16 października 2026Zaktualizowano Fathy Shalaby13 min czytania
Cztery ryzyka produktowe: jakie dowody liczą się przy każdym z nich
AI sprawiła, że wykonalność można udowodnić tanio. Wartość, użyteczność i opłacalność nadal wymagają własnych dowodów, a świetna demonstracja prototypu waży mniej, niż się wydaje. Risk Receipt pokazuje, co naprawdę udało ci się wyeliminować.
Udostępnij
Ten artykuł został przetłumaczony z języka angielskiego. Przeczytaj oryginał
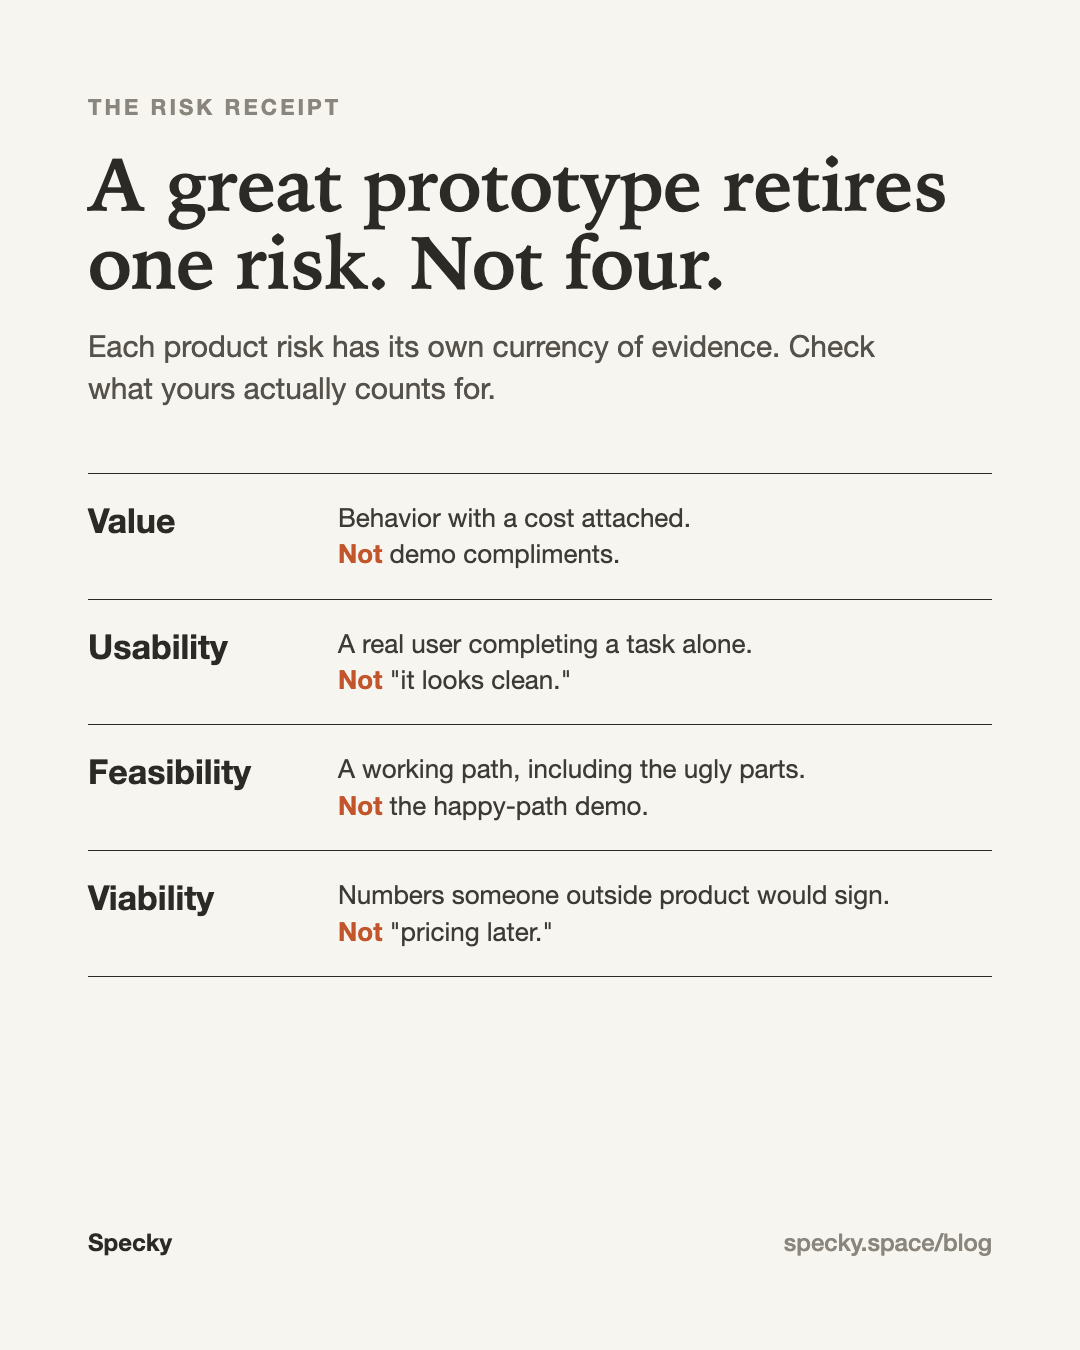
Cztery ryzyka produktowe to wartość (czy klienci to kupią albo będą używać?), użyteczność (czy domyślą się, jak z tego korzystać?), wykonalność (czy możemy to zbudować?) i opłacalność (czy to działa dla biznesu?). Ujęcie Marty'ego Cagana nadal się sprawdza, ale AI zmieniła ekonomię: wykonalność testuje się teraz tanio, a pozostałe trzy ryzyka wciąż potrzebują własnych dowodów. Demo prototypu mówi o wartości znacznie mniej, niż się wydaje.
Najważniejsze wnioski
Cztery wielkie ryzyka Cagana są od siebie niezależne: dowody dla jednego mówią niewiele o innym (SVPG, 2017).
W analizie CB Insights z 2026 roku obejmującej 385 upadłych startupów finansowanych przez fundusze VC, których przyczyny znamy, 43% wskazało słabe product-market fit, a 19% niezrównoważoną ekonomię jednostkową. To problemy wartości i opłacalności, a nie budowania (CB Insights, 2026).
Pięciu użytkowników testowych znajduje około 85% problemów z użytecznością, więc dowody w tym obszarze są tanie (Nielsen Norman Group, 2000).
Dowodem wartości jest zachowanie, które coś kosztuje, zwykle zebrane, zanim ludzie zobaczą twoje rozwiązanie.
Risk Receipt trzyma razem każde twierdzenie, jego dowód i uczciwy werdykt („liczy się / słaby / niezweryfikowany / niezbadany”), żeby nikt nie wziął czterech miłych rozmów demo za walidację.
Jakie są cztery ryzyka produktowe?
Cagan opisał cztery wielkie ryzyka w artykule na SVPG w 2017 roku i stały się one standardową listą kontrolną product discovery (SVPG, 2017):
Ryzyko
Pytanie
Właściciel w modelu Cagana
Najmocniejszy dowód
Najsłabszy dowód
Wartość
Czy klienci to kupią, a użytkownicy zechcą z tego korzystać?
Product manager
Zachowanie z kosztem: pilotaże, przedsprzedaż, obejścia, za które już płacą
„Używałbym tego”, entuzjazm podczas demo
Użyteczność
Czy użytkownicy potrafią sami ustalić, jak tego używać?
Samodzielne próby wykonania zadań przez docelowych użytkowników
Przeglądy z interesariuszami, „wygląda czytelnie”
Wykonalność
Czy inżynierowie mogą to zbudować w dostępnym czasie, z posiadanymi umiejętnościami i technologią?
Lead engineer
Działająca ścieżka na realistycznych danych, z listą tego, co pominięto
Demo na ścieżce idealnej na danych testowych
Opłacalność
Czy to działa dla reszty firmy?
Product manager
Koszt obsługi, cena sprawdzona na kupującym, zgoda sprzedaży, działu prawnego i supportu
„Cenami zajmiemy się później”
Słowami Cagana opłacalność to „czy to rozwiązanie działa także dla różnych aspektów naszego biznesu”. Obejmuje to ceny, koszt obsługi, sprzedaż, kwestie prawne, compliance i support.
Cztery ryzyka są niezależne. Funkcja może być banalna do zbudowania, w pełni użyteczna i mimo to nie mieć żadnej wartości. Może mieć oczywistą wartość i być nieopłacalna, na przykład gdy każde użycie kosztuje w inferencji więcej, niż płaci klient.
Dlaczego AI zmieniła to, które ryzyka produktowe są najważniejsze?
Gdy budowanie było drogie, wykonalność była bramką, za którą ustawiało się wszystko w kolejce. Zespoły poświęcały czas discovery na pozostałe trzy ryzyka, podczas gdy inżynieria szacowała. Teraz, gdy działający prototyp powstaje w jedno popołudnie, kolejka zniknęła, a razem z nią wymuszona pauza, w której wcześniej badano inne ryzyka.
Benedikt Kantus ujął to wprost w eseju z października 2026 roku: „AI has made feasibility almost trivial. It has not touched the other three.” (Leading in Product, 2026).
Dane o porażkach zgadzają się co do tego, gdzie giną produkty. CB Insights przeanalizował 431 firm finansowanych przez fundusze VC, które zamknęły działalność od 2023 roku, i dla 385 potrafił ustalić przyczyny. „Skończył się kapitał” znalazł się na szczycie z wynikiem 70%, ale raport nazywa to przyczyną ostateczną, a nie pierwotną. Pod spodem: słabe product-market fit z 43%, zły moment z 29% i niezrównoważona ekonomia jednostkowa z 19% (CB Insights, 2026). A w przypadku produktów, które przetrwały, analiza Pendo z 2019 roku wykazała, że 80% funkcji w przeciętnym produkcie jest używanych rzadko lub wcale (Pendo, 2019). Drogie jest ryzyko wartości, nie ryzyko budowania.
Czy wykonalność naprawdę jest rozwiązana?
W przypadku prototypów w większości tak. W produkcji mniej oczywiście. W randomizowanym badaniu METR 16 doświadczonych programistów open source, pracujących nad 246 prawdziwymi zgłoszeniami we własnych repozytoriach, potrzebowało o 19% więcej czasu z narzędziami AI z początku 2025 roku, choć prognozowało przyspieszenie o 24% i po fakcie sądziło, że byli o 20% szybsi (METR, 2025). Kontynuacja z lutego 2026 roku z udziałem 57 programistów wykazała tylko słabe dowody przyspieszenia, z przedziałami ufności obejmującymi zero, a sam METR ostrzega, że dane są niewiarygodną miarą (METR, 2026). Uczciwy odczyt: pierwsza wersja jest tania, ale przypadki brzegowe, niezawodność i utrzymanie już nie.
Czym jest Risk Receipt?
Problem nie polega na tym, że PM-owie przestali dbać o pozostałe ryzyka. Chodzi o to, że dopracowany prototyp sprawia wrażenie dowodu dla wszystkich czterech. Pokazujesz go pięciu osobom, słyszysz „super” i zespół wychodzi przekonany, że wartość, użyteczność i opłacalność są załatwione. Każde ryzyko ma własną walutę dowodów, a większość zespołów płaci niewłaściwą.
Risk Receipt to krótka notatka, którą dołączasz do każdego istotnego zakładu produktowego. Dla każdego z czterech ryzyk produktowych odpowiada na trzy pytania:
Jakie jest twierdzenie? Jedno zdanie, na tyle konkretne, żeby mogło okazać się błędne.
Jakie mamy dowody i jakiego są rodzaju? Z linkiem do źródła, nie w parafrazie.
Czy ten dowód naprawdę liczy się dla tego ryzyka? To część, którą zespoły pomijają.
Trzecie pytanie jest sednem. Dowody mają kurs wymiany. Niektóre są dla jednego ryzyka twardą walutą, a dla innego prawie nic nie warte.
Jakie dowody liczą się przy każdym ryzyku?
Wartość: płać zachowaniem, nie komplementami
Liczy się: klienci opisujący problem bez pytania, ze świeżym, konkretnym przykładem. Istniejące obejścia (arkusze, skrypty, ręczne procesy), które kosztują ich realny czas. Zobowiązania z kosztem: termin w kalendarzu, pilotaż na ich danych, przedsprzedaż, przedstawienie szefowi.
Nie liczy się: „Używałbym tego.” Entuzjazm podczas demo. Współczynnik kliknięć prototypu w sesji z moderatorem. Głosy na tablicy pomysłów od ludzi, którzy nigdy nie zapłacą.
Sygnał ostrzegawczy: jeśli najmocniejszym dowodem wartości jest czyjaś reakcja na twój prototyp, zebrałeś dowód użyteczności i nazwałeś go wartością. Ludzie reagują grzecznie na wszystko, co wygląda kompetentnie. Dowody wartości zwykle pochodzą z czasu, zanim zobaczyli twoje rozwiązanie, z tego, jak mówią o problemie. Tanie sposoby, by je zdobyć, to test fałszywych drzwi lub strona zainteresowania przedsprzedażą.
Użyteczność: płać obserwowanymi zadaniami, nie opiniami
Liczy się: patrzenie, jak prawdziwy użytkownik docelowy próbuje wykonać prawdziwe zadanie bez podpowiedzi, i notowanie, gdzie się waha lub poległ. Wykonanie zadania za pierwszym podejściem. Pytania, które zadaje na głos.
Nie liczy się: „Wygląda czytelnie.” Przegląd z interesariuszami. Twój własny zespół używający tego codziennie (ci ludzie już wiedzą, gdzie co jest).
Sygnał ostrzegawczy: jeśli nikt spoza zespołu nie próbował samodzielnie wykonać zadania, użyteczność jest niezweryfikowana, niezależnie od tego, jak dobrze wygląda prototyp.
To jedyne ryzyko, przy którym prototypowanie z AI naprawdę pomaga. Klikalny prototyp oparty na prawdziwych danych daje ci obserwację realnych zadań tygodnie wcześniej niż statyczna makieta. To realny zysk, ale tylko dla jednego ryzyka. Nasz szablon testu użyteczności pokazuje, jak prowadzić sesje.
Wykonalność: płać działającą ścieżką, wraz z brzydkimi fragmentami
Liczy się: prototyp działający na realistycznych wolumenach danych, z prawdziwymi uprawnieniami i prawdziwym opóźnieniem. Uczciwa lista inżyniera z tym, co prototyp pominął: uwierzytelnianie, migracje, stany błędów, integracja z limitem zapytań.
Nie liczy się: demo na ścieżce idealnej na danych testowych.
Sygnał ostrzegawczy: zapytaj „czego ten prototyp nie musiał obsłużyć?”. Jeśli odpowiedź jest długa, wykonalność jest wyeliminowana częściowo, nie w pełni.
Opłacalność: płać liczbami, pod którymi podpisałaby się osoba spoza produktu
Liczy się: szacunek kosztu obsługi (w funkcjach AI koszt jednego użycia przy spodziewanym wolumenie). Hipoteza cenowa, którą powiedziałeś na głos kupującemu. Konsultacja z osobą odpowiedzialną za support, sprzedaż, bezpieczeństwo lub kwestie prawne. W B2B: czy proces zakupowy kupującego na to pozwala.
Nie liczy się: „Cenami zajmiemy się później.” Zakładanie, że koszty użycia są pomijalne, bo prototyp był tani w uruchomieniu dla jednej osoby.
Sygnał ostrzegawczy: jeśli nikt spoza zespołu produktowego nie widział tego zakładu, opłacalność jest niezbadana.
Przykład krok po kroku: czterech zadowolonych klientów, jedna pusta notatka
Załóżmy, że jesteś dwuosobowym zespołem założycielskim budującym narzędzie B2B, a rozmowa z klientem podsuwa ci pomysł: asystent AI, który przygotowuje cotygodniowe raporty statusu na podstawie aktywności w projekcie. Robisz prototyp w weekend. Działa. Pokazujesz go czterem klientom podczas rozmów. Wszyscy czterej mówią, że są zachwyceni.
Oto uczciwy Risk Receipt:
Ryzyko
Twierdzenie
Dowód
Czy się liczy?
Wartość
Liderzy zespołów będą korzystać z cotygodniowych szkiców zamiast sami pisać raporty
4 pozytywne reakcje na demo
Słaby: reakcje na rozwiązanie, a nie zachowanie. Nikt nie opisał pisania raportów jako problemu, zanim mu to pokazałeś.
Użyteczność
Liderzy mogą przejrzeć i wysłać szkic w mniej niż 5 minut
Nic nie zaobserwowano
Niezweryfikowany: nikt nie próbował samodzielnie.
Wykonalność
Szkice pozostają dokładne na prawdziwych danych projektowych
Weekendowy prototyp na twoim własnym workspace
Częściowy: brak testu na zabałaganionym workspace klienta.
Opłacalność
Koszt szkicu pozostaje znacznie poniżej tego, co przynosi plan
Nie oszacowano
Niezbadany
Cztery entuzjastyczne rozmowy, a notatka mówi, że wyeliminowałeś prawie nic. To nie powód, by porzucić pomysł. To powód, by przed zbudowaniem wersji produkcyjnej zrobić trzy tanie sprawdziany:
Wartość: wróć do dwóch z tych klientów i zapytaj, jak dziś piszą raporty, ile to trwa i co się stało, gdy ostatnio któryś się spóźnił. Słuchaj, czy pojawi się obejście.
Użyteczność: daj jednemu klientowi prototyp na jego własnych danych i obserwuj, jak korzysta z niego bez wskazówek przez jeden cykl.
Opłacalność: pomnóż koszt modelu na szkic przez realistyczny tygodniowy wolumen w całej bazie klientów i porównaj z ceną planu.
Rachunek opłacalności (liczby poglądowe). Załóżmy, że szkic kosztuje 0,06 € w wywołaniach modelu na twoim własnym workspace, ale prawdziwy workspace klienta ma 5 razy więcej aktywności, czyli 0,30 € za szkic. Klient z 40 liderami zespołów generuje 160 szkiców miesięcznie, czyli 48 € kosztu modelu przy planie za 60 € miesięcznie. To 80% przychodu zjedzone przez jedną funkcję. Lepiej wiedzieć o tym w trzecim dniu niż w trzecim miesiącu.
Każdy sprawdzian zajmuje dni, nie tygodnie. To prawdziwa dywidenda taniej wykonalności: stać cię na kupienie realnych dowodów dla pozostałych trzech ryzyk, zanim się zobowiążesz.
Ilu klientów lub użytkowników potrzeba dla każdego ryzyka?
Użyteczność: wystarczą małe liczby. Analiza Nielsena wykazała, że 5 użytkowników ujawnia około 85% problemów z użytecznością, i zalecała trzy rundy po 5 osób z poprawkami pomiędzy nimi zamiast jednej rundy z 15 (Nielsen Norman Group, 2000).
Wartość: liczba liczy się mniej niż cena sygnału. Dwóch klientów, z których każdy daje ci pilotaż na własnych danych, waży więcej niż dwudziestu mówiących „brzmi świetnie”. Szukaj co najmniej 3 niezależnych zobowiązań, zanim uznasz ryzyko wartości dla danego segmentu za wyeliminowane.
Wykonalność: jedno realistyczne uruchomienie, ocenione przez inżyniera, który będzie za to odpowiadał, plus pisemna lista tego, co pominięto.
Opłacalność: jeden model kosztów z jawnymi założeniami i jedna rozmowa z każdą funkcją, która musi się zgodzić (sprzedaż, support, dział prawny lub bezpieczeństwo).
To punkty wyjścia dla małego zespołu, a nie wzorce odniesienia.
Dlaczego notatki są lepsze od listy kontrolnej discovery?
Mógłbyś zamienić cztery ryzyka w listę kontrolną. Zespoły tak robią. Listy kontrolne zawodzą w przewidywalny sposób: ktoś odhacza „wartość zwalidowana”, bo demo poszło dobrze, a ptaszek ukrywa, jaki był dowód.
Notatka trzyma dowód przy twierdzeniu. Trzy miesiące później, gdy funkcja wypada słabo i ktoś pyta „dlaczego to zbudowaliśmy?”, odpowiedzią nie jest wspomnienie ani slajd. To zapis: tak wierzyliśmy, to zobaczyliśmy, te ryzyka świadomie zostawiliśmy otwarte. Strukturę, która łączy takie zapisy w czasie, opisujemy w naszym grafie decyzji dla małych zespołów AI. Jeśli twój zespół wypuszcza produkty bez żadnych notatek, sprawdź go według 10 sygnałów ostrzegawczych fabryki funkcji.
Ta ostatnia kwestia jest ważna. Wypuszczenie z otwartym ryzykiem często jest dobrą decyzją, bo małe zespoły nie mogą sobie pozwolić na wyeliminowanie wszystkiego. Błędem jest wypuścić z otwartym ryzykiem, które uważałeś za zamknięte.
Typowe błędy
Liczenie reakcji na demo jako wartości. Najczęstszy pojedynczy błąd. Reakcje to w najlepszym razie dowód użyteczności.
Testowanie użyteczności z osobami z wewnątrz. Koledzy i życzliwi klienci znają już logikę produktu.
Traktowanie prototypu jako dowodu wykonalności w produkcji. Za każdym razem proś o listę tego, co pominięto.
Zostawianie opłacalności na „później”. Zwłaszcza w funkcjach AI koszt jednego użycia może zamienić lubianą funkcję w generator strat.
Próba wyeliminowania każdego ryzyka. Wybierz jedno lub dwa ryzyka, które zabiłyby zakład, i najpierw kupuj dowody dla nich. Nasz przewodnik po mapowaniu założeń pomaga je uszeregować.
Jak prowadzimy Risk Receipts w Specky
Sygnały od klientów (notatki z wywiadów, wątki supportu, transkrypcje rozmów, zdarzenia analityczne) trafiają do Product Graph jako typowane węzły, z których każdy zachowuje swoje źródło. Przygotowany insight lub decyzja cytuje konkretne węzły, na których się opiera, więc „czterech klientów to pokochało” nie może po cichu zamienić się w „klienci tego potrzebują”. Do sprawdzenia wartości Alex, agent badawczy AI w Specky, może przeprowadzać krótkie wywiady o obecnym procesie klientów, zanim zobaczą twoje rozwiązanie, a transkrypcje wracają jako dowody. Dla wczesnego popytu strona walidacyjna mierzy, czy ludzie podejmują działanie, które coś kosztuje. Osąd, które ryzyka zostawić otwarte, pozostaje po twojej stronie.
Zacznij w tym tygodniu od jednej notatki
Nie potrzebujesz narzędzia, żeby zacząć. Wybierz zakład, który najbardziej ekscytuje teraz twój zespół, ten z najlepszym prototypem. Napisz cztery linie:
Jeśli najbardziej ekscytujący zakład ma najpustszą notatkę, wiesz, gdzie powinien trafić twój kolejny tydzień discovery. Założenia możesz też naszkicować wizualnie za pomocą darmowego narzędzia do mapy założeń.
Wykonalność była kiedyś pytaniem drogim. Teraz jest tanim. Zespoły, które wygrają w tym cyklu, nie będą tymi, które budują najszybciej. Będą tymi, które potrafią pokazać, co wiedziały, gdy podejmowały decyzję.
Najczęściej zadawane pytania
Jakie są cztery wielkie ryzyka Marty'ego Cagana?
To ryzyko wartości (czy klienci to kupią albo zdecydują się używać), ryzyko użyteczności (czy użytkownicy potrafią ustalić, jak z tego korzystać), ryzyko wykonalności (czy inżynierowie mogą to zbudować w dostępnym czasie, z posiadanymi umiejętnościami i technologią) oraz ryzyko opłacalności biznesowej (czy to działa dla reszty firmy). Cagan opublikował je na SVPG w 2017 roku i przypisuje wartość oraz opłacalność product managerowi.
Które z czterech ryzyk produktowych jest najczęściej niedoceniane?
Ryzyko wartości. Działający prototyp i uprzejme reakcje budzą silne poczucie walidacji, które nie ma pokrycia w zachowaniu. Badanie CB Insights z 2026 roku wykazało, że 43% upadłych startupów o znanej przyczynie wskazało słabe product-market fit. Opłacalność plasuje się tuż za nim w funkcjach AI, gdzie koszt użycia może przerosnąć cenę.
Czy prototyp testuje ryzyko wartości?
Rzadko samodzielnie. Pokazanie prototypu testuje głównie użyteczność i trochę wykonalności. Dowody wartości pochodzą z zachowań z kosztem: ludzi opisujących problem bez pytania, istniejących obejść, pilotaży, przedsprzedaży lub przedstawień. Możesz użyć prototypu w teście wartości, na przykład prosząc o płatny pilotaż, ale sama reakcja się nie liczy.
Jak testować ryzyko opłacalności biznesowej?
Zapisz liczby, które musiałaby zatwierdzić osoba spoza produktu: koszt obsługi na klienta, spodziewaną cenę, obciążenie supportu oraz wszelkie ograniczenia prawne, bezpieczeństwa lub zakupowe. Następnie pokaż je tym ludziom. W funkcjach AI pomnóż koszt jednego użycia przez realistyczny wolumen i porównaj z ceną planu, zanim zdecydujesz się budować.
Czy AI sprawiła, że ryzyko wykonalności zniknęło?
Nie, uczyniła pierwszą wersję tanią. Prototypy powstają teraz w godziny, ale praca produkcyjna na dojrzałych bazach kodu to co innego: badanie METR z 2025 roku wykazało, że doświadczeni programiści z narzędziami AI potrzebowali na własnych repozytoriach o 19% więcej czasu, a kontynuacja z 2026 roku wykazała tylko słabe dowody przyspieszenia. Pytaj dalej, czego prototyp nie musiał obsłużyć.
GDPR-aligned. EU workspace data is stored in Frankfurt, Germany. GDPR and EU data Built in Vienna, Austria. A product of influence solutions fm GmbH (FN 675374y). Imprint 14-day trial. Card required, and nothing is charged until day 14. 30-day refund after subscribing. See pricing