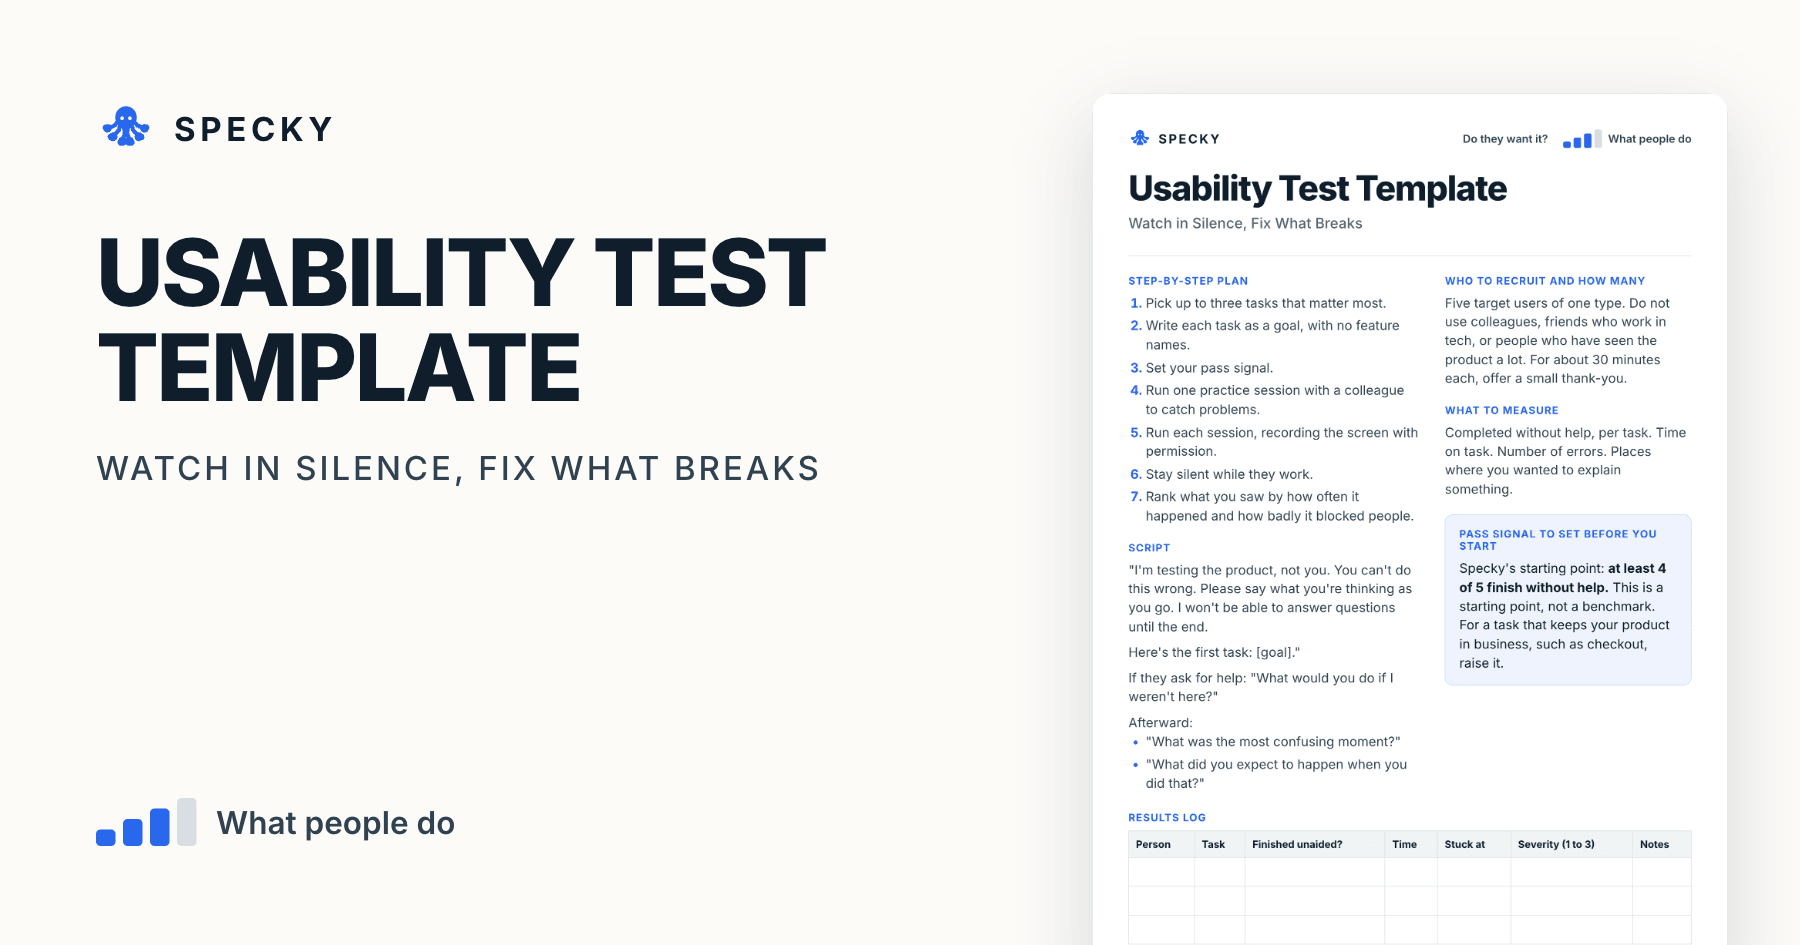
قالب اختبار قابلية الاستخدام هو خطة جاهزة لمشاهدة مستخدمين حقيقيين وهم يحاولون إنجاز مهام في منتجك بينما تلتزم الصمت. يمنحك المهام ونصًّا محايدًا وما تقيسه وسجلًّا للنتائج، فتُظهر لك خمس جلسات مدة كل منها نحو 30 دقيقة أين يتعثر الناس. تجد أدناه قالبًا مجانيًا والنص وإشارة النجاح والأدلة وراء قاعدة الخمسة مستخدمين.
أهم النقاط
خمسة مستخدمين من نوع واحد يجدون معظم المشكلات. وجد نموذج Jakob Nielsen أن خمسة مشاركين يكشفون نحو 85% من مشكلات قابلية الاستخدام، وينصح بثلاث جولات من خمسة بدلًا من جولة واحدة من 15 (Nielsen Norman Group, 2000).
خمسة مستخدمين يجدون مشكلات، لا أرقامًا تصلح للاقتباس. وللحصول على معدل إتمام أو قيمة مرجعية، يوصي Nielsen بما لا يقل عن 20 مستخدمًا (Nielsen Norman Group, 2012).
عبر 1,189 مهمة في 115 اختبار قابلية استخدام، بلغ متوسط معدل إتمام المهام 78% (MeasuringU, 2011).
مقياس System Usability Scale المكوّن من 10 بنود يعطي درجة واحدة قابلة للمقارنة بعد المهام. ما فوق 68 يعني أعلى من المتوسط.
حدّد إشارة النجاح أولًا: أن ينهي 4 من 5 أشخاص على الأقل المهمة دون مساعدة.
ما هو اختبار قابلية الاستخدام؟
يعطي اختبار قابلية الاستخدام المستخدمين المستهدفين مهمة على النسخة الحالية من منتجك، ويراقب بصمت أين يتعثرون.
تقسّمه Kate Moran من Nielsen Norman Group إلى ثلاثة أجزاء: ميسّر يعطي التعليمات دون توجيه، ومهام واقعية، ومشارك واقعي يفكر بصوت عالٍ عادةً (NN/g, 2019).
الاختبار النوعي يجد المشكلات وهو النوع الشائع. أما الاختبار الكمي فيجمع مقاييس مثل نجاح المهام والوقت المستغرق لكل مهمة، لوضع قيمة مرجعية. وهذا القالب نوعي وموجَّه: تراقب مباشرةً، حضوريًا أو عبر مشاركة الشاشة، فتستطيع في النهاية أن تسأل: «ماذا توقعت أن يحدث؟»
متى تجري اختبار قابلية الاستخدام ومتى لا تجريه؟
استخدمه عندما يكون شيء ما قد بُني فعلًا، وبدأ الناس يتركونه أو يطلبون المساعدة. إنه رخيص، وتكون النتائج واضحة عادةً بمجرد أن تراها. تقدّر NN/g أن دراسة بسيطة تستغرق نحو 3 أيام، من التخطيط إلى خمس جلسات ثم التحليل، مع حوافز تكلف بضع مئات من الدولارات.
لا تستخدمه لمعرفة ما إذا كان الناس يريدون المنتج. فالناس يجرّبون عن طيب خاطر أي شيء تضعه أمامهم. ولا تستخدمه على تصميم غير موجود بعد. النموذج الأولي القابل للنقر يؤدي هذه المهمة، والنموذج الأولي الورقي أرخص. ولمراقبة كيف يتعامل الناس مع منتج منافس بدلًا من منتجك، أجرِ اختبار البوميرانغ.
ما المخاطرة التي يختبرها، وما قوة الأدلة؟
يختبر الجاذبية بمعناها العملي: هل يستطيع الناس فعلًا استخدام هذا لإنجاز عملهم؟ والدليل هو السلوك. فهو يُظهر أن المنتج يعمل للناس، لكن ليس أنهم يقدّرونه. اطّلع على دليلنا لاختيار تجربة المنتج للصورة الأشمل.
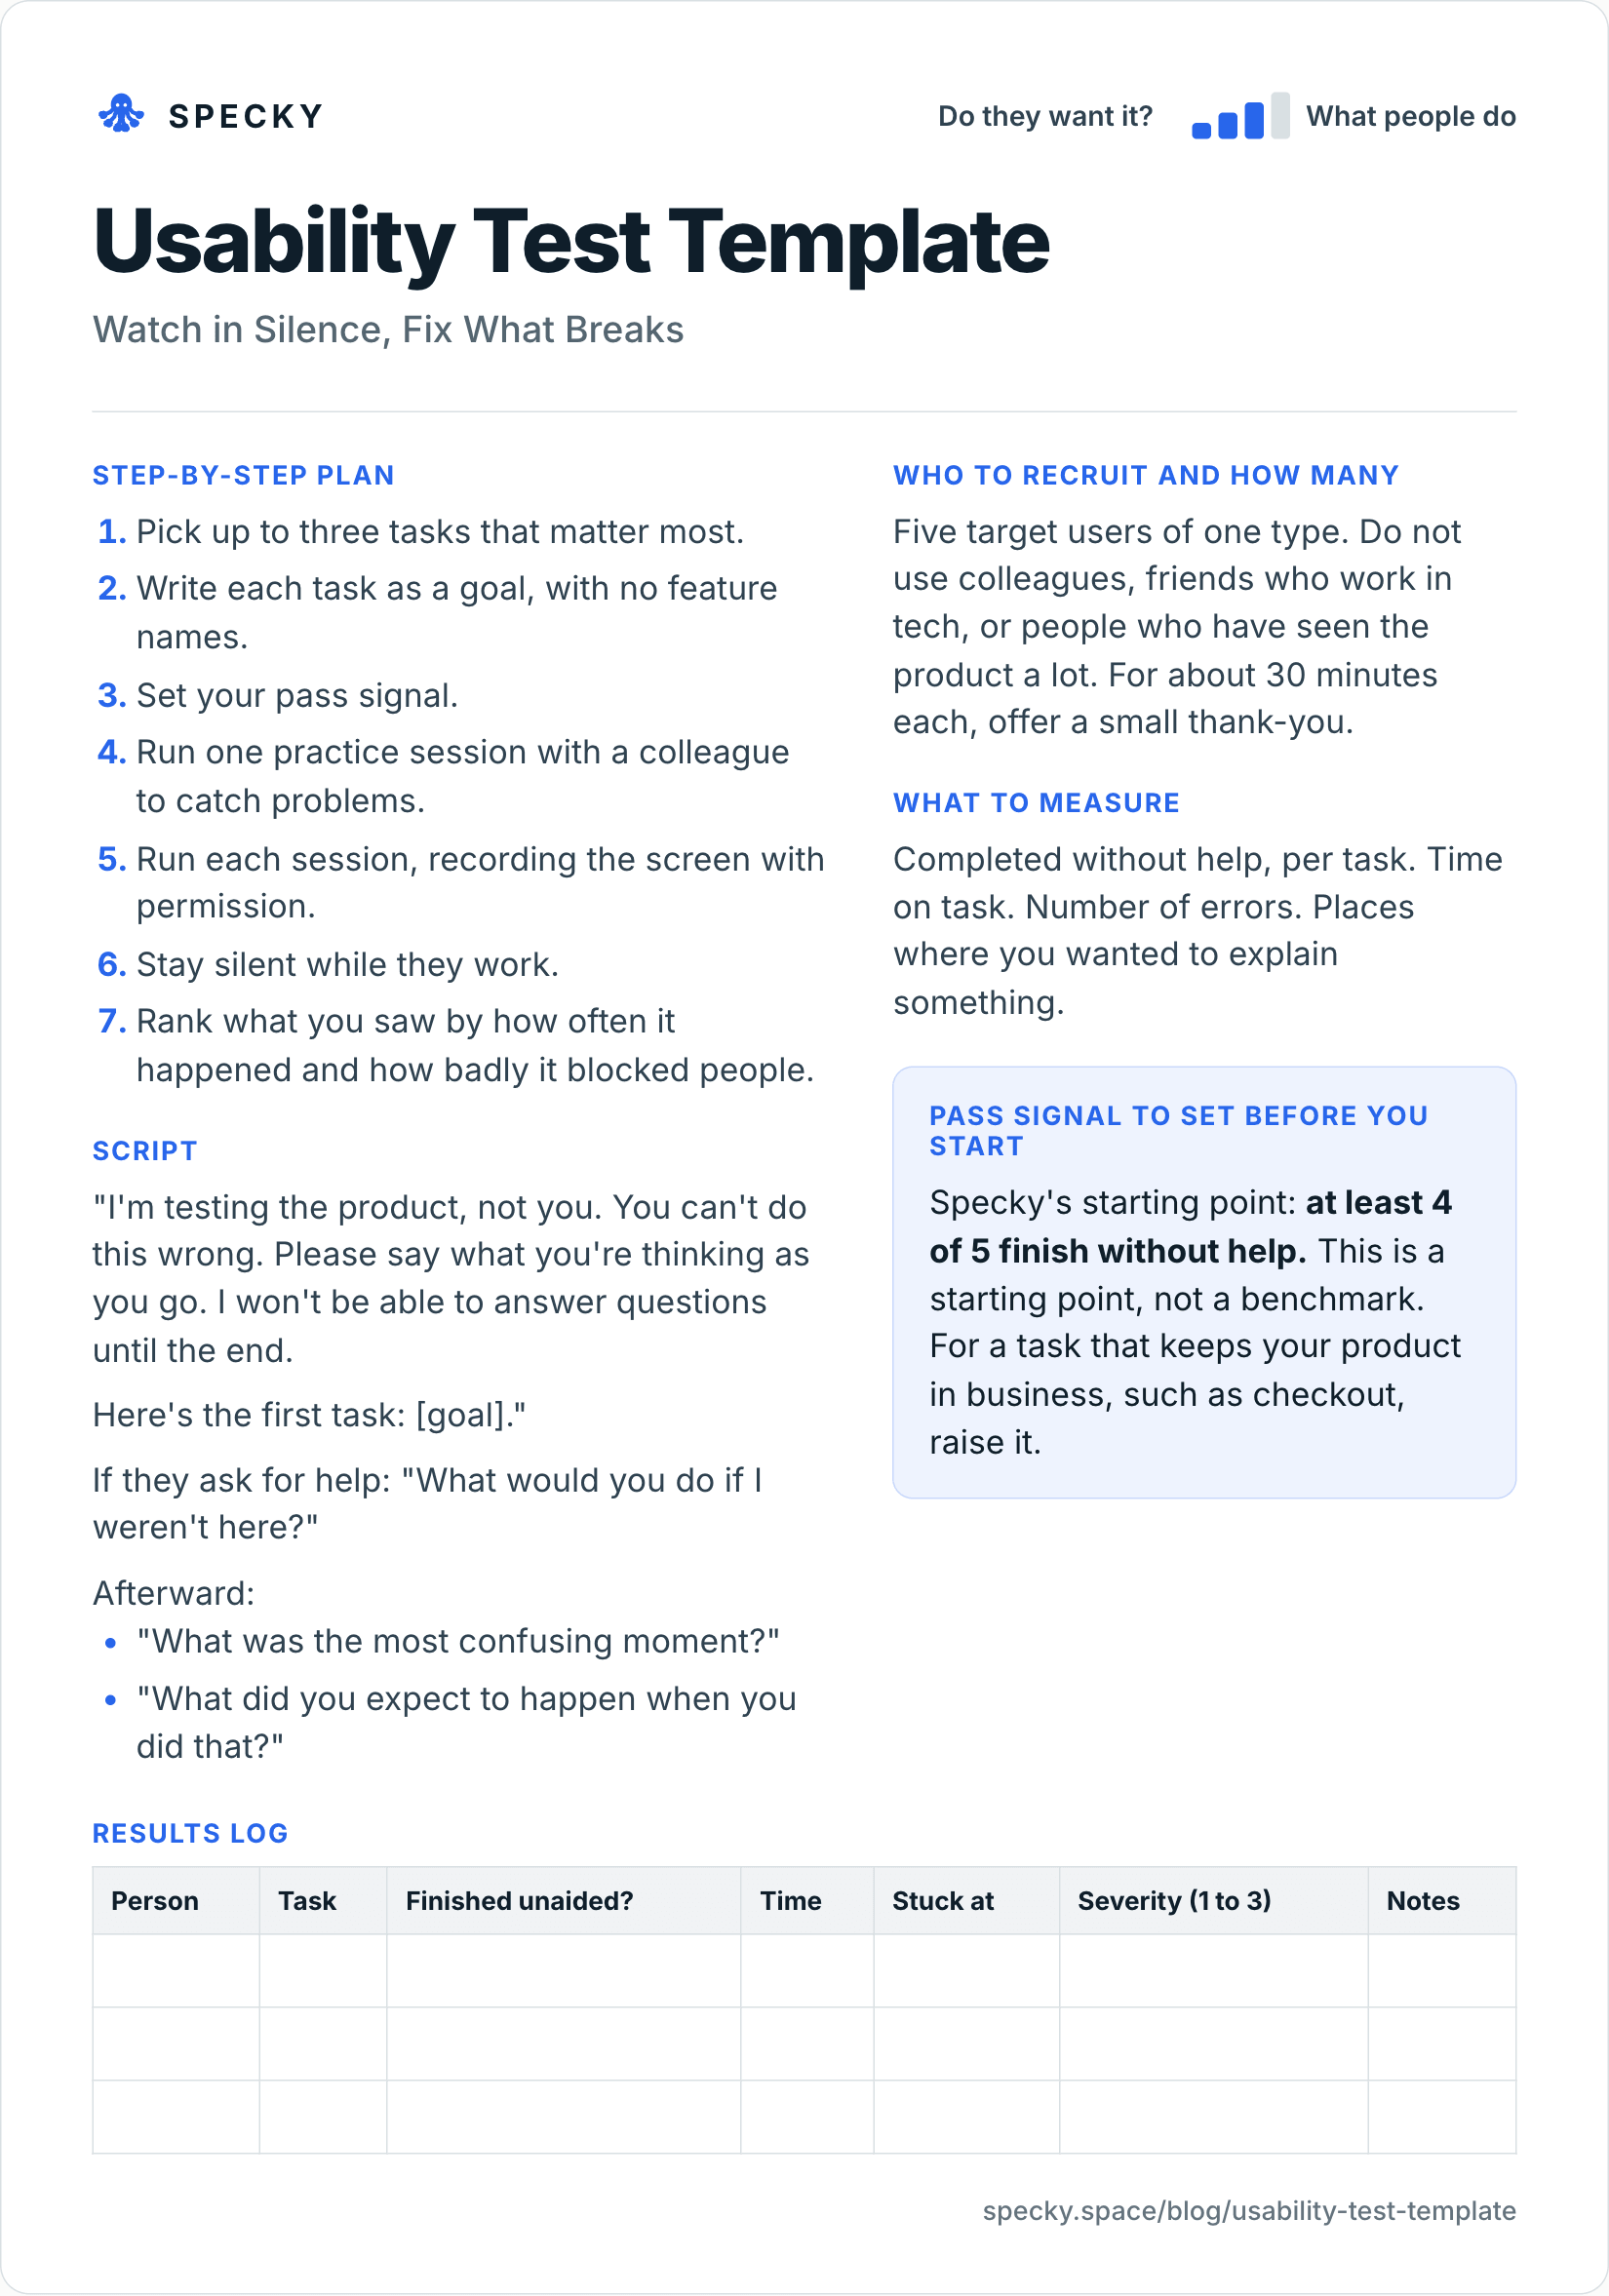
قالب اختبار قابلية الاستخدام (انسخه واستخدمه)
افتح الصورة بالحجم الكامل، أو انسخ النسخة النصية أدناه.
من تجنّد وكم عددهم
خمسة مستخدمين مستهدفين من نوع واحد. لا تستعن بزملاء ولا بأصدقاء يعملون في التقنية ولا بمن رأوا المنتج كثيرًا. قدّم لكل واحد شكرًا صغيرًا مقابل نحو 30 دقيقة.
خطة خطوة بخطوة
اختر حتى ثلاث مهام هي الأهم.
اكتب كل مهمة على هيئة هدف، دون أسماء ميزات.
حدّد إشارة النجاح.
أجرِ جلسة تجريبية واحدة مع زميل لاكتشاف المشكلات.
نفّذ كل جلسة مع تسجيل الشاشة بإذن المشارك.
التزم الصمت أثناء عملهم.
رتّب ما رأيته بحسب عدد مرات حدوثه ومدى إعاقته للناس.
النص
«أنا أختبر المنتج، لا أنت. لا يمكنك أن تخطئ. أرجو أن تقول بصوت عالٍ ما تفكر فيه أثناء العمل. لن أستطيع الإجابة عن الأسئلة حتى النهاية.
هذه هي المهمة الأولى: [الهدف].»
إذا طلبوا المساعدة: «ماذا كنت ستفعل لو لم أكن هنا؟»
بعد ذلك:
«ما أكثر لحظة كانت محيّرة؟»
«ماذا توقعت أن يحدث عندما فعلت ذلك؟»
ما الذي تقيسه
الإنجاز دون مساعدة، لكل مهمة. الوقت لكل مهمة. عدد الأخطاء. المواضع التي أردت فيها أن تشرح شيئًا.
إشارة النجاح التي تحددها قبل البدء
نقطة انطلاق Specky: ينهي 4 من 5 على الأقل المهمة دون مساعدة. هذه نقطة انطلاق وليست معيارًا مرجعيًا. وفي مهمة يتوقف عليها بقاء منتجك، مثل الدفع، ارفعها.
سجل النتائج
الشخص
المهمة
هل أنهاها دون مساعدة؟
الوقت
تعثّر عند
الخطورة (من 1 إلى 3)
ملاحظات
كيف تكتب مهام جيدة لاختبار قابلية الاستخدام؟
المهمة هي هدف يملكه الشخص أصلًا، مكتوب بكلماته. إذا ذكرت المهمة اسم زرّك، فأنت تختبر ما إذا كان الناس يجيدون القراءة.
مهمة ضعيفة
مهمة أفضل
«استخدم زر الاستيراد لإضافة الضيوف.»
«لديك 40 ضيفًا في جدول بيانات. أدخلهم في قائمة ضيوفك.»
«افتح الإعدادات وغيّر شعار الفاتورة.»
«يجب أن تعرض فواتيرك شعارك الجديد. اجعل ذلك يحدث.»
حدّد معنى «تم» قبل الجلسة الأولى: «يظهر الضيوف بأسمائهم وبريدهم الإلكتروني» نجاح، أما «وجدوا شاشة الاستيراد» فلا. أعطِ الناس بيانات واقعية واطبع كل مهمة على بطاقة ليعيدوا قراءتها دون أن يسألوك.
كم مستخدمًا تحتاج لاختبار قابلية الاستخدام؟
خمسة لكل جولة، من نوع واحد من المستخدمين. يقول نموذج Nielsen إن نسبة المشكلات المكتشفة مع n من المستخدمين هي 1 − (1 − L)ⁿ، حيث L هي النسبة التي يجدها مستخدم واحد. وفي المشاريع التي درسها بلغ متوسط L نحو 31% (Nielsen Norman Group, 2000).
هذه الـ31% متوسط. أما المشكلة التي تعثّر شخصًا واحدًا من كل عشرة فمن الأسهل بكثير أن تفوتك:
المستخدمون في الجولة
المشكلات المكتشفة (L = 31%)
احتمال رؤية مشكلة تصيب 10% من المستخدمين
1
31%
10%
3
67%
27%
5
84%
41%
10
98%
65%
15
99.6%
79%
لهذا يوصي Nielsen بإنفاق ميزانية 15 شخصًا على ثلاث جولات من خمسة، مع إصلاح التصميم بين الجولات: فالمشكلات النادرة تظهر عبر الجولات.
أنواع المستخدمين المختلفة تحتاج جولات خاصة بها. لمجموعتين، يقترح Nielsen من 3 إلى 4 مستخدمين لكل منهما؛ ولثلاث مجموعات أو أكثر، 3 لكل مجموعة.
الأرقام تحتاج أشخاصًا أكثر. وللحصول على مقاييس ذات دلالة إحصائية، يوصي بما لا يقل عن 20 مستخدمًا (NN/g, 2012). وفي المقال نفسه، وجد استطلاع شمل 217 مشاركًا في مؤتمر أن الفرق كانت تستخدم في المتوسط 11 مشاركًا في الجولة.
مثال محسوب: لماذا لا يستطيع خمسة مستخدمين إعطاءك معدل إتمام
هذا المثال توضيحي. لنفترض أن 4 من 5 أشخاص ينهون مهمة الدفع. هذا «نجاح بنسبة 80%»، لكن فاصل الثقة 95% (طريقة Wald المعدّلة) يمتد من نحو 36% إلى 98%. فقد يكون المعدل الحقيقي سيئًا أو ممتازًا.
الآن لنفترض أن 16 من 20 ينهونها. النسبة نفسها 80%، لكن الفاصل يضيق إلى نحو 58% إلى 93%. استخدم خمسة أشخاص لاكتشاف المشكلات وإصلاحها، و20 أو أكثر حين يحتاج أحد إلى نسبة مئوية.
ماذا تقيس في اختبار قابلية الاستخدام؟
المقاييس الأربعة في القالب تكفي لجولة نوعية. وإضافتان تجعلان النتائج أسهل في العمل بها.
كيف تقيّم خطورة مشكلة قابلية الاستخدام؟
يقيّم Nielsen الخطورة بثلاثة عوامل: كم مرة تحدث المشكلة، ومدى صعوبة تجاوزها، وهل تظل تزعج الناس (NN/g, 1994). يمتد مقياسه من 0 إلى 4؛ ويقابل مقياس القالب من 1 إلى 3 أعلى ثلاثة مستويات عنده:
الخطورة في القالب
مستوى Nielsen
ما حدث
ما العمل
1
2، طفيفة
أبطأتهم وتعافوا
أصلحها حين تكون رخيصة
2
3، كبيرة
احتاجوا إلى عدة محاولات أو تخمين
أصلحها قبل الجولة التالية
3
4، كارثية
لم يستطيعوا الإنهاء دون مساعدة
أصلحها قبل الإصدار
وجد Nielsen أن تقييمات الخطورة التي يضعها شخص واحد غير موثوقة بما يكفي، وينصح بأخذ متوسط ثلاثة مقيّمين. قيّموا كلٌّ على حدة ثم قارنوا.
هل تضيف System Usability Scale؟
System Usability Scale (SUS) استبيان من 10 بنود بخمس إجابات من «أوافق بشدة» إلى «لا أوافق بشدة». ابتكره John Brooke عام 1986، وأشار موقع usability.gov إلى أكثر من 1,300 مقال ومنشور يستند إليه (usability.gov, archived).
لحساب الدرجة، اطرح 1 من كل إجابة في البنود الفردية، واطرح كل إجابة في البنود الزوجية من 5، واجمع النتائج العشر واضرب في 2.5 (MeasuringU, 2011). مثال توضيحي: الإجابات 4 و2 و4 و1 و4 و2 و5 و2 و4 و2 تعطي 16 من البنود الفردية و16 من الزوجية، فيكون 32 × 2.5 = درجة SUS قدرها 80.
الدرجة ليست نسبة مئوية. المتوسط عبر 500 دراسة هو 68، وأعلى 10% يتجاوزون 80.3. كما أن SUS ليس تشخيصيًا: فهو يخبر كم يبدو الشيء قابلًا للاستخدام، لا ما الذي يجب إصلاحه. ومع خمسة أشخاص، اقرأه بوصفه إشارة تقريبية وقارنه من جولة إلى أخرى.
اختبار قابلية الاستخدام مقابل اختبار النموذج الأولي القابل للنقر ومقابلة العميل
بعد الإطلاق، حين يترك الناس المنتج أو يطلبون المساعدة
قبل البناء
قبل أن تصمم أي شيء
المقابلات تجد المشكلة، والنموذج الأولي يختبر حلًّا قبل البناء، واختبار قابلية الاستخدام يتحقق منه حين يصبح حقيقيًا.
كيف يبدو اختبار قابلية الاستخدام عمليًا؟
هذا المثال مختلق لتوضيح الطريقة. فريق يدير أداة لمنظّمي حفلات الزفاف يلاحظ أن كثيرين يبدؤون قائمة ضيوف ولا يُكملونها. يراقبون خمسة منظّمين وهم يحاولون استيراد 40 اسمًا من جدول بيانات.
ينهي اثنان المهمة. ويصل ثلاثة إلى شاشة عنوانها «Map fields»، فيتوقفون ويرجعون. ويقول أحدهم: «لا أعرف ماذا تطلبون مني».
تفشل الإشارة. يستبدل الفريق تلك الشاشة بمعاينة للأسماء المستوردة، ويختبر مع خمسة أشخاص آخرين في الأسبوع التالي. ينهي أربعة المهمة. لم يضطر أحد إلى إعادة تصميم بقية المنتج.
في السجل، يجعل تعثّر ثلاثة من خمسة عند شاشة واحدة «Map fields» بخطورة 3. أما زر «Done» الواقع أسفل الجزء المرئي فأبطأ شخصًا واحدًا وسُجّل بخطورة 1. الجولة الأولى: 2 من 5. الجولة الثانية: 4 من 5، وهذا يحقق إشارة النجاح. عشر جلسات مدة كل منها 30 دقيقة، وشاشة واحدة تغيّرت.
ما أكثر أخطاء اختبار قابلية الاستخدام شيوعًا؟
المساعدة. كل مرة تشرح فيها، تخفي مشكلة حقيقية.
ذكر اسم الميزة في المهمة. «استخدم زر الاستيراد» يختبر القراءة لا قابلية الاستخدام.
الاختبار مع الزملاء. فهم يعرفون أصلًا كيف يعمل.
طلب الآراء. راقب ما يفعلونه.
كتابة تقرير بدلًا من إصلاح. أصلح أهم مشكلة وأعد الاختبار.
اقتباس نسب مئوية من خمسة أشخاص. «نجاح 80%» من 4 من 5 له فاصل من 36% إلى 98%.
متى لا ينجح: في الأسئلة عن الطلب أو السعر، وفي المشكلات النادرة التي تحتاج عشرات الجلسات لتظهر، وفي السلوك الذي لا يظهر إلا بعد أسابيع من الاستخدام الحقيقي.
كيف تسجّل جلسات قابلية الاستخدام بطريقة أخلاقية؟
تسجيل الشاشة مع الصوت بيانات شخصية، فعامله على هذا الأساس. أخبر الناس بما تسجّله ومن سيشاهده ومدة الاحتفاظ به، واحصل على موافقة قبل أن تضغط تسجيل. وقل لهم إن بإمكانهم التوقف في أي لحظة وسيحصلون على الشكر رغم ذلك. استخدم حسابات اختبار وبيانات نموذجية، لا عملاءهم الحقيقيين ولا بياناتهم المصرفية. شارك مقاطع من 30 ثانية للمشكلة لا جلسات كاملة، واحذف الملفات الخام عند انتهاء الجولة.
كيف تجريه في Specky
في صفحة Assumptions، انقر على الملاحظة واختر Pick a test، ثم Usability test. تملأ Specky خمسة مستخدمين وإشارة النجاح وجدولًا زمنيًا من ثلاثة أيام.
انقر Start running. الصق ما حدث في كل جلسة وسجّل النتيجة.
يظهر الاختبار الناجح على اللوحة بوصفه Supported، لأن مشاهدة شخص ينهي مهمة هي سلوك.
ماذا تفعل مع كل نتيجة؟
Supported: المسار يعمل. تحقق من صموده مع حركة مرور حقيقية عبر فحص تحليلات المنتج.
Unclear: تختلف النتائج بحسب نوع المستخدم. افصلها وأجرِ خمسة اختبارات لكل نوع.
Contradicted: لا يستطيع الناس إكماله. أصلح أسوأ مشكلة أولًا ثم أعد الاختبار. وأي رهان قائم على هذه الملاحظة يظهر الآن بوصفه Contradicted، ويجب أن يبقى كذلك حتى إعادة الاختبار.
خمسة مستخدمين من نوع واحد هو نقطة الانطلاق المعتادة. يقدّر نموذج Jakob Nielsen أن خمسة مشاركين يجدون نحو 85% من مشكلات قابلية الاستخدام، ما داموا مستخدمين متشابهين. أعد الاختبار مع خمسة آخرين بعد كل إصلاح بدلًا من إجراء 15 دفعة واحدة. ولمجموعتين متمايزتين من المستخدمين، اختبر ثلاثة أو أربعة من كل منهما، واستخدم 20 على الأقل للمقاييس التي تنوي اقتباسها.
ماذا تقول أثناء اختبار قابلية الاستخدام؟
أقل ما يمكن. اقرأ المهمة، واطلب من الناس أن يفكروا بصوت عالٍ، ثم التزم الصمت. إذا طلب أحدهم المساعدة فقل: «ماذا كنت ستفعل لو لم أكن هنا؟» رغبتك في الشرح تدل على مشكلة في قابلية الاستخدام، فسجّلها. وأجّل أسئلة مثل «ماذا توقعت أن يحدث؟» إلى النهاية.
ما الفرق بين اختبار قابلية الاستخدام وأبحاث المستخدمين؟
اختبار قابلية الاستخدام نوع من أبحاث المستخدمين. يتحقق مما إذا كان الناس يستطيعون استخدام شيء موجود فعلًا، بمراقبتهم وهم يجرّبون مهامًّا. أما الأبحاث الأوسع، مثل مقابلات العملاء، فتستكشف ما يحتاجه الناس وكيف يتدبرون أمرهم اليوم، قبل أن يُصمَّم أي شيء. المقابلات تجد المشكلة، واختبارات قابلية الاستخدام تتحقق من الحل.
ما معدل إتمام المهام الجيد؟
عبر 1,189 مهمة في 115 اختبار قابلية استخدام، وجدت MeasuringU متوسط معدل إتمام قدره 78%، مع تجاوز الربع الأعلى 92% وانخفاض الربع الأدنى عن 49%. وفي المهام التي يكون فشلها مكلفًا، مثل الدفع، استهدف 100%. ومع خمسة مستخدمين، عُدَّ مرات الإنجاز بدلًا من اقتباس معدل، لأن هامش الخطأ واسع جدًا.
GDPR-aligned. EU workspace data is stored in Frankfurt, Germany. GDPR and EU data Built in Vienna, Austria. A product of influence solutions fm GmbH (FN 675374y). Imprint 14-day trial. Card required, and nothing is charged until day 14. 30-day refund after subscribing. See pricing