9. November 2026Aktualisiert am Fathy Shalaby12 Min. Lesezeit
A/B-Test-Plan-Vorlage: Eine Änderung testen, die Metrik vorab festlegen
Die meisten Split-Tests gehen schief, bevor sie starten. Ändere nur eine Sache, lege die Metrik zuerst fest, berechne die Stichprobengröße und schau nicht zwischendurch aufs Ergebnis.
Teilen
Dieser Artikel wurde aus dem Englischen übersetzt. Original lesen
Eine A/B-Test-Plan-Vorlage ist ein einseitiger Plan, den du vor einem Split-Test ausfüllst: die eine Änderung, die Primärmetrik, eine Guardrail-Metrik, die Stichprobengröße und das Enddatum. Ein Split-Test zeigt diese Änderung dann einem zufälligen Teil des echten Traffics und vergleicht die Metrik, die du vor dem Start festgelegt hast. Schreib den Plan zuerst, denn die meisten Split-Tests gehen schon vor dem Start schief.
Das Wichtigste in Kürze
Die meisten Ideen verlieren. Bings Erfolgsquote bei Ideen lag bei etwa 10–20 %, und Gewinner bewegten wichtige Metriken um 0,1 % bis 1,0 % (Kohavi et al., KDD 2014).
Berechne die Stichprobengröße, bevor du startest. Bei einer Conversion-Rate von 12 % braucht es für den Nachweis eines relativen Anstiegs von 10 % bei 95 % Konfidenz und 80 % Power etwa 11.700 Nutzer:innen pro Version (Evan Millers Rechner).
Schau nicht zwischendurch aufs Ergebnis. Wer nach jedem Besucher testet und beim ersten „signifikanten“ Ergebnis stoppt, treibt die Falsch-positiv-Rate von 5 % auf 26,1 % (Evan Miller, 2010).
Lege eine Guardrail fest, eine Metrik, die nicht schlechter werden darf.
Was ist ein Split-Test?
Ein Split-Test ändert eine Sache für einen Teil deines echten Traffics und vergleicht eine Metrik, die du vor Testbeginn festgelegt hast.
Er ist dasselbe wie ein A/B-Test: Version A ist das Original (die Kontrollgruppe), Version B enthält die Änderung, und die Leute werden zufällig zugewiesen. Weil die Änderung der einzige systematische Unterschied ist, deutet ein klarer Abstand bei der Metrik auf die Änderung hin.
In Testing Business Ideas von David J. Bland und Alex Osterwalder ist der Split-Test ein Validierungsexperiment vom Typ „Call to Action“, neben dem Landingpage-Test und dem Presale. Das Strategyzer-Poster bewertet ihn mit 2 von 5 bei den Kosten, 3 von 5 bei der Laufzeit und 3 von 5 bei der Aussagekraft der Evidenz (Strategyzer-Experimentbibliothek).
Wann solltest du einen Split-Test durchführen – und wann nicht?
Nutze ihn, wenn du genug Traffic hast und wissen willst, ob eine bestimmte Änderung ein Ergebnis verursacht hat. Das ist der verlässlichste Weg, das zu beantworten. Er kann dich auch überraschen. In ihrem Harvard-Business-Review-Artikel von 2017 erzählen Ron Kohavi und Stefan Thomke die Geschichte einer kleinen Änderung an der Darstellung von Anzeigenüberschriften bei Bing, die so starke Ergebnisse brachte, dass sie intern einen Alarm auslöste, weil sie zu gut schienen, um wahr zu sein. Die Idee hatte mehr als sechs Monate im Backlog gelegen. Sie steigerte den Umsatz um 12 %, was allein in den USA über 100 Millionen Dollar im Jahr wert war.
Diese Geschichte ist die Ausnahme. In einem Paper von 2014 schrieben Kohavi und Kollegen, dass die meisten Bing-Experimente scheitern und dass außergewöhnlich starke Ergebnisse Twymans Gesetz nahelegen: „Any figure that looks interesting or different is usually wrong!“
Nutze ihn nicht bei wenig Traffic. Wenn du viele Monate bräuchtest, um genug Leute zu erreichen, nimm einen Usability-Test oder Interviews. Nutze ihn nicht zum Erkunden. Er vergleicht nur Optionen, die du schon hast. Mehr dazu findest du in unserem ausführlicheren Leitfaden zu A/B-Tests für Product Manager.
Welches Risiko testet er, und wie stark ist die Evidenz?
Er testet Desirability: Bringt diese Version die Leute dazu, mehr von dem zu tun, was du willst? Die Evidenz ist Verhalten, von echten Menschen, die nicht wissen, dass sie in einem Test sind. Er misst, was im Testzeitraum passiert, und kann deshalb Langzeiteffekte übersehen. Siehe unseren Leitfaden zur Wahl eines Produktexperiments.
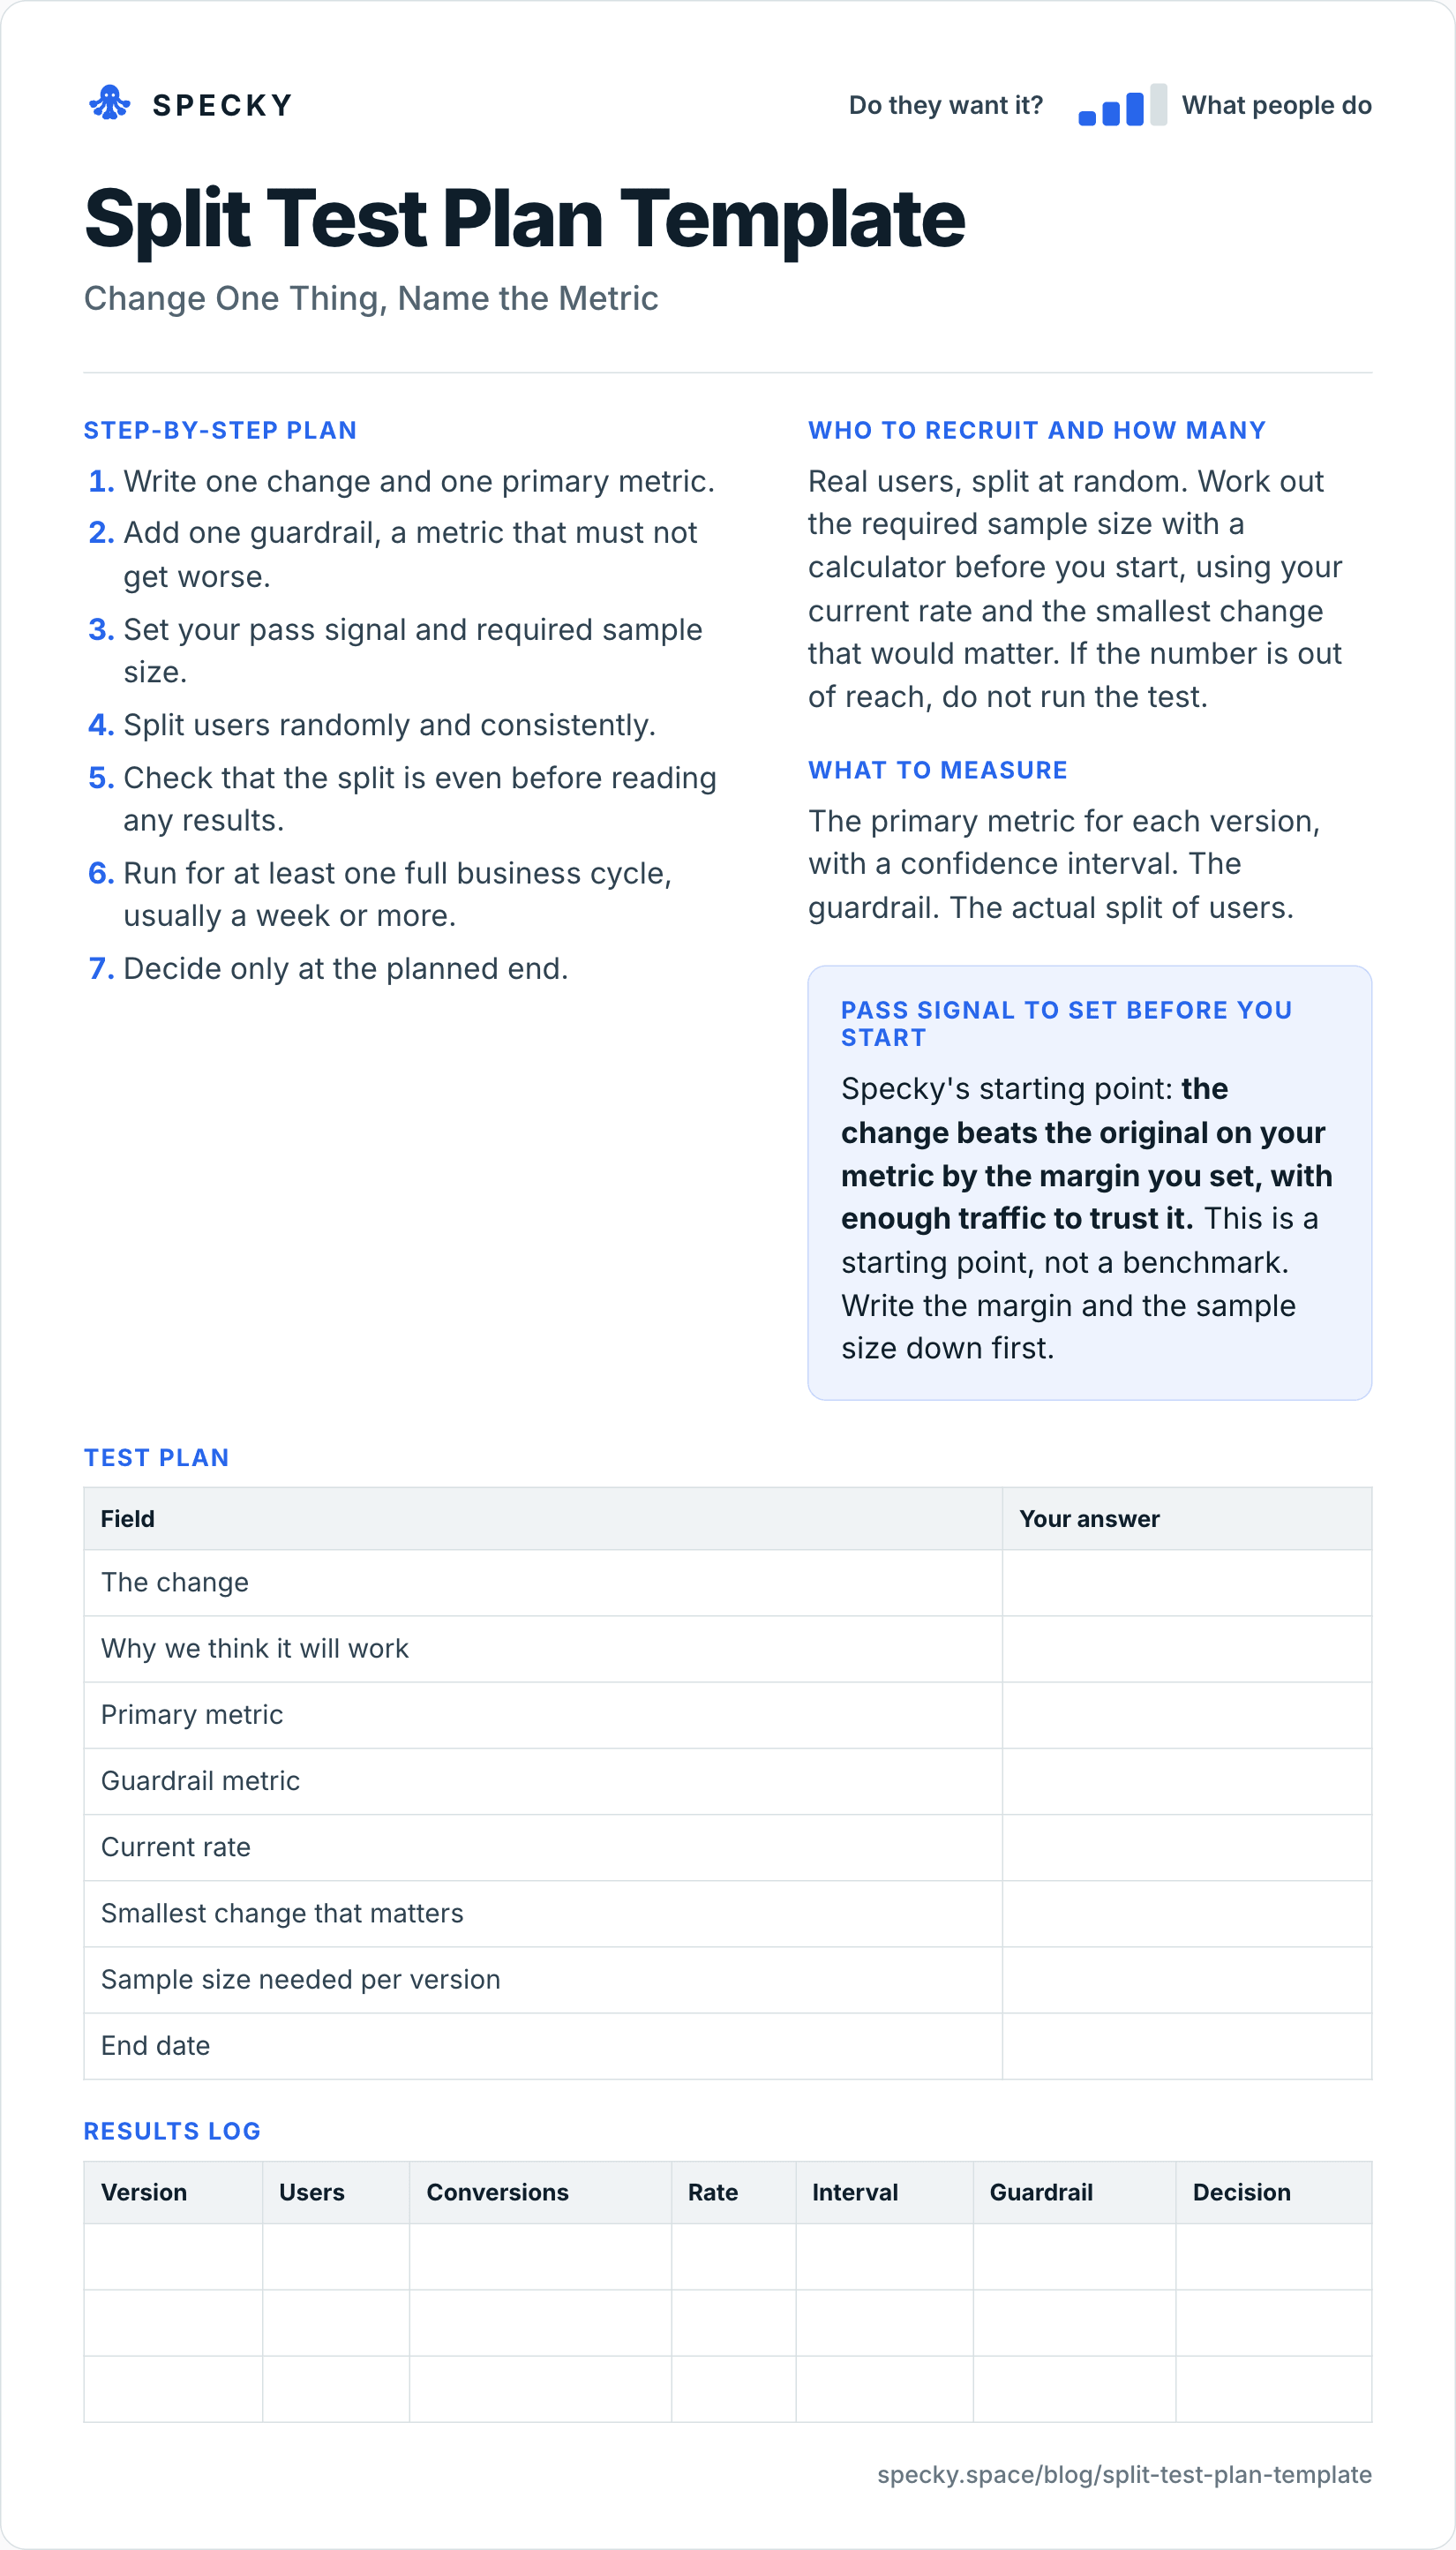
A/B-Test-Plan-Vorlage (kopieren und loslegen)
Öffne das Bild in voller Größe oder kopiere die Textversion unten.
Wen du rekrutierst und wie viele
Echte Nutzer:innen, zufällig aufgeteilt. Berechne die benötigte Stichprobengröße vor dem Start mit einem Rechner, anhand deiner aktuellen Rate und der kleinsten Änderung, die zählen würde. Ist die Zahl außer Reichweite, führ den Test nicht durch.
Schritt-für-Schritt-Plan
Schreib eine Änderung und eine Primärmetrik auf.
Ergänze eine Guardrail, eine Metrik, die nicht schlechter werden darf.
Lege dein Pass-Signal und die benötigte Stichprobengröße fest.
Teile Nutzer:innen zufällig und konsistent auf.
Prüfe, ob die Aufteilung gleichmäßig ist, bevor du Ergebnisse liest.
Lass den Test mindestens einen vollen Geschäftszyklus laufen, in der Regel eine Woche oder mehr.
Entscheide erst zum geplanten Ende.
Testplan
Feld
Deine Antwort
Die Änderung
Warum wir denken, dass sie funktioniert
Primärmetrik
Guardrail-Metrik
Aktuelle Rate
Kleinste relevante Änderung
Benötigte Stichprobengröße pro Version
Enddatum
Was du misst
Die Primärmetrik für jede Version, mit Konfidenzintervall. Die Guardrail. Die tatsächliche Aufteilung der Nutzer:innen.
Pass-Signal, das du vor dem Start festlegst
Speckys Ausgangspunkt: Die Änderung schlägt das Original bei deiner Metrik um die Marge, die du festgelegt hast, und es gibt genug Traffic, um dem Ergebnis zu trauen. Das ist ein Ausgangspunkt, kein Benchmark. Schreib zuerst die Marge und die Stichprobengröße auf.
Ergebnisprotokoll
Version
Nutzer:innen
Conversions
Rate
Intervall
Guardrail
Entscheidung
Wie viele Nutzer:innen brauchst du für einen A/B-Test?
Das hängt von deiner aktuellen Conversion-Rate und der kleinsten Änderung ab, die sich zu erkennen lohnt, dem Minimum Detectable Effect. Je kleiner eines von beidem ist, desto mehr Traffic brauchst du. Mit der zweiseitigen Formel in Evan Millers kostenlosem Rechner, bei dessen Standardwerten von 5 % Signifikanz und 80 % Power, ergibt sich folgende Stichprobe pro Version:
Aktuelle Conversion-Rate
Für einen relativen Anstieg von 5 %
10 % relativer Anstieg
20 % relativer Anstieg
2 %
etwa 310.000
etwa 78.000
etwa 19.800
5 %
etwa 120.000
etwa 30.200
etwa 7.700
12 %
etwa 46.300
etwa 11.700
etwa 2.900
20 %
etwa 25.300
etwa 6.300
etwa 1.600
Halbierst du den Effekt, den du nachweisen willst, brauchst du ungefähr viermal so viel Traffic, und niedrige Ausgangsraten brauchen weit mehr Leute als hohe.
Für eine Kontrolle ohne Rechner nimm Evan Millers Faustregel: n = 16σ² / δ², wobei δ der minimale Effekt ist und für eine Conversion-Rate p gilt σ² = p(1 − p). Bei 12 % und einem Anstieg auf 13,2 %: 16 × 0,12 × 0,88 ÷ 0,012² ≈ 11.700 pro Version.
Durchgerechnetes Beispiel: von der Stichprobengröße zum Enddatum
Dieses Beispiel ist anschaulich gemeint; es entspricht dem Beispiel weiter unten.
Aktuelle Rate: 12 % der Besucher:innen melden sich an.
Kleinste relevante Änderung: ein relativer Anstieg von 10 %, von 12 % auf 13,2 %.
Stichprobengröße: etwa 11.700 pro Version, also etwa 23.400 Besucher:innen insgesamt.
Traffic: etwa 860 Besucher:innen pro Tag erreichen die Anmeldeseite.
Wäre die Antwort sechs Monate gewesen, führ nicht einfach einen kleineren Test durch und hoffe. Teste eine größere Änderung, wähl eine Metrik mit höherer Basisrate oder nutze eine Methode, die weniger Traffic braucht.
Wie lange solltest du einen Split-Test laufen lassen?
Bis du die geplante Stichprobengröße erreicht hast und mindestens einen vollen Geschäftszyklus lang, in der Regel eine Woche oder mehr, weil sich Nutzer:innen unter der Woche und am Wochenende unterschiedlich verhalten.
Warum solltest du nicht zwischendurch aufs Ergebnis schauen?
Dashboards zeigen einen p-Wert, der voraussetzt, dass du nur einmal schaust, am Ende. Jeder zusätzliche Blick ist eine weitere Chance, dass Rauschen die Schwelle überschreitet. Evan Miller hat gezeigt, dass Testen nach jeder Beobachtung und Stoppen beim ersten p < 0,05 eine Falsch-positiv-Rate von 26,1 % ergibt, mehr als das Fünffache der 5 %, die du zu haben glaubst (Evan Miller, 2010).
Wenn du unbedingt früh schauen musst, lege die Messlatte höher: Schaust du 10-mal zwischendurch, brauchst du eine ausgewiesene Signifikanz von 1,0 %, um eine echte Rate von 5 % zu halten.
Warum braucht ein „signifikantes“ Ergebnis trotzdem eine Prüfung?
Kohavi und Kollegen rechnen es vor. Wenn eine von drei Ideen wirklich ein Gewinner ist, der Durchschnitt, den sie über Microsoft-Experimente berichteten, ist ein signifikantes Ergebnis in etwa 89 % der Fälle ein echter Treffer. Sind echte Durchbrüche eins zu 500, sinkt das auf 3,1 %. Überraschende Ergebnisse brauchen eine Wiederholung.
Was solltest du bei einem Split-Test messen?
Die Primärmetrik für jede Version, mit Konfidenzintervall, nicht nur als Prozentwert.
Eine Guardrail-Metrik, die nicht schlechter werden darf, etwa bezahlte Conversion, Rückerstattungen oder Seitenladezeit.
Die tatsächliche Aufteilung der Nutzer:innen. Wenn du 50/50 geplant hast und bei großen Zahlen 52/48 bekommst, stimmt etwas nicht. Das nennt man Sample Ratio Mismatch. Die Prüfung braucht nur die erwarteten Anteile und die beobachteten Zahlen und erkennt eine breite Palette von Datenproblemen (SRM-Checker von Lukas Vermeer und Kollegen). Lies keine Ergebnisse, bevor sie besteht.
Guardrails bei seltenen Ereignissen brauchen viel Traffic: Für den Nachweis eines Rückgangs von 10 % bei einer bezahlten Conversion von 1,2 % braucht es grob 130.000 Nutzer:innen pro Version. Wenn du das nicht erreichst, schreib vorab auf, was als Verletzung gilt, etwa „jeder Rückgang bei zahlenden Kund:innen blockiert den Launch“.
Split-Test vs. Landingpage-Test vs. Fake-Door-Test
Verursacht diese Änderung mehr von dem Verhalten, das wir wollen?
Tut jemand den nächsten Schritt für dieses Angebot?
Versuchen bestehende Nutzer:innen, ein Feature zu nutzen, das noch nicht gebaut ist?
Vergleich
Kontrolle vs. Variante, zufällig
Meist eine Seite gegen ein Ziel
Ein Button gegen ein Ziel
Evidenz
Kausal, Verhalten
Verhaltensbasiertes Interesse
Verhaltensbasiertes Interesse
Nutze einen Landingpage- oder Fake-Door-Test, um herauszufinden, ob es überhaupt Interesse gibt; nutze einen Split-Test, um herauszufinden, welche von zwei Versionen besser abschneidet.
Wie sieht ein Split-Test in der Praxis aus?
Dieses Beispiel ist erfunden, um die Methode zu zeigen. Ein Team, das ein Steuererklärungstool betreibt, will sein Anmeldeformular von sechs auf drei Felder kürzen. Es sagt voraus, dass die Anmeldungen um mindestens 10 % steigen, und legt die bezahlte Conversion als Guardrail fest.
Nach vier Wochen und 12.000 Besucher:innen in jeder Gruppe steigert das kürzere Formular die Anmeldungen um 14 %. Aber die bezahlte Conversion sinkt, und die Guardrail ist verletzt: Die zusätzlichen Anmeldungen sind Leute mit geringerer Absicht, die nie fertig werden.
Das Anmeldeziel besteht, die Guardrail nicht, also rollen sie es nicht unverändert aus. Sie probieren ein kürzeres Formular mit einer zusätzlichen Frage zur Art der Steuererklärung der Kund:innen.
So könnte das Protokoll aussehen:
Version
Nutzer:innen
Anmeldungen
Rate
Zahlende Kund:innen
Entscheidung
Sechs Felder (Kontrolle)
12.000
1.440
12,0 %
144
Drei Felder
12.000
1.642
13,7 %
131
Nicht ausrollen
Der Anstieg bei den Anmeldungen ist real: +1,7 Prozentpunkte, mit einem 95-%-Intervall von etwa +0,8 bis +2,5. Der Rückgang bei den Zahlenden, von 144 auf 131 Kund:innen, ist bei diesem Traffic zu klein, um ihn zu belegen, aber die vorab geschriebene Guardrail-Regel des Teams besagte, dass weniger zahlende Kund:innen den Release blockieren.
Was sind die häufigsten Fehler bei Split-Tests?
Zwischendurch schauen. Früh nachsehen und stoppen, wenn es gut aussieht, erzeugt falsche Gewinne.
Mehrere Dinge ändern. Du weißt dann nicht, was gewirkt hat.
Keine Guardrail. Du kannst eine Metrik gewinnen und das Geschäft verlieren.
Zu wenig Traffic. Ein Test ohne ausreichende Power ist nur teures Rauschen.
Den Neuheitseffekt ignorieren. Leute klicken auf Neues, nur weil es neu ist.
Wann er nicht funktioniert: bei wenig Traffic, bei großen Wetten, die sich nicht aufteilen lassen, bei Effekten, die Monate brauchen, und dort, wo Nutzer:innen miteinander reden, sodass die Gruppen nicht unabhängig sind.
Ist es ethisch, einen Split-Test durchzuführen, ohne es den Nutzer:innen zu sagen?
Gewöhnliche Änderungen wie ein kürzeres Formular oder eine neue Überschrift werden routinemäßig getestet, ohne es jedem einzelnen Nutzer zu sagen. Die Grenze ist Schaden. Teste nichts, was du nicht auch für alle ausrollen würdest, zeig ähnlichen Kund:innen keine unterschiedlichen Preise ohne klare Richtlinie, und zähle nur Leute, die dein Consent-Banner zu tracken erlaubt.
So führst du ihn in Specky durch
Klick auf der Seite „Assumptions“ auf die Notiz und wähle Pick a test, dann Split test. Specky füllt die Schritte, das Pass-Signal und einen Zeitplan von zwei Wochen aus.
Für eine Änderung in deinem Produkt führ den Split mit deinem eigenen Feature-Flag- oder Experiment-Tool durch. Specky ändert dein Produkt nicht. Es liest die Zahlen aus verbundener Analytics, und du hängst das Ergebnis als Evidenz an.
Testest du eine Specky-Validierungsseite, kann der Split dort stattfinden. Richte in Experiment analytics eine Kontrolle und bis zu fünf Varianten ein, und Specky zeigt die Conversion pro Version, 95-%-Intervalle, ob du genug Leute hast, und optional eine Guardrail. Das Urteil bleibt vorsichtig, solange die Stichprobe klein ist.
Klick auf Start running und halte das Ergebnis zum geplanten Ende fest.
Ein Bestehen erscheint auf dem Board als Supported, weil ein kontrollierter Vergleich dessen, was Leute getan haben, Verhalten ist.
Was solltest du mit jedem Ergebnis tun?
Supported: Roll die Änderung aus. Notiere die Größe des Gewinns und prüfe die Analytics in einem Monat noch einmal, um zu sehen, ob der Effekt anhält.
Unclear: Das Ergebnis liegt innerhalb der Fehlermarge. Behalte die einfachere Version oder finde mit ein paar Interviews heraus, warum.
Contradicted: Die Änderung hatte keine Wirkung oder hat alles verschlechtert. Roll sie nicht aus. Jede Wette, die auf dieser Notiz ruht, erscheint jetzt als Contradicted.
Häufig gestellte Fragen
Wie viel Traffic brauchst du für einen Split-Test?
Das hängt von deiner aktuellen Conversion-Rate und der kleinsten relevanten Änderung ab. Bei einer Conversion-Rate von 12 % braucht der Nachweis eines relativen Anstiegs von 10 % bei Standardeinstellungen etwa 11.700 Nutzer:innen pro Version; bei 2 % etwa 78.000. Wenn du die Zahl nicht in vertretbarer Zeit erreichst, nutze eine andere Methode.
Warum solltest du einen Split-Test nicht vorzeitig beenden?
Wer stoppt, wenn die Ergebnisse gut aussehen, macht falsche Gewinne deutlich wahrscheinlicher, weil die Ergebnisse am Anfang stark schwanken. In Evan Millers schlimmstem Fall ergibt Testen nach jedem Besucher eine Falsch-positiv-Rate von 26,1 % statt 5 %. Lege Enddatum und Stichprobengröße vorab fest.
Was ist eine Guardrail-Metrik?
Eine Guardrail-Metrik ist eine Zahl, die während eines Tests nicht schlechter werden darf, selbst wenn sich deine Hauptmetrik verbessert, etwa bezahlte Conversion, Rückerstattungen oder Seitengeschwindigkeit. Sie verhindert, dass du eine Metrik gewinnst und dem Geschäft schadest. Schreib die Regel, was als Verletzung gilt, vor dem Teststart auf.
Was ist der Unterschied zwischen einem Split-Test und einem A/B-Test?
In der Praxis keiner. Beide zeigen einem zufälligen Teil der Nutzer:innen eine Änderung und vergleichen eine Metrik mit einer Kontrollgruppe; Forschende nennen das ein Online Controlled Experiment. Mehrere Änderungen in Kombination zu testen ist ein multivariater Test, der deutlich mehr Traffic braucht.
GDPR-aligned. EU workspace data is stored in Frankfurt, Germany. GDPR and EU data Built in Vienna, Austria. A product of influence solutions fm GmbH (FN 675374y). Imprint 14-day trial. Card required, and nothing is charged until day 14. 30-day refund after subscribing. See pricing