5 de noviembre de 2026Actualizado el Fathy Shalaby16 min de lectura
Síntesis de investigación con IA: separa la evidencia de la interpretación
La IA ordena una carpeta de entrevistas en minutos, pero los estudios muestran que se le escapan los temas interpretativos. Un flujo de cinco pasos, un prompt y una lista de revisión mantienen cada afirmación unida a su fuente.
La síntesis de investigación con IA consiste en usar un modelo de lenguaje para organizar notas de entrevistas, tickets de soporte y observaciones de sesiones en posibles temas, mientras las personas comprueban cada tema contra la evidencia original y se responsabilizan de la interpretación. Reduce el primer pase de horas a minutos. Falla cuando los temas generados se tratan como hallazgos: en comparaciones publicadas, los modelos coinciden con los investigadores humanos mucho más a menudo en los temas descriptivos que en los interpretativos.
La IA puede convertir una carpeta de notas de entrevistas en un resumen ordenado en segundos. Eso es útil para encontrar material que merece inspección. También es una forma fácil de convertir una interpretación incierta en una decisión de producto que suena segura. Esta guía es para fundadores, primeros PM e ingenieros de producto que tienen un puñado de llamadas, tickets y notas de uso, no un departamento de investigación con tiempo para releerlo todo.
Ideas clave
En un estudio de 2024, ChatGPT y Bard encontraron cada uno 5 de los 7 temas que hallaron los codificadores humanos (71 %), pero coincidieron con los humanos en solo el 36–47 % de los códigos individuales (Prescott et al., 2024).
El mismo análisis con IA tardó unos 20 minutos, frente a una media de 567 minutos de los codificadores humanos. La velocidad es real; la precisión, no.
En 30 entrevistas clínicas japonesas, ChatGPT-4 coincidió con los investigadores en más del 80 % de los temas descriptivos, pero solo en alrededor del 30 % de los temas que requerían interpretación cultural o emocional (Sakaguchi et al., 2025).
El 67 % de los profesionales de UX que analizan sus propios datos de investigación usa IA para ello a menudo o siempre, pero la calidad de los resultados es la principal barrera de adopción, mencionada por el 54 % (NN/g, 2026).
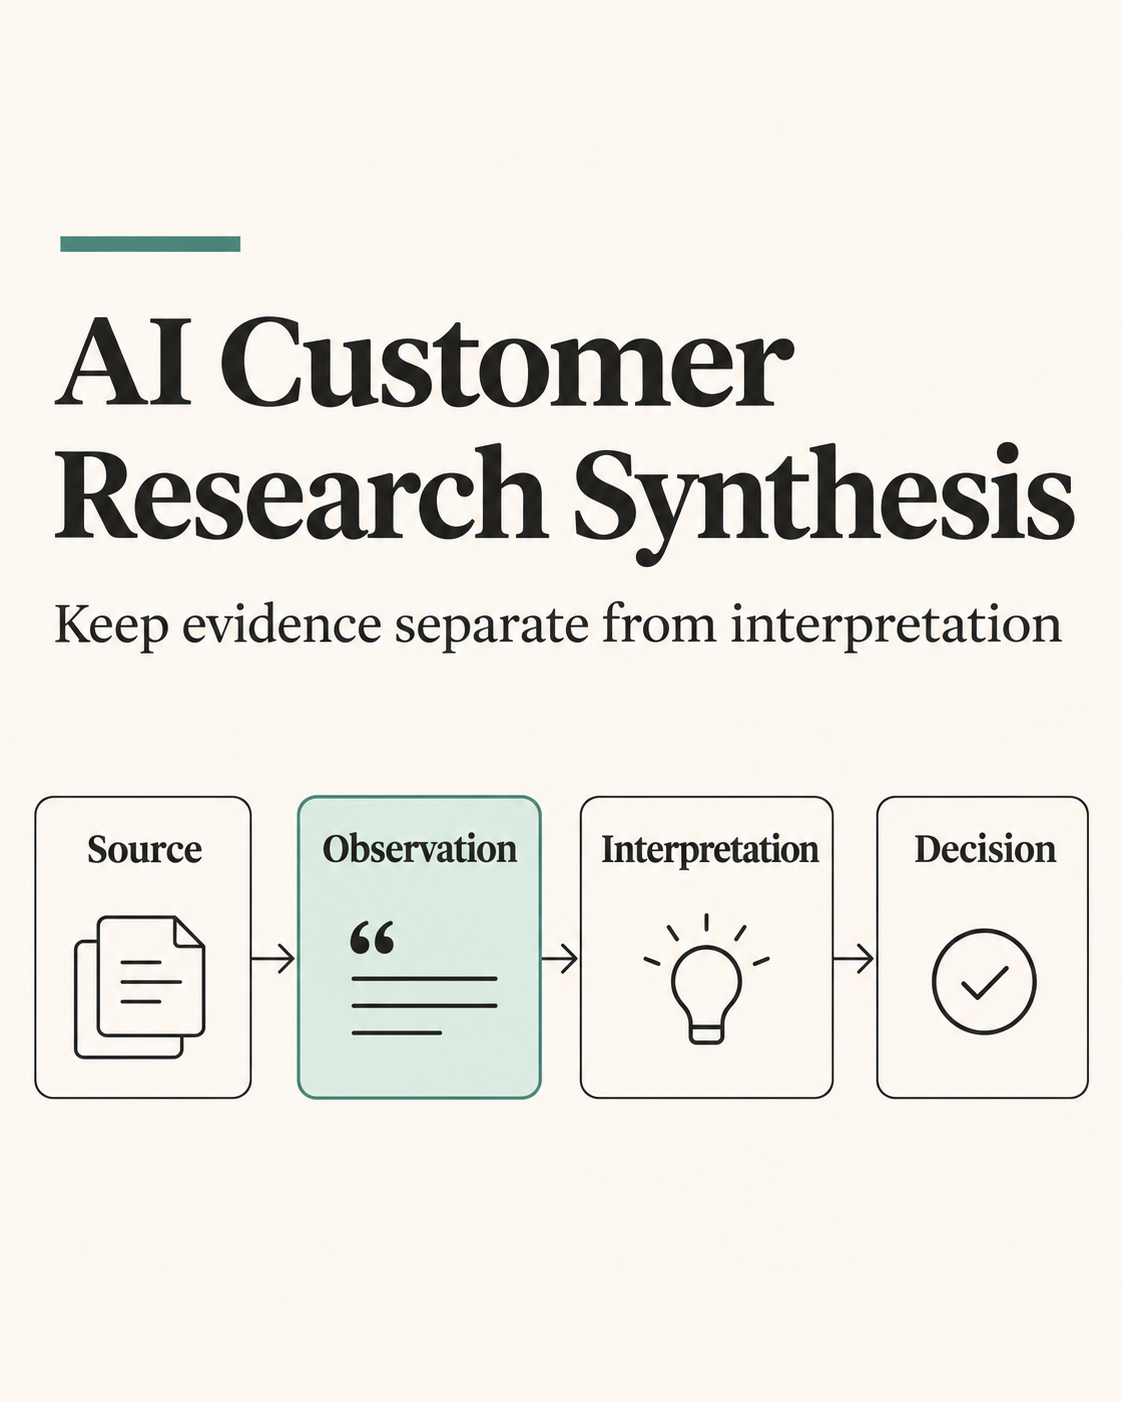
Mantén cuatro capas separadas: fuente, observación, interpretación, decisión. La IA puede ayudar con las dos primeras. Las personas son dueñas de las dos últimas.
¿Qué es la síntesis de investigación con IA y qué no debería hacer?
La síntesis es el paso posterior a las entrevistas: encontrar patrones y diferencias significativas entre conversaciones y luego decidir qué significan para una decisión de producto. Nuestra guía sobre explica el método manual. La síntesis de investigación con IA delega parte de ese trabajo en un modelo: transcribir, extraer observaciones, agrupar afirmaciones parecidas y redactar etiquetas de temas.
Lo que no debería hacer es concluir. Un modelo no conoce tu estrategia, el historial de la cuenta del cliente ni qué participante encajaba mal en el estudio. Cuando Nielsen Norman Group revisó generadores de insights con IA en 2023, las herramientas no podían asimilar los objetivos del estudio, los hallazgos anteriores ni el contexto de cada participante, y por eso sus temas salían sin priorizar (NN/g, 2023).
¿Por qué la evidencia y la historia son cosas distintas?
Imagina a tres entrevistados describiendo un paso de configuración confuso. Uno dice que no sabía qué fuente conectar. Otro conectó la cuenta equivocada. Un tercero pide una lista de comprobación para la configuración.
Las observaciones son concretas. «Los usuarios necesitan una lista de comprobación de onboarding» ya es una interpretación. «El selector de integraciones es el problema» es otra. Ninguna de las dos debería guardarse como si fuera una cita directa.
Una síntesis útil mantiene visibles cuatro capas:
Fuente: la entrevista original, el mensaje de soporte o la sesión observada.
Observación: lo que la persona dijo o hizo, con contexto suficiente para interpretarlo.
Interpretación: la posible necesidad, causa o patrón que infieres.
Decisión: lo que el equipo hará, probará, aplazará o aprenderá a continuación.
Cuando estas capas se funden en un solo resumen, el equipo pierde la posibilidad de cuestionar la interpretación sin poner en duda que la fuente misma sea real. NN/g formula la regla de la investigación sin rodeos: hay que «diferenciar entre nuestras interpretaciones o suposiciones y lo que los participantes dijeron o hicieron» («differentiate between our interpretations or assumptions and what the participants said or did», NN/g, 2023). Los resúmenes de IA son prosa fluida, y la prosa fluida es justo donde esa línea desaparece.
¿Qué tan precisa es la IA al analizar investigación cualitativa?
Lo bastante precisa para encontrar los temas obvios; no lo bastante para fiarte de ella en los sutiles. Las comparaciones publicadas apuntan en la misma dirección:
4 herramientas de investigación con IA (3 generadores de insights, 1 colaborador)
Transcripción y agrupación aproximada
Resúmenes vagos, sin contexto, citas sin fuente
No se midió
Prescott y sus colegas descubrieron que los codificadores humanos eran mejores con los temas matizados e interpretativos y concluyeron que los enfoques híbridos son necesarios. Sakaguchi y sus colegas calificaron a ChatGPT-4 de herramienta auxiliar y subrayaron que sigue haciendo falta experiencia humana.
Son estudios de investigación en salud y de UX, no de discovery en startups, así que no traslades los porcentajes a tus propias entrevistas. Sí respaldan una regla de trabajo: cuanto más depende un tema del contexto, de la emoción o de lo que alguien dejó sin decir, menos debes confiar en una etiqueta generada sin leer la fuente.
¿Qué cuentan los profesionales?
La encuesta de NN/g de octubre de 2026 a 521 profesionales de UX muestra lo normal que se ha vuelto el análisis con IA (NN/g, 2026):
El 67 % de quienes analizan sus propios datos de investigación usa IA para hacerlo a menudo o siempre.
Alrededor de 9 de cada 10 de quienes usan IA para análisis, investigación documental o codificación dijeron que hacía el trabajo más rápido.
El 54 % mencionó la preocupación por la calidad de los resultados como una barrera, la más común.
Entre 149 comentarios negativos, los resultados poco fiables y la carga de verificarlos fueron lo más citado, en 40.
El 61 % nunca había usado IA para entrevistar a usuarios.
NN/g lo describe como una muestra por conveniencia, así que léelo como una tendencia y no como una estimación de mercado. La tendencia es clara: los profesionales usan IA para analizar porque es más rápida, y dedican el tiempo ahorrado a comprobarla.
¿Cómo se hace una síntesis de investigación con IA, paso a paso?
Cinco pasos. Los dos primeros ocurren antes de abrir una herramienta de IA; en los dos últimos es donde las personas demuestran su valor.
1. Define la decisión antes de resumir
Escribe la decisión de producto que la investigación debe informar. Por ejemplo:
¿Simplificamos el flujo de conexión del primer uso, o primero explicamos qué fuente debe conectar el usuario?
Esto evita que un prompt amplio como «analiza estas entrevistas» produzca temas atractivos que no ayudan con la decisión que tienes delante. También facilita notar cuándo el material no responde a la pregunta. Si no puedes nombrar la decisión, no estás listo para sintetizar; puede que aún estés en la etapa del proceso de product discovery en la que se decide qué aprender.
2. Prepara el material de origen con responsabilidad
Usa solo material que tu equipo tenga permitido procesar en la herramienta de IA elegida, según el consentimiento que dieron los participantes. Elimina los datos personales o sensibles salvo que tengas un motivo claro y aprobado para conservarlos; NN/g señala que algunas herramientas de investigación ya borran automáticamente nombres, correos electrónicos e identificadores similares (NN/g, 2024). Conserva un ID de fuente y una fecha para que un revisor pueda encontrar el registro original, y controla el acceso a la transcripción subyacente.
No combines notas de distintos grupos de clientes o preguntas de investigación sin etiquetarlas. Una entrevista con un fundador, un ticket de soporte y una sesión de usabilidad observada pueden ser útiles; no son evidencia intercambiable. Etiqueta cada registro con su tipo y el segmento del participante antes de que el modelo lo vea.
3. Pide a la IA que organice, no que concluya
Dale al modelo una tarea acotada. Pídele que:
extraiga las observaciones relevantes para la decisión;
adjunte a cada observación un ID de fuente y el pasaje exacto que la respalda;
separe las afirmaciones directas de las necesidades inferidas;
enumere contraejemplos y evidencia contradictoria;
marque el contexto que falta y las preguntas que no puede responder;
evite contar menciones repetidas como usuarios independientes salvo que el conjunto de fuentes respalde ese recuento.
No pidas una persona definitiva, una conclusión para todo el mercado ni una roadmap ordenada por prioridad a partir de unas pocas conversaciones. Un modelo puede dar formato a la incertidumbre hasta sacarla de la vista, a menos que le pidas expresamente que la conserve. NN/g descubrió que el agrupamiento con IA a menudo junta elementos por palabras clave compartidas y no por significado compartido, así que trata los primeros grupos como una ayuda para ordenar (NN/g, 2024).
4. Verifica cada afirmación que podría cambiar la roadmap
Un PM o un fundador debería abrir la fuente original de cada tema propuesto de alto impacto. Comprueba si la cita respalda la afirmación, si el contexto que la rodea cambia su significado y si el modelo fusionó las experiencias de personas distintas.
Después busca la evidencia que no encaja. Si dos usuarios describen el mismo síntoma por motivos distintos, conserva ambas explicaciones. Si una sola historia vívida es el único apoyo de una idea, márcala como una señal que investigar y no como un patrón demostrado.
Una tabla de revisión práctica se ve así:
Tema propuesto
Fuente de apoyo
¿Qué se observa directamente?
Interpretación
Contraevidencia o laguna
Siguiente paso
La fuente de la configuración no está clara
Entrevista 04, nota de sesión
La persona conectó una cuenta distinta de la que pretendía
Las etiquetas de la elección pueden ser ambiguas
Una observación; aún sin reproducción de la tarea
Revisar la grabación y probar la comprensión de las etiquetas
Los usuarios quieren una lista de comprobación
Entrevista 07, transcripción
La persona pidió una lista de comprobación tras quedarse atascada
Puede que necesiten orientación en el punto de decisión
La petición puede reflejar la preferencia de esta persona
Comparar con casos de soporte y observar el primer uso
La tabla es deliberadamente modesta. No convierte dos conversaciones en un porcentaje ni afirma que «los usuarios» se comportan todos igual.
5. Registra la decisión y su detonante de aprendizaje
Cuando el equipo haya revisado la evidencia, registra qué decidió y por qué. Incluye al responsable de la decisión, las fuentes de apoyo, la incertidumbre más importante y qué evidencia futura cambiaría la elección. Un registro de decisiones de producto le da un hogar permanente.
Por ejemplo:
Decisión: Probar descripciones de fuente más claras antes de construir una lista de comprobación de configuración completa.
Por qué: Dos fuentes independientes apuntan a incertidumbre en la elección de conexión, pero no hemos observado suficientes sesiones de primer uso para saber si el problema son las etiquetas, el orden o la falta de orientación.
Detonante de revisión: Volver a mirarlo tras revisar varias sesiones de configuración representativas, o si los reportes de soporte apuntan a otro punto de fallo.
La muestra que necesitas depende de la decisión, del riesgo y de lo variados que sean tus usuarios. No trates un número fijo de entrevistas como prueba de saturación o representatividad. Si la evidencia sigue mixta, el siguiente paso útil puede ser otra observación, no un resumen más pulido.
¿Qué prompt usar para la síntesis de investigación con IA?
Usa dos pasadas: una para organizar y otra para ayudarte a priorizar la revisión. Puedes adaptar este primer prompt a un conjunto de fuentes permitido y debidamente protegido:
Ayúdame a organizar estas notas de investigación para la decisión: [pregunta de la decisión]. Para cada observación propuesta, incluye el ID de la fuente y el pasaje exacto que la respalda. Separa la evidencia directa de la interpretación. Enumera ejemplos contradictorios, contexto que falta y explicaciones alternativas. No infieras frecuencia más allá de los registros proporcionados. No recomiendes una decisión de roadmap. Si una afirmación no puede respaldarse con un pasaje, márcala como no respaldada. Devuelve una tabla con observación, cita, fuente, interpretación, motivo de confianza, contraevidencia y pregunta de seguimiento.
Después ejecuta un segundo prompt sobre el resultado:
Para cada tema anterior, enumera los participantes distintos (no las menciones) que lo respaldan, por ID de fuente. Señala cualquier tema respaldado por un solo participante, cualquier cita que no encuentres palabra por palabra en las fuentes y cualquier tema que combine participantes de segmentos distintos.
La segunda pasada no es una verificación. Un modelo que revisa su propio trabajo puede repetir sus propios errores. Es una forma de ordenar los temas para que la comprobación humana empiece por los más débiles. Ninguno de los dos prompts hace fiable el resultado por sí solo; juntos lo hacen más fácil de inspeccionar.
¿Cómo revisas una síntesis de IA antes de que llegue a la roadmap?
Copia esta lista en tu documento de síntesis y márcala antes de que un tema se convierta en un ticket o en una línea de PRD:
La decisión que informa esta síntesis está escrita arriba del todo.
Cada cita es literal: has buscado en la transcripción y la has encontrado.
Cada tema indica cuántas personas distintas lo respaldan, no cuántas menciones.
Cada tema nombra el segmento, el rol o la situación de esas personas.
La contraevidencia figura bajo el tema que cuestiona.
Las afirmaciones sobre por qué actúan las personas o cómo se sienten están marcadas como interpretación.
Los temas que descansan en una sola persona están etiquetados como señales que investigar.
Se anotan las voces ausentes: con quién no hablaste.
Ejemplo práctico: revisar una síntesis en una hora
Este ejemplo es ilustrativo. Supón un equipo de cinco personas con 8 entrevistas de onboarding, unas 6 horas de grabaciones y 40 tickets de soporte. GOV.UK sugiere aproximadamente 1 hora de análisis por cada 2 horas de investigación (GOV.UK), así que un pase manual solo de las llamadas son unas 3 horas. NN/g aconseja presupuestar al menos tanto tiempo para el análisis como para la recopilación, lo que sería más (NN/g, 2022).
El pase con IA tarda 10 minutos y propone 7 temas respaldados por 31 citas. La PM revisa solo los 3 temas que podrían cambiar el próximo sprint: 14 citas, unos 45 minutos de lectura. Encuentra 2 citas parafraseadas en lugar de literales. Un tema, «los usuarios quieren una lista de comprobación», descansa en 2 personas que pidieron cosas distintas. Otro, «la fuente de la configuración no está clara», se sostiene en 5 de 8 entrevistas y 9 tickets.
Solo ese último tema pasa al registro de decisiones, y las 2 peticiones de lista de comprobación se quedan como pregunta abierta. El tiempo total es de aproximadamente una hora, y cada afirmación que llega a la roadmap ha sido leída en su fuente por una persona. Para la misma disciplina aplicada a las specs escritas con IA, consulta el rastreo de afirmaciones contra la alucinación en specs.
¿Qué tareas de síntesis conviene dar a la IA y cuáles quedarte?
Tarea
¿Dársela a la IA?
Por qué
Revisión humana
Transcripción
Sí
Madura y rápida
Comprobar por muestreo nombres, jerga y voces superpuestas
Eliminar datos personales
Sí, con revisión
Ahorra un paso tedioso
Confirmar que no queda nada identificable
Extraer observaciones con citas
Sí
Buena para encontrar pasajes
Las citas deben ser literales y con fuente
Primer agrupamiento
Sí
Ayuda rápida para ordenar
Reagrupar por situación, no por palabra clave
Etiquetar temas interpretativos (por qué, emoción)
Las menciones no son personas; las muestras son pequeñas
Usar analítica o una encuesta para la prevalencia
Analizar sesiones de usabilidad a partir de transcripciones
No
Las transcripciones se pierden lo que los usuarios hicieron (NN/g, 2023)
Ver la grabación
Recomendar qué construir
No
Al modelo le faltan estrategia y compromisos
El equipo decide
Buscar en investigaciones pasadas
Sí
Bueno para «¿qué dijeron los clientes sobre X?»
Abrir la fuente antes de citar
¿Cuáles son los errores comunes en la síntesis de investigación con IA?
Tratar un resumen fluido como un hallazgo. El pulido no es evidencia. Un tema es un hallazgo solo después de que alguien ha leído sus fuentes.
Contar menciones como personas. Un cliente frustrado que plantea un problema cinco veces es un dato, no cinco.
Mezclar segmentos. Un fundador en solitario y un equipo de 50 personas pueden describir el mismo síntoma por motivos distintos. Promediarlos inventa un usuario que no existe.
Descartar contraejemplos. Los modelos tienden a resolver la tensión en una historia limpia. Pide las contradicciones de forma explícita y mantenlas visibles.
Dejar que el resumen sustituya a la fuente. Mantén la transcripción o el ticket a un clic de cada afirmación, o nadie podrá cuestionar la interpretación más adelante.
Sintetizar demasiado tarde. Los insights se degradan. Los equipos que practican continuous discovery sintetizan unas pocas entrevistas cada vez, mientras el contexto está fresco.
La IA tampoco puede arreglar una muestra escasa o sesgada. Si solo hablaste con tus clientes más contentos, una síntesis perfecta de esas llamadas sigue siendo una síntesis de tus clientes más contentos. Mejores preguntas ayudan; nuestra plantilla de entrevista con clientes se centra en el comportamiento reciente y no en las opiniones.
Dónde encaja Specky
Specky lee llamadas con clientes, feedback, Slack, Jira y analítica y los integra en un Product Graph; después redacta specs y tickets con citas en línea que remiten a la evidencia, para que un revisor pueda abrir la fuente detrás de cada afirmación. Alex, el agente de investigación de Specky, hace entrevistas con clientes desde un enlace para compartir, así que la investigación no espera a los calendarios. La regla de esta guía sigue valiendo: una cita hace comprobable una afirmación, no verdadera. Alguien del equipo sigue leyendo la fuente antes de que la afirmación llegue a la roadmap.
Preguntas frecuentes
¿Puede la IA sintetizar investigación de clientes por sí sola?
No. La IA puede transcribir, extraer citas y proponer temas mucho más rápido que una persona, pero las comparaciones publicadas muestran que solo coincide con los codificadores humanos en el 36–47 % de los códigos individuales y en alrededor del 30 % de los temas interpretativos. Úsala para el primer pase y haz que alguien que conozca el producto y a los clientes revise cada tema que pueda cambiar una decisión.
¿Qué tan precisa es la IA en el análisis temático comparada con los humanos?
Depende del tipo de tema. ChatGPT-4 coincidió con los investigadores humanos en más del 80 % de los temas descriptivos en un estudio de 2025, pero solo en alrededor del 30 % de los que requerían interpretación cultural o emocional. Un estudio de 2024 encontró que la IA acertó el 71 % de los temas inductivos de los humanos. Espera buena cobertura de los temas obvios y un juicio débil sobre el significado.
¿Cómo evitas que la IA invente citas?
Exige un ID de fuente y el pasaje exacto para cada observación, e indica al modelo que marque como no respaldado todo lo que no pueda sustentar. Después busca en la transcripción cada cita que respalde un tema de alto impacto. NN/g descubrió que algunas herramientas de investigación con IA atribuían citas sin nombrar la sesión ni la marca de tiempo, lo que hace imposible esta comprobación; elige herramientas que citen sus fuentes.
¿Es seguro subir entrevistas de clientes a una herramienta de IA?
Solo si los participantes dieron su consentimiento para ese tratamiento y tu organización ha aprobado la herramienta para este tipo de datos. Elimina los nombres, correos y otros identificadores que no necesites, comprueba dónde almacena y procesa los datos la herramienta, y restringe quién puede ver las transcripciones en bruto. Bajo el RGPD, las grabaciones y transcripciones de entrevistas son datos personales siempre que se pueda identificar a un participante.
¿Cuántas entrevistas necesitas antes de que la síntesis con IA sea útil?
La IA ayuda desde la primera entrevista, para transcribir y extraer observaciones. Los temas entre entrevistas necesitan varias conversaciones sobre la misma decisión antes de que un patrón merezca comprobarse. El número adecuado depende de lo variados que sean tus usuarios y de lo arriesgada que sea la decisión. Las entrevistas explican por qué ocurre algo; usa analítica o una encuesta para saber con qué frecuencia.
GDPR-aligned. EU workspace data is stored in Frankfurt, Germany. GDPR and EU data Built in Vienna, Austria. A product of influence solutions fm GmbH (FN 675374y). Imprint 14-day trial. Card required, and nothing is charged until day 14. 30-day refund after subscribing. See pricing