16 de noviembre de 2026Fathy Shalaby7 min de lectura
Cómo anotar outputs de IA como PM: separa los fallos de producto de las preferencias
Un método práctico de revisión para productos con IA: separa fallos de política, falta de contexto y preferencias personales para que el feedback real mejore tu producto.
Un revisor le da cuatro estrellas a la respuesta de una IA. ¿Qué debería cambiar el equipo de producto?
Quizá la respuesta no abordó la pregunta del usuario. O tal vez incluyó una afirmación sin fuentes. Puede que los datos fueran correctos, pero el tono resultara demasiado rígido. O quizá el revisor prefiere otra estructura, aunque la respuesta haya cumplido su función.
Estas reacciones son útiles, pero describen cosas totalmente distintas. Si todas se reducen a «calidad: 4/5», el equipo pierde la información que necesita para mejorar el producto.
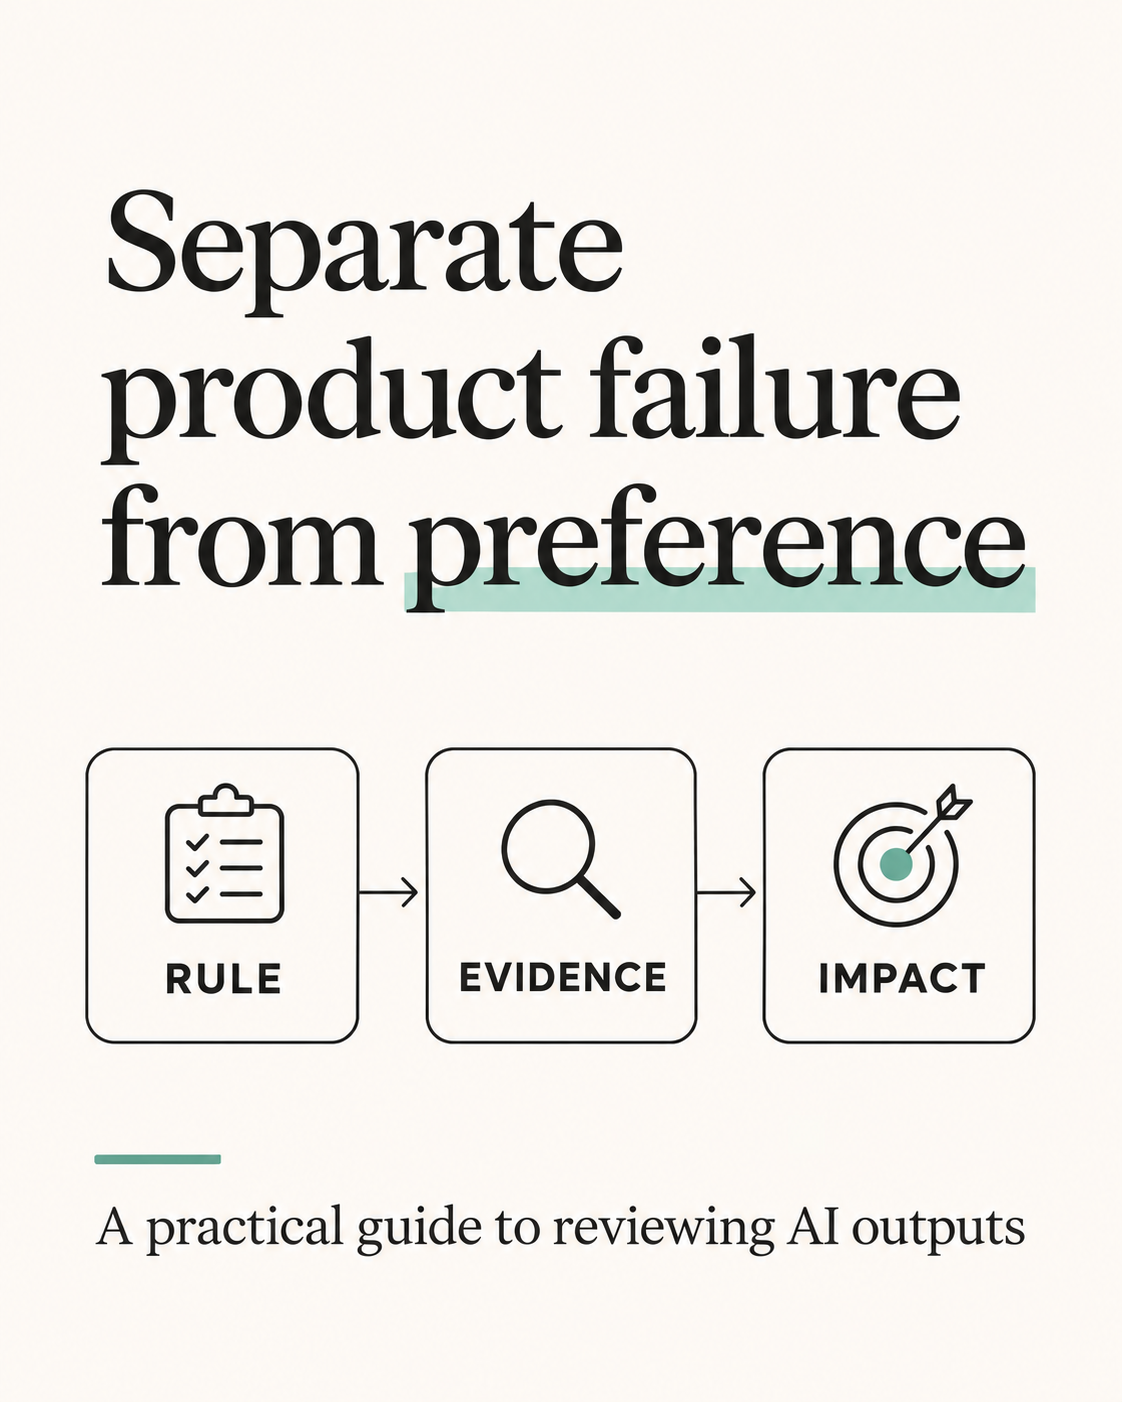
Un proceso de anotación práctico empieza por separar qué hizo el output, qué regla de producto cumplió o vulneró y qué prefería el revisor a nivel personal. Así, la revisión deja de ser un concurso de popularidad sobre texto generado y se convierte en una herramienta para definir con precisión el comportamiento del producto.
Decide qué tipo de criterio estás recopilando
Antes de pedir a la gente que etiquete outputs, define qué deben representar esas etiquetas.
A veces, el producto necesita una política coherente y estricta. Por ejemplo, el brief de un producto generado por IA jamás debe presentar como un hecho probado la afirmación de un cliente que no cuente con fuentes. Los revisores deben aplicar esa regla siempre. Esto es un juicio de política: el equipo está definiendo un comportamiento esperado y único para el producto.
Otras veces, el producto debe preservar la diversidad de necesidades de los usuarios. Puede que un product manager prefiera un resumen muy conciso, mientras que otro necesite más nivel de detalle para una revisión con stakeholders. Si ambos formatos cumplen su objetivo, registrar esa preferencia ayuda al producto a entender distintos contextos. Esto es un juicio de preferencia, no un fallo del producto.
Las investigaciones sobre anotación en tareas lingüísticas subjetivas describen una distinción parecida: capturar perspectivas diversas frente a instruir a los anotadores para que apliquen una política predefinida. La elección depende de para qué se va a utilizar ese conjunto de datos. La misma decisión se aplica cuando un equipo de producto revisa outputs de IA: ¿estás aprendiendo qué prefieren los usuarios o decidiendo qué debe hacer obligatoriamente el producto?
Escribe el propósito justo al inicio del formulario de revisión:
Estamos recopilando estas etiquetas para decidir si el output de la IA cumple el comportamiento acordado del producto para esta tarea.
O bien:
Estamos recopilando estas reacciones para aprender qué estilos válidos de output funcionan mejor para distintos usuarios y situaciones.
Un equipo puede recoger ambos tipos, pero las etiquetas deben mantenerlos separados.
Etiqueta el comportamiento antes de juzgar la redacción
Para cada output, registra tres elementos:
Comportamiento observado: ¿Qué hizo realmente el sistema?
Criterio: ¿Qué regla acordada del producto se aplica aquí?
Impacto: ¿Qué podría ocurrirle al usuario si este comportamiento se mantiene tal cual?
En una funcionalidad de síntesis de research, un conjunto básico de etiquetas de comportamiento podría ser:
Etiqueta
Cuándo utilizarla
Tarea no resuelta
El output no responde al trabajo que el usuario le pidió hacer
Afirmación sin fundamento
Un dato factual no puede rastrearse hasta el material proporcionado
Omisión importante
Falta evidencia relevante o una contradicción significativa
Confusión de contexto
El output mezcla fuentes o personas que deberían permanecer diferenciadas
Siguiente paso incorrecto
La recomendación no se deriva de la evidencia ni del objetivo planteado
Preferencia
El output funciona, pero el revisor elegiría otro estilo o estructura
Imposible de juzgar
Falta la fuente o el contexto de la tarea necesarios para evaluarlo
Estas etiquetas son solo un punto de partida. Adáptalas al trabajo real del usuario y a los riesgos de tu producto. Una etiqueta como «alucinación» suele ser demasiado vaga para orientar una solución. En cambio, «la afirmación sobre el motivo de baja de un cliente no tiene ningún fragmento de entrevista que la respalde» le indica al equipo qué falló con exactitud y qué evidencia lo resolvería.
Haz que cada fallo sea auditable
Cuando un revisor señale un fallo de producto, pídele un breve rastro de evidencia:
Seleccionar la frase o sección exacta en el output.
Enlazar la fuente o la instrucción de la tarea que debía seguirse.
Describir el comportamiento esperado en una sola frase.
Explicar el impacto para el usuario.
Indicar la gravedad de forma independiente a la certeza en la etiqueta.
Por ejemplo:
Campo
Ejemplo
Fragmento del output
«Los usuarios se fueron porque la configuración inicial era demasiado compleja».
Fuente
Tres entrevistas mencionan la configuración inicial, pero ninguna indica por qué se fueron los usuarios
Criterio
No enunciar una causa a menos que una fuente la respalde
Comportamiento esperado
Mencionar que se habló de la configuración inicial, dejando abierta la causa
Impacto
El equipo podría priorizar una solución equivocada
Gravedad
Alta para esta decisión
Certeza en la etiqueta
Clara
La gravedad y la certeza responden a preguntas distintas. Un revisor puede no estar del todo seguro de si una afirmación carece de fundamento pero entender que, si realmente no lo tiene, las consecuencias serían graves. Mantener estos campos separados ayuda al PM a decidir qué requiere una investigación inmediata.
No le pidas al revisor que diagnostique la causa técnica. Decir «falló el sistema de recuperación» es solo una hipótesis sobre la implementación. La anotación debe registrar el fallo observable; el equipo de ingeniería se encargará de investigar por qué ocurrió.
Trata el desacuerdo como una señal
Cuando dos revisores eligen etiquetas distintas, no resuelvas el caso automáticamente por votación de la mayoría. Primero, clasifica el origen del desacuerdo:
La regla no está clara: los revisores no logran determinar qué promete el producto. Reescribe el criterio y añade un ejemplo.
Falta contexto: a un revisor le falta la fuente, el objetivo del usuario o los permisos necesarios para juzgar. Corrige el caso de prueba.
Hay un tradeoff de política sin resolver: ambos juicios son razonables, pero implican comportamientos de producto distintos. El PM debe tomar o facilitar esa decisión junto con los expertos de dominio.
Difieren preferencias válidas: conserva la preferencia y analiza si encaja con un segmento de usuarios, una tarea o un contexto específicos.
La ejecución de la revisión difiere: puede que las instrucciones sean claras, pero alguien pasó por alto una evidencia o no entendió la tarea. Aclara la guía de revisión y repite el caso.
Este enfoque evita convertir cada discrepancia en un simple «error humano». Un desacuerdo puede destapar una política incompleta o una variación real en las necesidades de los usuarios. Un estudio de 2022 sobre paradigmas de anotación resalta un punto clave: a veces el objetivo es modelar perspectivas diversas; otras veces, aplicar un criterio normativo unificado. Decide qué objetivo encaja con tu producto antes de reducir las etiquetas a una sola respuesta.
Haz una calibración breve antes de escalar la revisión
Empieza con un puñado de outputs representativos: un caso directo, un caso con fuentes ausentes, una contradicción, una preferencia de estilo y un caso límite. Pide a dos o más revisores que los etiqueten de forma independiente y luego poned en común las evidencias y el razonamiento.
El objetivo de la calibración no es conseguir una métrica de concordancia perfecta. Es detectar en qué puntos las instrucciones no logran distinguir:
un error factual de una inferencia no demostrada
un detalle omitido de un detalle irrelevante para la tarea del usuario
una preferencia de estilo de un problema de usabilidad
un detalle de bajo impacto de un comportamiento que bloquea un lanzamiento
un error del modelo de un contexto de entrada deficiente o incompleto
Actualiza la guía con la resolución acordada y un ejemplo breve. Guarda también las etiquetas independientes iniciales: te mostrarán si el desacuerdo se debió al caso en sí, a la política de producto o a las instrucciones de revisión.
El NIST AI Risk Management Framework insta a los equipos a definir responsabilidades y supervisión en el uso conjunto de personas e IA. Para un equipo de producto, una guía de revisión es una forma muy práctica de visibilizar esas responsabilidades: quién aporta el criterio de dominio, quién aplica la regla y quién hace el seguimiento de la implementación y la fiabilidad técnica.
Conecta las anotaciones con las decisiones de producto
Un conjunto de anotaciones no equivale por sí solo a una decisión de lanzamiento. Es la evidencia en la que te basas para decidir:
¿Está el comportamiento del producto definido con la claridad suficiente para empezar a construirlo?
¿Qué fallo exige modificar las políticas del producto?
¿Qué fallo corresponde a problemas de implementación o fiabilidad técnica?
¿Necesita el equipo más ejemplos representativos?
¿Estamos ante una preferencia válida que justifique ofrecer personalización?
¿Qué debemos volver a evaluar tras un cambio en los prompts, el modelo o el flujo de trabajo?
Mantén un registro conciso de cada tanda de revisión: contexto de la tarea y del usuario, versión de la regla de producto, fuentes de ejemplo, etiquetas, desacuerdos sin resolver, decisiones y responsable. Cuando una regla cambie, crea una nueva versión y revisita los ejemplos que dependan de ella. Así sabrás si un output cambió porque se modificó la política de producto o porque el sistema se comportó de forma distinta.
Los PMs son los dueños del criterio sobre el comportamiento esperado para el usuario, los tradeoffs de dominio y el aprendizaje que deben aportar los ejemplos. Pueden redactar los prompts, revisar outputs y definir criterios de aceptación porque ese trabajo es el que especifica el producto. Los ingenieros son los dueños de la implementación en producción, el control de accesos, la fiabilidad y los sistemas que hacen posible que ese comportamiento funcione.
Ficha de anotación para copiar y usar
Utiliza esta plantilla en tu próxima sesión de revisión:
Tarea y usuario: Regla de producto evaluada: Fragmento del output: Fuente o contexto: Comportamiento observado: Comportamiento esperado: Impacto en el usuario y gravedad: Certeza en la etiqueta: ¿Fallo de política, falta de contexto o preferencia? Decisión, responsable y próxima revisión:
Si el equipo no puede rellenar la regla de producto, detén la evaluación y define primero qué se espera del producto. La rúbrica solo es útil cuando refleja una decisión de producto que el equipo está dispuesto a asumir.
Specky ayuda a los equipos a mantener conectadas la evidencia de los usuarios, las decisiones de producto y los siguientes pasos. Explora el espacio de trabajo de producto para PMs técnicos o empieza a estructurar tu documento de requisitos con el generador de PRD.
GDPR-aligned. EU workspace data is stored in Frankfurt, Germany. GDPR and EU data Built in Vienna, Austria. A product of influence solutions fm GmbH (FN 675374y). Imprint 14-day trial. Card required, and nothing is charged until day 14. 30-day refund after subscribing. See pricing