9 de noviembre de 2026Actualizado el Fathy Shalaby12 min de lectura
Plantilla de plan de test A/B: prueba un solo cambio y define la métrica
La mayoría de los tests A/B fracasan antes de empezar. Cambia una sola cosa, define primero la métrica, calcula el tamaño de muestra y no mires los resultados antes de tiempo.
Una plantilla de plan de test A/B es un plan de una página que rellenas antes de un split test: el cambio único, la métrica principal, una métrica de control (guardrail), el tamaño de muestra y la fecha de fin. Después, el split test muestra ese cambio a una parte aleatoria del tráfico real y compara la métrica que nombraste antes de empezar. Escribe primero el plan, porque la mayoría de los split tests fracasan antes del lanzamiento.
Ideas clave
La mayoría de las ideas pierden. La tasa de éxito de las ideas en Bing fue de alrededor del 10-20 %, y las ganadoras movían las métricas clave entre un 0,1 % y un 1,0 % (Kohavi et al., KDD 2014).
Calcula el tamaño de muestra antes de empezar. Con una tasa de conversión del 12 %, detectar un aumento relativo del 10 % requiere unos 11.700 usuarios por versión, con un 95 % de confianza y un 80 % de potencia (calculadora de Evan Miller).
No espíes los resultados. Probar después de cada visitante y parar en el primer resultado «significativo» eleva la tasa de falsos positivos del 5 % al 26,1 % (Evan Miller, 2010).
Nombra un guardrail, una métrica que no debe empeorar.
¿Qué es un split test?
Un split test cambia una cosa para una parte de tu tráfico real y compara una métrica que nombraste antes de que empezara el test.
Es lo mismo que un test A/B: la versión A es la original (el control), la versión B lleva el cambio, y las personas se asignan al azar. Como el cambio es la única diferencia sistemática, una brecha clara en la métrica apunta al cambio.
En Testing Business Ideas, de David J. Bland y Alex Osterwalder, el split test es un experimento de validación de «llamada a la acción», junto al test de landing page y la preventa. El póster de Strategyzer lo puntúa con 2 de 5 en coste, 3 de 5 en tiempo de ejecución y 3 de 5 en solidez de la evidencia (biblioteca de experimentos de Strategyzer).
Úsalo cuando tengas suficiente tráfico y quieras saber si un cambio concreto causó un resultado. Es la forma más fiable de responder eso. También puede sorprenderte. En su artículo de 2017 en Harvard Business Review, Ron Kohavi y Stefan Thomke cuentan la historia de un pequeño cambio en cómo se mostraban los titulares de anuncios en Bing, que dio resultados tan fuertes que activaron una alerta interna por parecer demasiado buenos para ser verdad. La idea llevaba más de seis meses en el backlog. Aumentó los ingresos un 12 %, lo que valía más de 100 millones de dólares al año solo en Estados Unidos.
Esa historia es la excepción. En un artículo de 2014, Kohavi y sus colegas escribieron que la mayoría de los experimentos de Bing fracasan, y que los resultados excepcionalmente fuertes piden aplicar la ley de Twyman: «Any figure that looks interesting or different is usually wrong!»
¿Qué riesgo pone a prueba y qué fuerza tiene la evidencia?
Pone a prueba la deseabilidad: ¿esta versión hace que la gente haga más de lo que quieres? La evidencia es comportamiento, de personas reales que no saben que están en un test. Mide lo que ocurre durante el periodo del test, así que puede pasar por alto efectos a largo plazo. Consulta nuestra guía para elegir un experimento de producto.
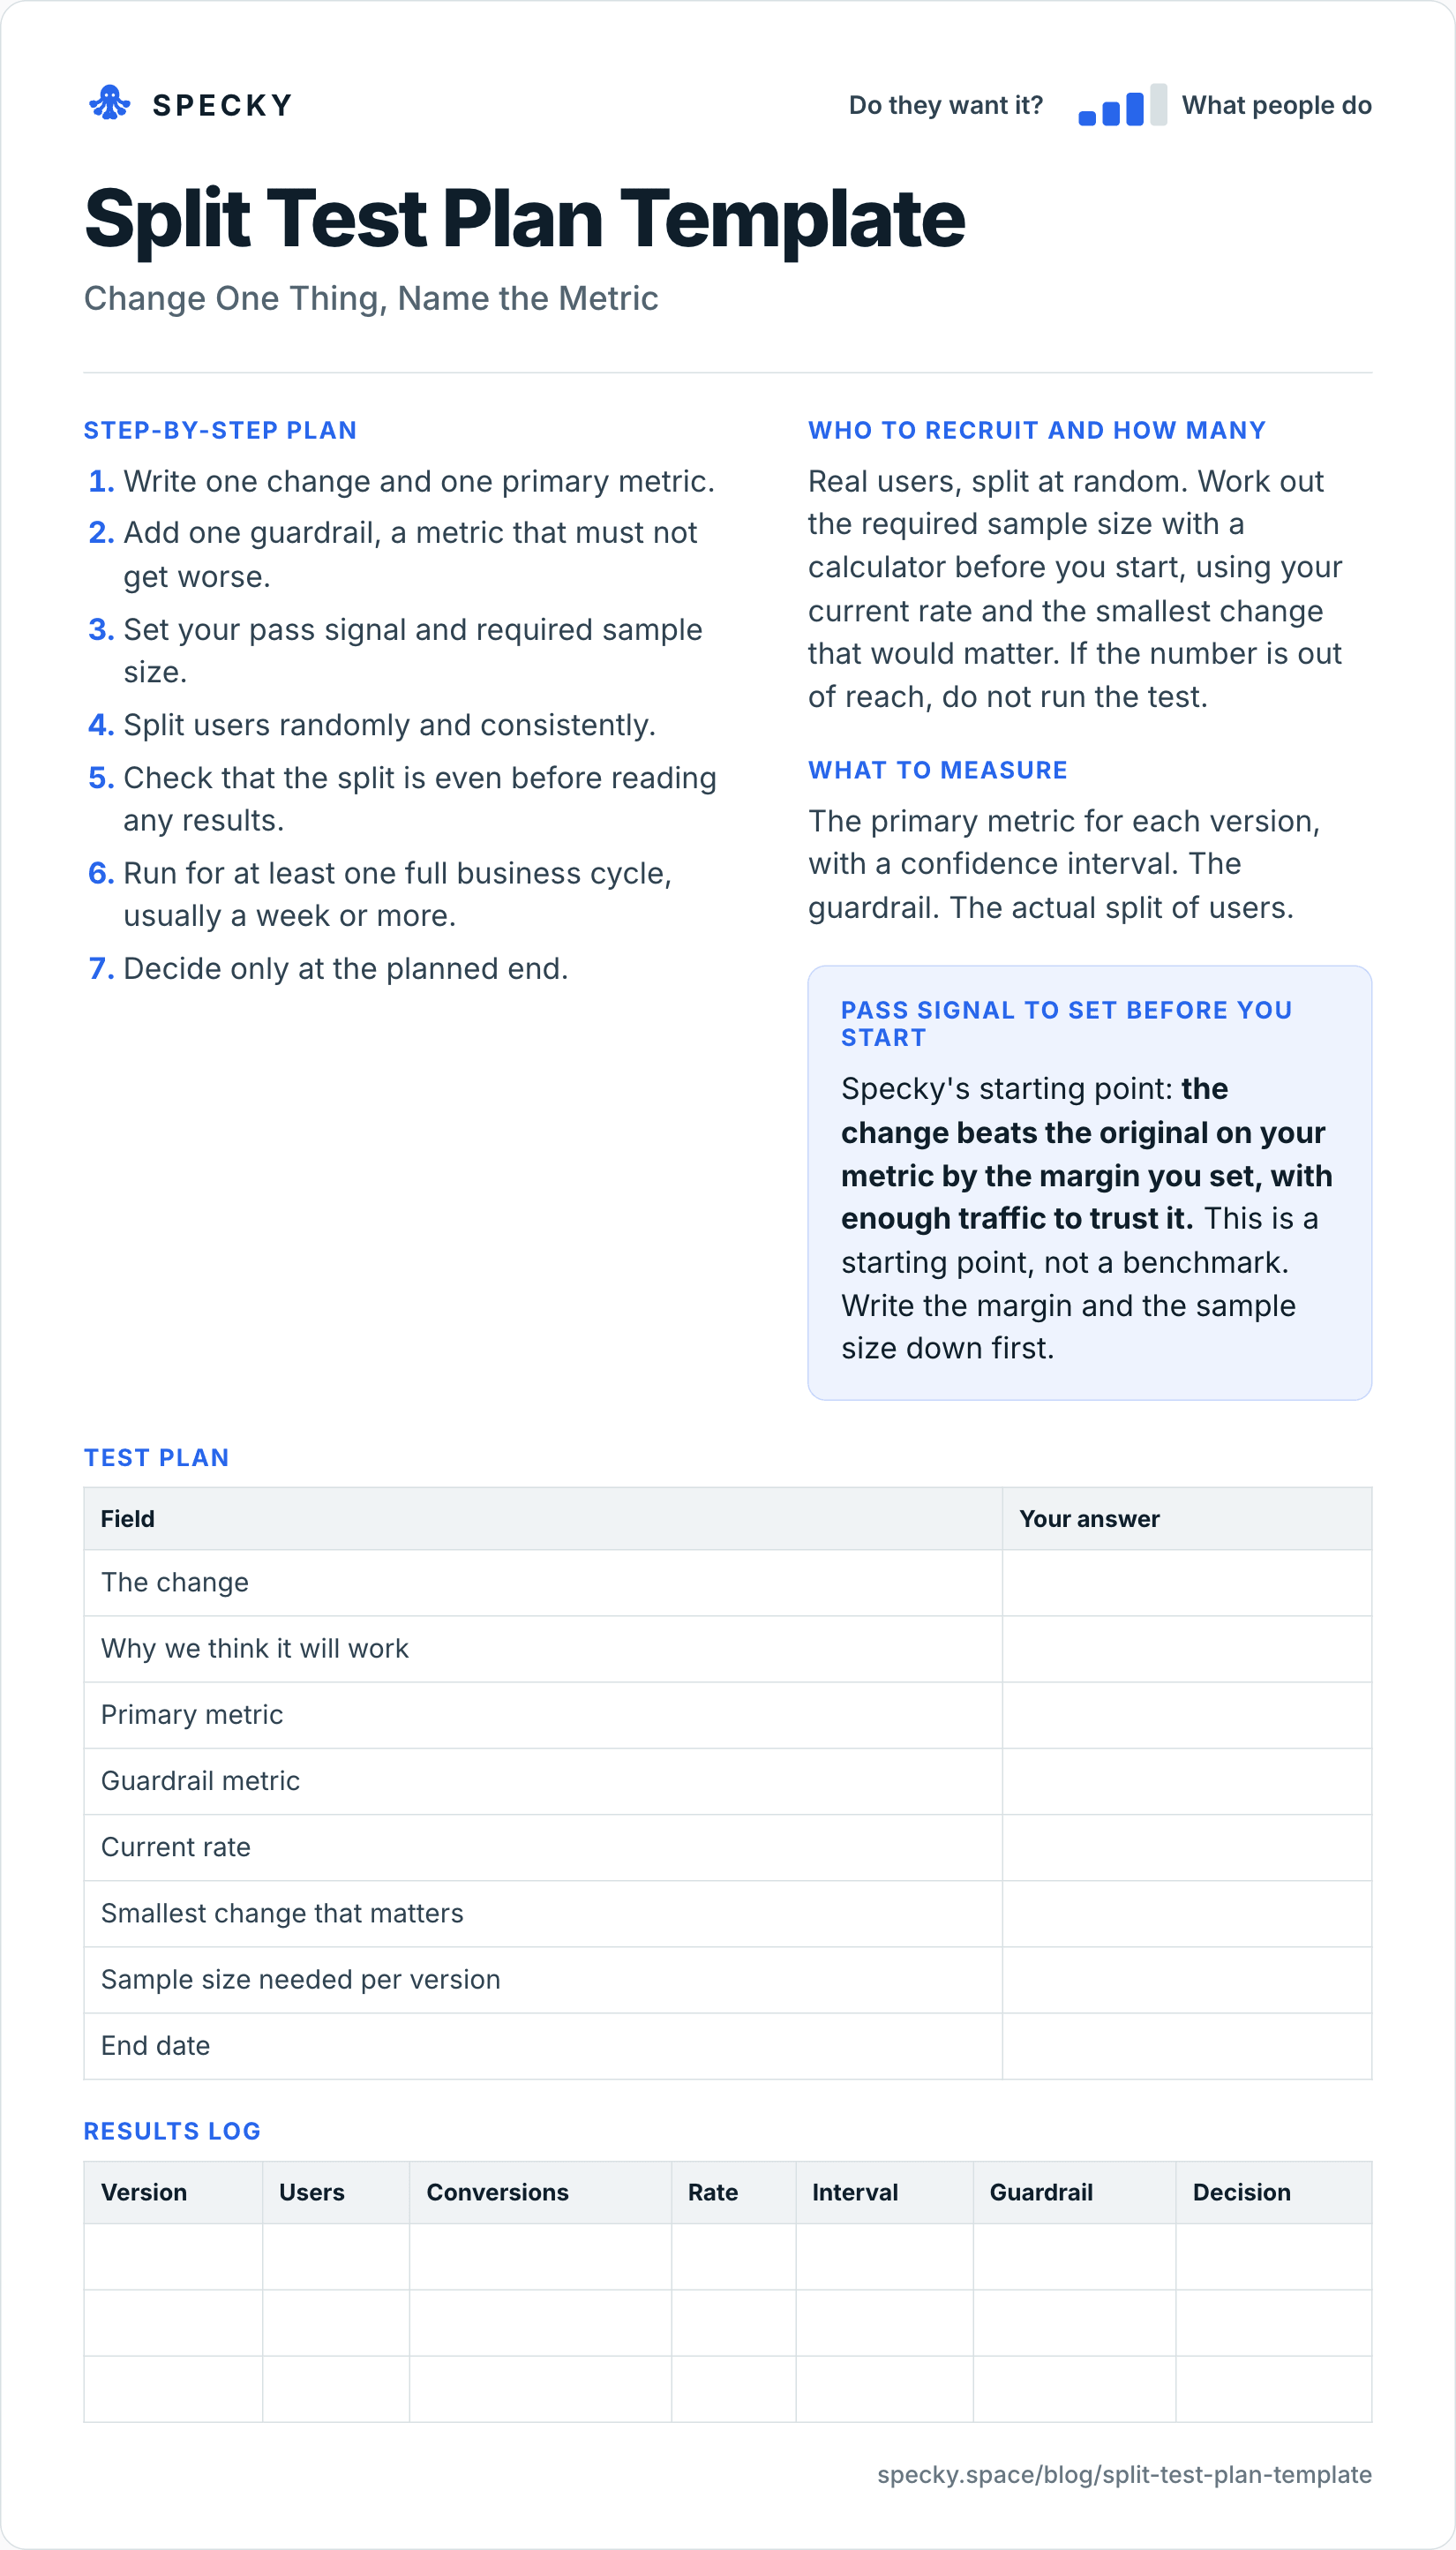
Plantilla de plan de test A/B (copia y usa)
Abre la imagen a tamaño completo o copia la versión en texto de abajo.
A quién reclutar y cuántos
Usuarios reales, divididos al azar. Calcula el tamaño de muestra necesario con una calculadora antes de empezar, usando tu tasa actual y el cambio más pequeño que importaría. Si la cifra está fuera de tu alcance, no hagas el test.
Plan paso a paso
Escribe un cambio y una métrica principal.
Añade un guardrail, una métrica que no debe empeorar.
Fija tu señal de éxito y el tamaño de muestra necesario.
Divide a los usuarios de forma aleatoria y consistente.
Comprueba que la división es pareja antes de leer cualquier resultado.
Déjalo correr al menos un ciclo de negocio completo, normalmente una semana o más.
Decide solo al final previsto.
Plan del test
Campo
Tu respuesta
El cambio
Por qué creemos que funcionará
Métrica principal
Métrica guardrail
Tasa actual
Cambio más pequeño que importa
Tamaño de muestra necesario por versión
Fecha de fin
Qué medir
La métrica principal de cada versión, con un intervalo de confianza. El guardrail. La división real de los usuarios.
Señal de éxito que debes fijar antes de empezar
Punto de partida de Specky: el cambio supera al original en tu métrica por el margen que fijaste, con tráfico suficiente para fiarte. Es un punto de partida, no un benchmark. Escribe primero el margen y el tamaño de muestra.
Registro de resultados
Versión
Usuarios
Conversiones
Tasa
Intervalo
Guardrail
Decisión
¿Cuántos usuarios necesitas para un test A/B?
Depende de tu tasa de conversión actual y del cambio más pequeño que valga la pena detectar, el efecto mínimo detectable. Cuanto más pequeño sea cualquiera de los dos, más tráfico necesitas. Con la fórmula bilateral de la calculadora gratuita de Evan Miller, con su significancia estándar del 5 % y potencia del 80 %, esta es la muestra necesaria por versión:
Tasa de conversión actual
Para detectar un aumento relativo del 5 %
Aumento relativo del 10 %
Aumento relativo del 20 %
2 %
unos 310.000
unos 78.000
unos 19.800
5 %
unos 120.000
unos 30.200
unos 7.700
12 %
unos 46.300
unos 11.700
unos 2.900
20 %
unos 25.300
unos 6.300
unos 1.600
Reducir a la mitad el efecto que quieres detectar multiplica aproximadamente por cuatro el tráfico, y las tasas base bajas necesitan muchas más personas que las altas.
Para comprobarlo sin calculadora, usa la regla práctica de Evan Miller: n = 16σ² / δ², donde δ es el efecto mínimo y, para una tasa de conversión p, σ² = p(1 − p). Con un 12 % y un aumento al 13,2 %: 16 × 0,12 × 0,88 ÷ 0,012² ≈ 11.700 por versión.
Ejemplo resuelto: del tamaño de muestra a la fecha de fin
Este ejemplo es ilustrativo; coincide con el ejemplo resuelto de más abajo.
Tasa actual: el 12 % de los visitantes se registra.
Cambio más pequeño que importa: un aumento relativo del 10 %, del 12 % al 13,2 %.
Tamaño de muestra: unos 11.700 por versión, es decir, unos 23.400 visitantes en total.
Tráfico: unos 860 visitantes al día llegan a la página de registro.
Si la respuesta hubiera sido seis meses, no hagas un test más pequeño y esperes lo mejor. Prueba un cambio mayor, elige una métrica con una tasa base más alta o usa un método que necesite menos tráfico.
¿Cuánto tiempo debe durar un split test?
Hasta alcanzar el tamaño de muestra previsto, y durante al menos un ciclo de negocio completo, normalmente una semana o más, porque los usuarios entre semana y los del fin de semana se comportan de forma distinta.
¿Por qué no debes espiar los resultados?
Los dashboards muestran un valor p que da por hecho que miras una sola vez, al final. Cada vistazo extra es otra oportunidad para que el ruido cruce la línea. Evan Miller demostró que probar después de cada observación y parar en el primer p < 0,05 da una tasa de falsos positivos del 26,1 %, más de cinco veces el 5 % que crees tener (Evan Miller, 2010).
Si tienes que mirar antes de tiempo, sube el listón: si miras 10 veces, necesitas una significancia reportada del 1,0 % para mantener una tasa real del 5 %.
¿Por qué un resultado «significativo» sigue necesitando una comprobación?
Kohavi y sus colegas explican las cuentas. Si una idea de cada tres es realmente ganadora, el promedio que reportaron en los experimentos de Microsoft, un resultado significativo es un verdadero positivo alrededor del 89 % de las veces. Si los verdaderos avances son uno de cada 500, baja al 3,1 %. Los resultados sorprendentes necesitan repetirse.
¿Qué debes medir en un split test?
La métrica principal de cada versión, con un intervalo de confianza, no solo un porcentaje.
Una métrica guardrail que no debe empeorar, como la conversión a pago, los reembolsos o el tiempo de carga de la página.
La división real de los usuarios. Si planeaste 50/50 y obtienes 52/48 con números grandes, algo está roto. Eso es un desajuste de proporción de muestra (sample ratio mismatch). Comprobarlo solo necesita las proporciones esperadas y los recuentos observados, y detecta una amplia variedad de problemas de datos (verificador SRM de Lukas Vermeer y colegas). No leas los resultados hasta que lo pase.
Los guardrails sobre eventos poco frecuentes necesitan mucho tráfico: detectar una caída del 10 % en una conversión a pago del 1,2 % requiere aproximadamente 130.000 usuarios por versión. Si no puedes llegar a eso, anota de antemano qué cuenta como incumplimiento, por ejemplo «cualquier caída de clientes de pago bloquea el lanzamiento».
Split test frente a test de landing page frente a test de puerta falsa
¿Este cambio provoca más del comportamiento que queremos?
¿Alguien da el siguiente paso por esta oferta?
¿Los usuarios actuales intentan usar una función que aún no está construida?
Comparación
Control frente a variante, al azar
Normalmente una página frente a un objetivo
Un botón frente a un objetivo
Evidencia
Causal, de comportamiento
Interés de comportamiento
Interés de comportamiento
Usa un test de landing page o de puerta falsa para saber si hay algún interés; usa un split test para saber cuál de dos versiones funciona mejor.
¿Cómo es un split test en la práctica?
Este ejemplo es inventado para mostrar el método. Un equipo que gestiona una herramienta de declaración de impuestos quiere acortar su formulario de registro de seis campos a tres. Prevén que los registros subirán al menos un 10 % y fijan la conversión a pago como guardrail.
Tras cuatro semanas y 12.000 visitantes en cada grupo, el formulario más corto aumenta los registros un 14 %. Pero la conversión a pago cae y el guardrail se incumple: los registros extra son personas con menos intención que nunca terminan.
El objetivo de registros se cumple y el guardrail falla, así que no lo lanzan tal cual. Prueban un formulario más corto con una pregunta adicional sobre el tipo de declaración del cliente.
Así podría quedar el registro:
Versión
Usuarios
Registros
Tasa
Clientes de pago
Decisión
Seis campos (control)
12.000
1.440
12,0 %
144
Tres campos
12.000
1.642
13,7 %
131
No lanzar
El aumento de registros es real: +1,7 puntos porcentuales, con un intervalo del 95 % de aproximadamente +0,8 a +2,5. La caída de clientes de pago, de 144 a 131, es demasiado pequeña para demostrarla con este tráfico, pero la regla de guardrail que el equipo escribió de antemano decía que menos clientes de pago bloqueaba el lanzamiento.
¿Cuáles son los errores más comunes en los split tests?
Espiar. Mirar pronto y parar cuando se ve bien produce falsas victorias.
Cambiar varias cosas. No sabrás cuál funcionó.
Sin guardrail. Puedes ganar una métrica y perder el negocio.
Muy poco tráfico. Un test sin potencia suficiente es solo ruido caro.
Ignorar la novedad. La gente hace clic en lo nuevo solo porque es nuevo.
Cuándo no funciona: con poco tráfico, para apuestas grandes que no se pueden dividir, para efectos que tardan meses y cuando los usuarios hablan entre sí, de modo que los grupos no son independientes.
¿Es ético hacer un split test sin avisar a los usuarios?
Los cambios ordinarios, como un formulario más corto o un titular nuevo, se prueban habitualmente sin avisar a cada usuario. El límite es el daño. No pruebes nada que no te sentirías cómodo lanzando para todos, no muestres precios distintos a clientes similares sin una política clara y cuenta solo a las personas que tu banner de consentimiento te permite rastrear.
Cómo hacerlo en Specky
En la página Assumptions, haz clic en la nota y elige Pick a test, y luego Split test. Specky rellena los pasos, la señal de éxito y un calendario de dos semanas.
Para un cambio dentro de tu producto, haz la división con tu propia herramienta de feature flags o de experimentos. Specky no cambia tu producto. Lee los números de la analítica conectada y tú adjuntas el resultado como evidencia.
Si pruebas una página de validación de Specky, la división puede hacerse allí. Configura un control y hasta cinco variantes en Experiment analytics, y Specky muestra la conversión por versión, intervalos del 95 %, si tienes suficientes personas y un guardrail opcional. El veredicto se mantiene cauteloso mientras la muestra sea pequeña.
Haz clic en Start running y registra el resultado en la fecha de fin prevista.
Un resultado favorable aparece en el tablero como Supported, porque una comparación controlada de lo que hizo la gente es comportamiento.
¿Qué hacer con cada resultado?
Supported: lanza el cambio. Anota el tamaño de la mejora y revisa de nuevo la analítica en un mes para ver si el efecto dura.
Unclear: el resultado está dentro del margen de error. Quédate con la versión más simple, o averigua por qué con unas cuantas entrevistas.
Contradicted: el cambio no tuvo efecto o empeoró las cosas. No lo lances. Cualquier apuesta que se apoye en esta nota aparece ahora como Contradicted.
Preguntas frecuentes
¿Cuánto tráfico necesitas para un split test?
Depende de tu tasa de conversión actual y del cambio más pequeño que importaría. Con una tasa de conversión del 12 %, detectar un aumento relativo del 10 % requiere unos 11.700 usuarios por versión con la configuración estándar; con un 2 %, unos 78.000. Si no puedes alcanzar la cifra en un plazo razonable, usa otro método.
¿Por qué no debes detener un split test antes de tiempo?
Parar cuando los resultados se ven bien hace mucho más probables las falsas victorias, ya que los resultados oscilan al principio. En el peor caso de Evan Miller, probar después de cada visitante da una tasa de falsos positivos del 26,1 % en lugar del 5 %. Decide de antemano la fecha de fin y el tamaño de muestra.
¿Qué es una métrica guardrail?
Una métrica guardrail es un número que no debe empeorar durante un test, aunque mejore tu métrica principal, como la conversión a pago, los reembolsos o la velocidad de la página. Evita que ganes una métrica mientras dañas el negocio. Escribe la regla de qué cuenta como incumplimiento antes de que empiece el test.
¿Cuál es la diferencia entre un split test y un test A/B?
Ninguna en la práctica. Ambos muestran un cambio a una parte aleatoria de los usuarios y comparan una métrica con un grupo de control; los investigadores lo llaman experimento controlado en línea. Probar varios cambios combinados es un test multivariante, que necesita mucho más tráfico.
GDPR-aligned. EU workspace data is stored in Frankfurt, Germany. GDPR and EU data Built in Vienna, Austria. A product of influence solutions fm GmbH (FN 675374y). Imprint 14-day trial. Card required, and nothing is charged until day 14. 30-day refund after subscribing. See pricing