9 de noviembre de 2026Actualizado el Fathy Shalaby12 min de lectura
Plantilla de análisis de tickets de soporte: descubre la tarea que tus usuarios no logran completar
Tu bandeja de soporte es investigación de usuarios por la que ya pagaste. Etiquétala según lo que tus clientes intentaban hacer, valida el criterio y descubre qué duele más.
El análisis de tickets de soporte es un experimento de escritorio que toma dos días: etiquetas tus últimos 200 contactos de soporte según la tarea que el cliente intentaba completar, cuentas cuántos tickets corresponden a cada una y descubres cuáles generan más problemas. Los clientes ya describieron el problema de forma espontánea y con fecha y hora exactas. Esto revela fricción y dolor, pero no disposición a pagar, y deja fuera a todas las personas que se fueron sin escribirte.
Conclusiones clave
El «customer support analysis» es uno de los cinco experimentos de discovery basados en análisis de datos presentados por David J. Bland y Alex Osterwalder en Testing Business Ideas (curso de la UPV).
Etiqueta por tarea (el «job»), no por área de producto. «Intentando enviar una factura a mi contable» te dice qué debes solucionar; «Facturación», no.
Las etiquetas automáticas del helpdesk se diseñaron para enrutar conversaciones. El etiquetado automático de Zendesk compara las palabras de un ticket nuevo con las etiquetas ya existentes y asigna las tres más coincidentes (Zendesk).
Valida tus etiquetas antes de contar. Pídele a una segunda persona que clasifique 20 tickets de forma independiente; muchos textos metodológicos consideran un 80 % de concordancia como el mínimo aceptable (McHugh, 2012).
La señal de éxito inicial que sugerimos en Specky: la tarea figura entre los 3 motivos principales por los que la gente contacta a soporte.
¿Qué es el análisis de tickets de soporte?
El análisis de tickets de soporte consiste en etiquetar los contactos recientes de atención al cliente según la tarea que el usuario intentaba completar, para identificar qué tareas causan más fricción. Hablamos de «contactos» porque abarca todos los canales: correo electrónico, chat, mensajes dentro de la aplicación, notas de llamadas y el foro de la comunidad, si tienes uno.
Es una de las formas más económicas de dimensionar un problema en un producto en producción, porque el esfuerzo de describir la incidencia ya lo hizo el usuario. La diferencia con los informes habituales de soporte radica en la etiqueta. Los equipos de soporte clasifican para enrutar incidencias y balancear la carga de trabajo; en producto, clasificamos según la tarea y el obstáculo que la bloqueó, siguiendo la filosofía de los .
¿Cuándo conviene usar el análisis de tickets y cuándo no?
Utilízalo cuando tengas un producto en producción y un volumen de contactos suficiente para cuantificar tendencias. Es una de las vías más accesibles para medir un problema, ya que los clientes te lo han contado de forma espontánea y con una marca de tiempo precisa.
No lo uses:
En un producto casi sin usuarios. Diez tickets no permiten priorizar nada con rigor.
Para entender a quienes se fueron en silencio. Esas personas no escriben a soporte.
Para responder preguntas sobre monetización. Una acumulación de tickets evidencia frustración, lo cual es muy distinto de la disposición a pagar. Para evaluar eso, prueba un test de intención de compra simulada.
¿Qué riesgo evalúa y qué tan sólida es la evidencia?
Evalúa la deseabilidad: ¿qué problema está afectando más a los clientes reales? La evidencia obtenida es direccional. Proviene de un comportamiento real, ya que los usuarios se tomaron la molestia de escribir. Sin embargo, el volumen no te dice cuánto valdría solucionar el problema. Nuestra guía para elegir experimentos de producto explica en detalle cómo interpretar este nivel de certeza.
Plantilla de análisis de tickets de soporte lista para usar
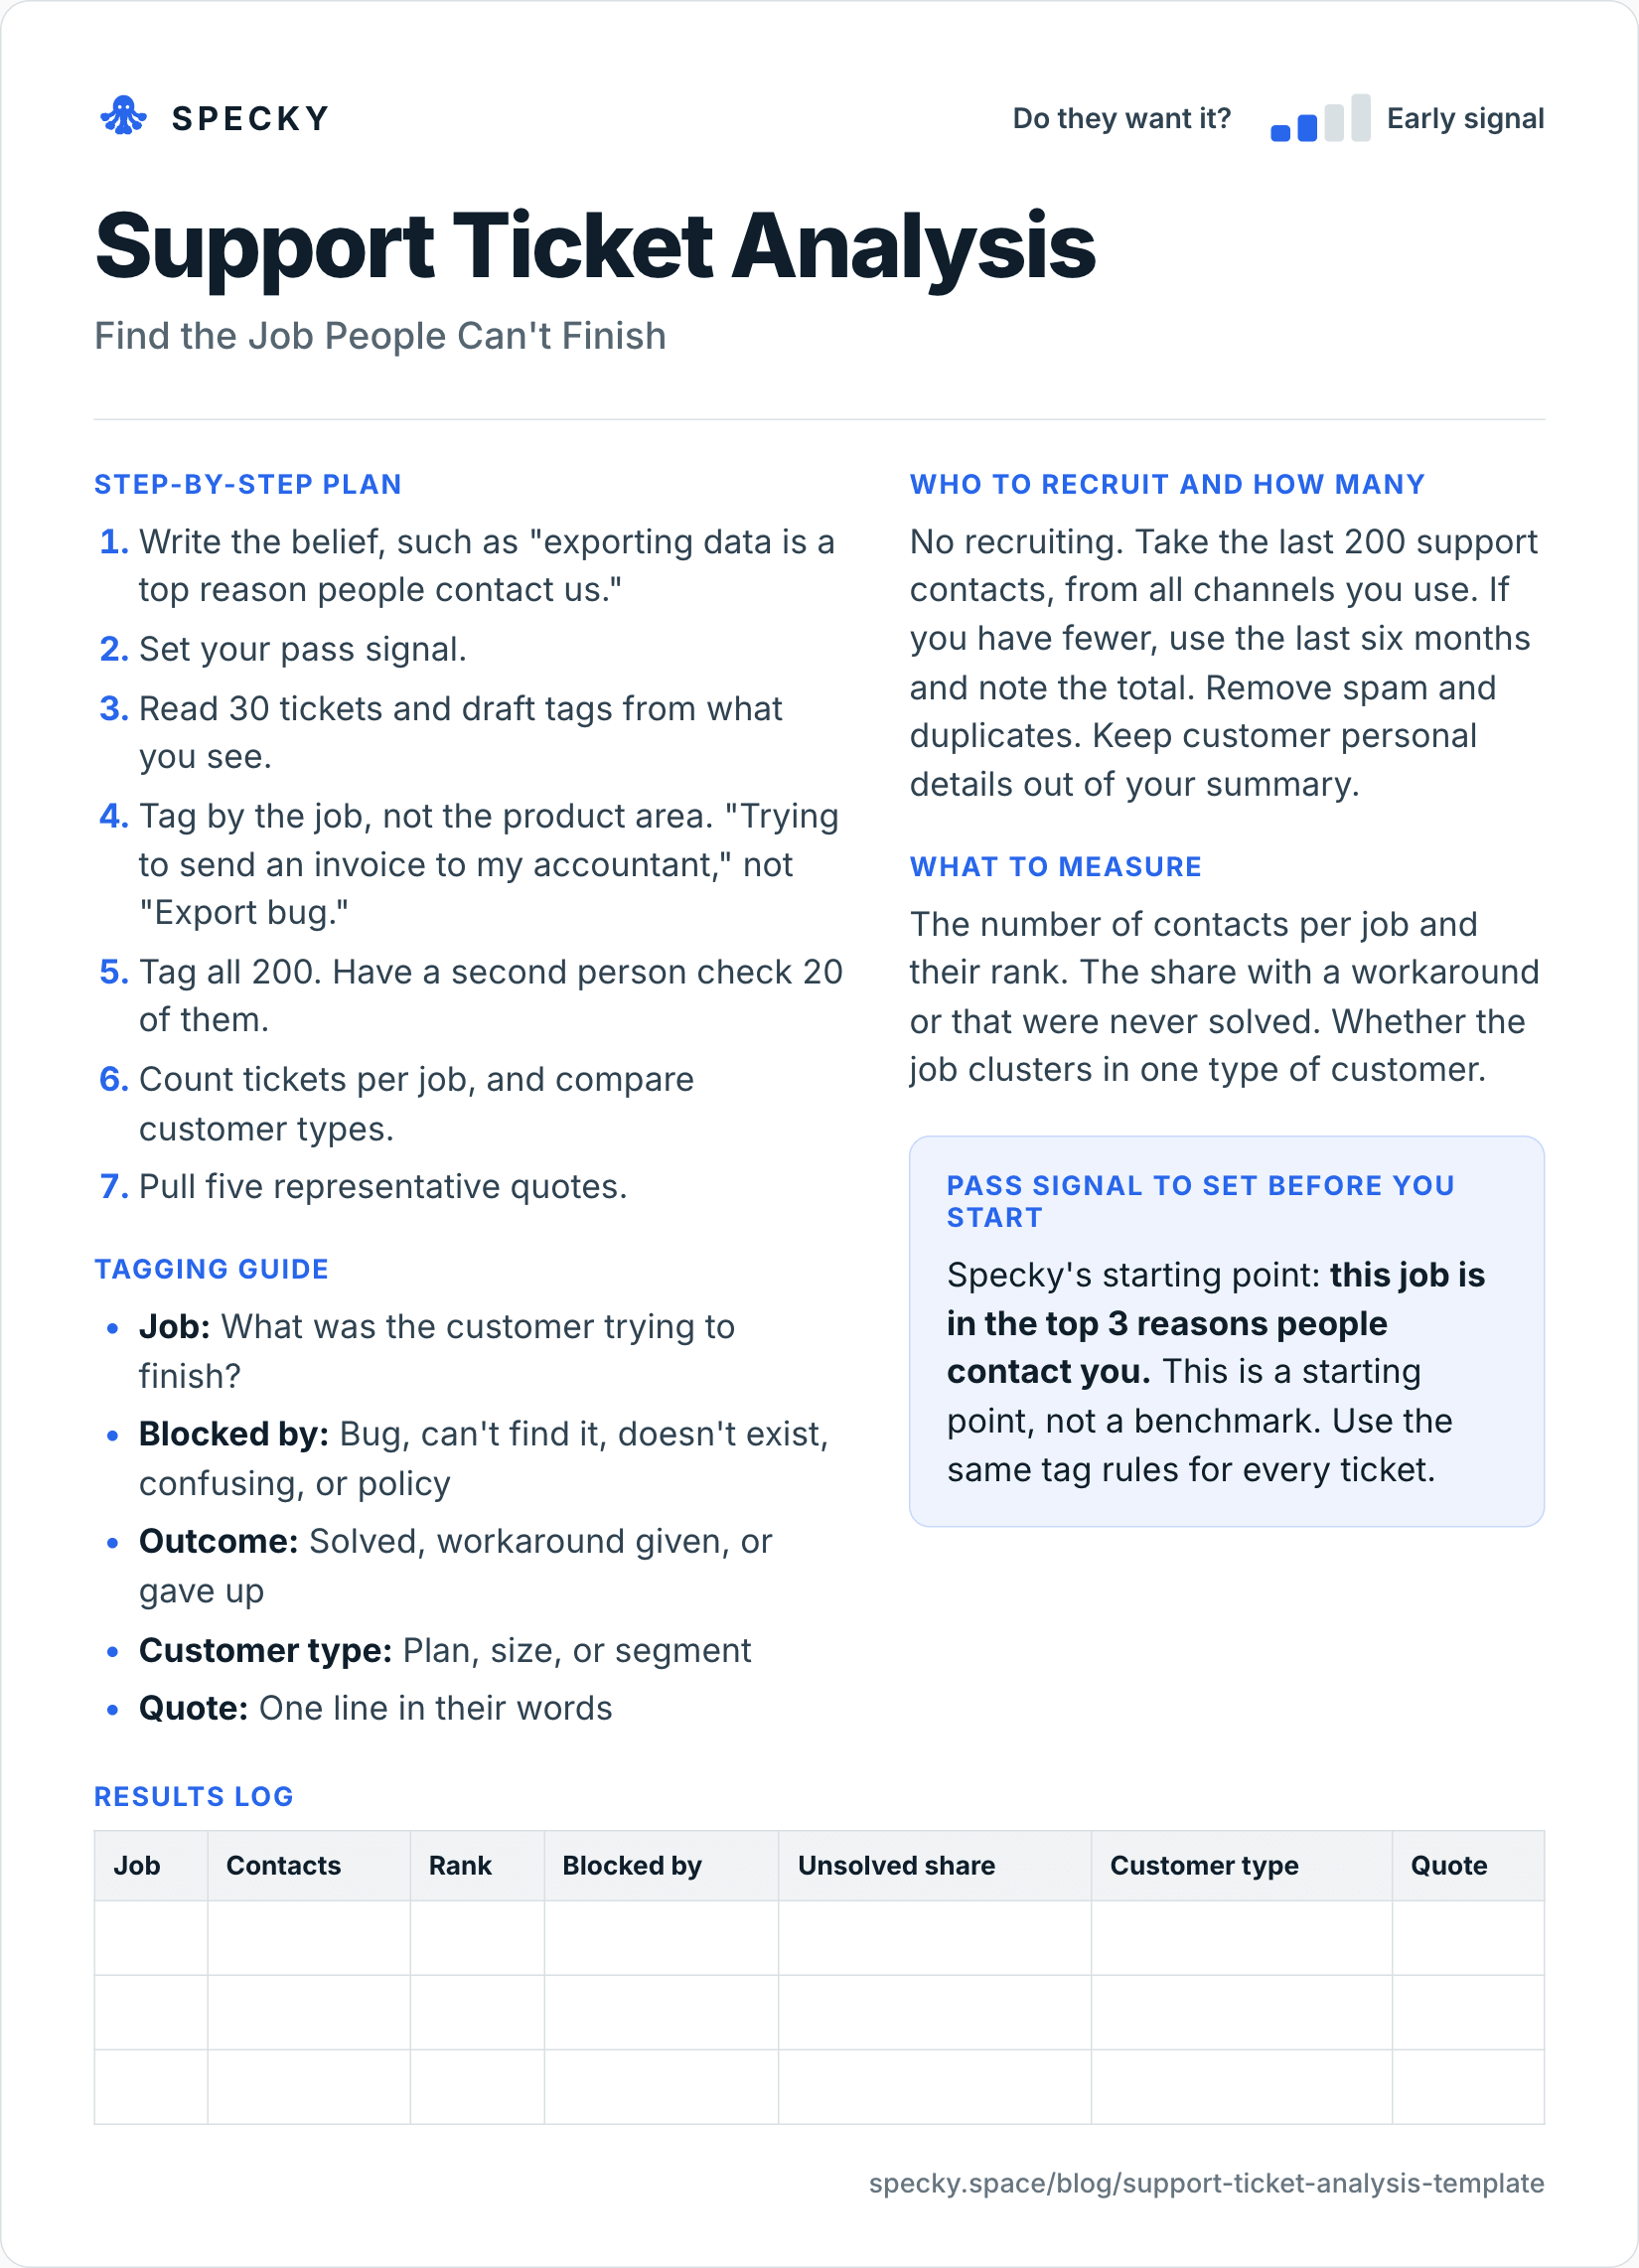
Abre la imagen a tamaño completo o copia la versión en texto a continuación.
A quién reclutar y cuántos
No necesitas reclutar a nadie. Toma los últimos 200 contactos de soporte de todos los canales que utilices. Si tienes menos volumen, toma los últimos seis meses y anota el total. Elimina el spam y los mensajes duplicados. Asegúrate de excluir cualquier dato personal de los clientes en tu resumen final.
Plan paso a paso
Formula la hipótesis que quieres validar, por ejemplo: «exportar datos es uno de los principales motivos de contacto».
Define tu señal de éxito.
Lee 30 tickets y esboza un listado inicial de etiquetas a partir de lo que observes.
Etiqueta por tarea, no por área de producto. «Intentando enviar una factura a mi contable», no «Error de exportación».
Etiqueta los 200 tickets. Pide a una segunda persona que clasifique 20 de ellos para validar el criterio.
Cuenta los tickets por tarea y compara los distintos tipos de cliente.
Extrae cinco citas textuales representativas.
Guía de etiquetado
Job (Tarea): ¿Qué intentaba completar el cliente?
Bloqueado por: Bug, no lo encuentra, no existe la función, confuso o política de la empresa
Resultado: Resuelto, se dio una alternativa temporal (workaround) o abandonó
Tipo de cliente: Plan, tamaño o segmento
Cita: Una frase textual con sus propias palabras
Qué medir
El número de contactos por tarea y su posición en el ranking. El porcentaje de casos resueltos con parches temporales o que quedaron sin solución. Si la tarea se concentra en un segmento de clientes en particular.
Señal de éxito que debes fijar antes de empezar
El criterio inicial en Specky: esta tarea se encuentra entre los 3 motivos principales de contacto. Se trata de un punto de partida, no de un estándar universal. Aplica las mismas reglas de etiquetado a cada ticket.
Registro de resultados
Tarea (Job)
Contactos
Posición
Bloqueado por
% sin resolver
Tipo de cliente
Cita
¿Cómo crear un sistema de etiquetado que sea riguroso?
Redacta un libro de códigos (codebook) breve antes de clasificar los 200 tickets. La guía de análisis temático de Nielsen Norman Group recomienda asignar a cada código un nombre, una descripción y ejemplos de fragmentos que encajan y que no encajan; esto resulta crítico cuando clasifica más de una persona (Nielsen Norman Group).
Un libro de códigos funcional para tickets de soporte:
Campo
Regla
Ejemplo que encaja
Ejemplo que no encaja
Tarea (Job)
Una frase verbal reconocible para el cliente
«Reembolsar el depósito de un cliente»
«Pagos»
Bloqueado por
Exactamente uno de cinco valores posibles
«No lo encuentra»: la opción existe, pero el usuario no dio con ella
«Problema de UX»
Resultado
Resuelto, alternativa temporal (workaround) o abandonó
«Soporte emitió el reembolso manualmente» = alternativa temporal
«Cerrado»
Tipo de cliente
Tomado de los datos reales de la cuenta, no supuesto
«Plan: Team, 6 puestos»
«Parece una cuenta grande»
Cuatro reglas para mantener la objetividad del recuento:
Diseña las etiquetas a partir de 30 tickets y luego congela la lista. Procura tener entre 8 y 15 tareas. Con un número mayor, la consistencia del etiquetado se desploma.
Mantén la categoría «Otros» bajo control. Si más de 1 de cada 10 tickets termina ahí, te falta una tarea clave en la lista.
Una sola tarea principal por ticket. Si una conversación aborda dos problemas, etiqueta el motivo con el que abrió el usuario y anota el segundo aparte.
Etiqueta el hilo completo, no solo el primer mensaje. La verdadera tarea suele manifestarse en la segunda o tercera respuesta.
¿Cómo comprobar la fiabilidad del etiquetado?
Pídele a otra persona que clasifique 20 de los 200 tickets usando el mismo libro de códigos, sin ver tus respuestas. Cuenta en cuántos tickets coincidieron en la tarea asignada. Ese porcentaje representa tu nivel de concordancia.
En su artículo de 2012 sobre fiabilidad interjueces (inter-rater reliability), Mary McHugh señala que muchos textos metodológicos sugieren un 80 % de concordancia como el mínimo admisible, y analiza por qué el coeficiente kappa de Jacob Cohen —que corrige el efecto del azar— suele arrojar valores más bajos (McHugh, 2012). Para una prueba de producto de dos días, el porcentaje de concordancia simple es suficiente: 16 aciertos sobre 20 representan un 80 %.
Si obtienes un resultado menor, no discutas caso por caso. Detecta cuáles fueron las dos tareas que más se confundieron, redefine sus descripciones agregando un ejemplo de lo que entra y lo que no, y vuelve a etiquetar esos casos.
¿Deberías confiar en las etiquetas automáticas de Zendesk o Intercom?
Úsalas como punto de partida exploratorio, nunca como resultado definitivo. Ambas herramientas fueron construidas para distribuir y gestionar la operativa del equipo de soporte, y sus categorías responden a esa lógica.
Las etiquetas de Zendesk son términos que aportan contexto a los tickets para filtrar vistas, búsquedas, reglas de negocio e informes (Zendesk). El etiquetado automático analiza las descripciones en busca de palabras de más de dos caracteres, las compara con etiquetas previas y añade las tres más coincidentes para ayudar al enrutamiento (Zendesk). Se trata de coincidencia por palabras clave sobre el mensaje inicial, no de una interpretación de la tarea de fondo.
El triaje inteligente de Zendesk predice el tema, el sentimiento en una escala de cinco niveles y el idioma (alrededor de 150 lenguas) evaluando el asunto y el primer comentario público, asignando un nivel de confianza a cada predicción (Zendesk).
Intercom separa tres herramientas distintas: temas de conversación (conversation topics), que son automáticos y aplican también a conversaciones históricas; atributos de datos (data attributes), que son estructurados y pueden exigirse como obligatorios antes de cerrar una conversación; y etiquetas (tags), que señalan respuestas específicas aplicadas manualmente o mediante Workflows. Intercom aconseja combinarlas (Intercom).
El Topics Explorer de Intercom agrupa conversaciones mediante IA en lugar de simples palabras clave; analiza los últimos 90 días al activarse y luego se actualiza a diario. Requiere el complemento Pro con Fin operativo, no clasifica el sentimiento y puede ignorar conversaciones atípicas o de bajo volumen (Intercom).
La estrategia práctica: exporta 200 contactos con las etiquetas que ya tengan, consérvalas en una columna y añade al lado tus propias columnas de «Tarea» y «Bloqueado por». Si el análisis demuestra su utilidad y se incorpora a tu rutina, define «Tarea» como un campo obligatorio al cerrar tickets para simplificar el proceso en el futuro.
Ejemplo práctico (hipotético)
Este caso es simulado para ilustrar el método. El equipo detrás de una aplicación de reservas para salones de belleza sospecha que su mayor problema son los errores en la sincronización del calendario. Deciden etiquetar sus últimos 200 contactos según la tarea que el usuario intentaba realizar.
La sincronización de calendario resulta ser la octava tarea más frecuente. Las tres primeras son «modificar una reserva en nombre de un cliente», «reembolsar un depósito» y «añadir a un segundo profesional del equipo». El caso de «reembolsar un depósito» llama la atención: la gran mayoría de los contactos terminó requiriendo una gestión manual por parte del equipo de soporte.
La señal de éxito no se cumple para la sincronización de calendario. El equipo documenta este resultado e introduce una nueva hipótesis centrada en el reembolso de depósitos en modalidad de autoservicio.
Los datos detrás del ejemplo: tras eliminar 14 contactos clasificados como spam o duplicados, se analizaron 200 tickets. «Modificar una reserva en nombre de un cliente» sumó 34 casos, «reembolsar un depósito» 29 y «añadir a un segundo profesional» 22. La sincronización de calendario acumuló apenas 9. De las 29 consultas por reembolsos, 21 (el 72 %) estaban bloqueadas porque la función «no existe» y terminaron con el agente procesando la devolución manualmente; además, 18 procedían de salones suscritos a los dos planes más económicos. Una segunda persona clasificó 20 tickets y coincidió en 17 (85 % de concordancia), validando la distribución final.
Análisis de tickets de soporte vs feedback del equipo de ventas vs análisis de métricas de producto
Aplica el análisis de tickets de soporte para aislar la tarea problemática y luego recurre a la analítica de producto para verificar cuántas personas llegan a ese mismo punto y abandonan sin escribir. Si los compradores potenciales plantean esa misma dificultad antes de contratar, el feedback de ventas confirmará que el problema te cuesta acuerdos comerciales además de horas de soporte.
¿Cuáles son los errores más comunes al analizar tickets de soporte?
Etiquetar por área de producto. «Facturación» no aporta contexto accionable. La tarea concreta te indica qué debes diseñar o arreglar.
Limitar el análisis a la última semana. Un lanzamiento problemático o una caída puntual pueden distorsionar los datos de una semana concreta.
Depender ciegamente de las etiquetas automáticas del helpdesk. Se diseñaron para distribuir tickets, no para extraer aprendizajes de producto.
Confundir volumen de quejas con valor comercial. Los clientes más ruidosos no siempre son los más representativos ni los más rentables.
Ignorar a quienes no dicen nada. Los usuarios que abandonan el producto sin pedir ayuda no aparecen reflejados en estos registros.
Cómo ejecutar este análisis en Specky
En la sección de Supuestos (Assumptions), haz clic en la nota y selecciona Elegir una prueba (Pick a test), luego elige Análisis de soporte al cliente (Customer support analysis). Specky completará los pasos, la señal de éxito y una estimación de dos días.
Specky se integra con tus herramientas habituales. Si conectaste plataformas como Zendesk, Intercom, Freshdesk o Help Scout, pide en el chat un agrupamiento de contactos según lo que los clientes intentaban hacer. Revisa los grupos resultantes por tu cuenta, ya que el acto de clasificar constituye la esencia del análisis.
Si tu software de soporte no está conectado, etiqueta un archivo exportado de forma manual y pega los totales obtenidos.
Haz clic en Comenzar ejecución (Start running), adjunta los números como evidencia y documenta el resultado.
Un resultado favorable se reflejará en el panel como Señal temprana (Early signal), no como Validado (Supported), ya que el volumen demuestra fricción pero no compromiso de compra.
Qué hacer según el resultado obtenido
Validado (se muestra como Señal temprana): Tienes identificada la tarea crítica. Desarrolla una solución rápida y manual mediante un test de conserje para comprobar si el volumen de contactos se reduce.
No concluyente: La tarea se ubica en posiciones intermedias o se concentra exclusivamente en un segmento reducido. Conduce algunas entrevistas con clientes de ese grupo. Una dinámica de speed boat puede ayudarte a determinar si la fricción es tan severa como sugieren las cifras.
Refutado: El problema no figura entre los principales motivos de contacto. Deja de tratarlo como una urgencia y enfoca recursos en lo que realmente genera fricción. Cualquier iniciativa asociada a este supuesto pasará a estado Refutado.
Preguntas frecuentes
¿Cómo se analizan los tickets de atención al cliente?
Lee 30 tickets recientes y diseña una serie de etiquetas tentativas a partir de lo que los clientes intentaban resolver. Define cada etiqueta en una sola línea y clasifica tus últimos 200 contactos según la tarea, el obstáculo y el desenlace. Pide a otra persona del equipo que revise 20 de ellos para validar el criterio y cuenta el volumen por tarea para descubrir cuáles generan más fricción y cuáles terminan sin resolverse.
¿Cuántos tickets de soporte conviene analizar?
Una muestra de aproximadamente 200 contactos recientes resulta un punto de equilibrio práctico: ofrece volumen suficiente para que las tareas principales se destaquen con claridad y se puede categorizar a mano en una sola jornada. Si tienes un volumen menor, analiza los últimos seis meses indicando la cifra total. Evita restringirte a una sola semana, ya que una versión inestable del software puede sesgar por completo los datos.
¿Qué criterios se deben usar para etiquetar tickets de soporte?
Clasifica según la tarea que el cliente intentaba completar, el impedimento que encontró y cómo concluyó la conversación. Incorpora el tipo de cliente a partir de los datos registrados en su cuenta. Las etiquetas por módulo funcional como «Facturación» o «Exportar» sirven para organizar la cola de trabajo, pero resultan demasiado ambiguas para guiar el desarrollo de producto.
¿Puede la IA etiquetar los tickets de soporte por nosotros?
Puede facilitarte un borrador inicial muy rápido. El triaje inteligente de Zendesk y el Topics Explorer de Intercom agrupan conversaciones de forma automática, pero su arquitectura está pensada para la gestión operativa y el reporting interno; de hecho, el algoritmo de Zendesk solo procesa el asunto y el primer mensaje. Conviene revisar una muestra representativa de forma manual y reclasificar por tarea, ya que el ejercicio de categorizar es donde reside el aprendizaje cualitativo.
¿Revelan los tickets de soporte la disposición a pagar de los clientes?
No. Los tickets reflejan los puntos de fricción del producto, no si los usuarios estarían dispuestos a pagar para resolverlos. Una tarea que acumule muchos contactos y dependa de parches manuales representa una gran oportunidad de mejora, pero debes contrastar el hallazgo con un experimento que demande un compromiso real, como una propuesta tipo conserje o una prueba de compra simulada.
GDPR-aligned. EU workspace data is stored in Frankfurt, Germany. GDPR and EU data Built in Vienna, Austria. A product of influence solutions fm GmbH (FN 675374y). Imprint 14-day trial. Card required, and nothing is charged until day 14. 30-day refund after subscribing. See pricing