5 novembre 2026Mis à jour le Fathy Shalaby16 min de lecture
Synthèse de recherche par IA : séparer les preuves de l’interprétation
L’IA trie un dossier d’entretiens en quelques minutes, mais les études montrent qu’elle manque les thèmes interprétatifs. Un workflow en cinq étapes, un prompt et une checklist de relecture gardent chaque affirmation reliée à sa source.
La synthèse de recherche par IA consiste à utiliser un modèle de langage pour organiser des notes d’entretien, des tickets de support et des observations de sessions en thèmes candidats, tandis que des personnes vérifient chaque thème par rapport aux preuves d’origine et assument l’interprétation. Elle ramène le premier passage de plusieurs heures à quelques minutes. Elle échoue quand les thèmes générés sont traités comme des conclusions : dans les comparaisons publiées, les modèles rejoignent les chercheurs humains bien plus souvent sur les thèmes descriptifs que sur les thèmes interprétatifs.
L’IA peut transformer un dossier de notes d’entretien en un résumé bien rangé en quelques secondes. C’est utile pour repérer la matière à examiner. C’est aussi une façon facile de transformer une interprétation incertaine en décision produit d’apparence assurée. Ce guide s’adresse aux fondateurs, aux premiers PM et aux product engineers qui disposent de quelques appels, tickets et notes d’usage, et non d’un département de recherche qui aurait le temps de tout relire.
Points clés
Dans une étude de 2024, ChatGPT et Bard ont chacun trouvé 5 des 7 thèmes identifiés par les codeurs humains (71 %), mais ne concordaient avec les humains que sur 36 à 47 % des codes individuels (Prescott et al., 2024).
La même analyse par IA a pris environ 20 minutes, contre 567 minutes en moyenne pour les codeurs humains. La vitesse est réelle ; la précision, non.
Sur 30 entretiens cliniques japonais, ChatGPT-4 concordait avec les chercheurs sur plus de 80 % des thèmes descriptifs, mais sur seulement environ 30 % des thèmes exigeant une interprétation culturelle ou émotionnelle (Sakaguchi et al., 2025).
67 % des praticiens UX qui analysent leurs propres données de recherche utilisent souvent ou toujours l’IA pour cela, mais la qualité des résultats reste le premier frein à l’adoption, citée par 54 % d’entre eux (NN/g, 2026).
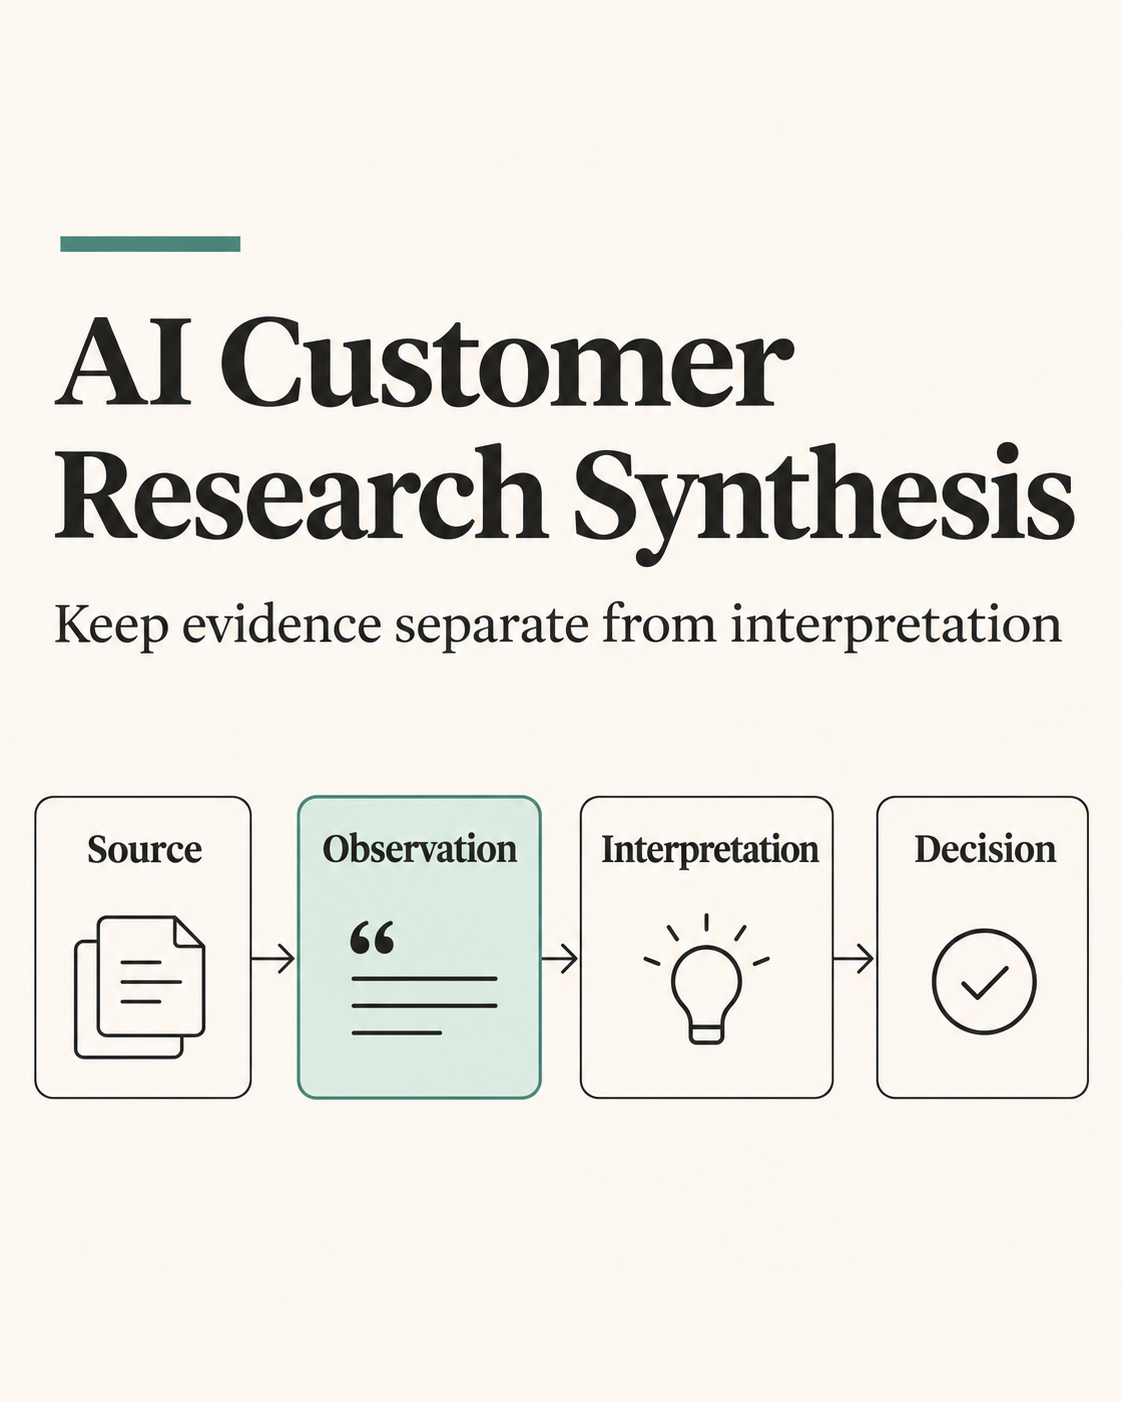
Gardez quatre couches distinctes : source, observation, interprétation, décision. L’IA peut aider sur les deux premières. Les humains possèdent les deux dernières.
Qu’est-ce que la synthèse de recherche par IA, et que ne devrait-elle pas faire ?
La synthèse est l’étape qui suit les entretiens : trouver des motifs et des différences significatives d’une conversation à l’autre, puis décider ce qu’ils signifient pour une décision produit. Notre guide sur décrit la méthode manuelle. La synthèse de recherche par IA confie une partie de ce travail à un modèle : transcrire, extraire des observations, regrouper des propos similaires et proposer des libellés de thèmes.
Ce qu’elle ne doit pas faire, c’est conclure. Un modèle ne connaît ni votre stratégie, ni l’historique du compte du client, ni le participant qui ne convenait pas à l’étude. Quand le Nielsen Norman Group a passé en revue des générateurs d’insights par IA en 2023, les outils ne pouvaient pas intégrer les objectifs de l’étude, les conclusions antérieures ni le contexte de chaque participant, et leurs thèmes sortaient de ce fait non hiérarchisés (NN/g, 2023).
Pourquoi les preuves et le récit ne sont-ils pas la même chose ?
Imaginez trois personnes interrogées qui décrivent une étape de configuration déroutante. L’une dit qu’elle ne savait pas quelle source connecter. Une autre a connecté le mauvais compte. Une troisième demande une checklist de configuration.
Les observations sont précises. « Les utilisateurs ont besoin d’une checklist d’onboarding » est déjà une interprétation. « Le sélecteur d’intégration est le problème » en est une autre. Ni l’une ni l’autre ne doit être archivée comme s’il s’agissait d’une citation directe.
Une synthèse utile garde quatre couches visibles :
Source : l’entretien d’origine, le message au support ou la session observée.
Observation : ce que la personne a dit ou fait, avec assez de contexte pour l’interpréter.
Interprétation : le besoin, la cause ou le motif possible que vous en déduisez.
Décision : ce que l’équipe va faire, tester, reporter ou chercher à apprendre ensuite.
Quand ces couches s’effondrent en un seul résumé, l’équipe perd la possibilité de contester l’interprétation sans mettre en doute la réalité de la source elle-même. NN/g énonce directement la règle de la recherche : il faut « différencier nos interprétations ou hypothèses de ce que les participants ont dit ou fait » (« differentiate between our interpretations or assumptions and what the participants said or did », NN/g, 2023). Les résumés d’IA sont une prose fluide, et c’est précisément dans une prose fluide que cette frontière disparaît.
Quelle est la fiabilité de l’IA pour analyser des données qualitatives ?
Assez fiable pour repérer les thèmes évidents ; pas assez pour qu’on se fie à elle sur les thèmes subtils. Les comparaisons publiées vont dans le même sens :
4 outils de recherche par IA (3 générateurs d’insights, 1 collaborateur)
Transcription et regroupement approximatif
Résumés vagues, aucun contexte, citations sans source
Non mesurée
Prescott et ses collègues ont constaté que les codeurs humains étaient meilleurs sur les thèmes nuancés et interprétatifs, et en ont conclu que des approches hybrides sont nécessaires. Sakaguchi et ses collègues ont qualifié ChatGPT-4 d’outil auxiliaire et insisté sur le besoin persistant d’expertise humaine.
Il s’agit d’études de recherche en santé et d’UX, pas de discovery en startup : ne transposez donc pas les pourcentages à vos propres entretiens. Elles étayent néanmoins une règle de fonctionnement : plus un thème dépend du contexte, de l’émotion ou de ce que la personne n’a pas dit, moins vous devez faire confiance à un libellé généré sans lire la source.
Que rapportent les praticiens ?
L’enquête de NN/g d’octobre 2026 auprès de 521 praticiens UX montre à quel point l’analyse par IA est devenue banale (NN/g, 2026) :
67 % de ceux qui analysent leurs propres données de recherche utilisent souvent ou toujours l’IA pour le faire.
Environ 9 sur 10 de ceux qui utilisent l’IA pour l’analyse, la recherche documentaire ou le codage ont dit qu’elle accélérait le travail.
54 % ont cité des inquiétudes sur la qualité des résultats comme un frein, le plus fréquent.
Parmi 149 commentaires négatifs, les résultats peu fiables et la charge de leur vérification revenaient le plus souvent, dans 40 d’entre eux.
61 % n’avaient jamais utilisé l’IA pour interviewer des utilisateurs.
NN/g décrit cela comme un échantillon de convenance : lisez-le comme une tendance, pas comme une estimation de marché. La tendance est claire : les praticiens utilisent l’IA pour l’analyse parce qu’elle est plus rapide, et consacrent le temps gagné à la vérifier.
Comment mener une synthèse de recherche par IA, étape par étape ?
Cinq étapes. Les deux premières ont lieu avant d’ouvrir un outil d’IA ; les deux dernières sont celles où les humains justifient leur place.
1. Définir la décision avant de résumer
Notez la décision produit que la recherche doit éclairer. Par exemple :
Faut-il simplifier le parcours de connexion du premier lancement, ou d’abord expliquer quelle source l’utilisateur doit connecter ?
Cela empêche un prompt trop large comme « analyse ces entretiens » de produire de beaux thèmes qui n’aident pas pour la décision en cours. Cela permet aussi de remarquer plus facilement quand le matériau ne répond pas à la question. Si vous ne pouvez pas nommer la décision, vous n’êtes pas prêt à faire la synthèse ; vous êtes peut-être encore à l’étape du processus de product discovery où l’on décide ce qu’il faut apprendre.
2. Préparer le matériau source de façon responsable
N’utilisez que du matériau que votre équipe est autorisée à traiter dans l’outil d’IA choisi, dans le cadre du consentement donné par les participants. Retirez les détails personnels ou sensibles, sauf si vous avez une raison claire et approuvée de les conserver ; NN/g note que certains outils de recherche effacent désormais automatiquement les noms, les adresses e-mail et autres identifiants similaires (NN/g, 2024). Conservez un identifiant de source et une date pour qu’un relecteur retrouve l’enregistrement d’origine, tout en contrôlant l’accès à la transcription sous-jacente.
Ne mélangez pas des notes de groupes de clients ou de questions de recherche différents sans les étiqueter. Un entretien avec un fondateur, un ticket de support et une session d’utilisabilité observée peuvent tous être utiles ; ce ne sont pas des preuves interchangeables. Étiquetez chaque enregistrement avec son type et le segment du participant avant que le modèle ne le voie.
3. Demander à l’IA d’organiser, pas de conclure
Donnez au modèle une tâche bornée. Demandez-lui de :
extraire les observations pertinentes pour la décision ;
associer à chaque observation un identifiant de source et le passage exact qui l’appuie ;
séparer les déclarations directes des besoins déduits ;
lister les contre-exemples et les preuves contradictoires ;
signaler le contexte manquant et les questions auxquelles il ne peut pas répondre ;
éviter de compter des mentions répétées comme des utilisateurs indépendants, sauf si l’ensemble des sources soutient ce décompte.
Ne demandez pas de persona définitive, de conclusion valable pour tout le marché ni de roadmap hiérarchisée à partir de quelques conversations. Un modèle peut mettre l’incertitude en forme jusqu’à la faire disparaître, sauf si vous lui demandez expressément de la conserver. NN/g a constaté que le regroupement par IA associe souvent les éléments selon des mots-clés communs plutôt qu’un sens commun ; traitez donc les premiers regroupements comme une aide au tri (NN/g, 2024).
4. Vérifier chaque affirmation susceptible de changer la roadmap
Un PM ou un fondateur doit ouvrir la source d’origine pour chaque thème proposé à fort impact. Vérifiez si la citation appuie l’affirmation, si le contexte qui l’entoure en change le sens, et si le modèle a fusionné les expériences de personnes différentes.
Cherchez ensuite les preuves qui ne cadrent pas. Si deux utilisateurs décrivent le même symptôme pour des raisons différentes, gardez les deux explications. Si une seule histoire marquante est le seul appui d’une idée, signalez-la comme un signal à explorer plutôt que comme un motif avéré.
Un tableau de relecture pratique ressemble à ceci :
Thème proposé
Source à l’appui
Qu’est-ce qui est observé directement ?
Interprétation
Contre-preuve ou lacune
Prochaine étape
La source à configurer n’est pas claire
Entretien 04, note de session
La personne a connecté un autre compte que celui prévu
Les libellés du choix sont peut-être ambigus
Une seule observation ; pas encore de relecture de la tâche
Revoir l’enregistrement et tester la compréhension des libellés
Les utilisateurs veulent une checklist
Entretien 07, transcription
La personne a demandé une checklist après avoir été bloquée
Elle a peut-être besoin d’être guidée au moment de la décision
La demande reflète peut-être la préférence de cette personne
Comparer avec les cas de support et observer la première utilisation
Le tableau est volontairement modeste. Il ne transforme pas deux conversations en pourcentage et ne prétend pas que « les utilisateurs » se comportent tous de la même façon.
5. Consigner la décision et son déclencheur d’apprentissage
Une fois que l’équipe a examiné les preuves, notez ce qu’elle a décidé et pourquoi. Indiquez le responsable de la décision, les sources à l’appui, l’incertitude principale et les preuves futures qui feraient changer le choix. Un journal des décisions produit lui offre un lieu permanent.
Par exemple :
Décision : Tester des descriptions de source plus claires avant de construire une checklist de configuration complète.
Pourquoi : Deux sources indépendantes révèlent une incertitude au moment du choix de connexion, mais nous n’avons pas observé assez de sessions de premier lancement pour savoir si le problème vient des libellés, de l’ordre ou d’un guidage manquant.
Déclencheur de révision : Y revenir après avoir examiné plusieurs sessions de configuration représentatives, ou si les remontées du support pointent vers un autre point de blocage.
L’échantillon dont vous avez besoin dépend de la décision, du risque et de la variété de vos utilisateurs. Ne considérez pas un nombre d’entretiens fixe comme une preuve de saturation ou de représentativité. Si les preuves restent partagées, la prochaine étape utile est peut-être une nouvelle observation plutôt qu’un résumé plus soigné.
Quel prompt utiliser pour la synthèse de recherche par IA ?
Procédez en deux passes : une pour organiser, une pour vous aider à prioriser la vérification. Vous pouvez adapter ce premier prompt à un ensemble de sources autorisé et correctement protégé :
Aide-moi à organiser ces notes de recherche pour la décision suivante : [question de décision]. Pour chaque observation proposée, indique l’identifiant de la source et le passage exact qui l’appuie. Sépare les preuves directes de l’interprétation. Liste les exemples contradictoires, le contexte manquant et les explications alternatives. N’en déduis aucune fréquence au-delà des enregistrements fournis. Ne recommande pas de décision de roadmap. Si une affirmation ne peut pas être appuyée par un passage, qualifie-la de non étayée. Renvoie un tableau avec observation, citation, source, interprétation, justification du niveau de confiance, contre-preuves et question de suivi.
Lancez ensuite un second prompt sur le résultat :
Pour chaque thème ci-dessus, liste les participants distincts (pas les mentions) qui l’appuient, par identifiant de source. Signale tout thème appuyé par un seul participant, toute citation que tu ne retrouves pas mot pour mot dans les sources, et tout thème qui combine des participants de segments différents.
La seconde passe n’est pas une vérification. Un modèle qui contrôle son propre travail peut répéter ses propres erreurs. C’est une manière de trier les thèmes pour que le contrôle humain commence par les plus fragiles. Aucun des deux prompts ne rend le résultat fiable à lui seul ; ensemble, ils le rendent plus facile à inspecter.
Comment contrôler une synthèse d’IA avant qu’elle n’atteigne la roadmap ?
Copiez cette checklist dans votre document de synthèse et cochez-la avant qu’un thème ne devienne un ticket ou une ligne de PRD :
La décision éclairée par cette synthèse est écrite en haut.
Chaque citation est textuelle : vous avez cherché dans la transcription et vous l’y avez trouvée.
Chaque thème indique combien de personnes distinctes l’appuient, et non combien de mentions.
Chaque thème nomme le segment, le rôle ou la situation de ces personnes.
Les contre-preuves sont listées sous le thème qu’elles remettent en cause.
Les affirmations sur les raisons d’agir ou les sentiments des gens sont marquées comme interprétation.
Les thèmes reposant sur une seule personne sont étiquetés comme des signaux à explorer.
Les voix manquantes sont notées : ceux à qui vous n’avez pas parlé.
Exemple concret : contrôler une synthèse en une heure
Cet exemple est illustratif. Prenons une équipe de cinq personnes avec 8 entretiens d’onboarding, environ 6 heures d’enregistrements, plus 40 tickets de support. GOV.UK suggère environ 1 heure d’analyse pour 2 heures de recherche (GOV.UK) : un passage manuel sur les seuls appels représente donc environ 3 heures. NN/g conseille de prévoir au moins autant de temps pour l’analyse que pour la collecte, ce qui ferait davantage (NN/g, 2022).
Le passage par l’IA prend 10 minutes et propose 7 thèmes appuyés par 31 citations. La PM ne vérifie que les 3 thèmes susceptibles de changer le prochain sprint : 14 citations, environ 45 minutes de lecture. Elle constate que 2 citations sont paraphrasées et non textuelles. Un thème, « les utilisateurs veulent une checklist », repose sur 2 personnes qui demandaient des choses différentes. Un autre, « la source à configurer n’est pas claire », tient sur 5 entretiens sur 8 et 9 tickets.
Seul ce dernier thème entre dans le registre de décision, les 2 demandes de checklist étant conservées comme question ouverte. Le temps total est d’environ une heure, et chaque affirmation qui atteint la roadmap a été lue dans sa source par une personne. Pour la même discipline appliquée aux specs rédigées par IA, voyez le suivi des affirmations contre l’hallucination de specs.
Quelles tâches de synthèse confier à l’IA, et lesquelles garder ?
Tâche
La confier à l’IA ?
Pourquoi
Contrôle humain
Transcription
Oui
Mature et rapide
Vérifier par sondage les noms, le jargon et les chevauchements de voix
Suppression des données personnelles
Oui, avec relecture
Évite une étape fastidieuse
Confirmer qu’il ne reste rien d’identifiant
Extraction d’observations avec citations
Oui
Bonne pour trouver des passages
Les citations doivent être textuelles et sourcées
Premier regroupement
Oui
Aide au tri rapide
Regrouper par situation, pas par mot-clé
Libellé des thèmes interprétatifs (pourquoi, émotion)
Les mentions ne sont pas des personnes ; les échantillons sont petits
Utiliser l’analytics ou un sondage pour la prévalence
Analyser des sessions d’utilisabilité à partir des transcriptions
Non
Les transcriptions manquent ce que les utilisateurs ont fait (NN/g, 2023)
Regarder l’enregistrement
Recommander ce qu’il faut construire
Non
Le modèle ignore la stratégie et les arbitrages
L’équipe décide
Rechercher dans les recherches passées
Oui
Efficace pour « qu’ont dit les clients sur X ? »
Ouvrir la source avant de citer
Quelles sont les erreurs courantes de la synthèse de recherche par IA ?
Traiter un résumé fluide comme une conclusion. Le poli n’est pas une preuve. Un thème n’est une conclusion qu’après que quelqu’un a lu ses sources.
Compter des mentions comme des personnes. Un client frustré qui soulève cinq fois le même problème est un point de donnée, pas cinq.
Mélanger les segments. Un fondateur solo et une équipe de 50 personnes peuvent décrire le même symptôme pour des raisons différentes. En faire la moyenne invente un utilisateur qui n’existe pas.
Abandonner les contre-exemples. Les modèles ont tendance à résoudre les tensions en une histoire propre. Demandez explicitement les contradictions et gardez-les visibles.
Laisser le résumé remplacer la source. Gardez la transcription ou le ticket à un clic de chaque affirmation, faute de quoi personne ne pourra contester l’interprétation plus tard.
Faire la synthèse trop tard. Les insights se périment. Les équipes qui pratiquent la continuous discovery synthétisent quelques entretiens à la fois, tant que le contexte est frais.
L’IA ne peut pas non plus réparer un échantillon mince ou biaisé. Si vous n’avez parlé qu’à vos clients les plus satisfaits, une synthèse parfaite de ces appels reste une synthèse de vos clients les plus satisfaits. De meilleures questions aident ; notre modèle d’entretien client se concentre sur le comportement récent plutôt que sur les opinions.
Où Specky intervient
Specky lit les appels clients, les retours, Slack, Jira et l’analytics pour les intégrer à un Product Graph, puis rédige des specs et des tickets avec des citations en ligne renvoyant aux preuves, afin qu’un relecteur puisse ouvrir la source derrière chaque affirmation. Alex, l’agent de recherche de Specky, mène des entretiens clients à partir d’un lien partageable, si bien que la recherche n’attend pas les agendas. La règle de ce guide reste valable : une citation rend une affirmation vérifiable, pas vraie. Quelqu’un dans l’équipe lit encore la source avant que l’affirmation n’atteigne la roadmap.
Questions fréquentes
L’IA peut-elle faire seule la synthèse de recherche client ?
Non. L’IA peut transcrire, extraire des citations et proposer des thèmes bien plus vite qu’une personne, mais les comparaisons publiées montrent qu’elle ne concorde avec les codeurs humains que sur 36 à 47 % des codes individuels et sur environ 30 % des thèmes interprétatifs. Utilisez-la pour le premier passage, puis demandez à quelqu’un qui connaît le produit et les clients de vérifier chaque thème susceptible de changer une décision.
Quelle est la précision de l’analyse thématique par IA comparée à celle des humains ?
Cela dépend du type de thème. ChatGPT-4 concordait avec les chercheurs humains sur plus de 80 % des thèmes descriptifs dans une étude de 2025, mais sur seulement environ 30 % des thèmes exigeant une interprétation culturelle ou émotionnelle. Une étude de 2024 a montré que l’IA retrouvait 71 % des thèmes inductifs des humains. Attendez-vous à un bon rappel des sujets évidents et à un jugement faible sur le sens.
Comment empêcher l’IA d’inventer des citations ?
Exigez un identifiant de source et le passage exact pour chaque observation, et dites au modèle de qualifier de non étayé tout ce qu’il ne peut pas appuyer. Cherchez ensuite dans la transcription chaque citation qui soutient un thème à fort impact. NN/g a constaté que certains outils de recherche par IA attribuaient des citations sans nommer la session ni l’horodatage, ce qui rend cette vérification impossible : choisissez donc des outils qui citent leurs sources.
Est-il sûr de téléverser des entretiens clients dans un outil d’IA ?
Seulement si les participants ont consenti à ce traitement et si votre organisation a approuvé l’outil pour ce type de données. Retirez les noms, e-mails et autres identifiants dont vous n’avez pas besoin, vérifiez où l’outil stocke et traite les données, et limitez les personnes qui peuvent voir les transcriptions brutes. Sous le RGPD, les enregistrements et transcriptions d’entretiens sont des données personnelles dès lors qu’un participant peut être identifié.
Combien d’entretiens faut-il avant que la synthèse par IA soit utile ?
L’IA aide dès le premier entretien, pour la transcription et l’extraction d’observations. Les thèmes transversaux demandent plusieurs conversations sur la même décision avant qu’un motif mérite d’être vérifié. Le bon nombre dépend de la variété de vos utilisateurs et du risque de la décision. Les entretiens expliquent pourquoi quelque chose arrive ; utilisez l’analytics ou un sondage pour savoir à quelle fréquence.
GDPR-aligned. EU workspace data is stored in Frankfurt, Germany. GDPR and EU data Built in Vienna, Austria. A product of influence solutions fm GmbH (FN 675374y). Imprint 14-day trial. Card required, and nothing is charged until day 14. 30-day refund after subscribing. See pricing