9 novembre 2026Mis à jour le Fathy Shalaby12 min de lecture
Modèle de test d’utilisabilité : script, tâches et plan pour 5 utilisateurs
Chaque fois que vous avez envie d’expliquer votre produit, vous avez trouvé un bug. Cinq personnes, trois tâches au plus, et vous ne dites rien jusqu’à la fin.
Un modèle de test d’utilisabilité est un plan prêt à l’emploi pour regarder de vrais utilisateurs essayer d’accomplir des tâches dans votre produit pendant que vous restez silencieux. Il vous donne les tâches, un script neutre, ce qu’il faut mesurer et un journal des résultats, de sorte que cinq séances d’environ 30 minutes vous montrent où les gens bloquent. Vous trouverez ci-dessous un modèle gratuit, le script, un signal de réussite et les preuves derrière la règle des cinq utilisateurs.
L’essentiel
Cinq utilisateurs d’un même type trouvent la plupart des problèmes. Le modèle de Jakob Nielsen établit que cinq participants révèlent environ 85 % des problèmes d’utilisabilité, et il conseille trois séries de cinq plutôt qu’une série de 15 (Nielsen Norman Group, 2000).
Cinq utilisateurs permettent de trouver des problèmes, pas des chiffres à citer. Pour un taux de réussite ou une référence, Nielsen recommande au moins 20 utilisateurs (Nielsen Norman Group, 2012).
Sur 1 189 tâches issues de 115 tests d’utilisabilité, le taux moyen de réussite des tâches était de 78 % (MeasuringU, 2011).
Le System Usability Scale à 10 questions donne un score comparable après les tâches. Au-dessus de 68, on est au-dessus de la moyenne.
Fixez d’abord le signal de réussite : au moins 4 personnes sur 5 y arrivent sans aide.
Qu’est-ce qu’un test d’utilisabilité ?
Un test d’utilisabilité donne à des utilisateurs cibles une tâche à accomplir sur la version actuelle de votre produit, et vous observez en silence pour voir où ils bloquent.
Kate Moran, du Nielsen Norman Group, le décompose en trois éléments : un animateur qui donne des consignes sans orienter, des tâches réalistes et un participant réaliste qui pense généralement à voix haute (NN/g, 2019).
Le test qualitatif trouve des problèmes et c’est le plus courant. Le test quantitatif collecte des indicateurs comme la réussite des tâches et le temps passé par tâche, pour établir une référence. Ce modèle est qualitatif et modéré : vous regardez en direct, en personne ou par partage d’écran, ce qui vous permet de demander à la fin « Qu’attendiez-vous qu’il se passe ? »
Quand faire un test d’utilisabilité, et quand l’éviter ?
Utilisez-le quand quelque chose est déjà construit et que les gens abandonnent ou demandent de l’aide. Il est peu coûteux, et les résultats sont généralement évidents une fois qu’on les voit. Le NN/g estime qu’une étude simple prend environ 3 jours, de la préparation à l’analyse en passant par cinq séances, avec des incitations de quelques centaines de dollars.
Ne l’utilisez pas pour savoir si les gens veulent le produit. Ils essaieront de bonne grâce tout ce que vous leur présentez. Ne l’utilisez pas non plus sur un design qui n’existe pas encore. Un prototype cliquable fait ce travail, et un prototype papier coûte encore moins cher. Pour observer comment les gens se débrouillent avec le produit d’un concurrent plutôt qu’avec le vôtre, faites un test boomerang.
Quel risque teste-t-il, et quelle est la force des preuves ?
Il teste la désirabilité au sens pratique : les gens peuvent-ils réellement s’en servir pour accomplir leur tâche ? La preuve est un comportement. Il montre que le produit fonctionne pour les gens, mais pas qu’ils y trouvent de la valeur. Voir notre guide pour choisir une expérience produit pour la vue d’ensemble.
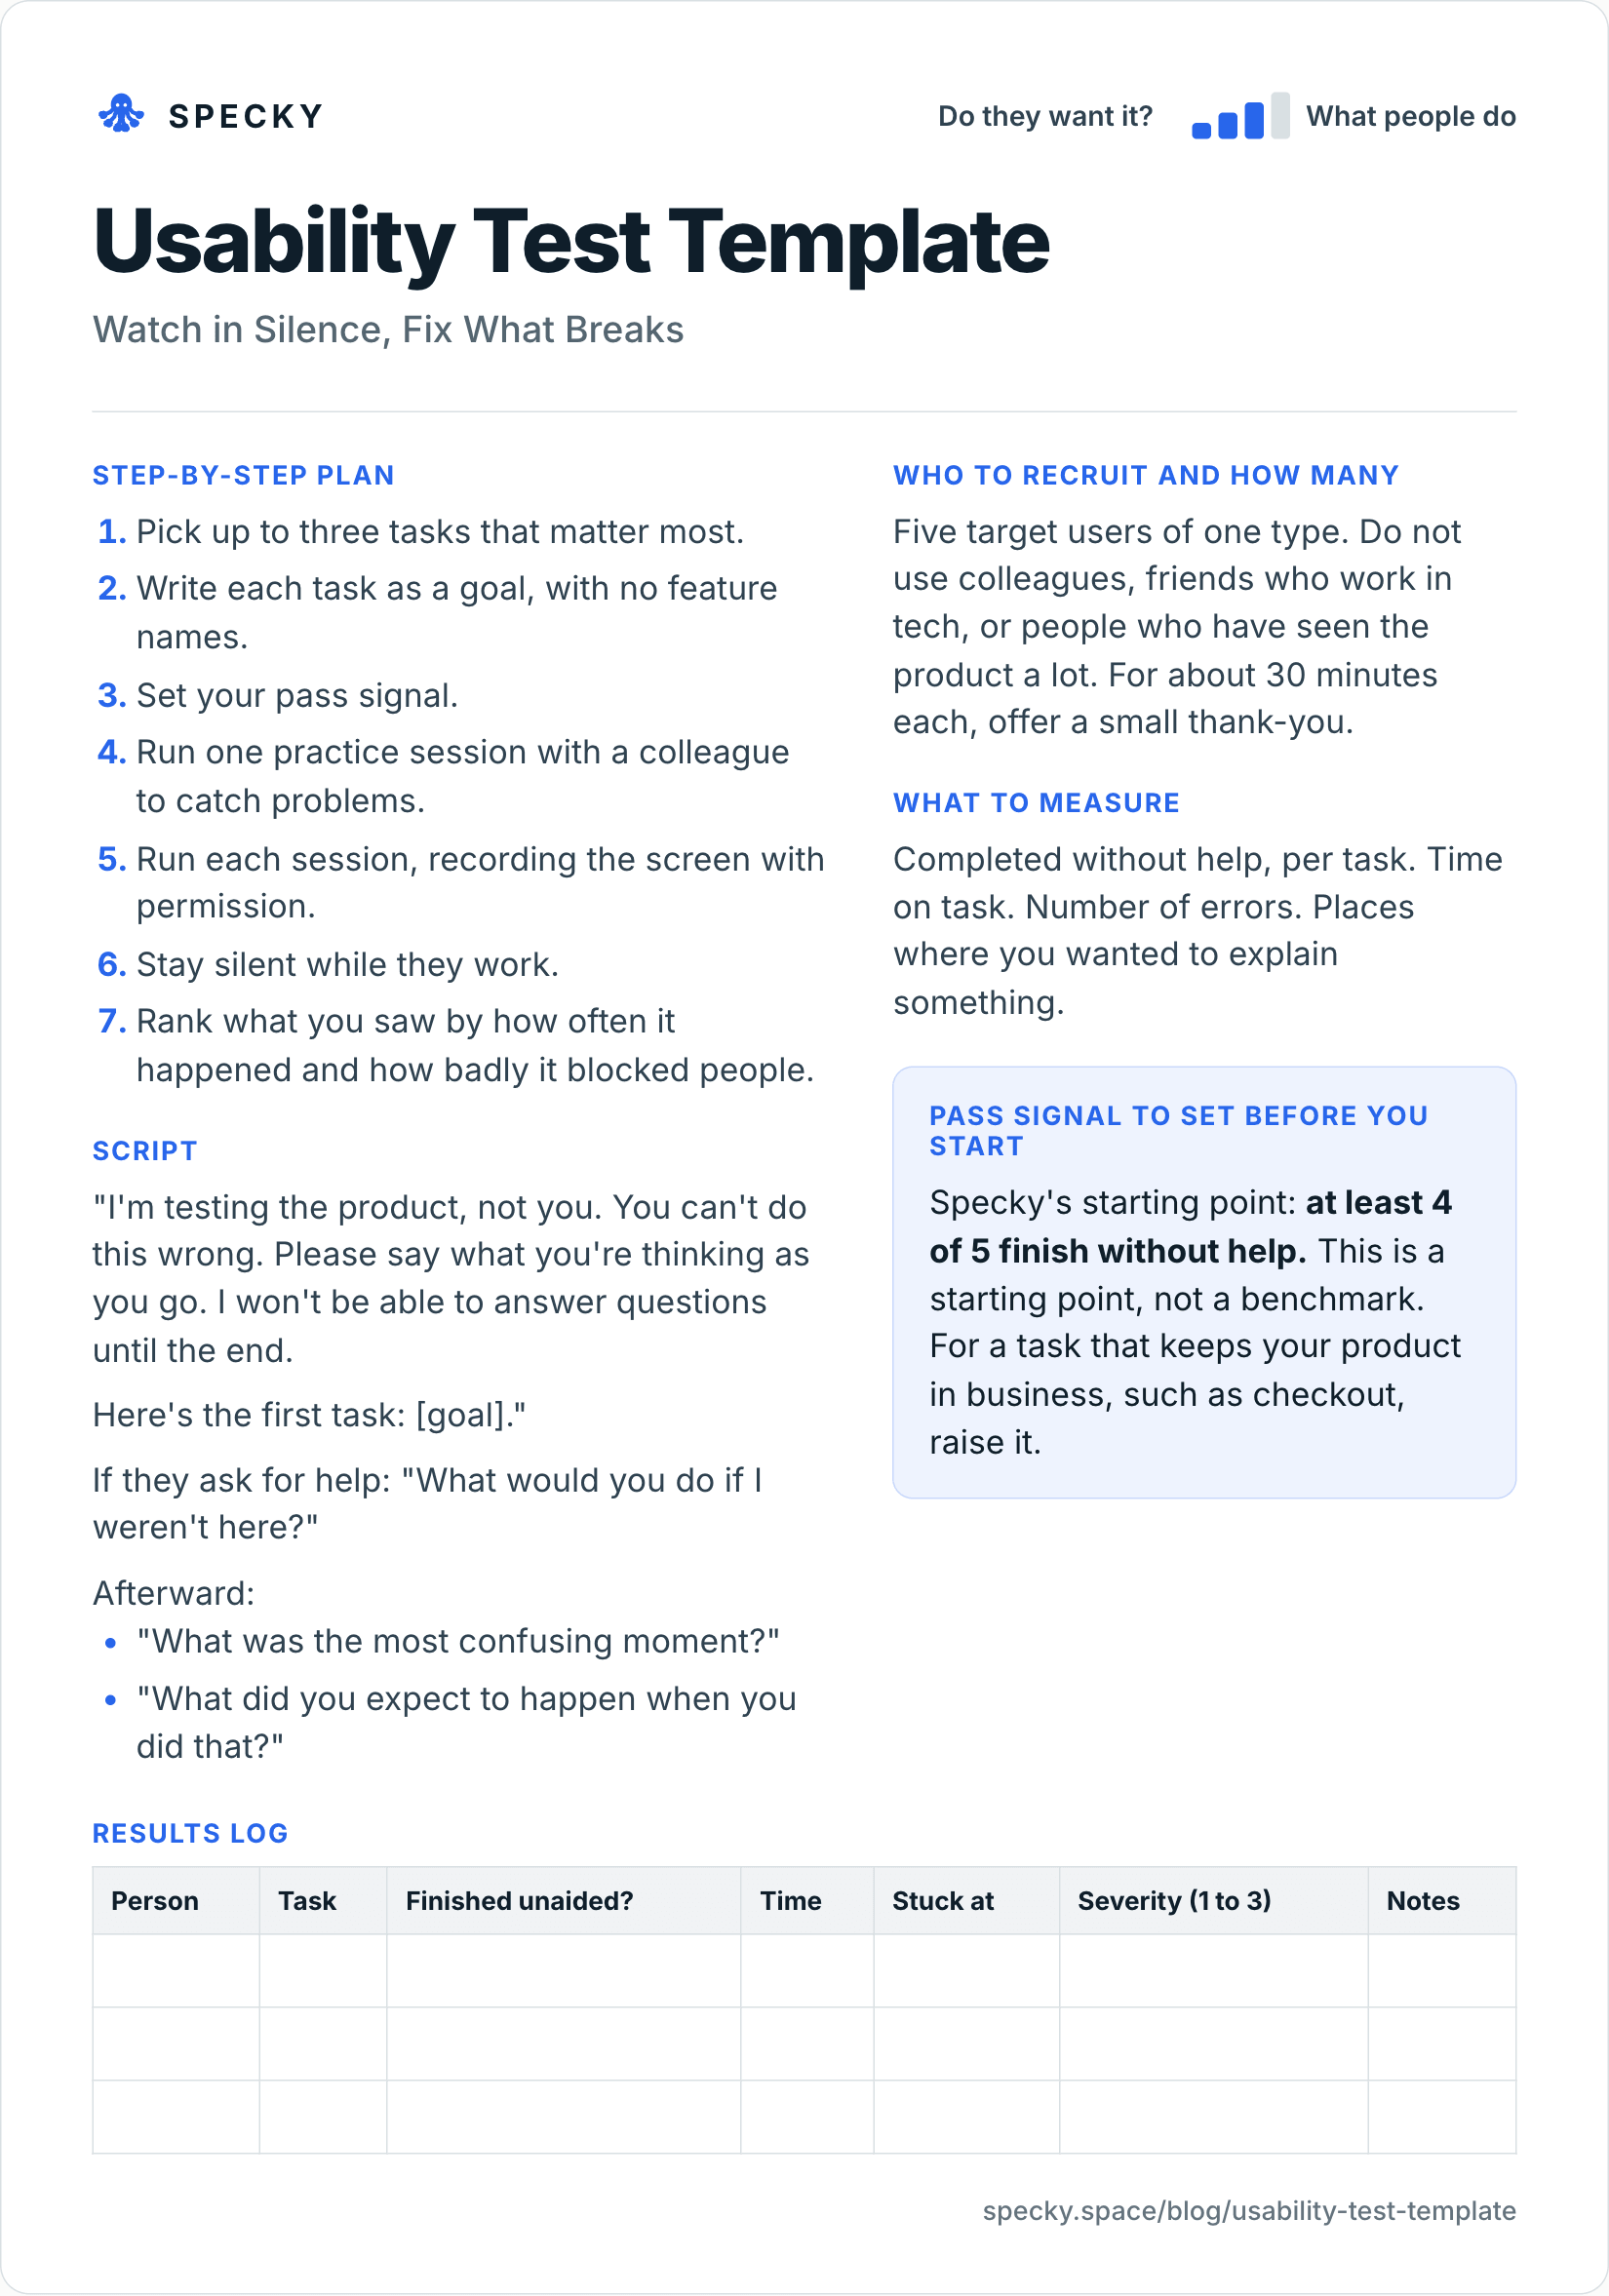
Modèle de test d’utilisabilité (à copier et utiliser)
Ouvrez l’image en taille réelle, ou copiez la version texte ci-dessous.
Qui recruter et combien
Cinq utilisateurs cibles d’un même type. N’utilisez ni collègues, ni amis qui travaillent dans la tech, ni personnes qui ont beaucoup vu le produit. Pour environ 30 minutes chacun, offrez un petit remerciement.
Plan pas à pas
Choisissez jusqu’à trois tâches parmi les plus importantes.
Écrivez chaque tâche comme un objectif, sans nom de fonctionnalité.
Fixez votre signal de réussite.
Faites une séance d’essai avec un collègue pour repérer les problèmes.
Menez chaque séance en enregistrant l’écran avec autorisation.
Restez silencieux pendant qu’ils travaillent.
Classez ce que vous avez vu selon la fréquence et la gravité du blocage.
Script
« Je teste le produit, pas vous. Vous ne pouvez pas vous tromper. Dites à voix haute ce que vous pensez au fur et à mesure. Je ne pourrai pas répondre aux questions avant la fin.
Voici la première tâche : [objectif]. »
S’ils demandent de l’aide : « Que feriez-vous si je n’étais pas là ? »
Ensuite :
« Quel a été le moment le plus déroutant ? »
« Qu’attendiez-vous qu’il se passe quand vous avez fait cela ? »
Ce qu’il faut mesurer
Réussi sans aide, par tâche. Temps passé par tâche. Nombre d’erreurs. Moments où vous avez eu envie d’expliquer quelque chose.
Signal de réussite à fixer avant de commencer
Point de départ de Specky : au moins 4 personnes sur 5 réussissent sans aide. C’est un point de départ, pas une référence. Pour une tâche dont dépend la survie de votre activité, comme le paiement, relevez-le.
Journal des résultats
Personne
Tâche
Réussi sans aide ?
Temps
Bloqué à
Gravité (1 à 3)
Notes
Comment rédiger de bonnes tâches de test d’utilisabilité ?
Une tâche est un objectif que la personne a déjà, formulé avec ses mots. Si la tâche nomme votre bouton, vous testez si les gens savent lire.
Tâche faible
Meilleure tâche
« Utilisez le bouton Importer pour ajouter des invités. »
« Vous avez 40 invités dans un tableur. Faites-les entrer dans votre liste d’invités. »
« Ouvrez les Paramètres et changez le logo de la facture. »
« Vos factures doivent afficher votre nouveau logo. Faites en sorte que ce soit le cas. »
Décidez avant la première séance ce que « terminé » veut dire : « les invités apparaissent avec leurs noms et e-mails » est une réussite, « ils ont trouvé l’écran d’import » n’en est pas une. Donnez aux gens des données réalistes et imprimez chaque tâche sur une fiche afin qu’ils puissent la relire sans vous demander.
De combien d’utilisateurs avez-vous besoin pour un test d’utilisabilité ?
Cinq par série, d’un seul type d’utilisateur. Le modèle de Nielsen dit que la part de problèmes trouvés avec n utilisateurs est 1 − (1 − L)ⁿ, où L est la part qu’un seul utilisateur trouve. Sur les projets qu’il a étudiés, L valait en moyenne 31 % (Nielsen Norman Group, 2000).
Ces 31 % sont une moyenne. Un problème qui ne gêne qu’une personne sur dix est beaucoup plus facile à manquer :
Utilisateurs dans la série
Problèmes trouvés (L = 31 %)
Chance de voir un problème qui touche 10 % des utilisateurs
1
31 %
10 %
3
67 %
27 %
5
84 %
41 %
10
98 %
65 %
15
99,6 %
79 %
C’est pourquoi Nielsen recommande de répartir un budget de 15 personnes en trois séries de cinq, en corrigeant le design entre les séries : les problèmes rares apparaissent au fil des séries.
Chaque type d’utilisateur a besoin de sa propre série. Pour deux groupes, Nielsen suggère 3 à 4 utilisateurs chacun ; pour trois groupes ou plus, 3 chacun.
Les chiffres demandent plus de monde. Pour des indicateurs statistiquement significatifs, il recommande au moins 20 utilisateurs (NN/g, 2012). Dans le même article, une enquête auprès de 217 participants à une conférence a montré que les équipes comptaient en moyenne 11 participants par série.
Exemple chiffré : pourquoi cinq utilisateurs ne peuvent pas donner un taux de réussite
Cet exemple est illustratif. Imaginons que 4 personnes sur 5 réussissent votre tâche de paiement. Cela fait « 80 % de réussite », mais l’intervalle de confiance à 95 % (Wald ajusté) va d’environ 36 % à 98 %. Le vrai taux pourrait être mauvais ou excellent.
Imaginons maintenant que 16 sur 20 réussissent. Toujours 80 %, mais l’intervalle se resserre à environ 58 %–93 %. Utilisez cinq personnes pour trouver et corriger des problèmes, et 20 ou plus quand quelqu’un a besoin d’un pourcentage.
Que faut-il mesurer dans un test d’utilisabilité ?
Les quatre mesures du modèle suffisent pour une série qualitative. Deux ajouts rendent les résultats plus faciles à exploiter.
Comment évaluer la gravité d’un problème d’utilisabilité ?
Nielsen évalue la gravité selon trois facteurs : la fréquence du problème, la difficulté à le surmonter et le fait qu’il continue de gêner les gens (NN/g, 1994). Son échelle va de 0 à 4 ; l’échelle de 1 à 3 du modèle correspond à ses trois niveaux supérieurs :
Gravité dans le modèle
Niveau de Nielsen
Ce qui s’est passé
Que faire
1
2, mineur
Les a ralentis, ils s’en sont remis
Corriger quand c’est peu coûteux
2
3, majeur
A demandé plusieurs essais ou une supposition
Corriger avant la série suivante
3
4, catastrophe
Impossible de finir sans aide
Corriger avant la sortie
Nielsen a constaté que les notes de gravité d’une seule personne sont trop peu fiables et recommande de faire la moyenne de trois évaluateurs. Notez séparément, puis comparez.
Faut-il ajouter le System Usability Scale ?
Le System Usability Scale (SUS) est un questionnaire de 10 items avec cinq réponses allant de « Tout à fait d’accord » à « Pas du tout d’accord ». John Brooke l’a créé en 1986, et usability.gov recensait plus de 1 300 articles et publications qui le citent (usability.gov, archived).
Pour le calculer, soustrayez 1 à chaque réponse de rang impair, soustrayez chaque réponse de rang pair de 5, additionnez les dix résultats et multipliez par 2,5 (MeasuringU, 2011). Exemple illustratif : les réponses 4, 2, 4, 1, 4, 2, 5, 2, 4, 2 donnent 16 pour les items impairs et 16 pour les items pairs, soit 32 × 2,5 = un score SUS de 80.
Ce score n’est pas un pourcentage. La moyenne sur 500 études est de 68, et les 10 % meilleurs dépassent 80,3. Le SUS n’est pas non plus diagnostique : il dit à quel point quelque chose paraît utilisable, pas ce qu’il faut corriger. Avec cinq personnes, lisez-le comme un signal approximatif et comparez-le d’une série à l’autre.
Test d’utilisabilité, test de prototype cliquable ou entretien client
Les gens peuvent-ils accomplir la tâche avec ce que nous avons construit ?
Ce design va-t-il fonctionner, et le réclament-ils ?
Quel problème les gens ont-ils, et comment le résolvent-ils aujourd’hui ?
Preuve
Comportement sur le produit réel
Comportement sur une simulation
Ce que les gens disent du passé
Meilleur moment
Après le lancement, quand les gens abandonnent ou demandent de l’aide
Avant de construire
Avant de concevoir quoi que ce soit
Les entretiens trouvent le problème, un prototype teste une solution avant de la construire, et un test d’utilisabilité la vérifie une fois qu’elle est réelle.
À quoi ressemble un test d’utilisabilité en pratique ?
Cet exemple est inventé pour illustrer la méthode. Une équipe qui exploite un outil pour organisateurs de mariage constate que beaucoup de gens commencent une liste d’invités mais ne la terminent pas. Elle observe cinq organisateurs essayer d’importer 40 noms depuis un tableur.
Deux y arrivent. Trois atteignent un écran intitulé « Map fields », s’arrêtent et reviennent en arrière. L’un dit : « Je ne comprends pas ce que vous me demandez. »
Le signal n’est pas atteint. L’équipe remplace cet écran par un aperçu des noms importés et teste avec cinq autres personnes la semaine suivante. Quatre y arrivent. Personne n’a eu à redessiner le reste du produit.
Dans le journal, trois personnes sur cinq bloquées sur un seul écran font de « Map fields » une gravité 3. Un bouton « Done » sous la ligne de flottaison a ralenti une personne et a été noté en gravité 1. Première série : 2 sur 5. Deuxième série : 4 sur 5, ce qui atteint le signal de réussite. Dix séances de 30 minutes, un seul écran modifié.
Quelles sont les erreurs les plus courantes dans les tests d’utilisabilité ?
Aider. Chaque fois que vous expliquez, vous masquez un vrai problème.
Nommer la fonctionnalité dans la tâche. « Utilisez le bouton Importer » teste la lecture, pas l’utilisabilité.
Tester avec des collègues. Ils savent déjà comment cela fonctionne.
Demander des opinions. Observez ce qu’ils font.
Rédiger un rapport au lieu d’un correctif. Corrigez le problème principal et testez à nouveau.
Citer des pourcentages à partir de cinq personnes. « 80 % de réussite » avec 4 sur 5 a un intervalle de 36 % à 98 %.
Quand cela ne marche pas : pour les questions de demande ou de prix, pour les problèmes rares qui nécessitent des dizaines de séances pour apparaître, et pour les comportements qui n’émergent qu’après des semaines d’usage réel.
Comment enregistrer des séances d’utilisabilité de façon éthique ?
Un enregistrement d’écran avec la voix constitue une donnée personnelle, traitez-le comme tel. Dites aux gens ce que vous enregistrez, qui le regardera et combien de temps vous le conservez, et obtenez un oui avant d’appuyer sur enregistrer. Précisez qu’ils peuvent s’arrêter à tout moment et recevoir quand même le remerciement. Utilisez des comptes de test et des données d’exemple, jamais leurs vrais clients ni leurs coordonnées bancaires. Partagez des extraits de 30 secondes du problème, pas des séances entières, et supprimez les fichiers bruts une fois la série terminée.
Comment le mener dans Specky
Sur la page Assumptions, cliquez sur la note et choisissez Pick a test, puis Usability test. Specky renseigne cinq utilisateurs, le signal de réussite et un calendrier de trois jours.
Celui-ci, c’est vous qui le menez. Specky conserve le plan et le résultat. Tenez les séances et enregistrez-les vous-même, avec autorisation.
Cliquez sur Start running. Collez ce qui s’est passé dans chaque séance et enregistrez le résultat.
Un test réussi apparaît sur le tableau comme Supported, car regarder quelqu’un terminer une tâche est un comportement.
Que faire de chaque résultat ?
Supported : le parcours fonctionne. Vérifiez qu’il tient face à du trafic réel avec un contrôle d’analytique produit.
Unclear : les résultats diffèrent selon le type d’utilisateur. Séparez-les et menez cinq tests pour chacun.
Contradicted : les gens n’arrivent pas à le terminer. Corrigez d’abord le pire problème, puis testez à nouveau. Tout pari reposant sur cette note apparaît désormais comme Contradicted, et il doit le rester jusqu’au nouveau test.
De combien d’utilisateurs avez-vous besoin pour un test d’utilisabilité ?
Cinq utilisateurs d’un même type, c’est le point de départ standard. Le modèle de Jakob Nielsen estime que cinq participants trouvent environ 85 % des problèmes d’utilisabilité, à condition que ce soient des utilisateurs similaires. Testez de nouveau avec cinq autres après chaque correction plutôt que d’en réunir 15 d’un coup. Pour deux groupes d’utilisateurs distincts, testez-en trois ou quatre de chaque, et prenez-en au moins 20 pour des chiffres que vous comptez citer.
Que faut-il dire pendant un test d’utilisabilité ?
Le moins possible. Lisez la tâche, demandez aux gens de penser à voix haute, puis taisez-vous. Si quelqu’un demande de l’aide, répondez : « Que feriez-vous si je n’étais pas là ? » Votre envie d’expliquer signale un problème d’utilisabilité, notez-le donc. Gardez pour la fin des questions comme « Qu’attendiez-vous qu’il se passe ? »
Quelle est la différence entre un test d’utilisabilité et la recherche utilisateur ?
Un test d’utilisabilité est un type de recherche utilisateur. Il vérifie si les gens peuvent utiliser quelque chose qui existe déjà, en les regardant essayer des tâches. La recherche plus large, comme les entretiens clients, explore ce dont les gens ont besoin et comment ils se débrouillent aujourd’hui, avant que quoi que ce soit ne soit conçu. Les entretiens trouvent le problème ; les tests d’utilisabilité vérifient la solution.
Quel est un bon taux de réussite des tâches ?
Sur 1 189 tâches issues de 115 tests d’utilisabilité, MeasuringU a trouvé un taux moyen de réussite de 78 %, le quart supérieur dépassant 92 % et le quart inférieur restant sous 49 %. Pour les tâches dont l’échec coûte cher, comme le paiement, visez 100 %. Avec cinq utilisateurs, comptez les réussites plutôt que de citer un taux, car la marge d’erreur est trop large.
GDPR-aligned. EU workspace data is stored in Frankfurt, Germany. GDPR and EU data Built in Vienna, Austria. A product of influence solutions fm GmbH (FN 675374y). Imprint 14-day trial. Card required, and nothing is charged until day 14. 30-day refund after subscribing. See pricing