16 octobre 2026Mis à jour le Fathy Shalaby13 min de lecture
Les quatre risques produit : quelles preuves comptent pour chacun
L'IA a rendu la faisabilité peu coûteuse à prouver. La valeur, l'utilisabilité et la viabilité exigent encore chacune leurs propres preuves, et une belle démo de prototype pèse moins qu'elle n'en a l'air. Le Risk Receipt montre ce que vous avez réellement levé comme risque.
Les quatre risques produit sont la valeur (les clients l'achèteront-ils ou l'utiliseront-ils ?), l'utilisabilité (peuvent-ils comprendre comment s'en servir ?), la faisabilité (pouvons-nous le construire ?) et la viabilité (est-ce que cela fonctionne pour l'entreprise ?). Le cadre de Marty Cagan reste valable, mais l'IA a changé l'économie : la faisabilité se teste désormais à peu de frais, tandis que les trois autres risques exigent encore leurs propres preuves. Une démo de prototype en dit beaucoup moins sur la valeur qu'on ne le ressent.
Points clés
Les quatre grands risques de Cagan sont indépendants : les preuves de l'un n'apprennent pas grand-chose sur un autre (SVPG, 2017).
Dans l'analyse 2026 de CB Insights portant sur 385 startups financées par du capital-risque et dont l'échec a une cause connue, 43 % citent un mauvais product-market fit et 19 % une économie unitaire non viable. Ce sont des problèmes de valeur et de viabilité, pas des problèmes de construction (CB Insights, 2026).
Cinq utilisateurs de test trouvent environ 85 % des problèmes d'utilisabilité : ces preuves-là s'obtiennent à bas prix (Nielsen Norman Group, 2000).
Une preuve de valeur est un comportement qui a un coût, généralement recueilli avant que les gens voient votre solution.
Un Risk Receipt réunit chaque hypothèse, sa preuve et un verdict honnête (« compte / faible / non vérifié / non examiné »), pour que personne ne confonde quatre jolis appels de démo avec une validation.
Quels sont les quatre risques produit ?
Cagan a exposé les quatre grands risques dans un article de SVPG en 2017, et ils sont devenus la liste de contrôle standard de la product discovery (SVPG, 2017) :
Risque
La question
Responsable dans le modèle de Cagan
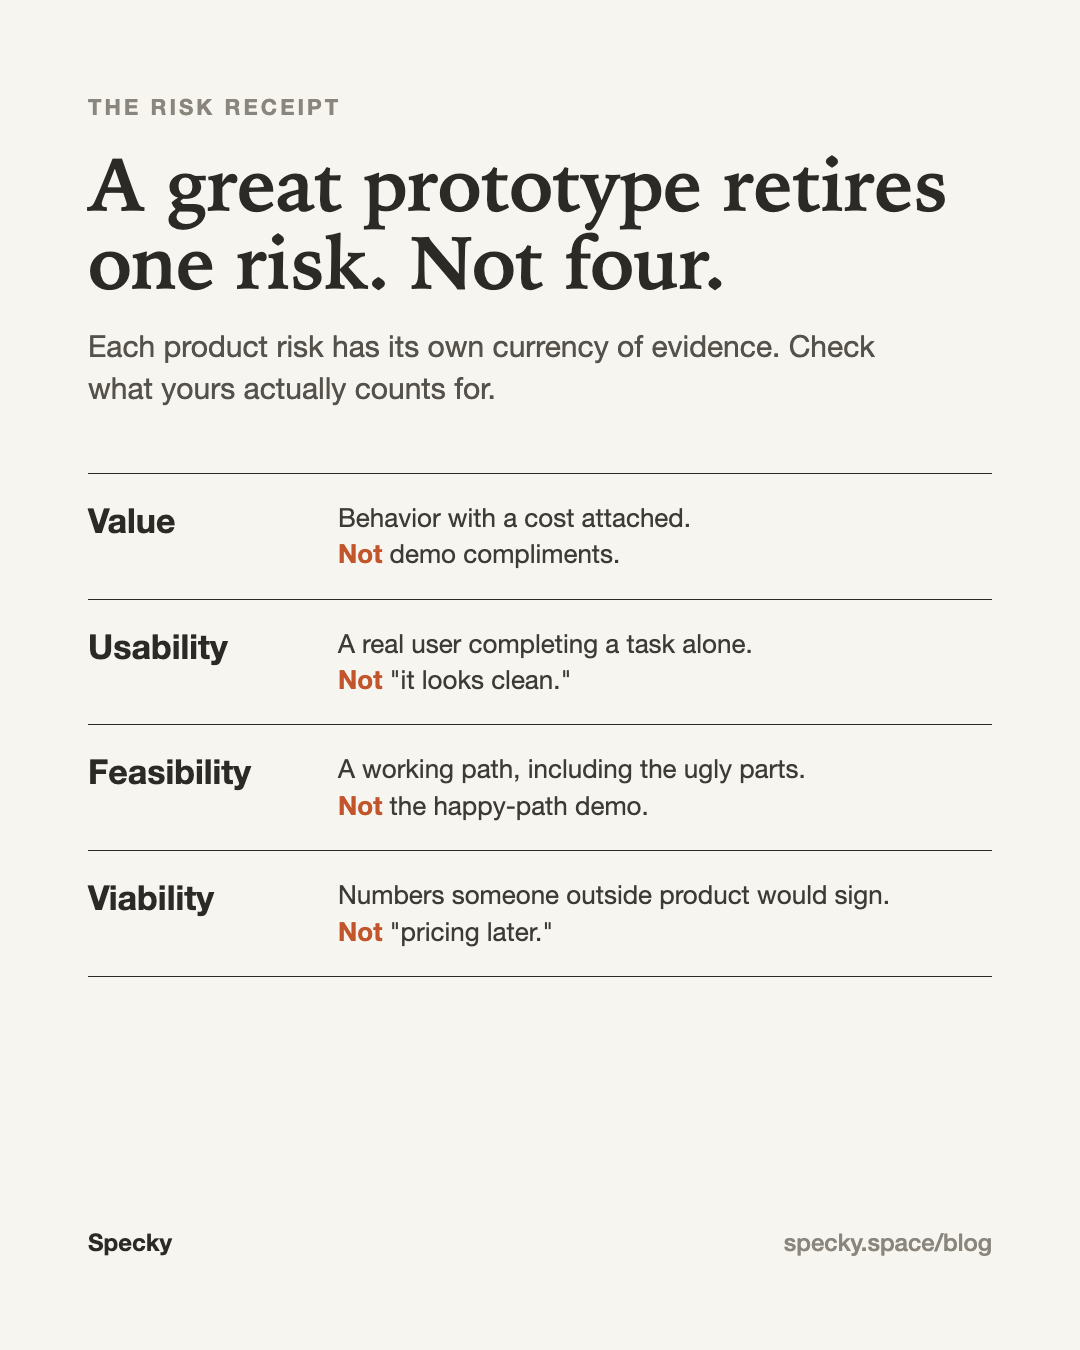
Preuve la plus solide
Preuve la plus faible
Valeur
Les clients l'achèteront-ils, ou les utilisateurs choisiront-ils de l'utiliser ?
Product manager
Un comportement qui a un coût : pilotes, précommandes, contournements qu'ils paient déjà
« Je l'utiliserais », enthousiasme pendant la démo
Utilisabilité
Les utilisateurs peuvent-ils comprendre comment s'en servir ?
Product designer
Tentatives de tâches sans aide par des utilisateurs cibles
Présentations aux parties prenantes, « ça a l'air clair »
Faisabilité
Les ingénieurs peuvent-ils le construire avec le temps, les compétences et la technologie dont nous disposons ?
Lead engineer
Une voie fonctionnelle sur des données réalistes, avec la liste de ce qui a été laissé de côté
Une démo sur le chemin idéal avec des données fictives
Viabilité
Est-ce que cela fonctionne pour le reste de l'entreprise ?
Product manager
Coût de service, tarification testée auprès d'un acheteur, feu vert des ventes, du juridique, du support
« On verra la tarification plus tard »
Selon Cagan, la viabilité consiste à savoir si la solution « fonctionne aussi pour les différents aspects de notre activité ». Cela couvre la tarification, le coût de service, les ventes, le juridique, la conformité et le support.
Les quatre risques sont indépendants. Une fonctionnalité peut être triviale à construire, parfaitement utilisable et n'avoir malgré tout aucune valeur. Elle peut aussi avoir une valeur évidente et n'être pas viable, par exemple lorsque chaque utilisation coûte plus cher en inférence que ce que paie le client.
Pourquoi l'IA a-t-elle changé les risques produit qui comptent le plus ?
Quand construire coûtait cher, la faisabilité était la porte derrière laquelle tout faisait la queue. Les équipes consacraient leur temps de discovery aux trois autres risques pendant que l'ingénierie chiffrait. Maintenant qu'un prototype fonctionnel prend un après-midi, la file d'attente a disparu, et avec elle la pause forcée pendant laquelle les autres risques étaient examinés.
Benedikt Kantus l'a dit sans détour dans un essai d'octobre 2026 : « AI has made feasibility almost trivial. It has not touched the other three. » (Leading in Product, 2026).
Les données sur les échecs disent la même chose : c'est là que les produits meurent. CB Insights a étudié 431 entreprises financées par du capital-risque qui ont fermé depuis 2023 et a pu identifier les causes pour 385 d'entre elles. « À court de capital » arrive en tête avec 70 %, mais le rapport y voit la cause finale plutôt que la cause racine. En dessous : un mauvais product-market fit à 43 %, un mauvais timing à 29 % et une économie unitaire non viable à 19 % (CB Insights, 2026). Et pour les produits qui survivent, l'analyse de Pendo de 2019 a montré que 80 % des fonctionnalités d'un produit moyen sont rarement ou jamais utilisées (Pendo, 2019). Le risque de valeur, et non le risque de construction, est celui qui coûte cher.
La faisabilité est-elle vraiment résolue ?
Pour les prototypes, en grande partie. Pour la production, moins nettement. Dans l'essai randomisé de METR, 16 développeurs open source expérimentés, travaillant sur 246 tickets réels dans leurs propres dépôts, ont mis 19 % de temps en plus avec les outils d'IA du début 2025, alors qu'ils avaient prévu un gain de 24 % et pensaient ensuite avoir été 20 % plus rapides (METR, 2025). Un suivi de février 2026 auprès de 57 développeurs n'a trouvé que de faibles indices d'accélération, avec des intervalles de confiance qui incluent zéro, et METR lui-même avertit que ces données sont une mesure peu fiable (METR, 2026). La lecture honnête : la première version est bon marché ; les cas limites, la fiabilité et la maintenance ne sont pas gratuits.
Qu'est-ce qu'un Risk Receipt ?
Le problème n'est pas que les PM aient cessé de se soucier des autres risques. C'est qu'un prototype soigné donne l'impression de constituer une preuve pour les quatre. On le montre à cinq personnes, on entend « c'est génial », et l'équipe repart persuadée que la valeur, l'utilisabilité et la viabilité sont couvertes. Chaque risque a sa propre monnaie de preuve, et la plupart des équipes paient dans la mauvaise.
Un Risk Receipt est une courte fiche que vous rattachez à tout pari produit important. Pour chacun des quatre risques produit, elle répond à trois questions :
Quelle est l'hypothèse ? Une phrase, assez précise pour pouvoir être fausse.
De quelle preuve disposons-nous, et de quelle nature ? Reliée à sa source, pas paraphrasée.
Cette preuve compte-t-elle vraiment pour ce risque ? C'est la partie que les équipes sautent.
La troisième question est le point central. Les preuves ont un taux de change. Certaines sont une monnaie forte pour un risque et ne valent presque rien pour un autre.
Quelles preuves comptent pour chaque risque ?
Valeur : payez en comportements, pas en compliments
Ce qui compte : des clients qui décrivent le problème sans y être invités, avec un exemple récent et concret. Des contournements existants (tableurs, scripts, processus manuels) qui leur coûtent un temps réel. Des engagements qui ont un coût : un créneau d'agenda, un pilote avec leurs données, une précommande, une introduction auprès de leur supérieur.
Ce qui ne compte pas : « Je l'utiliserais. » L'enthousiasme pendant une démo. Le taux de clics d'un prototype dans une session modérée. Des votes sur un tableau d'idées par des gens qui ne paieront jamais.
Le signal d'alerte : si la preuve la plus forte de la valeur est quelqu'un qui réagit à votre prototype, vous avez recueilli une preuve d'utilisabilité et l'avez étiquetée « valeur ». Les gens réagissent poliment à tout ce qui a l'air compétent. Les preuves de valeur viennent le plus souvent de l'avant, de la façon dont les gens parlent du problème avant d'avoir vu votre solution. Pour en obtenir à peu de frais, il y a par exemple un test de la fausse porte ou une page d'intérêt en prévente.
Utilisabilité : payez en tâches observées, pas en opinions
Ce qui compte : regarder un vrai utilisateur cible tenter une vraie tâche sans accompagnement, et noter où il hésite ou échoue. La réussite de la tâche dès le premier essai. Les questions qu'il pose à voix haute.
Ce qui ne compte pas : « Ça a l'air clair. » Une présentation aux parties prenantes. Votre propre équipe qui l'utilise tous les jours (elle sait déjà où tout se trouve).
Le signal d'alerte : si personne en dehors de l'équipe n'a tenté une tâche seul, l'utilisabilité n'est pas vérifiée, quelle que soit la qualité du prototype.
C'est le seul risque pour lequel le prototypage par IA aide vraiment. Un prototype cliquable, alimenté par de vraies données, vous donne de l'observation de tâches réelles des semaines plus tôt qu'une maquette statique. C'est un vrai gain, mais pour un seul risque. Notre modèle de test d'utilisabilité explique comment mener les sessions.
Faisabilité : payez en voie fonctionnelle, y compris les parties moches
Ce qui compte : un prototype qui tourne sur des volumes de données réalistes, avec de vraies permissions et une vraie latence. La liste honnête d'un ingénieur de ce que le prototype a laissé de côté : authentification, migrations, états d'erreur, l'intégration soumise à des limites de débit.
Ce qui ne compte pas : une démo sur le chemin idéal avec des données fictives.
Le signal d'alerte : demandez « qu'est-ce que ce prototype n'a pas eu à gérer ? ». Si la réponse est longue, la faisabilité est en partie levée, pas totalement.
Viabilité : payez en chiffres qu'une personne extérieure au produit signerait
Ce qui compte : une estimation du coût de service (pour les fonctionnalités d'IA, le coût par utilisation au volume attendu). Une hypothèse de prix que vous avez dite à voix haute à un acheteur. Une vérification auprès de la personne qui pilote le support, les ventes, la sécurité ou le juridique. En B2B, la question de savoir si le processus d'achat d'un client permet cela.
Ce qui ne compte pas : « On verra la tarification plus tard. » Supposer que les coûts d'usage sont négligeables parce que le prototype était peu coûteux à faire tourner pour une seule personne.
Le signal d'alerte : si personne en dehors de l'équipe produit n'a vu le pari, la viabilité n'est pas examinée.
Un exemple concret : quatre clients ravis, un reçu vide
Imaginons que vous êtes une équipe fondatrice de deux personnes qui construit un outil B2B, et qu'un appel client fait naître une idée : un assistant IA qui rédige les points d'avancement hebdomadaires à partir de l'activité des projets. Vous le prototypez en un week-end. Ça marche. Vous le montrez à quatre clients lors d'appels. Tous les quatre disent l'adorer.
Voici le Risk Receipt honnête :
Risque
Hypothèse
Preuve
Ça compte ?
Valeur
Les responsables d'équipe utiliseront des brouillons hebdomadaires plutôt que de rédiger eux-mêmes les points d'avancement
4 réactions positives en démo
Faible : des réactions à une solution, pas un comportement. Personne n'avait décrit la rédaction des points d'avancement comme une douleur avant que vous la montriez.
Utilisabilité
Les responsables peuvent relire et envoyer un brouillon en moins de 5 minutes
Rien d'observé
Non vérifié : personne ne l'a essayé seul.
Faisabilité
Les brouillons restent exacts sur de vraies données de projet
Prototype de week-end sur votre propre espace de travail
Partiel : aucun test sur l'espace de travail désordonné d'un client.
Viabilité
Le coût par brouillon reste bien en dessous de ce que rapporte l'abonnement
Non estimé
Non examiné
Quatre appels enthousiastes, et le reçu indique que vous n'avez presque rien levé comme risque. Ce n'est pas une raison d'abandonner l'idée. C'est une raison de faire trois vérifications peu coûteuses avant de construire la version de production :
Valeur : retournez voir deux de ces clients et demandez-leur comment ils rédigent ces points aujourd'hui, combien de temps cela prend, et ce qui s'est passé la dernière fois que l'un d'eux est arrivé en retard. Écoutez s'il y a un contournement.
Utilisabilité : donnez le prototype à un client sur ses propres données et regardez-le s'en servir, sans guidage, pendant un cycle.
Viabilité : multipliez le coût de votre modèle par brouillon par le volume hebdomadaire réaliste sur l'ensemble de votre base clients, et comparez avec le prix de l'abonnement.
Le calcul de viabilité (chiffres illustratifs). Supposons qu'un brouillon coûte 0,06 € d'appels au modèle sur votre propre espace de travail, mais qu'un vrai espace client ait 5 fois plus d'activité, soit 0,30 € par brouillon. Un client avec 40 responsables d'équipe génère 160 brouillons par mois, soit 48 € de coût de modèle pour un abonnement à 60 € par mois. C'est 80 % du chiffre d'affaires absorbé par une seule fonctionnalité. Mieux vaut le savoir au troisième jour qu'au troisième mois.
Chaque vérification prend des jours, pas des semaines. C'est le vrai dividende d'une faisabilité bon marché : vous pouvez vous permettre d'acheter de vraies preuves pour les trois autres risques avant de vous engager.
De combien de clients ou d'utilisateurs avez-vous besoin pour chaque risque ?
Utilisabilité : de petits nombres suffisent. L'analyse de Nielsen a montré que 5 utilisateurs révèlent environ 85 % des problèmes d'utilisabilité, et recommandait trois séries de 5 avec des corrections entre elles plutôt qu'une série de 15 (Nielsen Norman Group, 2000).
Valeur : le nombre compte moins que le coût du signal. Deux clients qui vous accordent chacun un pilote avec leurs propres données pèsent plus que vingt qui disent « ça a l'air super ». Cherchez au moins 3 engagements indépendants avant de considérer la valeur comme levée pour un segment.
Faisabilité : une exécution réaliste, relue par l'ingénieur qui en sera responsable, plus une liste écrite de ce qui a été laissé de côté.
Viabilité : un modèle de coûts aux hypothèses explicites et une conversation avec chaque fonction qui doit donner son accord (ventes, support, juridique ou sécurité).
Ce sont des points de départ pour une petite équipe, pas des références.
Pourquoi les reçus valent-ils mieux qu'une liste de contrôle de discovery ?
Vous pourriez transformer les quatre risques en liste de contrôle. Les équipes le font. Les listes de contrôle échouent de façon prévisible : quelqu'un coche « valeur validée » parce qu'une démo s'est bien passée, et la coche masque la nature de la preuve.
Un reçu garde la preuve attachée à l'hypothèse. Trois mois plus tard, quand la fonctionnalité sous-performe et que quelqu'un demande « pourquoi avons-nous construit ça ? », la réponse n'est pas un souvenir ni une diapositive. C'est un enregistrement : voici ce que nous croyions, voici ce que nous avons vu, voici les risques que nous avons sciemment laissés ouverts. Pour la structure qui garde ces enregistrements reliés dans le temps, consultez notre graphe de décisions pour les petites équipes IA. Si votre équipe livre sans aucun reçu, confrontez-la aux 10 signes d'alerte d'une feature factory.
Ce dernier point compte. Livrer avec un risque ouvert est souvent le bon choix, car les petites équipes ne peuvent pas tout lever. L'erreur est de livrer avec un risque ouvert que l'on croyait fermé.
Erreurs fréquentes
Compter les réactions en démo comme de la valeur. L'erreur la plus fréquente. Les réactions sont au mieux une preuve d'utilisabilité.
Tester l'utilisabilité avec des proches de l'équipe. Les collègues et les clients bienveillants connaissent déjà la logique du produit.
Traiter un prototype comme la preuve de la faisabilité en production. Demandez à chaque fois la liste de ce qui a été laissé de côté.
Renvoyer la viabilité à « plus tard ». Pour les fonctionnalités d'IA surtout, le coût par utilisation peut transformer une fonctionnalité appréciée en gouffre financier.
Vouloir lever tous les risques. Choisissez le ou les deux risques qui tueraient le pari et achetez d'abord des preuves pour ceux-là. Notre guide de cartographie des hypothèses aide à les classer.
Comment nous appliquons les Risk Receipts dans Specky
Les signaux clients (notes d'entretien, fils de support, transcriptions d'appels, événements analytics) arrivent dans le Product Graph sous forme de nœuds typés, chacun gardant sa source. Un insight ou une décision rédigés citent les nœuds précis sur lesquels ils reposent, si bien que « quatre clients ont adoré » ne peut pas se transformer discrètement en « les clients en ont besoin ». Pour la vérification de la valeur, Alex, l'agent de recherche IA de Specky, peut mener de courts entretiens sur le processus actuel des clients avant qu'ils voient votre solution, et les transcriptions reviennent comme preuves. Pour la demande naissante, une page de validation mesure si les gens accomplissent une action qui a un coût. Le jugement sur les risques à laisser ouverts reste le vôtre.
Commencez par un reçu cette semaine
Vous n'avez pas besoin d'un outil pour démarrer. Choisissez le pari qui enthousiasme le plus votre équipe en ce moment, celui qui a le meilleur prototype. Écrivez quatre lignes :
Si le pari le plus enthousiasmant a le reçu le plus vide, vous avez trouvé où devrait aller votre prochaine semaine de discovery. Vous pouvez aussi esquisser visuellement les hypothèses avec l'outil gratuit de carte des hypothèses.
La faisabilité était la question coûteuse. Elle est devenue la question peu coûteuse. Les équipes qui gagneront ce cycle ne seront pas celles qui construisent le plus vite. Ce seront celles qui sauront montrer ce qu'elles savaient au moment de décider.
Questions fréquentes
Quels sont les quatre grands risques de Marty Cagan ?
Ce sont le risque de valeur (les clients l'achèteront-ils ou choisiront-ils de l'utiliser), le risque d'utilisabilité (les utilisateurs peuvent-ils comprendre comment s'en servir), le risque de faisabilité (les ingénieurs peuvent-ils le construire avec le temps, les compétences et la technologie disponibles) et le risque de viabilité commerciale (est-ce que cela fonctionne pour le reste de l'entreprise). Cagan les a publiés sur SVPG en 2017 et confie la valeur et la viabilité au product manager.
Lequel des quatre risques produit est le plus souvent sous-estimé ?
Le risque de valeur. Un prototype fonctionnel et des réactions polies créent un fort sentiment de validation qui n'est pas appuyé par des comportements. L'étude 2026 de CB Insights a montré que 43 % des startups en échec dont la cause est connue citaient un mauvais product-market fit. La viabilité arrive de près en deuxième position pour les fonctionnalités d'IA, où le coût par utilisation peut dépasser le prix.
Un prototype teste-t-il le risque de valeur ?
Rarement à lui seul. Montrer un prototype teste surtout l'utilisabilité et un peu la faisabilité. Les preuves de valeur viennent de comportements qui ont un coût : des personnes qui décrivent le problème sans y être invitées, des contournements existants, des pilotes, des précommandes ou des introductions. Vous pouvez utiliser un prototype dans un test de valeur, par exemple en demandant un pilote payant, mais la réaction seule ne compte pas.
Comment tester le risque de viabilité commerciale ?
Notez les chiffres qu'une personne extérieure au produit devrait valider : coût de service par client, prix attendu, charge de support, et toute contrainte juridique, de sécurité ou d'achat. Montrez-les ensuite à ces personnes. Pour les fonctionnalités d'IA, multipliez le coût par utilisation par un volume réaliste et comparez avec le prix de l'abonnement avant de vous engager à construire.
L'IA a-t-elle fait disparaître le risque de faisabilité ?
Non, elle a rendu la première version bon marché. Les prototypes prennent désormais quelques heures, mais le travail de production sur des bases de code matures est une autre affaire : l'essai de METR de 2025 a constaté que des développeurs expérimentés mettaient 19 % de temps en plus avec des outils d'IA sur leurs propres dépôts, et son suivi de 2026 n'a trouvé que de faibles indices d'accélération. Continuez à demander ce qu'un prototype n'a pas eu à gérer.
GDPR-aligned. EU workspace data is stored in Frankfurt, Germany. GDPR and EU data Built in Vienna, Austria. A product of influence solutions fm GmbH (FN 675374y). Imprint 14-day trial. Card required, and nothing is charged until day 14. 30-day refund after subscribing. See pricing