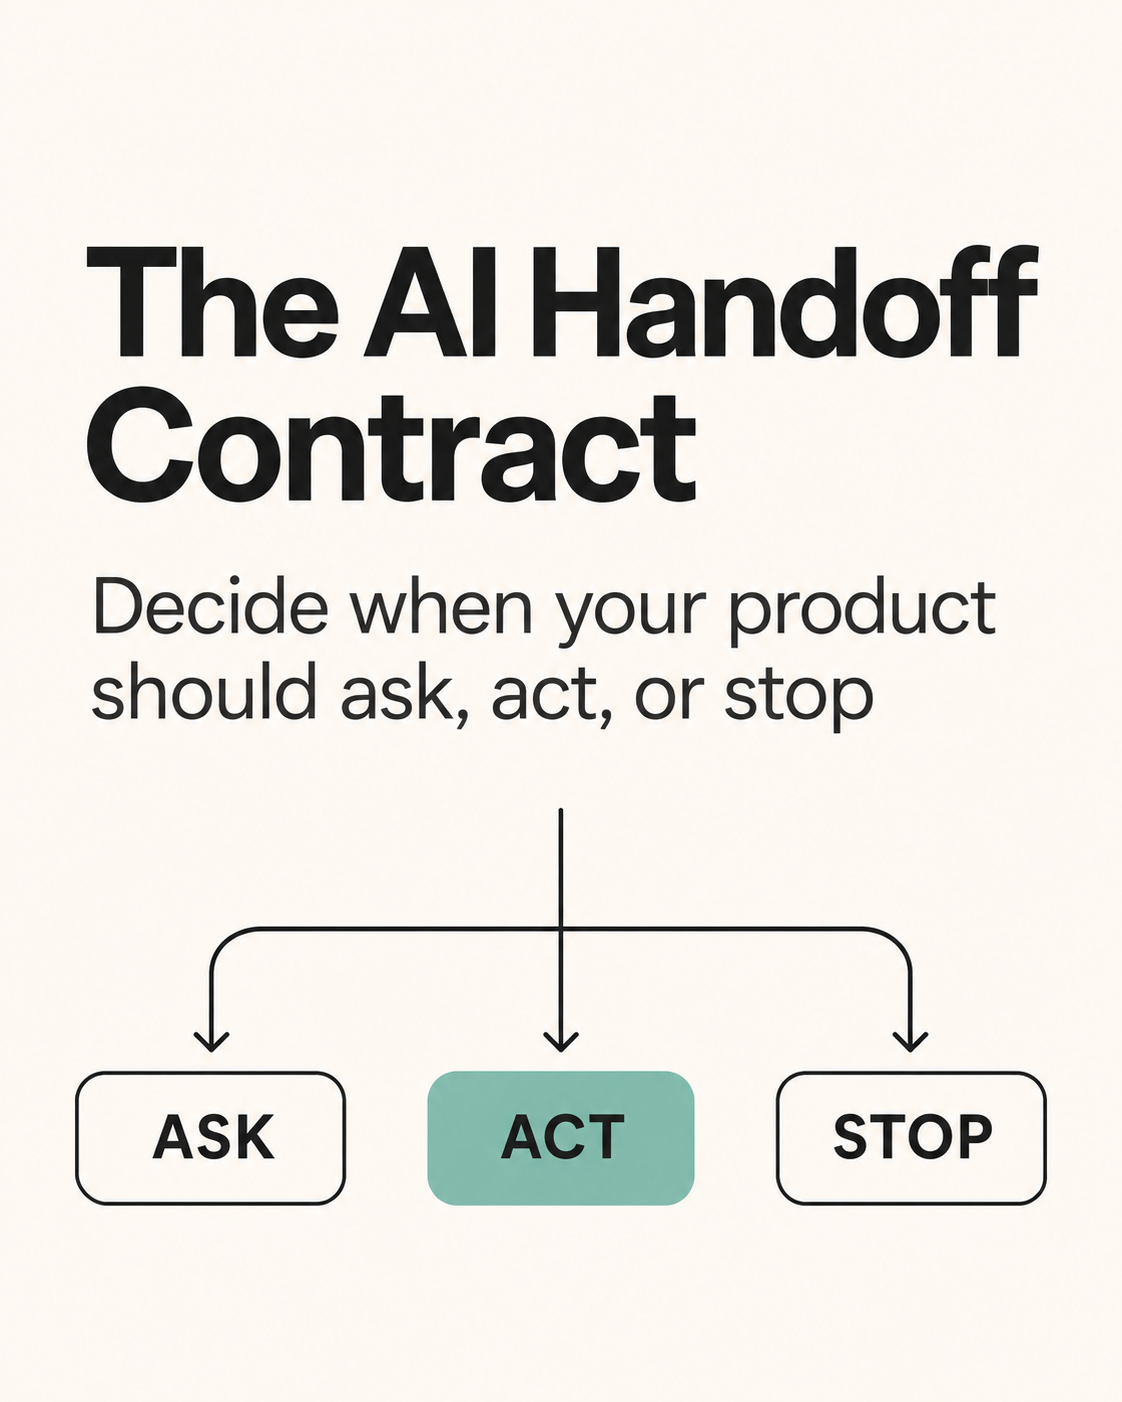
Handoff degli agenti AI: quando il tuo prodotto deve chiedere, agire o fermarsi
Decidi quando un agente AI deve chiedere, agire entro limiti chiari o fermarsi e passare il controllo a una persona, grazie a dati reali sulla condivisione del controllo e a un modello di contratto pronto all'uso.
L'handoff di un agente AI è il momento in cui una funzionalità basata su intelligenza artificiale restituisce il controllo a una persona: per richiedere informazioni mancanti, per ottenere l'approvazione prima di un'azione rilevante o per fermarsi e lasciare che qualcuno subentri. Un contratto di handoff (o handoff contract) stabilisce, prima del lancio, quando il prodotto deve chiedere, quando può agire autonomamente e quando deve fermarsi, oltre a definire ciò che l'utente visualizza in ciascun caso.
Punti chiave
Gli agenti si fermano già da soli più spesso di quanto non siano le persone a interromperli. Nello studio di Anthropic su circa 500.000 sessioni di Claude Code, l'agente ha chiesto chiarimenti più del doppio delle volte sui task più complessi rispetto a quelli semplici, e più spesso di quanto gli esseri umani lo abbiano interrotto (Anthropic, 2026).
Il motivo principale per cui l'agente si è fermato è stato presentare una scelta tra approcci diversi (35%). Il motivo principale per cui gli utenti lo hanno interrotto è stato fornire contesto mancante o correzioni (32%). Entrambi sono problemi di contesto di prodotto, non limiti del modello.
La guida agli agenti di OpenAI individua due trigger per l'intervento umano: il superamento delle soglie di fallimento e le azioni ad alto rischio che risultano delicate, irreversibili o ad alta posta in gioco (OpenAI).
La confidenza del modello non equivale a un'autorizzazione. Essere «sicuro al 90%» non autorizza a inviare un'email o a modificare l'anagrafica di un cliente.
Un revisore umano non è una rete di sicurezza per definizione. In un'analisi aggregata, indicazioni errate da parte di sistemi di supporto decisionale hanno aumentato il rischio di una decisione umana scorretta del 26% (Goddard et al., 2012).
Cos'è l'handoff di un agente AI?
Il termine ha due significati ed è utile distinguerli chiaramente.
Handoff tra agenti (agent-to-agent). Nell'Agents SDK di OpenAI, gli handoff consentono a un agente di delegare un task a un altro, come un agente di triage che passa una richiesta di rimborso a un agente dedicato ai rimborsi. Il modello interpreta ogni handoff come un tool, ad esempio transfer_to_refund_agent (). La guida di OpenAI lo descrive come un trasferimento unidirezionale che porta con sé lo stato della conversazione.
Handoff da agente a persona (agent-to-human). L'agente trasferisce il controllo a una persona perché non può o non deve continuare. La guida di OpenAI offre due esempi: nell'assistenza clienti, l'escalation a un operatore umano; per un agente di coding, la restituzione del controllo all'utente.
Questo articolo si concentra sul secondo tipo, che rappresenta una decisione di prodotto e non un dettaglio di orchestrazione. Un agente di prodotto può raccomandare il passaggio successivo, prepararlo o eseguirlo direttamente. Sono tre comportamenti distinti, anche quando sullo schermo appare un rassicurante pulsante «Continua». La domanda a cui risponde un contratto di handoff è: cosa può decidere questo prodotto per conto dell'utente, con quali informazioni, e cosa succede quando la risposta è incerta?
Agli utenti questo equilibrio interessa molto. Nella survey del 2025 di Stack Overflow, l'86,9% degli sviluppatori si è detto preoccupato per l'accuratezza delle informazioni fornite dagli agenti AI, e l'81,4% ha espresso timori su sicurezza e privacy dei propri dati durante il loro utilizzo (Stack Overflow, 2025). Una chiara politica di handoff affronta entrambi i problemi: l'agente agisce meno in presenza di prove deboli e tocca meno elementi senza autorizzazione.
Questo è lavoro di prodotto. Il PM porta il giudizio di dominio: cosa definisce un'azione ragionevole, quali compromessi sono accettabili e quali errori impongono che l'utente riprenda il controllo. I team di ingegneria trasformano queste regole in comportamenti a regime rendendoli affidabili. Il PM non si sostituisce alla proprietà del codice.
Perché «human in the loop» è un concetto troppo vago per un agente AI?
Un brief che si limita a prescrivere di «mantenere un essere umano nel loop» lascia aperte le questioni più complesse:
Quale persona esamina l'output, e dispone del contesto necessario per giudicare?
Sta valutando un suggerimento, una bozza o un'azione già eseguita?
Può modificare l'azione o soltanto approvarla?
Cosa succede se nessuno risponde?
Quali errori non devono mai essere delegati?
I framework chiedono ai team di chiarire questi aspetti, ma non forniscono le risposte prefissate. Il NIST AI Risk Management Framework 1.0 invita le organizzazioni a definire i ruoli per le configurazioni uomo-AI (GOVERN 3.2), a documentare i processi per la supervisione umana (MAP 3.5) e ad avere meccanismi per scavalcare, disimpegnare o disattivare un sistema di intelligenza artificiale che operi al di fuori dell'uso previsto (MANAGE 2.4) (NIST).
L'EU AI Act impone requisiti ancora più stringenti per i sistemi ad alto rischio. L'articolo 14 richiede che chi li supervisiona sia in grado di prevenire o ridurre il bias da automazione, di ignorare, annullare o invertire l'output e di interrompere il sistema tramite un pulsante di «stop» o una procedura analoga (EUR-Lex). A seguito del Digital Omnibus, tali obblighi si applicheranno ai sistemi ad alto rischio dell'Allegato III a partire dal 2 dicembre 2027 (EUR-Lex, Regulation 2026/1744). La maggior parte degli agenti di prodotto non rientra tra i sistemi ad alto rischio, ma prevedere chiedere, sovrascrivere e fermare rappresenta un ottimo standard minimo per chiunque.
Anche la revisione stessa richiede progettazione. Goddard e colleghi hanno analizzato 74 studi sul bias da automazione, scoprendo che, quando un sistema di supporto alle decisioni sbagliava, aumentava il rischio di una decisione umana errata del 26%. Un revisore che vede una raccomandazione formulata con sicurezza e un pulsante «Approva» non rappresenta un controllo indipendente, a meno che il prodotto non mostri le evidenze e renda semplice dissentire.
Quando un agente AI dovrebbe chiedere, agire o fermarsi?
Utilizza tre percorsi e selezionali in base alle conseguenze e all'autorità, non in base al punteggio di confidenza del modello.
Chiedere (Ask) quando al sistema mancano informazioni o l'autorizzazione necessaria che potrebbero modificare la decisione. Poni una domanda concreta, spiega perché la risposta è importante e lascia che l'utente scelga. Se il dettaglio mancante è facoltativo, proponi un'impostazione predefinita visibile.
Agire (Act) quando il task è ben specificato, l'azione rientra in ciò che l'utente ha richiesto e le conseguenze sono accettabili anche in caso di errore. Rendi l'azione visibile e facile da ispezionare o annullare.
Fermarsi (Stop) quando il sistema non può procedere responsabilmente: la richiesta è fuori dall'ambito consentito dal prodotto, le prove sono insufficienti rispetto all'impatto dell'azione, una fonte indispensabile non è disponibile, è stata raggiunta una soglia di fallimento oppure il passaggio successivo varcherebbe un limite non autorizzato dall'utente. Spiega il motivo e offri un'alternativa, come modificare la richiesta o affidarla a una persona.
Percorso
Quando usarlo
Cosa vede l'utente
Esempio
Chiedere
Informazioni mancanti o contrastanti cambierebbero l'esito
Una domanda, perché è importante, 2-4 opzioni
«Preferisci dare priorità al profilo dell'account o al recente segnale d'acquisto?»
Agire
La richiesta è chiara, l'azione è in scope e reversibile
Il risultato, cosa è cambiato, un comando di annullamento
Bozza di risposta salvata tra le bozze dell'utente
Agire dopo conferma
L'azione è in scope ma ha conseguenze rilevanti
Un'anteprima e una conferma esplicita
Invia la risposta al cliente
Fermarsi
Fuori scope, prove insufficienti, limite di errori raggiunto o non autorizzato
Il motivo e il passaggio successivo o un contatto umano
«Non posso modificare i dati di fatturazione. Ecco a chi puoi rivolgerti.»
La confidenza non equivale all'autorizzazione. Il fatto che un modello affermi di essere sicuro al 90% non gli conferisce il diritto di inviare un'email, aggiornare un record cliente o confermare una decisione di prodotto. Il percorso dipende dal task, dalle prove disponibili, dall'autorizzazione dell'utente e dal costo di un eventuale errore. Per le decisioni che restituiscono una risposta fissa, come classificare, instradare o assegnare uno score, il framework per le decisioni AI illustra come definire le soglie in base al costo degli errori. Per valutare la reversibilità di un'azione, consulta il framework sulle decisioni di prodotto reversibili e irreversibili (one-way vs two-way door).
Come si dividono il controllo le persone e gli agenti AI oggi?
Lo studio di Anthropic del febbraio 2026 offre i dati pubblici più completi a oggi disponibili. Ha analizzato circa 500.000 sessioni interattive di Claude Code e 998.481 chiamate a tool tramite la sua API pubblica (Anthropic, 2026).
Perché l'agente si è fermato spontaneamente:
Motivo per cui Claude Code si è messo in pausa
Quota
Per presentare una scelta tra approcci diversi
35%
Per raccogliere informazioni diagnostiche o risultati di test
21%
Per chiarire una richiesta vaga
13%
Per richiedere credenziali o permessi di accesso
12%
Per chiedere l'approvazione prima di agire
11%
Perché le persone lo hanno interrotto: per fornire contesto mancante o correzioni (32%), perché l'agente era lento, bloccato o stava eseguendo troppe operazioni (17%), e per gestire direttamente il passaggio successivo (7%).
Come cambia la fiducia con l'esperienza: i nuovi utenti (con meno di 50 sessioni) hanno utilizzato l'auto-approvazione completa in circa il 20% delle sessioni, quota che è salita a oltre il 40% dopo 750 sessioni. Gli utenti esperti, tuttavia, hanno anche interrotto più spesso l'agente: in circa il 9% dei turni, contro il 5% circa degli utenti con una decina di sessioni alle spalle. Anthropic interpreta questo comportamento come monitoraggio attivo piuttosto che come abbandono della supervisione.
Il profilo di rischio registrato sull'API: l'80% delle chiamate ai tool proveniva da agenti dotati di almeno una misura di sicurezza, come permessi limitati o requisiti di approvazione; fino al 73% prevedeva verosimilmente un essere umano nel loop (gli autori lo definiscono un limite massimo); e solo lo 0,8% delle azioni appariva irreversibile.
Da questi dati emergono tre lezioni per i team di prodotto:
Progetta la richiesta («ask») per presentare opzioni, non solo per colmare lacune. Il motivo principale per cui un agente si è fermato è stato proporre una scelta tra soluzioni alternative. Trasforma questo momento in una schermata di primo livello con opzioni ben definite.
La maggior parte delle interruzioni è dovuta a contesti carenti. Un terzo delle interruzioni umane è servito a fornire indicazioni o correzioni di cui l'agente era sprovvisto. Fornire un contesto di prodotto migliore all'inizio riduce sia le richieste di chiarimento sia le interruzioni. Il template PRD per agenti AI di coding mostra come impostarlo efficacemente.
Progetta per l'intervento, non per l'approvazione a ogni singolo passaggio. Anthropic raccomanda di offrire agli utenti visibilità e modalità semplici per reindirizzare l'agente, anziché imporre un via libera su ogni azione. Anche gli utenti che si fidano maggiormente dell'agente desiderano uno strumento rapido per intervenire.
Come implementano chiedere, agire e fermarsi i prodotti reali?
Le modalità di autorizzazione di Claude Code costituiscono un ottimo esempio in produzione, poiché ciascuna modalità codifica una diversa politica di handoff (documentazione di Claude Code):
Modalità di Claude Code
Cosa fa senza chiedere
Percorso di handoff che implementa
Manuale (default)
Solo lettura; chiede conferma prima di modifiche, comandi shell e accessi di rete
Chiede prima di ogni scrittura
acceptEdits
Lettura, modifiche ai file e comandi comuni all'interno della working directory
Agisce su modifiche a basso rischio e reversibili; chiede per il resto
plan
Legge ed esplora; modifiche bloccate finché non approvi un piano
Chiede una volta sola, in anticipo, presentando un piano
auto
Esegue tutto, con un classificatore che esamina ciascuna azione
Agisce, con un modello di controllo che può fermare l'esecuzione
dontAsk
Solo i tool pre-approvati; qualsiasi altra operazione viene rifiutata
Agisce entro un perimetro prefissato; si ferma al di fuori
Ci sono due dettagli che vale la pena replicare. Il primo: la modalità automatica blocca per impostazione predefinita una serie di azioni ad alto impatto, tra cui deploy e migrazioni in produzione, comandi di force push, cancellazioni massive su cloud storage e il merge di pull request non approvate da una persona. Questa è una vera e propria stop list. Il secondo: se il classificatore blocca un'azione per 3 volte consecutive o 20 volte in totale, la modalità automatica si sospende e Claude Code torna a chiedere istruzioni. Questa è una soglia di fallimento, esattamente il primo trigger descritto nella guida di OpenAI. Le regole di diniego (deny) valgono in ogni modalità, costituendo il limite invalicabile.
La guida di OpenAI aggiunge un criterio per decidere quale percorso assegnare a ciascuna azione: attribuisci a ogni tool un livello di rischio basso, medio o alto basandoti sulla distinzione tra sola lettura e scrittura, sulla reversibilità, sui permessi richiesti e sull'impatto economico; poi metti in pausa per effettuare controlli o passa la palla a una persona prima delle chiamate ad alto rischio. Tra gli esempi di azioni che dovrebbero attivare la supervisione umana figurano la cancellazione di ordini, l'autorizzazione di rimborsi consistenti e l'esecuzione di pagamenti.
Le linee guida di Anthropic sullo sviluppo di agenti sottolineano lo stesso concetto dal punto di vista ingegneristico: gli agenti possono mettersi in pausa per attendere il feedback umano a determinati checkpoint o quando incontrano ostacoli, devono ottenere elementi certi dall'ambiente a ogni passaggio e necessitano di condizioni di arresto, come un numero massimo di iterazioni (Anthropic, 2024).
Come si scrive un contratto di handoff per un agente AI?
Per ciascun workflow supportato dall'intelligenza artificiale, definisci un perimetro d'azione (action envelope) in linguaggio semplice, abbastanza conciso da poter essere revisionato da prodotto, design, engineering e supporto.
Campo del contratto
Domanda a cui rispondere
Utente e job
Chi sta cercando di completare quale attività?
Azioni consentite
Cosa può preparare o compiere il prodotto, e con quale livello di rischio?
Contesto necessario
Quali dati, autorizzazioni o fonti devono essere necessariamente presenti?
Condizione per chiedere
Quale dettaglio mancante o contrastante impone di rivolgersi all'utente?
Condizione per fermarsi
Cosa rende inaccettabile proseguire?
Soglia di fallimento
Dopo quanti tentativi falliti scatta l'handoff?
Conferma
Quali azioni richiedono una revisione o un'approvazione esplicita?
Recupero
In che modo l'utente può correggere, annullare o riassegnare il risultato?
Criterio di revisione
Quale segnale o data impone di ridiscutere il contratto?
Il perimetro descrive il comportamento, non l'implementazione. Non vincola a uno specifico modello, prompt, API o architettura; questi aspetti appartengono al piano di engineering, una volta concordato cosa il prodotto deve fare.
Puoi inserire questo schema all'interno di un brief di prodotto:
## Contratto di handoff: [workflow]
Per l'utente [utente] che cerca di [job], il prodotto può [azione consentita]
quando è presente [contesto necessario].

Chiedere quando: [le informazioni che cambiano la decisione sono mancanti o contrastanti]
Fermarsi quando: [limite raggiunto, prove insufficienti, fonte non disponibile o passaggio non autorizzato]
Soglia di fallimento: passare il controllo dopo [n] tentativi falliti in [passaggio]
Conferma richiesta prima di: [azione rilevante] (rischio: basso / medio / alto)
Recupero: l'utente può [annullare / modificare / riassegnare] tramite [meccanismo]
Owner: [PM] per la policy, [engineer] per l'implementazione
Revisione al verificarsi di: [segnale, incidente o data]
Esamina quindi scenari reali insieme a PM, ingegneri, designer e chi lavora a stretto contatto con gli utenti. Perfeziona il contratto finché ogni caso d'uso non prevede un percorso chiaro e comprensibile per l'utente.
Mantieni un registro delle decisioni
Quando il team approva un contratto, registra ciò che è consentito, quali utenti o contesti riguarda, le evidenze alla base della scelta, chi ne è responsabile, quali casi di test ne verificano il funzionamento e cosa attiverebbe una revisione. Se in futuro il prodotto dovesse fare troppe domande, agire su dati deboli o bloccarsi senza offrire alternative utili, il team potrà ricondurre il comportamento alle regole stabilite. Un log delle decisioni di prodotto è più che sufficiente. Questo approccio evita anche sovrapposizioni di responsabilità: i PM definiscono il comportamento atteso e i compromessi; gli ingegneri sono responsabili di implementazione, permessi, affidabilità e sicurezza operativa.
Esempio pratico: prioritizzazione dei prospect di vendita
Questo è un esempio illustrativo. Immagina una funzionalità AI che aiuti un team sales a qualificare i lead. Una grande azienda con un solido round di finanziamento può sembrare un ottimo prospect. Una realtà più piccola che ha mostrato un segnale d'acquisto la settimana scorsa potrebbe essere più reattiva nell'immediato. Entrambi i dati sono validi; il prodotto ha comunque bisogno di una policy per stabilire quale elemento abbia la precedenza.
Il contratto potrebbe stabilire:
Azione consentita: suggerire un livello di priorità (rischio: basso, trattandosi di un suggerimento) e illustrare le evidenze a supporto.
Contesto necessario: i criteri di adeguatezza dell'account (account-fit) definiti dal team, uniti a data e fonte di ciascun segnale d'acquisto.
Chiedere: domandare la regola di prioritizzazione se la definizione di «miglior prospect» non è ancora stata specificata.
Fermarsi: non dedurre un segnale d'acquisto solo dalle dimensioni dell'azienda e non dichiarare che un account è pronto all'acquisto senza una fonte verificata.
Soglia di fallimento: se l'arricchimento dei dati fallisce due volte per lo stesso account, contrassegnalo con «richiede revisione manuale» anziché procedere per tentativi.
Conferma: una persona del team commerciale controlla il livello prima che questo modifichi la pipeline condivisa (rischio: medio, poiché influenza il lavoro altrui).
Recupero: il revisore può modificare la priorità assegnata annotandone il motivo.
Il contratto porta alla luce una decisione che il modello non può prendere da solo: questo team deve privilegiare il fit, la tempestività o un equilibrio esplicito tra i due? Il PM mette a disposizione la propria competenza di dominio, o interpella chi la possiede, rendendo il trade-off trasparente e valutabile. Il modello applica la regola stabilita; non deve inventarne una.
Come si testa un contratto di handoff prima del lancio?
Costruisci un set ristretto di scenari rappresentativi e verifica se il prodotto sceglie il percorso corretto e lo motiva chiaramente. Includi casi in cui:
La richiesta è completa e l'azione è reversibile (esito atteso: agire).
Un dato fondamentale è assente e risposte diverse cambierebbero l'esito (esito atteso: chiedere).
Due fonti sono in disaccordo (esito atteso: chiedere, mostrando entrambe le versioni).
L'utente richiede un'operazione che esula dai permessi concordati (esito atteso: fermarsi).
Le prove raccolte sono troppo deboli rispetto alla rilevanza dell'azione (esito atteso: fermarsi o chiedere).
Una dipendenza esterna fallisce o una fonte è irraggiungibile (esito atteso: riprovare fino alla soglia limite, poi passare il controllo).
Per ogni scenario, documenta il percorso previsto, la motivazione e ciò che l'utente dovrebbe visualizzare: «Chiedere perché manca la data del segnale d'acquisto; mostrare la fonte dell'account e consentire al commerciale di aggiungerla o ignorarla». Questo è misurabile. Dire semplicemente «fare attenzione» non lo è.
Analizza gli output reali insieme a chi conosce a fondo il dominio applicativo. Se i revisori sono in disaccordo, non limitarti a fare una media dei loro voti per chiudere la questione; individua la scelta di fondo non esplicitata. Un revisore potrebbe privilegiare il profilo dell'azienda e un altro l'urgenza temporale. Risolvi il dilemma, formalizzalo nel contratto e aggiungi un test che renda verificabile la distinzione. Il ciclo è continuo: osserva un caso, identifica la scelta discrezionale, definisci la policy, aggiorna i casi di test, valuta nuovamente il comportamento. Il framework di valutazione dell'AI per team di prodotto illustra come trasformare questi casi in un eval set completo.
Questi scenari non sostituiscono il monitoraggio in produzione né i controlli architetturali di ingegneria. Servono a garantire che tutto il team condivida cosa il prodotto debba fare.
Come rendere la richiesta («ask») uno stato utile nel prodotto?
Chiedere non significa automaticamente garantire sicurezza. Un numero eccessivo di interruzioni scarica il lavoro sull'utente e dà la sensazione che la funzionalità sia incompleta. Una domanda deve comparire solo se la risposta può effettivamente modificare il risultato finale. Le 18 linee guida sull'interazione persona-AI di Microsoft, che sintetizzano oltre vent'anni di ricerca, trattano la gestione degli errori del sistema come una vera e propria fase di progettazione a sé stante, distinta dall'interazione ordinaria (Microsoft Research, 2019).
Una schermata di handoff efficace mostra:
cosa il sistema ha elaborato fino a quel momento
le informazioni mancanti o contrastanti
perché tali informazioni modificano l'azione successiva
da due a quattro scelte chiare, compresa l'opzione «decidi dopo», ove non comporti rischi
Se l'utente può correggere facilmente il risultato dopo aver visto un'anteprima, un passaggio di conferma può essere preferibile a una domanda preventiva. Se il prodotto è in grado di eseguire un'azione reversibile fornendo un chiaro comando di annullamento (undo), potrebbe non essere affatto necessario interrompere il flusso.
Errori comuni nell'handoff degli agenti AI
Confondere la confidenza con l'autorizzazione. Un valore di probabilità indica quanto il modello sia sicuro del calcolo, non se l'utente abbia dato il permesso di compiere l'azione.
Chiedere conferma per ogni cosa. Continue richieste di approvazione abituano le persone a cliccare su «Approva» senza leggere, alimentando il bias da automazione già a livello di design.
Fermarsi senza indicare i passaggi successivi. Rispondere «Non posso aiutarti con questa richiesta» senza spiegarne il motivo o senza indirizzare verso una persona crea un vicolo cieco.
Omettere una soglia di fallimento. Senza un limite di tentativi, un agente rischia di ripetersi all'infinito su un passaggio che fallisce. Stabilisci un numero massimo e cedi il controllo non appena viene raggiunto.
Applicare un unico contratto a qualsiasi azione. Le consultazioni in sola lettura e l'elaborazione di pagamenti richiedono percorsi diversi. Valuta il livello di rischio per ogni singola azione.
Regole implicite non dichiarate. Se i revisori dissentono sulla risposta corretta, la lacuna è nel contratto, non nel modello.
Dimenticare un criterio di revisione. Agenti e abitudini degli utenti evolvono nel tempo. Stabilisci fin da subito l'evento scatenante o la data in cui il contratto verrà ridiscusso.
Come si inserisce Specky
L'MCP server di Specky applica questo approccio per gli agenti che operano in un workspace di prodotto: gli agenti generano PRD, insight, decisioni e ticket in stato di bozza o proposta; la PM Inbox funge da coda di revisione e la pubblicazione automatica avviene solo se l'utente la richiede esplicitamente nello stesso turno. Puoi documentare ogni contratto di handoff nel Decision Log, accanto alle evidenze che lo hanno determinato. Per approfondire il flusso di lavoro complessivo, consulta la pagina dedicata a Specky per PM tecnici.
Domande frequenti
Cos'è l'handoff di un agente AI?
L'handoff di un agente AI è il momento in cui una funzionalità basata su intelligenza artificiale trasferisce il controllo, a un altro agente o a un essere umano. Nel product design ci si riferisce solitamente al passaggio da agente a persona: l'agente chiede informazioni mancanti, richiede l'approvazione prima di un'azione rilevante oppure si ferma per lasciare spazio all'utente. Un contratto di handoff stabilisce queste condizioni prima del rilascio.
Quando un agente AI dovrebbe richiedere una conferma?
Prima di azioni che comportano conseguenze rilevanti pur rientrando nell'ambito previsto: l'invio di messaggi ai clienti, la modifica di record condivisi, transazioni economiche o qualsiasi operazione difficile da annullare. Assegna a ogni azione un rischio basso, medio o alto basandoti su scrittura dei dati, reversibilità, permessi e impatto economico, e richiedi una conferma esplicita per i livelli medio e alto. Le azioni a basso rischio e facilmente reversibili possono invece essere eseguite direttamente, offrendo un'opzione di annullamento visibile.
Qual è la differenza tra handoff agent-to-agent e agent-to-human?
L'handoff tra agenti (agent-to-agent) è una delega interna all'architettura: nell'Agents SDK di OpenAI, un agente di smistamento passa una richiesta di rimborso all'agente competente tramite una chiamata a un tool. L'handoff da agente a persona (agent-to-human) restituisce invece il controllo a un essere umano poiché l'agente non può o non deve continuare. Il primo è un dettaglio di orchestrazione tecnica; il secondo è una scelta di prodotto incentrata su permessi e gestione del rischio.
La presenza di «human in the loop» garantisce di per sé la sicurezza di un agente AI?
No. Un revisore apporta valore solo se dispone delle informazioni necessarie, del tempo sufficiente e di un modo semplice per esprimere disaccordo. Un'analisi su 74 studi ha rilevato che indicazioni scorrette fornite da sistemi di supporto decisionale hanno accresciuto il rischio di un errore umano del 26%. Specifica chiaramente chi esamina cosa, quali dati visualizza, quali modifiche può apportare e come procedere se nessuno risponde.
Con quale frequenza un agente AI dovrebbe interrompere l'utente?
Soltanto quando la risposta può modificare l'esito finale o se l'azione richiede un'autorizzazione che l'agente non possiede. Nei dati rilevati da Anthropic nel 2026, Claude Code ha domandato chiarimenti con maggiore frequenza sulle attività complesse rispetto a quelle semplici, e gli utenti esperti sono intervenuti per interromperlo in circa il 9% dei turni. Monitora il tasso di interruzione del tuo prodotto e la percentuale di richieste a cui gli utenti rispondono in modo utile.
L'EU AI Act impone l'handoff umano per gli agenti AI?
Per i sistemi ad alto rischio, l'articolo 14 impone che le persone incaricate della supervisione siano in grado di comprenderne i limiti, evitare il bias da automazione, ignorare o modificare gli output e arrestare il sistema. In seguito al Digital Omnibus, tali obblighi saranno applicabili ai sistemi ad alto rischio dell'Allegato III a partire dal 2 dicembre 2027. Anche se la maggior parte degli agenti di prodotto non rientra in questa categoria, implementare il pattern chiedere, sovrascrivere e fermarsi rappresenta comunque una best practice.
GDPR-aligned. EU workspace data is stored in Frankfurt, Germany. GDPR and EU data Built in Vienna, Austria. A product of influence solutions fm GmbH (FN 675374y). Imprint 14-day trial. Card required, and nothing is charged until day 14. 30-day refund after subscribing. See pricing