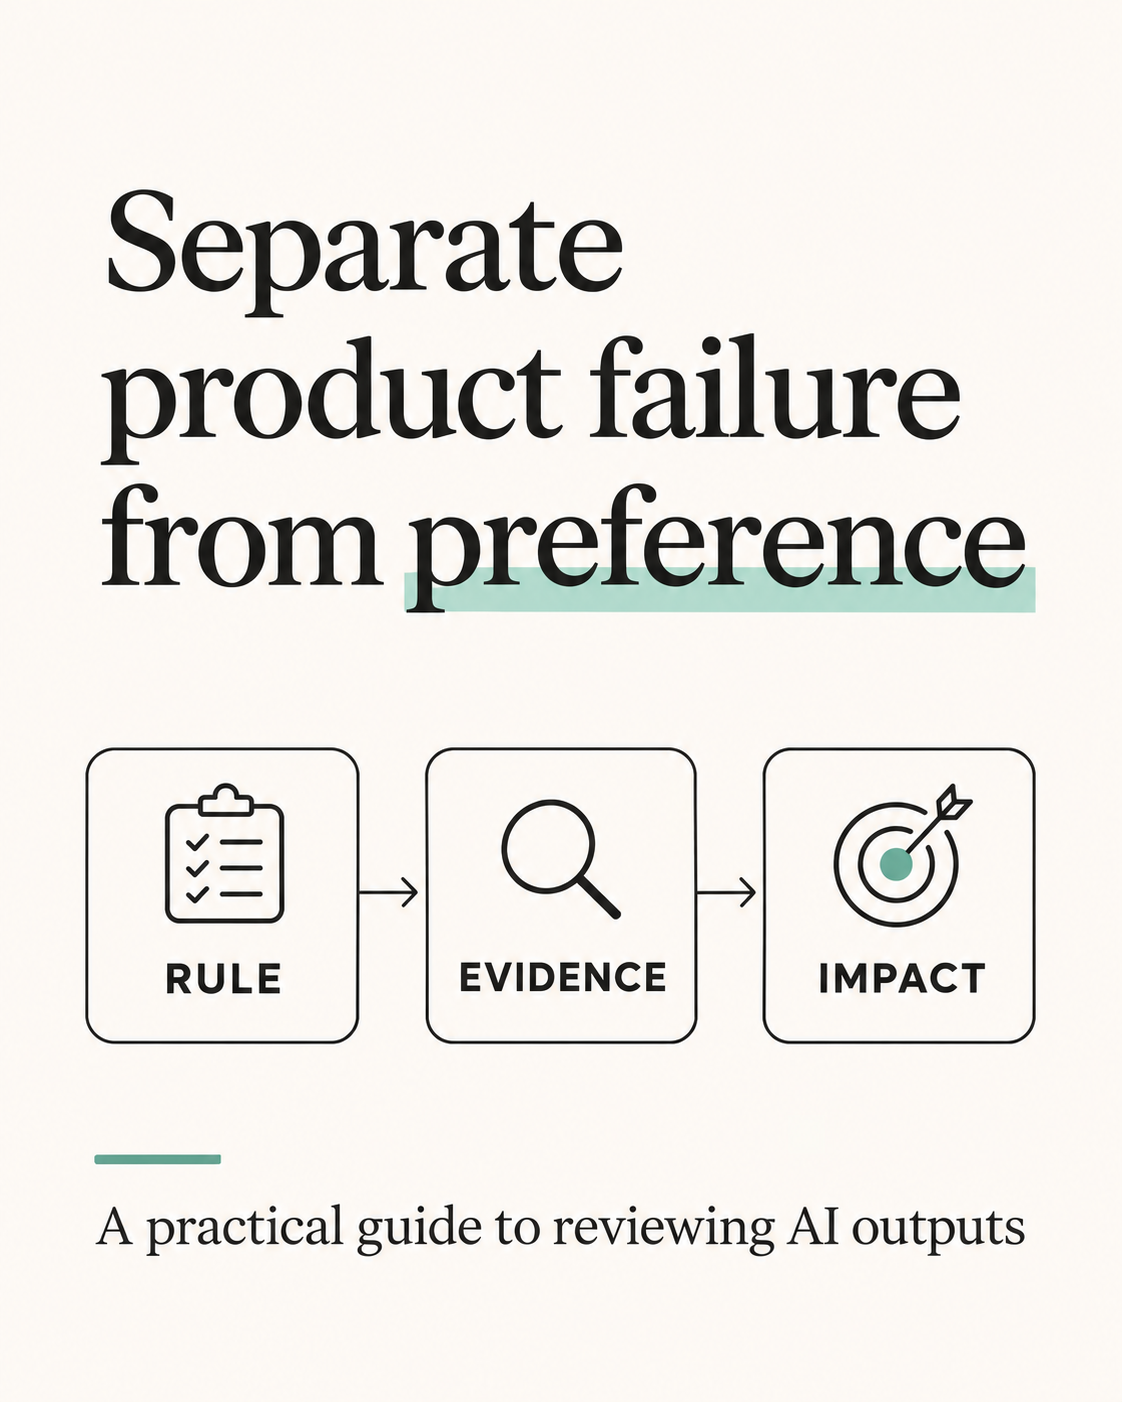
Come annotare gli output dell'AI per i PM: separare errori di prodotto e preferenze
Un metodo pratico di review per i prodotti AI: separa violazioni di policy, contesto mancante e preferenze personali per trasformare i feedback sugli output in comportamenti di prodotto migliori.
Un reviewer assegna quattro stelle alla risposta di un'AI. Cosa dovrebbe cambiare il team di prodotto?
Forse la risposta non ha centrato la domanda dell'utente. Forse conteneva un'affermazione senza fonti. Forse i dati erano corretti, ma il tono sembrava troppo rigido. Oppure il reviewer preferisce semplicemente una struttura diversa, anche se la risposta ha svolto il suo compito.
Tutte queste reazioni sono utili, ma descrivono cose diverse. Se vengono ridotte a un generico “qualità: 4/5”, il team perde le informazioni necessarie per migliorare il prodotto.
Un processo di annotazione pratico parte dal separare ciò che l'output ha fatto, quale regola di prodotto ha rispettato o mancato e ciò che il reviewer preferiva a livello personale. In questo modo, la fase di review smette di essere una gara di popolarità sul testo generato e diventa uno strumento per chiarire il comportamento del prodotto.
Decidi che tipo di giudizio stai raccogliendo
Prima di chiedere alle persone di etichettare gli output, stabilisci cosa devono rappresentare quelle etichette.
A volte il prodotto ha bisogno di una policy coerente. Ad esempio, il brief di un prodotto generato dall'AI non deve presentare l'affermazione di un cliente priva di fonte come un dato di fatto. I reviewer devono applicare questa regola in modo sistematico. Si tratta di un giudizio di policy: il team sta definendo un comportamento previsto e univoco del prodotto.
Altre volte, il prodotto dovrebbe preservare la diversità delle esigenze delle persone. Un product manager potrebbe preferire un riepilogo sintetico; un altro potrebbe aver bisogno di maggiori dettagli per una review con gli stakeholder. Se entrambi i formati funzionano per i rispettivi casi d'uso, registrare la preferenza può aiutare il prodotto a comprendere contesti differenti. Si tratta di un giudizio di preferenza, non automaticamente di un difetto del prodotto.
La ricerca sull'annotazione per task linguistici soggettivi descrive una distinzione simile tra la raccolta di prospettive diverse e l'indicazione agli annotatori di applicare una policy definita. La scelta dipende dallo scopo per cui il dataset viene creato. La stessa decisione è fondamentale quando un team di prodotto analizza gli output dell'AI: stai cercando di capire cosa preferiscono gli utenti o di stabilire cosa il prodotto deve fare tassativamente?
Raccogliamo queste etichette per stabilire se l'output dell'AI rispetta il comportamento concordato per questo task.
Oppure:
Raccogliamo queste reazioni per scoprire quali stili di output validi funzionano meglio per utenti e situazioni diverse.
Un team può raccogliere entrambi i tipi di feedback, ma le etichette devono tenerli ben distinti.
Etichetta il comportamento prima di giudicare il testo
Per ciascun output, registra tre elementi:
Comportamento osservato: cosa ha fatto concretamente il sistema?
Criterio: quale regola di prodotto concordata si applica a questo caso?
Impatto: cosa potrebbe accadere all'utente se questo comportamento restasse invariato?
Per una funzionalità di sintesi delle attività di research, un set essenziale di etichette di comportamento potrebbe essere:
Etichetta
Quando usarla
Obiettivo mancato
L'output non risponde al task richiesto dall'utente
Affermazione senza riscontro
Un dato fattuale non è rintracciabile nel materiale fornito
Omissione rilevante
Manca una prova rilevante o una contraddizione significativa
Confusione di contesto
L'output unisce fonti o persone che dovrebbero restare distinte
Prossimo passo errato
La raccomandazione non è coerente con le prove fornite e l'obiettivo dichiarato
Preferenza
L'output funziona, ma il reviewer sceglierebbe uno stile o una struttura diversa
Giudizio impossibile
Mancano la fonte o il contesto del task necessari per una valutazione
Queste etichette sono solo un punto di partenza. Adattale al reale user job e ai rischi specifici del tuo prodotto. Un'etichetta come “allucinazione” è spesso troppo generica per orientare una correzione. Dire “L'affermazione sul motivo per cui il cliente ha abbandonato il servizio non trova riscontro in alcun passaggio dell'intervista” spiega chiaramente al team cosa non ha funzionato e quale prova servirebbe a confermarlo.
Rendi verificabile ogni errore
Quando un reviewer segnala un errore di prodotto, richiedi una breve traccia di evidenze:
Seleziona la frase o la sezione esatta all'interno dell'output.
Collega la fonte o l'istruzione del task che l'output avrebbe dovuto seguire.
Descrivi il comportamento atteso in una sola frase.
Riporta l'impatto sull'utente.
Valuta la gravità separatamente dal livello di certezza nell'etichetta.
Ad esempio:
Campo
Esempio
Estratto dell'output
“Gli utenti hanno abbandonato il servizio perché il setup era troppo complesso.”
Fonte
Tre interviste menzionano il setup, ma nessuna spiega il motivo dell'abbandono
Criterio
Non dichiarare una causa se non è supportata da una fonte
Comportamento atteso
Riportare che il setup è stato menzionato, lasciando aperta la causa dell'abbandono
Impatto
Il team potrebbe dare priorità al problema sbagliato
Gravità
Alta per questo tipo di decisione
Certezza dell'etichetta
Sicura
Gravità e certezza rispondono a domande differenti. Un reviewer può non essere sicuro che un'affermazione sia priva di fondamento, ma al contempo rendersi conto che, se lo fosse, le conseguenze sarebbero gravi. Mantenere distinti questi campi aiuta il PM a decidere cosa richiede un'indagine immediata.
Non chiedere al reviewer di diagnosticare la causa tecnica. Dire che “il sistema di retrieval ha fallito” è un'ipotesi sull'implementazione. L'annotazione deve limitarsi a registrare l'errore osservabile; saranno poi gli ingegneri a indagare sul motivo per cui si è verificato.
Considera i disaccordi come un segnale utile
Quando due reviewer scelgono etichette diverse, non risolvere la questione affidandoti automaticamente alla maggioranza. Prima di tutto, classifica il disaccordo.
La regola non è chiara: i reviewer non riescono a capire cosa promette il prodotto. Riscrivi il criterio e aggiungi un esempio.
Manca il contesto: un reviewer non dispone della fonte, dell'obiettivo utente o dei permessi necessari per giudicare. Sistema il caso di test.
C'è un trade-off di policy irrisolto: entrambi i giudizi sono ragionevoli, ma implicano comportamenti di prodotto diversi. Il PM deve prendere una decisione o facilitarla insieme agli esperti di dominio.
Le preferenze sono valide ma differenti: mantieni la preferenza e verifica se corrisponde a un segmento di utenti, a un task o a un contesto specifico.
L'esecuzione della review è divergente: le istruzioni potrebbero essere chiare, ma qualcuno potrebbe aver trascurato un dato o frainteso il task. Chiarisci la guida di review e riesamina il caso.
Questo approccio evita di liquidare ogni divergenza come un semplice “errore umano”. Un disaccordo può evidenziare una policy incompleta o una reale variabilità nelle esigenze degli utenti. Uno studio del 2022 sui paradigmi di annotazione sottolinea proprio questo: a volte l'obiettivo è modellare prospettive differenti, altre volte è applicare una policy ben definita. Decidi quale obiettivo si adatta al tuo prodotto prima di condensare le etichette in una risposta univoca.
Conduci una breve calibrazione prima di estendere la review
Inizia con un piccolo gruppo di output rappresentativi: un caso lineare, uno con fonte mancante, una contraddizione, una preferenza di stile e un caso limite. Chiedi a due o più reviewer di etichettarli in modo indipendente, quindi confrontate insieme evidenze e motivazioni.
L'obiettivo della calibrazione non è ottenere un punteggio di accordo perfetto. Serve a individuare i punti in cui le istruzioni non riescono a distinguere tra:
un errore fattuale e un'inferenza non supportata
un dettaglio mancante e un dettaglio irrilevante per il task dell'utente
una preferenza di stile e un reale problema di usabilità
un difetto a basso impatto e un comportamento bloccante per il rilascio
un errore del modello e un contesto di input carente o di scarsa qualità
Aggiorna la guida con la soluzione individuata e un esempio conciso. Conserva anche le annotazioni indipendenti iniziali: mostrano se il disaccordo dipendeva dal caso specifico, dalla policy o dalle istruzioni della review.
Il NIST AI Risk Management Framework richiede ai team di definire responsabilità e supervisione nell'interazione tra esseri umani e AI. Per un team di prodotto, una guida di review è un modo pratico per rendere visibili queste responsabilità: chi fornisce il giudizio di dominio, chi applica la regola e chi monitora implementazione e affidabilità.
Collega le annotazioni alle decisioni di prodotto
Un set di annotazioni non costituisce di per sé una decisione di lancio. È la base di prove su cui poggiano decisioni come:
Il comportamento del prodotto è definito con sufficiente chiarezza per poter essere implementato?
Quale errore richiede una modifica alla policy di prodotto?
Quale errore riguarda invece l'implementazione tecnica o l'affidabilità?
Il team ha bisogno di esempi più rappresentativi?
Si tratta di una preferenza valida che richiede una personalizzazione?
Cosa deve essere rivalutato dopo aver modificato un prompt, un modello o un flusso di lavoro?
Tieni una traccia sintetica di ogni sessione di review: task e contesto utente, versione della regola di prodotto, fonti di esempio, etichette, disaccordi aperti, decisioni prese e owner. Quando la regola cambia, aggiorna la versione e riesamina gli esempi collegati. Questo permette al team di capire se l'output è cambiato a causa di una modifica alla policy di prodotto o per un diverso comportamento del sistema.
I PM hanno la responsabilità di valutare il comportamento previsto per l'utente, i trade-off di dominio e cosa devono trasmettere gli esempi. Possono scrivere i prompt, esaminare gli output e definire i criteri di accettazione perché questo lavoro specifica il prodotto. Agli ingegneri spetta invece l'implementazione in produzione, la gestione degli accessi, l'affidabilità e i sistemi che permettono al comportamento di funzionare.
Una scheda di annotazione pronta all'uso
Usa questo schema per la prossima sessione di review:
Task e utente: Regola di prodotto da verificare: Estratto dell'output: Fonte o contesto: Comportamento osservato: Comportamento atteso: Impatto sull'utente e gravità: Certezza dell'etichetta: Violazione di policy, contesto mancante o preferenza? Decisione, owner e prossima review:
Se il team non riesce a compilare il campo relativo alla regola di prodotto, metti in pausa la valutazione e stabilisci prima di tutto cosa dovrebbe fare il prodotto. La scheda è utile solo quando rispecchia una decisione di prodotto che il team è disposto a sostenere.
Specky aiuta i team a mantenere allineati evidenze degli utenti, decisioni di prodotto e prossimi passi. Scopri il product workspace for technical PMs o inizia a definire un documento di requisiti con il nostro PRD generator.
GDPR-aligned. EU workspace data is stored in Frankfurt, Germany. GDPR and EU data Built in Vienna, Austria. A product of influence solutions fm GmbH (FN 675374y). Imprint 14-day trial. Card required, and nothing is charged until day 14. 30-day refund after subscribing. See pricing