9 novembre 2026Aggiornato il Fathy Shalaby12 min di lettura
Template di piano per test A/B: testa un solo cambiamento e indica la metrica
La maggior parte degli split test va storta prima ancora di iniziare. Cambia una sola cosa, indica prima la metrica, calcola la dimensione del campione e non sbirciare i risultati.
Un template di piano per test A/B è un piano di una pagina che compili prima di uno split test: il singolo cambiamento, la metrica primaria, una metrica guardrail, la dimensione del campione e la data di fine. Lo split test poi mostra quel cambiamento a una quota casuale del traffico reale e confronta la metrica che hai indicato prima dell'avvio. Scrivi prima il piano, perché la maggior parte degli split test va storta prima del lancio.
Punti chiave
La maggior parte delle idee perde. Il tasso di successo delle idee su Bing era circa del 10-20%, e le vincenti spostavano le metriche chiave dallo 0,1% all'1,0% (Kohavi et al., KDD 2014).
Calcola la dimensione del campione prima di iniziare. Con un tasso di conversione del 12%, rilevare un aumento relativo del 10% richiede circa 11.700 utenti per versione, con il 95% di confidenza e l'80% di potenza (calcolatore di Evan Miller).
Non sbirciare. Testare dopo ogni visitatore e fermarsi al primo risultato «significativo» porta il tasso di falsi positivi dal 5% al 26,1% (Evan Miller, 2010).
Indica una guardrail, una metrica che non deve peggiorare.
Che cos'è uno split test?
Uno split test cambia una cosa per una parte del tuo traffico reale e confronta una metrica che hai indicato prima dell'inizio del test.
È la stessa cosa di un test A/B: la versione A è l'originale (il controllo), la versione B contiene il cambiamento, e le persone vengono assegnate a caso. Poiché il cambiamento è l'unica differenza sistematica, uno scarto netto nella metrica indica il cambiamento.
In Testing Business Ideas di David J. Bland e Alex Osterwalder, lo split test è un esperimento di validazione di tipo «call to action», accanto al test della landing page e alla prevendita. Il poster di Strategyzer gli assegna 2 su 5 per il costo, 3 su 5 per il tempo di esecuzione e 3 su 5 per la solidità dell'evidenza (libreria di esperimenti di Strategyzer).
Usalo quando hai abbastanza traffico e vuoi sapere se un cambiamento specifico ha causato un risultato. È il modo più affidabile per rispondere. Può anche sorprenderti. Nel loro articolo del 2017 su Harvard Business Review, Ron Kohavi e Stefan Thomke raccontano la storia di una piccola modifica al modo in cui venivano mostrati i titoli degli annunci su Bing, che produsse risultati così forti da far scattare un allarme interno perché sembravano troppo belli per essere veri. L'idea era rimasta nel backlog per più di sei mesi. Aumentò i ricavi del 12%, per un valore di oltre 100 milioni di dollari l'anno solo negli Stati Uniti.
Quella storia è l'eccezione. In un articolo del 2014, Kohavi e colleghi scrissero che la maggior parte degli esperimenti di Bing fallisce e che i risultati eccezionalmente forti richiamano la legge di Twyman: «Any figure that looks interesting or different is usually wrong!»
Non usarlo con poco traffico. Se ti servissero molti mesi per raggiungere abbastanza persone, usa un test di usabilità o delle interviste. Non usarlo per esplorare. Confronta solo opzioni che hai già. Per approfondire, leggi la nostra guida più completa ai test A/B per product manager.
Quale rischio mette alla prova e quanto è forte l'evidenza?
Mette alla prova la desiderabilità: questa versione porta le persone a fare di più ciò che vuoi? L'evidenza è comportamento, di persone reali che non sanno di essere in un test. Misura ciò che accade durante il periodo del test, quindi può perdere effetti a lungo termine. Vedi la nostra guida alla scelta di un esperimento di prodotto.
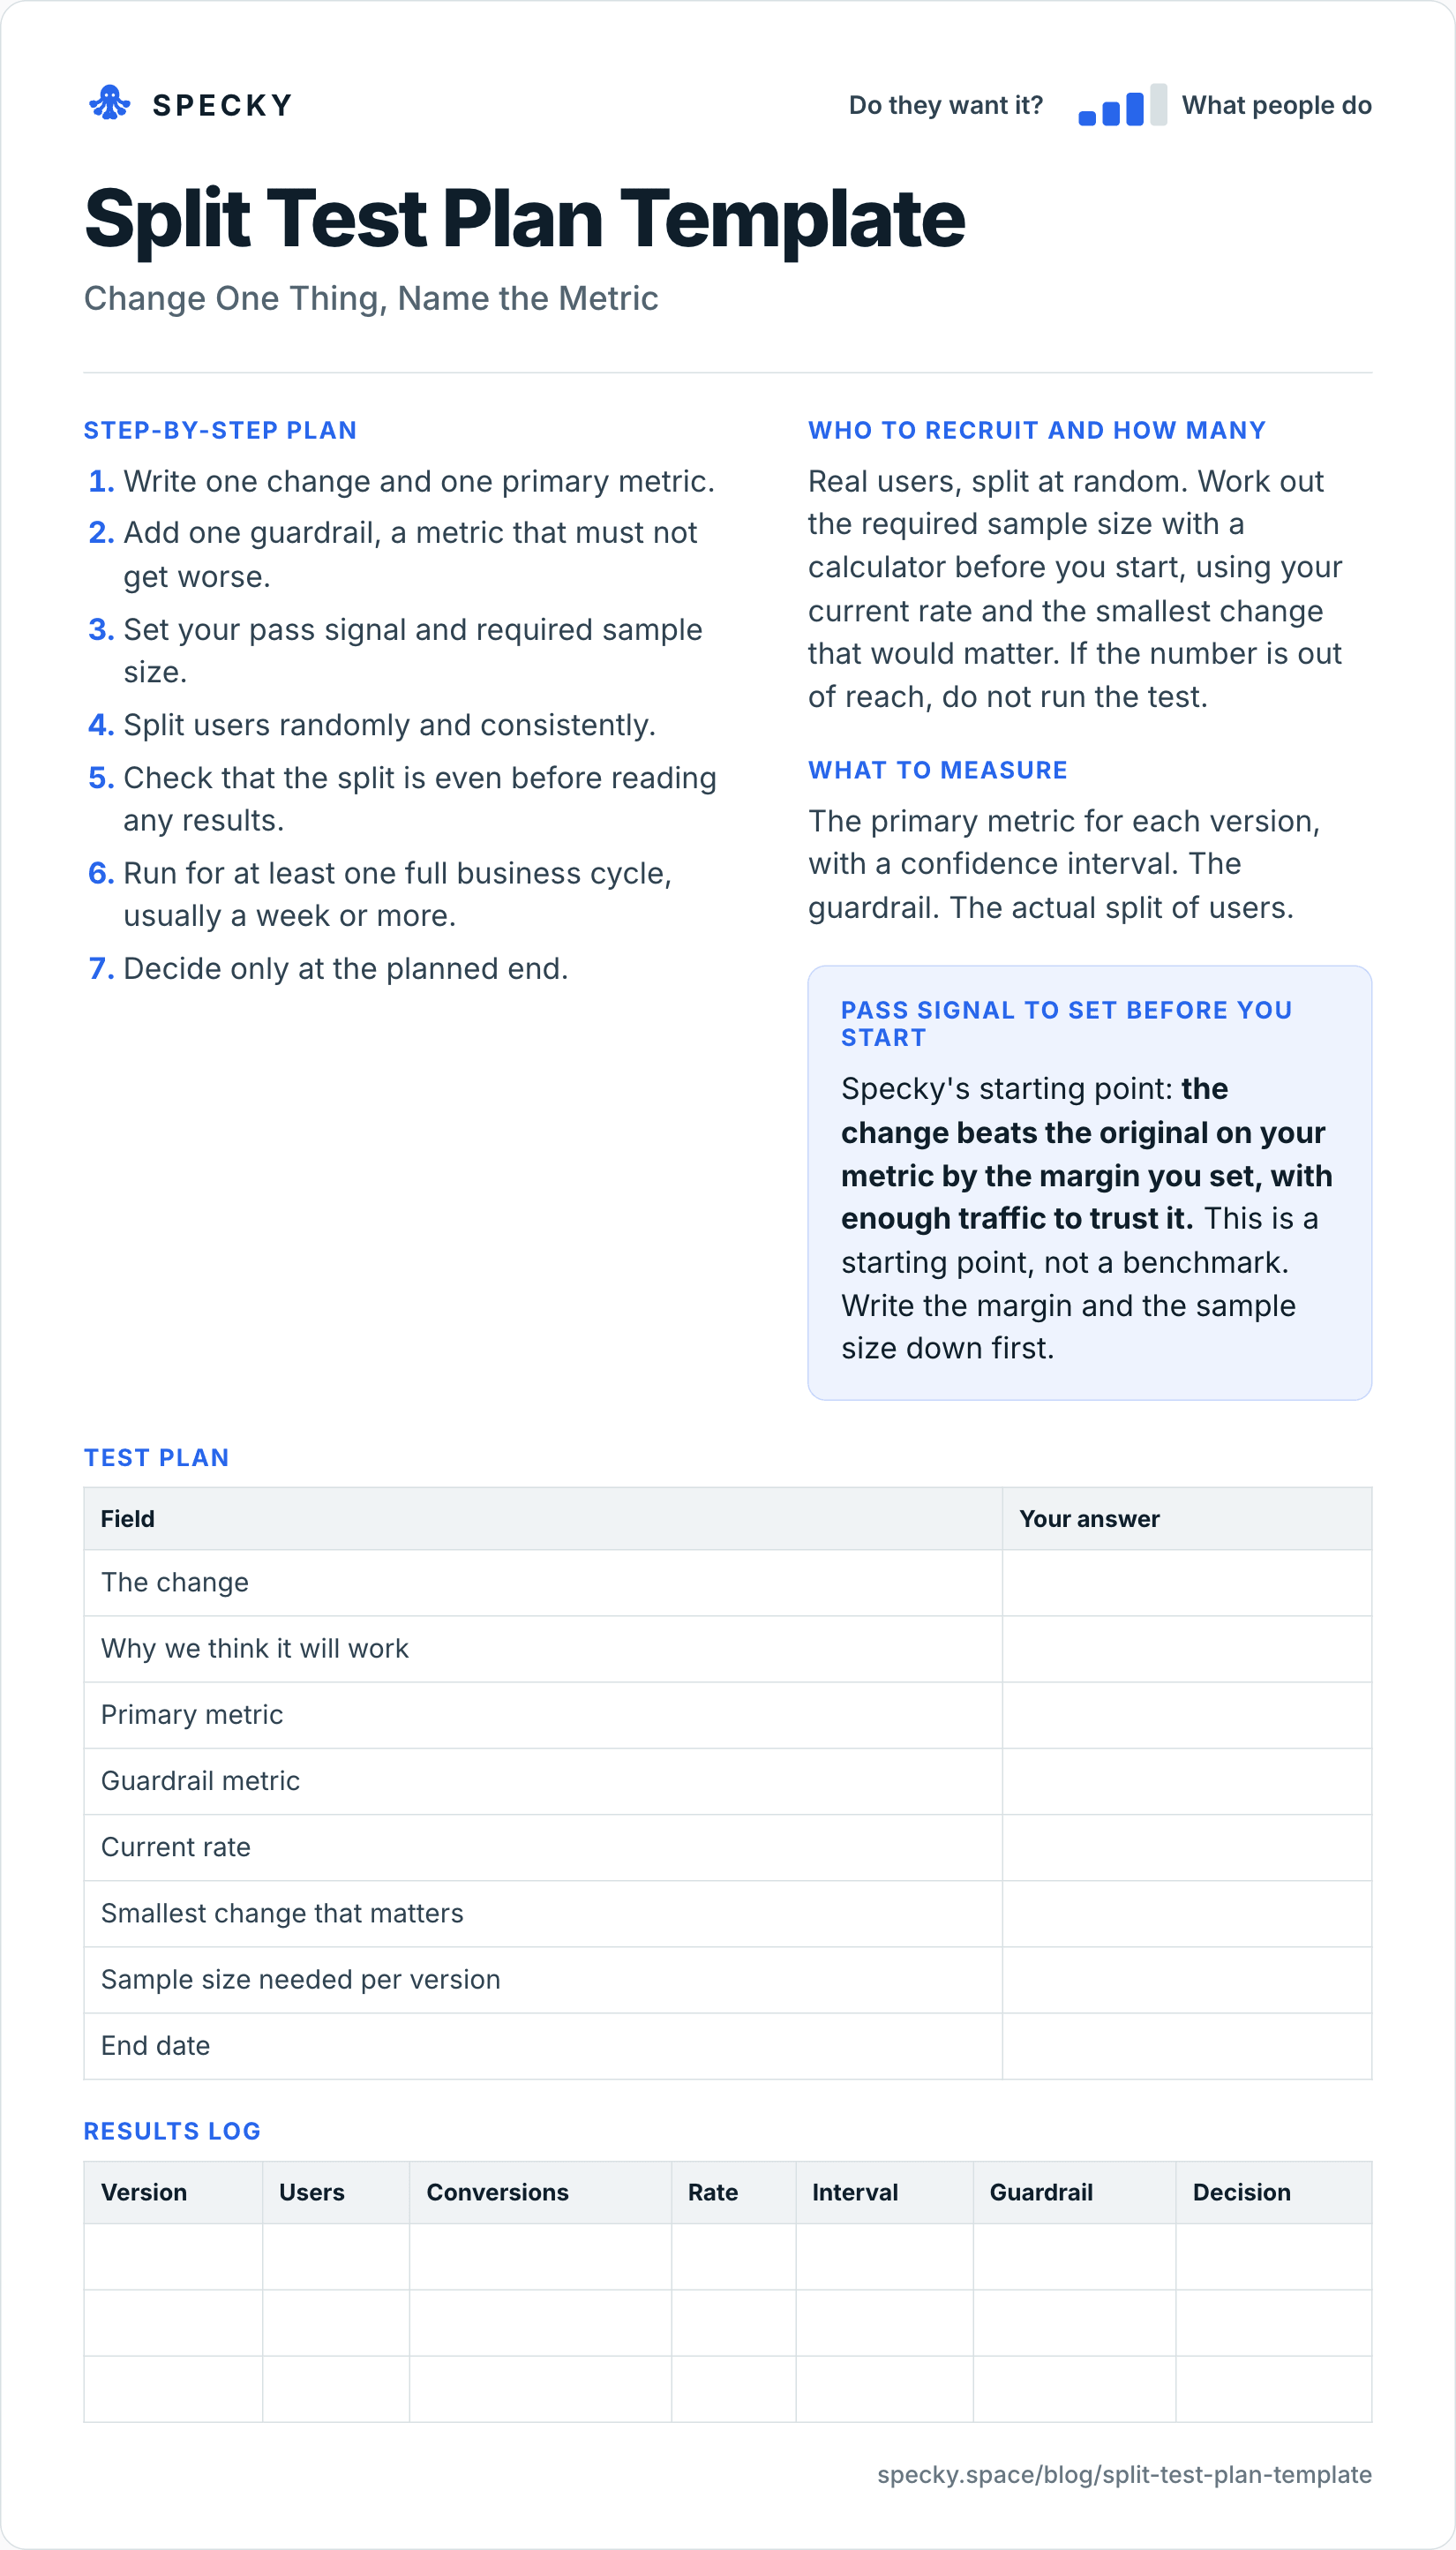
Template di piano per test A/B (copia e usa)
Apri l'immagine a dimensione intera oppure copia la versione testuale qui sotto.
Chi reclutare e quanti
Utenti reali, divisi a caso. Calcola la dimensione del campione necessaria con un calcolatore prima di iniziare, usando il tuo tasso attuale e il cambiamento più piccolo che conterebbe. Se il numero è fuori portata, non fare il test.
Piano passo per passo
Scrivi un cambiamento e una metrica primaria.
Aggiungi una guardrail, una metrica che non deve peggiorare.
Fissa il tuo segnale di successo e la dimensione del campione necessaria.
Dividi gli utenti in modo casuale e coerente.
Verifica che la divisione sia uniforme prima di leggere qualsiasi risultato.
Lascialo girare per almeno un ciclo di business completo, di solito una settimana o più.
Decidi solo alla fine prevista.
Piano del test
Campo
La tua risposta
Il cambiamento
Perché pensiamo che funzionerà
Metrica primaria
Metrica guardrail
Tasso attuale
Cambiamento più piccolo che conta
Dimensione del campione necessaria per versione
Data di fine
Che cosa misurare
La metrica primaria per ogni versione, con un intervallo di confidenza. La guardrail. La divisione effettiva degli utenti.
Segnale di successo da fissare prima di iniziare
Il punto di partenza di Specky: il cambiamento batte l'originale sulla tua metrica del margine che hai fissato, con abbastanza traffico per fidarsene. È un punto di partenza, non un benchmark. Scrivi prima il margine e la dimensione del campione.
Registro dei risultati
Versione
Utenti
Conversioni
Tasso
Intervallo
Guardrail
Decisione
Di quanti utenti hai bisogno per un test A/B?
Dipende dal tuo tasso di conversione attuale e dal cambiamento più piccolo che vale la pena rilevare, l'effetto minimo rilevabile. Più piccolo è uno dei due, più traffico serve. Con la formula a due code del calcolatore gratuito di Evan Miller, al suo standard del 5% di significatività e 80% di potenza, ecco il campione necessario per versione:
Tasso di conversione attuale
Per rilevare un aumento relativo del 5%
Aumento relativo del 10%
Aumento relativo del 20%
2%
circa 310.000
circa 78.000
circa 19.800
5%
circa 120.000
circa 30.200
circa 7.700
12%
circa 46.300
circa 11.700
circa 2.900
20%
circa 25.300
circa 6.300
circa 1.600
Dimezzare l'effetto che vuoi rilevare quadruplica all'incirca il traffico, e i tassi di base bassi richiedono molte più persone di quelli alti.
Per verificare senza calcolatore, usa la regola empirica di Evan Miller: n = 16σ² / δ², dove δ è l'effetto minimo e, per un tasso di conversione p, σ² = p(1 − p). Al 12% e per un aumento al 13,2%: 16 × 0,12 × 0,88 ÷ 0,012² ≈ 11.700 per versione.
Esempio svolto: dalla dimensione del campione alla data di fine
Questo esempio è illustrativo; corrisponde all'esempio svolto più sotto.
Tasso attuale: il 12% dei visitatori si iscrive.
Cambiamento più piccolo che conta: un aumento relativo del 10%, dal 12% al 13,2%.
Dimensione del campione: circa 11.700 per versione, quindi circa 23.400 visitatori in totale.
Traffico: circa 860 visitatori al giorno raggiungono la pagina di iscrizione.
Se la risposta fosse stata sei mesi, non fare un test più piccolo sperando nel meglio. Testa un cambiamento più grande, scegli una metrica con un tasso di base più alto o usa un metodo che richiede meno traffico.
Quanto deve durare uno split test?
Finché non raggiungi la dimensione del campione prevista, e per almeno un ciclo di business completo, di solito una settimana o più, perché gli utenti dei giorni feriali e quelli del weekend si comportano in modo diverso.
Perché non bisogna sbirciare i risultati?
Le dashboard mostrano un valore p che presuppone che tu guardi una sola volta, alla fine. Ogni occhiata in più è un'altra occasione perché il rumore superi la soglia. Evan Miller ha mostrato che testare dopo ogni osservazione e fermarsi al primo p < 0,05 dà un tasso di falsi positivi del 26,1%, più di cinque volte il 5% che pensi di avere (Evan Miller, 2010).
Se devi guardare prima, alza l'asticella: guardando 10 volte, ti serve una significatività riportata dell'1,0% per mantenere un vero tasso del 5%.
Perché un risultato «significativo» richiede comunque una verifica?
Kohavi e colleghi spiegano i conti. Se un'idea su tre è davvero vincente, la media che hanno riportato sugli esperimenti di Microsoft, un risultato significativo è un vero positivo circa l'89% delle volte. Se le vere svolte sono una su 500, scende al 3,1%. I risultati sorprendenti vanno rieseguiti.
Che cosa misurare in uno split test?
La metrica primaria per ogni versione, con un intervallo di confidenza, non solo una percentuale.
Una metrica guardrail che non deve peggiorare, come la conversione a pagamento, i rimborsi o il tempo di caricamento della pagina.
La divisione effettiva degli utenti. Se avevi pianificato 50/50 e ottieni 52/48 su numeri grandi, qualcosa non va. È un sample ratio mismatch. Verificarlo richiede solo le proporzioni attese e i conteggi osservati, e individua un'ampia varietà di problemi nei dati (SRM checker di Lukas Vermeer e colleghi). Non leggere i risultati finché non lo supera.
Le guardrail sugli eventi rari richiedono molto traffico: rilevare un calo del 10% in una conversione a pagamento dell'1,2% richiede circa 130.000 utenti per versione. Se non puoi raggiungerli, scrivi in anticipo che cosa conta come violazione, per esempio «qualsiasi calo di clienti paganti blocca il lancio».
Split test, test della landing page e fake door test a confronto
Questo cambiamento causa più del comportamento che vogliamo?
Qualcuno fa il passo successivo per questa offerta?
Gli utenti esistenti provano a usare una funzionalità non ancora costruita?
Confronto
Controllo contro variante, a caso
Di solito una pagina contro un obiettivo
Un pulsante contro un obiettivo
Evidenza
Causale, comportamentale
Interesse comportamentale
Interesse comportamentale
Usa un test della landing page o un fake door test per capire se c'è interesse; usa uno split test per capire quale di due versioni funziona meglio.
Che aspetto ha uno split test nella pratica?
Questo esempio è inventato per mostrare il metodo. Un team che gestisce uno strumento per la dichiarazione dei redditi vuole accorciare il modulo di iscrizione da sei campi a tre. Prevedono che le iscrizioni aumentino di almeno il 10% e fissano la conversione a pagamento come guardrail.
Dopo quattro settimane e 12.000 visitatori in ogni gruppo, il modulo più corto aumenta le iscrizioni del 14%. Ma la conversione a pagamento cala e la guardrail viene violata: le iscrizioni extra sono persone con meno intenzione che non finiscono mai.
L'obiettivo delle iscrizioni è raggiunto e la guardrail fallisce, quindi non lo rilasciano così com'è. Provano un modulo più corto con una domanda in più sul tipo di dichiarazione del cliente.
Ecco come potrebbe apparire il registro:
Versione
Utenti
Iscrizioni
Tasso
Clienti paganti
Decisione
Sei campi (controllo)
12.000
1.440
12,0%
144
Tre campi
12.000
1.642
13,7%
131
Non rilasciare
L'aumento delle iscrizioni è reale: +1,7 punti percentuali, con un intervallo al 95% di circa da +0,8 a +2,5. Il calo dei paganti, da 144 a 131 clienti, è troppo piccolo per essere dimostrato con questo traffico, ma la regola di guardrail scritta in anticipo dal team diceva che meno clienti paganti bloccavano il rilascio.
Quali sono gli errori più comuni negli split test?
Sbirciare. Controllare presto e fermarsi quando sembra buono produce false vittorie.
Cambiare più cose. Non saprai quale ha funzionato.
Nessuna guardrail. Puoi vincere una metrica e perdere l'azienda.
Troppo poco traffico. Un test senza potenza sufficiente è solo rumore costoso.
Ignorare la novità. Le persone cliccano sulle cose nuove solo perché sono nuove.
Quando non funziona: con poco traffico, per le grandi scommesse che non si possono dividere, per gli effetti che richiedono mesi e quando gli utenti parlano tra loro, così che i gruppi non sono indipendenti.
È etico fare uno split test senza dirlo agli utenti?
I cambiamenti ordinari, come un modulo più corto o un titolo nuovo, vengono testati abitualmente senza avvisare ogni utente. Il limite è il danno. Non testare nulla che non ti sentiresti a tuo agio a rilasciare per tutti, non mostrare prezzi diversi a clienti simili senza una politica chiara e conta solo le persone che il tuo banner di consenso ti permette di tracciare.
Come eseguirlo in Specky
Nella pagina Assumptions, clicca sulla nota e scegli Pick a test, poi Split test. Specky compila i passaggi, il segnale di successo e una tempistica di due settimane.
Per un cambiamento all'interno del tuo prodotto, esegui la divisione con il tuo strumento di feature flag o di esperimenti. Specky non modifica il tuo prodotto. Legge i numeri dagli analytics collegati e tu allegli il risultato come evidenza.
Se stai testando una pagina di validazione di Specky, la divisione può avvenire lì. Imposta un controllo e fino a cinque varianti in Experiment analytics, e Specky mostra la conversione per versione, gli intervalli al 95%, se hai abbastanza persone e una guardrail facoltativa. Il verdetto resta prudente finché il campione è piccolo.
Clicca su Start running e registra il risultato alla fine prevista.
Un esito positivo appare sulla board come Supported, perché un confronto controllato di ciò che le persone hanno fatto è comportamento.
Che cosa fare con ciascun esito?
Supported: rilascia il cambiamento. Annota l'entità del guadagno e ricontrolla gli analytics tra un mese per vedere se l'effetto dura.
Unclear: il risultato rientra nel margine di errore. Tieni la versione più semplice, oppure scopri perché con qualche intervista.
Contradicted: il cambiamento non ha avuto effetto o ha peggiorato le cose. Non rilasciarlo. Ogni scommessa che poggia su questa nota ora appare come Contradicted.
Domande frequenti
Di quanto traffico hai bisogno per uno split test?
Dipende dal tuo tasso di conversione attuale e dal cambiamento più piccolo che conterebbe. Con un tasso di conversione del 12%, rilevare un aumento relativo del 10% richiede circa 11.700 utenti per versione con le impostazioni standard; al 2%, circa 78.000. Se non riesci a raggiungere il numero in un tempo ragionevole, usa un metodo diverso.
Perché non bisogna fermare uno split test in anticipo?
Fermarsi quando i risultati sembrano buoni rende molto più probabili le false vittorie, perché all'inizio i risultati oscillano. Nel caso peggiore di Evan Miller, testare dopo ogni visitatore dà un tasso di falsi positivi del 26,1% invece del 5%. Decidi in anticipo la data di fine e la dimensione del campione.
Che cos'è una metrica guardrail?
Una metrica guardrail è un numero che non deve peggiorare durante un test, anche se la tua metrica principale migliora, come la conversione a pagamento, i rimborsi o la velocità della pagina. Ti impedisce di vincere una metrica danneggiando l'azienda. Scrivi la regola di che cosa conta come violazione prima dell'inizio del test.
Qual è la differenza tra uno split test e un test A/B?
Nessuna nella pratica. Entrambi mostrano un cambiamento a una quota casuale di utenti e confrontano una metrica con un gruppo di controllo; i ricercatori lo chiamano esperimento controllato online. Testare più cambiamenti in combinazione è un test multivariato, che richiede molto più traffico.
GDPR-aligned. EU workspace data is stored in Frankfurt, Germany. GDPR and EU data Built in Vienna, Austria. A product of influence solutions fm GmbH (FN 675374y). Imprint 14-day trial. Card required, and nothing is charged until day 14. 30-day refund after subscribing. See pricing