5 november 2026Bijgewerkt op Fathy Shalaby16 min leestijd
AI-onderzoekssynthese: houd bewijs en interpretatie gescheiden
AI sorteert een map vol interviews in minuten, maar studies laten zien dat interpretatieve thema's wegvallen. Een werkwijze in vijf stappen, een prompt en een reviewchecklist houden elke bewering gekoppeld aan de bron.
AI-onderzoekssynthese is het gebruik van een taalmodel om interviewnotities, supporttickets en sessieobservaties te ordenen tot kandidaat-thema's, terwijl mensen elk thema toetsen aan het oorspronkelijke bewijs en de interpretatie zelf verantwoorden. Het brengt de eerste ronde terug van uren naar minuten. Het gaat mis als gegenereerde thema's als bevindingen worden behandeld: in gepubliceerde vergelijkingen komen modellen veel vaker overeen met menselijke onderzoekers bij beschrijvende thema's dan bij interpretatieve.
AI kan een map met interviewnotities in een paar seconden omzetten in een nette samenvatting. Dat is handig om materiaal te vinden dat je moet bekijken. Het is ook een makkelijke manier om een onzekere interpretatie om te zetten in een productbeslissing die zelfverzekerd klinkt. Deze gids is voor founders, eerste PM's en product engineers die een handvol gesprekken, tickets en gebruiksnotities hebben, niet voor een onderzoeksafdeling met tijd om alles opnieuw te lezen.
Belangrijkste punten
In een studie uit 2024 vonden ChatGPT en Bard elk 5 van de 7 thema's die menselijke coders vonden (71%), maar kwamen ze op slechts 36–47% van de afzonderlijke codes overeen met de mensen (Prescott et al., 2024).
Dezelfde AI-analyse duurde ongeveer 20 minuten, tegen gemiddeld 567 minuten voor de menselijke coders. De snelheid is echt; de precisie niet.
Bij 30 Japanse klinische interviews kwam ChatGPT-4 op meer dan 80% van de beschrijvende thema's overeen met de onderzoekers, maar op slechts ongeveer 30% van de thema's die culturele of emotionele interpretatie vereisten (Sakaguchi et al., 2025).
67% van de UX-professionals die hun eigen onderzoeksdata analyseren, gebruikt daar vaak of altijd AI voor, maar de kwaliteit van de output is de grootste drempel voor adoptie, genoemd door 54% (NN/g, 2026).
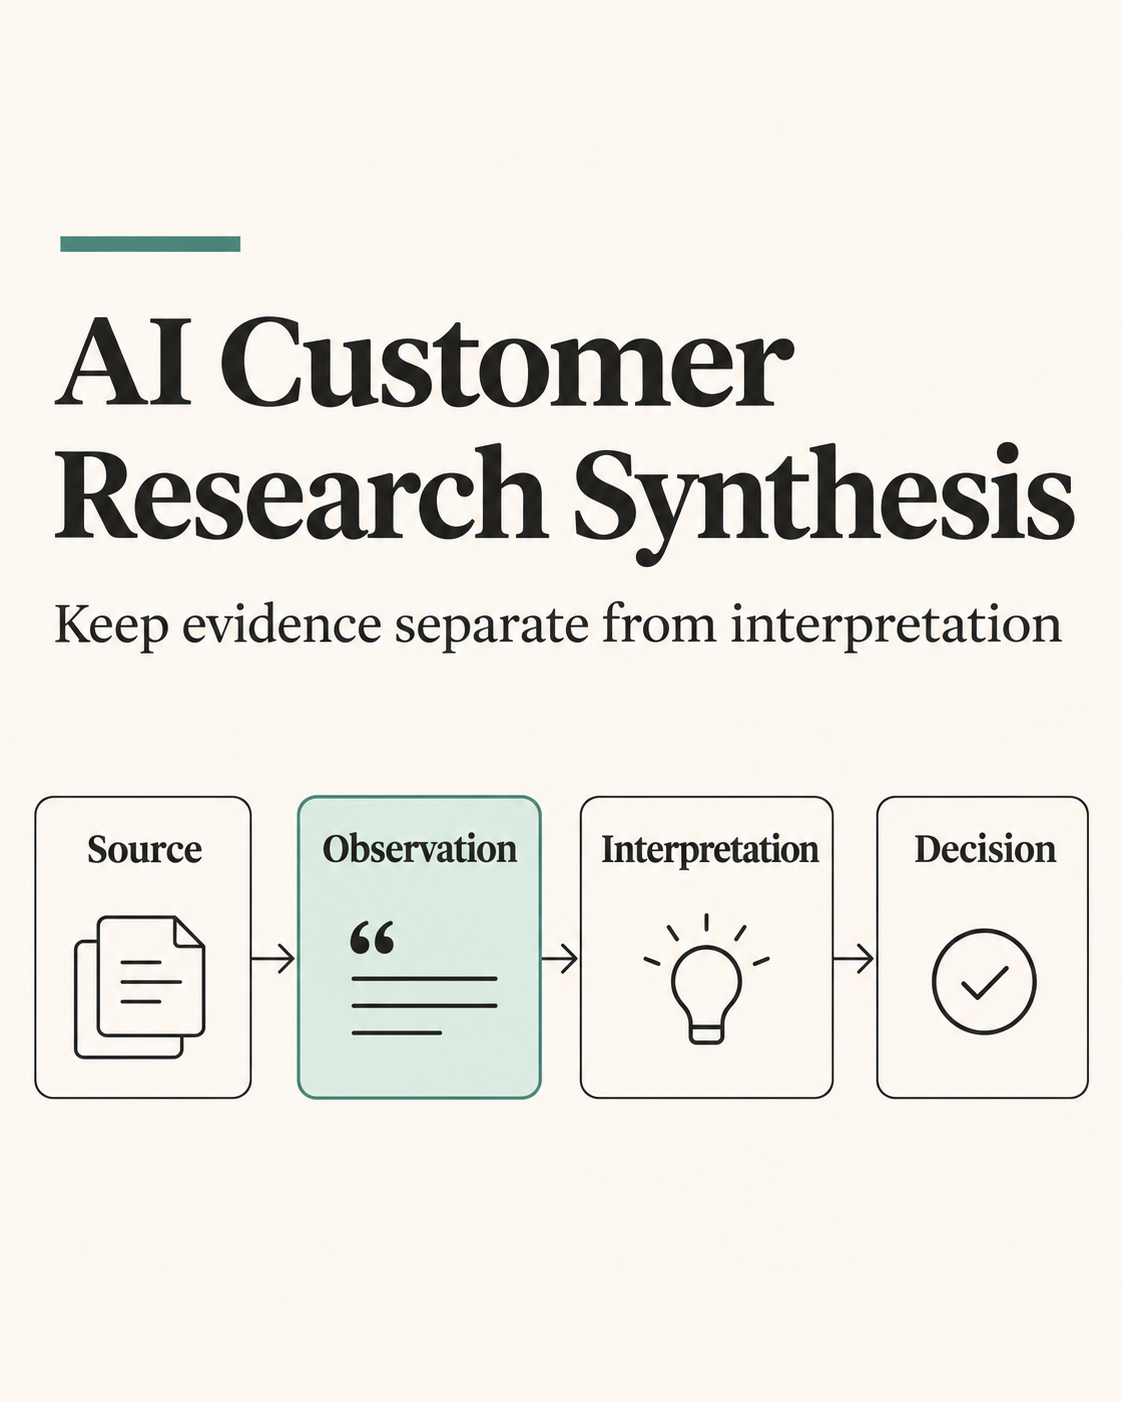
Houd vier lagen uit elkaar: bron, observatie, interpretatie, beslissing. Bij de eerste twee mag AI helpen. Mensen zijn eigenaar van de laatste twee.
Wat is AI-onderzoekssynthese, en wat zou het niet moeten doen?
Synthese is de stap na de interviews: patronen en betekenisvolle verschillen tussen gesprekken vinden en dan beslissen wat ze betekenen voor een productbeslissing. Onze gids over hoe je klantinterviews analyseert beschrijft de handmatige methode. Bij AI-onderzoekssynthese geef je een deel van dat werk aan een model: transcriberen, observaties eruit halen, vergelijkbare uitspraken clusteren en themalabels voorstellen.
Wat het niet moet doen, is concluderen. Een model kent je strategie niet, niet de accounthistorie van de klant en niet welke deelnemer slecht paste bij het onderzoek. Toen Nielsen Norman Group in 2023 AI-insightgeneratoren onder de loep nam, konden de tools de doelen van het onderzoek, eerdere bevindingen en context over elke deelnemer niet meenemen, en daardoor kwamen hun thema's ongeprioriteerd uit de bus (NN/g, 2023).
Waarom zijn bewijs en verhaal twee verschillende dingen?
Stel je drie geïnterviewden voor die een verwarrende installatiestap beschrijven. De één zegt dat hij niet wist welke bron hij moest koppelen. Een ander koppelde het verkeerde account. Een derde vraagt om een installatiechecklist.
De observaties zijn specifiek. "Gebruikers hebben een onboardingchecklist nodig" is al een interpretatie. "De integratiekiezer is het probleem" is er nog een. Geen van beide mag worden opgeslagen alsof het een letterlijk citaat is.
Een bruikbare synthese houdt vier lagen zichtbaar:
Bron: het oorspronkelijke interview, het supportbericht of de geobserveerde sessie.
Observatie: wat de persoon zei of deed, met genoeg context om het te kunnen duiden.
Interpretatie: de mogelijke behoefte, oorzaak of het patroon dat je afleidt.
Beslissing: wat het team gaat doen, testen, uitstellen of hierna wil leren.
Als deze lagen samenvallen in één samenvatting, kan het team de interpretatie niet meer ter discussie stellen zonder meteen te twijfelen of de bron zelf wel echt is. NN/g formuleert de onderzoeksregel rechtstreeks: je moet "onderscheid maken tussen onze interpretaties of aannames en wat de deelnemers zeiden of deden" ("differentiate between our interpretations or assumptions and what the participants said or did", NN/g, 2023). AI-samenvattingen zijn vloeiend proza, en in vloeiend proza verdwijnt die grens het makkelijkst.
Hoe nauwkeurig is AI bij het analyseren van kwalitatief onderzoek?
Nauwkeurig genoeg om de voor de hand liggende thema's te vinden; niet nauwkeurig genoeg om op te vertrouwen bij de subtiele. De gepubliceerde vergelijkingen wijzen dezelfde kant op:
Vage samenvattingen, geen context, citaten zonder bron
Niet gemeten
Prescott en collega's ontdekten dat menselijke coders beter waren in genuanceerde, interpretatieve thema's en concludeerden dat hybride aanpakken nodig zijn. Sakaguchi en collega's noemden ChatGPT-4 een hulpmiddel en benadrukten dat menselijke expertise nodig blijft.
Dit zijn gezondheidsonderzoeken en UX-studies, geen startup-discovery, dus zet de percentages niet zomaar over naar je eigen interviews. Ze ondersteunen wel één werkregel: hoe meer een thema afhangt van context, emotie of wat iemand niet zei, hoe minder je een gegenereerd label mag vertrouwen zonder de bron te lezen.
Wat melden professionals zelf?
De NN/g-enquête van oktober 2026 onder 521 UX-professionals laat zien hoe gewoon AI-analyse is geworden (NN/g, 2026):
67% van degenen die hun eigen onderzoeksdata analyseren, gebruikt daar vaak of altijd AI voor.
Ongeveer 9 op de 10 van degenen die AI gebruiken voor analyse, deskresearch of coderen, zei dat het werk er sneller van werd.
54% noemde zorgen over de kwaliteit van de output als drempel, de meest genoemde.
Van 149 negatieve opmerkingen kwamen onbetrouwbare output en de last om die te controleren het vaakst voor, in 40.
61% had AI nog nooit gebruikt om gebruikers te interviewen.
NN/g beschrijft dit als een gemakssteekproef, dus lees het als een richting en niet als een marktschatting. De richting is duidelijk: professionals gebruiken AI voor analyse omdat het sneller is, en besteden de bespaarde tijd aan controleren.
Hoe voer je AI-onderzoekssynthese stap voor stap uit?
Vijf stappen. De eerste twee doe je voordat je een AI-tool opent; in de laatste twee laten mensen zien wat ze waard zijn.
1. Bepaal de beslissing voordat je gaat samenvatten
Schrijf de productbeslissing op waar het onderzoek input voor moet leveren. Bijvoorbeeld:
Moeten we de koppelflow bij de eerste start vereenvoudigen, of eerst uitleggen welke bron een gebruiker moet koppelen?
Zo voorkom je dat een brede prompt als "analyseer deze interviews" aantrekkelijke thema's oplevert die niet helpen bij de beslissing die voorligt. Het maakt het ook makkelijker om te merken wanneer het materiaal de vraag niet beantwoordt. Als je de beslissing niet kunt benoemen, ben je nog niet klaar om te synthetiseren; misschien zit je nog in de fase van het productdiscoveryproces waarin je bepaalt wat je wilt leren.
2. Bereid het bronmateriaal verantwoord voor
Gebruik alleen materiaal dat je team in de gekozen AI-tool mag verwerken, binnen de toestemming die deelnemers gaven. Verwijder persoonlijke of gevoelige gegevens, tenzij je een duidelijke, goedgekeurde reden hebt om ze te bewaren; NN/g merkt op dat sommige onderzoekstools inmiddels automatisch namen, e-mailadressen en vergelijkbare identificatoren wissen (NN/g, 2024). Bewaar een bron-ID en datum zodat een reviewer het oorspronkelijke record kan vinden, en beperk tegelijk de toegang tot het onderliggende transcript.
Combineer geen notities van verschillende klantgroepen of onderzoeksvragen zonder labels. Een founderinterview, een supportticket en een geobserveerde usabilitysessie kunnen allemaal nuttig zijn; het is geen onderling uitwisselbaar bewijs. Label elk record met het type en het segment van de deelnemer voordat het model het ziet.
3. Laat AI ordenen, niet concluderen
Geef het model een afgebakende taak. Laat het:
observaties halen die relevant zijn voor de beslissing;
bij elke observatie een bron-ID en de exacte onderbouwende passage voegen;
directe uitspraken scheiden van afgeleide behoeften;
tegenvoorbeelden en tegenstrijdig bewijs opsommen;
ontbrekende context en vragen die het niet kan beantwoorden markeren;
herhaalde vermeldingen niet als onafhankelijke gebruikers tellen, tenzij de bronnen die telling ondersteunen.
Vraag niet om een definitieve persona, een marktbrede conclusie of een geprioriteerde roadmap op basis van een paar gesprekken. Een model kan onzekerheid uit beeld opmaken, tenzij je er specifiek om vraagt die te behouden. NN/g zag dat AI-clustering vaak items groepeert op gedeelde trefwoorden in plaats van gedeelde betekenis, dus behandel de eerste clusters als sorteerhulp (NN/g, 2024).
4. Controleer elke bewering die de roadmap kan veranderen
Een PM of founder moet voor elk voorgesteld thema met grote impact de oorspronkelijke bron openen. Kijk of het citaat de bewering ondersteunt, of de omringende context de betekenis verandert, en of het model de ervaringen van verschillende mensen heeft samengevoegd.
Zoek dan naar bewijs dat niet past. Als twee gebruikers hetzelfde symptoom om verschillende redenen beschrijven, bewaar dan beide verklaringen. Als één levendig verhaal de enige onderbouwing van een idee is, label het dan als een signaal om uit te zoeken en niet als een bewezen patroon.
Een praktische reviewtabel ziet er zo uit:
Voorgesteld thema
Onderbouwende bron
Wat is direct geobserveerd?
Interpretatie
Tegenbewijs of gat
Volgende stap
De bron bij de installatie is onduidelijk
Interview 04, sessienotitie
Persoon koppelde een ander account dan bedoeld
De labels van de keuze zijn mogelijk dubbelzinnig
Eén observatie; nog geen replay van de taak
Opname bekijken en begrip van de labels testen
Gebruikers willen een checklist
Interview 07, transcript
Persoon vroeg om een checklist nadat hij vastliep
Ze hebben misschien begeleiding nodig op het beslismoment
Het verzoek kan de voorkeur van deze persoon zijn
Vergelijken met supportcases en het eerste gebruik observeren
De tabel is bewust bescheiden. Ze maakt van twee gesprekken geen percentage en beweert niet dat "gebruikers" zich allemaal hetzelfde gedragen.
5. Leg de beslissing en de leertrigger vast
Zodra het team het bewijs heeft bekeken, leg je vast wat het besloot en waarom. Neem de beslissingseigenaar op, de onderbouwende bronnen, de belangrijkste onzekerheid en welk toekomstig bewijs de keuze zou veranderen. Een productbeslissingslogboek geeft dit een vaste plek.
Bijvoorbeeld:
Beslissing: Duidelijkere bronbeschrijvingen testen voordat we een volledige installatiechecklist bouwen.
Waarom: Twee onafhankelijke bronnen wijzen op onzekerheid bij de koppelkeuze, maar we hebben te weinig eerste-gebruiksessies geobserveerd om te weten of het probleem in de labels, de volgorde of ontbrekende begeleiding zit.
Reviewtrigger: Opnieuw bekijken na een aantal representatieve installatiesessies, of als supportmeldingen op een ander knelpunt wijzen.
De steekproef die je nodig hebt, hangt af van de beslissing, het risico en hoe gevarieerd je gebruikers zijn. Behandel een vast aantal interviews niet als bewijs van verzadiging of representativiteit. Als het bewijs gemengd blijft, is de volgende nuttige stap misschien nog een observatie in plaats van een gladdere samenvatting.
Welke prompt gebruik je voor AI-onderzoekssynthese?
Gebruik twee rondes: één om te ordenen, één om te helpen de controle te prioriteren. Deze eerste prompt kun je aanpassen voor een toegestane, passend beveiligde set bronnen:
Help me deze onderzoeksnotities te ordenen voor de beslissing: [beslissingsvraag]. Neem bij elke voorgestelde observatie het bron-ID en de exacte onderbouwende passage op. Scheid direct bewijs van interpretatie. Som tegenstrijdige voorbeelden, ontbrekende context en alternatieve verklaringen op. Leid geen frequentie af die verder gaat dan de aangeleverde records. Doe geen aanbeveling voor een roadmapbeslissing. Als een bewering niet met een passage kan worden onderbouwd, label die dan als onderbouwing ontbreekt. Geef een tabel terug met observatie, citaat, bron, interpretatie, reden voor het vertrouwen, tegenbewijs en vervolgvraag.
Draai daarna een tweede prompt over de output:
Som voor elk thema hierboven de afzonderlijke deelnemers (niet de vermeldingen) op die het ondersteunen, per bron-ID. Markeer elk thema dat door maar één deelnemer wordt ondersteund, elk citaat dat je niet woordelijk in de bronnen kunt vinden, en elk thema dat deelnemers uit verschillende segmenten combineert.
De tweede ronde is geen verificatie. Een model dat zijn eigen werk controleert, kan zijn eigen fouten herhalen. Het is een manier om de thema's te sorteren zodat de menselijke controle bij de zwakste begint. Geen van beide prompts maakt de output op zichzelf betrouwbaar; samen maken ze die makkelijker te inspecteren.
Hoe controleer je een AI-synthese voordat die de roadmap bereikt?
Kopieer deze checklist naar je synthesedocument en vink hem af voordat een thema een ticket of PRD-regel wordt:
De beslissing waar deze synthese input voor levert, staat bovenaan.
Elk citaat is letterlijk: je hebt het transcript doorzocht en gevonden.
Elk thema vermeldt hoeveel verschillende mensen het ondersteunen, niet hoeveel vermeldingen.
Elk thema noemt het segment, de rol of de situatie van die mensen.
Tegenbewijs staat onder het thema dat het ter discussie stelt.
Beweringen over waarom mensen iets doen of hoe ze zich voelen zijn als interpretatie gemarkeerd.
Thema's die op één persoon rusten, zijn gelabeld als signalen om uit te zoeken.
Ontbrekende stemmen zijn genoteerd: met wie je niet hebt gesproken.
Uitgewerkt voorbeeld: een synthese in een uur controleren
Dit voorbeeld is illustratief. Stel dat een team van vijf mensen 8 onboardinginterviews heeft, ongeveer 6 uur aan opnames, plus 40 supporttickets. GOV.UK stelt ongeveer 1 uur analyse voor per 2 uur onderzoek (GOV.UK), dus een handmatige ronde over alleen de gesprekken kost grofweg 3 uur. NN/g adviseert minstens evenveel tijd voor analyse te reserveren als voor het verzamelen, wat meer zou zijn (NN/g, 2022).
De AI-ronde duurt 10 minuten en stelt 7 thema's voor, onderbouwd met 31 citaten. De PM controleert alleen de 3 thema's die de volgende sprint kunnen veranderen: 14 citaten, ongeveer 45 minuten lezen. Ze ontdekt dat 2 citaten geparafraseerd zijn in plaats van letterlijk. Eén thema, "gebruikers willen een checklist", rust op 2 mensen die om verschillende dingen vroegen. Een ander, "de bron bij de installatie is onduidelijk", houdt stand in 5 van de 8 interviews en 9 tickets.
Alleen dat laatste thema komt in het beslissingslogboek, met de 2 checklistverzoeken als open vraag. De totale tijd is ongeveer een uur, en elke bewering die de roadmap haalt, is door een mens in de bron gelezen. Voor dezelfde discipline bij door AI geschreven specs, zie de claimtrace tegen spec-hallucinatie.
Welke synthesetaken geef je aan AI, en welke houd je zelf?
Taak
Aan AI geven?
Waarom
Menselijke controle
Transcriptie
Ja
Volwassen en snel
Namen, jargon en door elkaar praten steekproefsgewijs controleren
Persoonsgegevens verwijderen
Ja, met review
Bespaart een saaie stap
Bevestigen dat er niets identificerends overblijft
Vermeldingen zijn geen mensen; steekproeven zijn klein
Gebruik analytics of een survey voor prevalentie
Usabilitysessies analyseren op basis van transcripten
Nee
Transcripten missen wat gebruikers deden (NN/g, 2023)
De opname bekijken
Aanbevelen wat je moet bouwen
Nee
Het model mist strategie en afwegingen
Het team beslist
Eerder onderzoek doorzoeken
Ja
Goed voor "wat zeiden klanten over X?"
De bron openen voordat je citeert
Wat zijn veelgemaakte fouten bij AI-onderzoekssynthese?
Een vloeiende samenvatting als bevinding behandelen. Gladheid is geen bewijs. Een thema is pas een bevinding nadat iemand de bronnen heeft gelezen.
Vermeldingen als mensen tellen. Eén gefrustreerde klant die een probleem vijf keer noemt, is één datapunt, geen vijf.
Segmenten door elkaar halen. Een solo founder en een team van 50 mensen kunnen hetzelfde symptoom om verschillende redenen beschrijven. Middelen verzint een gebruiker die niet bestaat.
Tegenvoorbeelden laten vallen. Modellen lossen spanning graag op in een nette verhaallijn. Vraag expliciet om tegenstrijdigheden en houd ze zichtbaar.
De samenvatting de bron laten vervangen. Houd het transcript of ticket bij elke bewering één klik weg, anders kan niemand de interpretatie later nog betwisten.
Te laat synthetiseren. Inzichten verouderen. Teams die continuous discovery doen, synthetiseren een paar interviews tegelijk, terwijl de context vers is.
AI kan ook een dunne of vertekende steekproef niet repareren. Als je alleen met je tevredenste klanten hebt gesproken, is een perfecte synthese van die gesprekken nog steeds een synthese van je tevredenste klanten. Betere vragen helpen; ons klantinterviewtemplate richt zich op recent gedrag in plaats van meningen.
Waar Specky past
Specky leest klantgesprekken, feedback, Slack, Jira en analytics in een Product Graph en schrijft daarna specs en tickets met inline citaten terug naar het bewijs, zodat een reviewer de bron achter elke bewering kan openen. Alex, de onderzoeksagent van Specky, voert klantinterviews uit via een deelbare link, zodat onderzoek niet op agenda's hoeft te wachten. De regel uit deze gids blijft gelden: een citaat maakt een bewering controleerbaar, niet waar. Iemand in het team leest nog steeds de bron voordat de bewering de roadmap bereikt.
Veelgestelde vragen
Kan AI klantonderzoek zelfstandig synthetiseren?
Nee. AI kan veel sneller dan een mens transcriberen, citaten halen en thema's voorstellen, maar gepubliceerde vergelijkingen laten zien dat het slechts op 36–47% van de afzonderlijke codes en ongeveer 30% van de interpretatieve thema's overeenkomt met menselijke coders. Gebruik het voor de eerste ronde en laat daarna iemand die het product en de klanten kent elk thema controleren dat een beslissing kan veranderen.
Hoe nauwkeurig is AI-thematische analyse vergeleken met mensen?
Dat hangt af van het soort thema. ChatGPT-4 kwam in een studie uit 2025 op meer dan 80% van de beschrijvende thema's overeen met menselijke onderzoekers, maar op slechts ongeveer 30% van de thema's die culturele of emotionele interpretatie vereisten. Een studie uit 2024 vond dat AI 71% van de inductieve thema's van mensen haalde. Verwacht een goede recall van voor de hand liggende onderwerpen en een zwak oordeel over betekenis.
Hoe voorkom je dat AI citaten verzint?
Eis voor elke observatie een bron-ID en de exacte passage, en laat het model alles wat het niet kan onderbouwen als onderbouwing ontbreekt labelen. Zoek daarna in het transcript naar elk citaat dat een thema met grote impact onderbouwt. NN/g zag dat sommige AI-onderzoekstools citaten toeschreven zonder de sessie of tijdstempel te noemen, waardoor deze controle onmogelijk is; kies dus tools die hun bronnen vermelden.
Is het veilig om klantinterviews naar een AI-tool te uploaden?
Alleen als deelnemers toestemming hebben gegeven voor die verwerking en je organisatie de tool heeft goedgekeurd voor dit soort data. Verwijder namen, e-mailadressen en andere identificatoren die je niet nodig hebt, controleer waar de tool data opslaat en verwerkt, en beperk wie de ruwe transcripten mag zien. Onder de AVG zijn interviewopnames en transcripten persoonsgegevens zodra een deelnemer identificeerbaar is.
Hoeveel interviews heb je nodig voordat AI-synthese nuttig is?
AI helpt al vanaf het eerste interview, bij transcriptie en het halen van observaties. Thema's over interviews heen vragen meerdere gesprekken over dezelfde beslissing voordat een patroon het controleren waard is. Het juiste aantal hangt af van hoe gevarieerd je gebruikers zijn en hoe riskant de beslissing is. Interviews verklaren waarom iets gebeurt; gebruik analytics of een survey om te weten hoe vaak.
GDPR-aligned. EU workspace data is stored in Frankfurt, Germany. GDPR and EU data Built in Vienna, Austria. A product of influence solutions fm GmbH (FN 675374y). Imprint 14-day trial. Card required, and nothing is charged until day 14. 30-day refund after subscribing. See pricing