9 listopada 2026Zaktualizowano Fathy Shalaby12 min czytania
Szablon planu testu A/B: testuj jedną zmianę i nazwij metrykę
Większość testów A/B psuje się, zanim się zacznie. Zmień jedną rzecz, najpierw nazwij metrykę, policz wielkość próby i nie podglądaj wyników.
Udostępnij
Ten artykuł został przetłumaczony z języka angielskiego. Przeczytaj oryginał
Szablon planu testu A/B to jednostronicowy plan, który wypełniasz przed testem podzielonym: jedna zmiana, metryka główna, metryka ochronna (guardrail), wielkość próby i data zakończenia. Test podzielony pokazuje potem tę zmianę losowej części prawdziwego ruchu i porównuje metrykę, którą nazwałeś przed startem. Napisz plan najpierw, bo większość testów podzielonych psuje się jeszcze przed uruchomieniem.
Najważniejsze wnioski
Większość pomysłów przegrywa. Skuteczność pomysłów w Bingu wynosiła około 10-20%, a zwycięzcy zmieniali kluczowe metryki o 0,1% do 1,0% (Kohavi et al., KDD 2014).
Policz wielkość próby przed startem. Przy konwersji 12% wykrycie względnego wzrostu o 10% wymaga około 11 700 użytkowników na wersję przy 95% ufności i 80% mocy (kalkulator Evana Millera).
Nie podglądaj. Testowanie po każdym odwiedzającym i zatrzymanie przy pierwszym „istotnym” wyniku podnosi odsetek fałszywych alarmów z 5% do 26,1% (Evan Miller, 2010).
Nazwij jedną metrykę ochronną, czyli taką, która nie może się pogorszyć.
Czym jest test podzielony?
Test podzielony zmienia jedną rzecz dla części Twojego prawdziwego ruchu i porównuje metrykę, którą nazwałeś, zanim test się zaczął.
To to samo co test A/B: wersja A to oryginał (kontrola), wersja B ma zmianę, a ludzie są przydzielani losowo. Ponieważ zmiana jest jedyną systematyczną różnicą, wyraźna różnica w metryce wskazuje na tę zmianę.
W książce Testing Business Ideas Davida J. Blanda i Alexa Osterwaldera test podzielony to eksperyment walidacyjny typu „wezwanie do działania”, obok testu strony docelowej i przedsprzedaży. Plakat Strategyzer ocenia go na 2 z 5 pod względem kosztu, 3 z 5 pod względem czasu trwania i 3 z 5 pod względem siły dowodu (biblioteka eksperymentów Strategyzer).
Kiedy przeprowadzać test podzielony, a kiedy nie?
Użyj go, gdy masz dość ruchu i chcesz wiedzieć, czy konkretna zmiana spowodowała wynik. To najpewniejszy sposób, żeby na to odpowiedzieć. Może też zaskoczyć. W artykule z 2017 roku w Harvard Business Review małej zmiany w sposobie wyświetlania nagłówków reklam w Bingu, która dała tak mocne wyniki, że uruchomiła wewnętrzny alarm, bo wyglądały zbyt dobrze, by były prawdziwe. Pomysł leżał w backlogu ponad sześć miesięcy. Podniósł przychody o 12%, co było warte ponad 100 milionów dolarów rocznie tylko w USA.
Ta historia to wyjątek. W artykule z 2014 roku Kohavi i współpracownicy napisali, że większość eksperymentów w Bingu kończy się porażką, a wyjątkowo mocne wyniki wymagają stosowania prawa Twymana: „Any figure that looks interesting or different is usually wrong!”
Nie używaj go przy małym ruchu. Jeśli do dotarcia do wystarczającej liczby osób potrzebowałbyś wielu miesięcy, użyj testu użyteczności albo wywiadów. Nie używaj go do eksploracji. Porównuje tylko opcje, które już masz. Więcej znajdziesz w naszym dłuższym przewodniku po testach A/B dla product managerów.
Jakie ryzyko testuje i jak mocny jest dowód?
Testuje atrakcyjność (desirability): czy ta wersja sprawia, że ludzie robią więcej tego, czego chcesz? Dowodem jest zachowanie prawdziwych ludzi, którzy nie wiedzą, że biorą udział w teście. Mierzy to, co dzieje się w okresie testu, więc może przeoczyć efekty długoterminowe. Zobacz nasz przewodnik po wyborze eksperymentu produktowego.
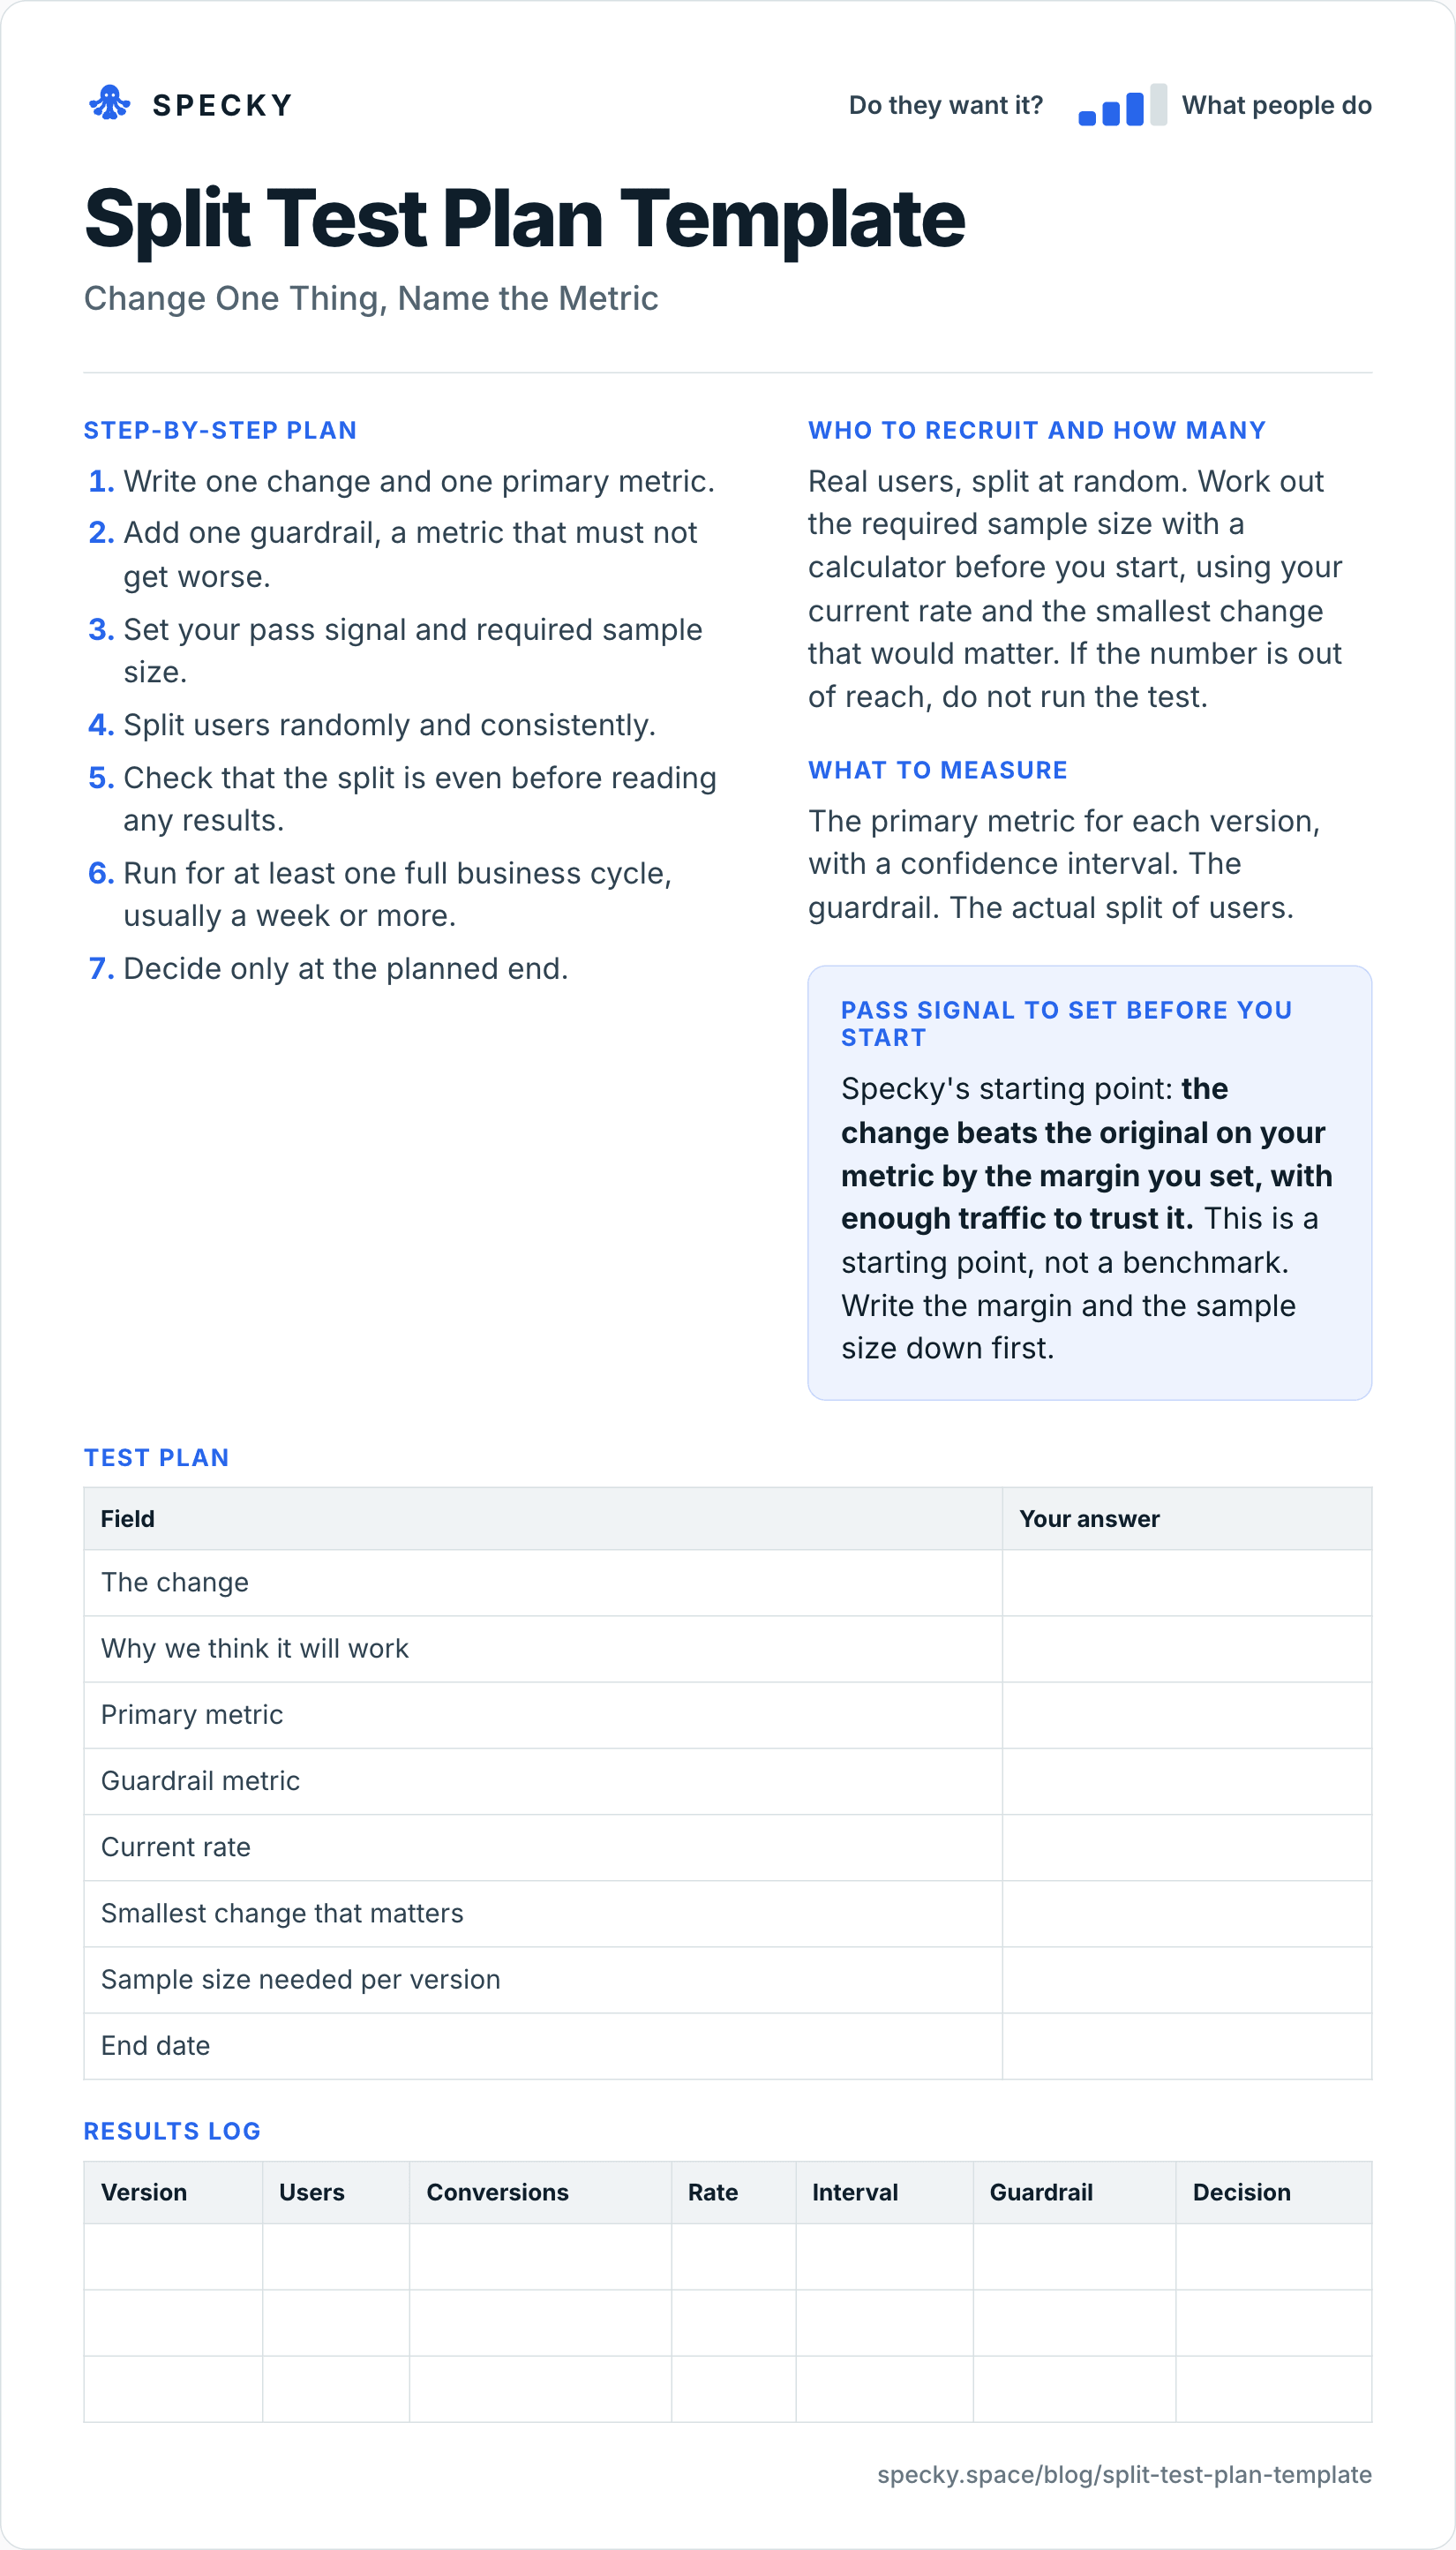
Szablon planu testu A/B (skopiuj i używaj)
Otwórz obraz w pełnym rozmiarze albo skopiuj wersję tekstową poniżej.
Kogo rekrutować i ilu osób
Prawdziwych użytkowników, podzielonych losowo. Wylicz wymaganą wielkość próby kalkulatorem przed startem, na podstawie obecnego wskaźnika i najmniejszej zmiany, która miałaby znaczenie. Jeśli ta liczba jest poza zasięgiem, nie przeprowadzaj testu.
Plan krok po kroku
Zapisz jedną zmianę i jedną metrykę główną.
Dodaj jedną metrykę ochronną, czyli taką, która nie może się pogorszyć.
Ustal sygnał zaliczenia i wymaganą wielkość próby.
Dziel użytkowników losowo i konsekwentnie.
Sprawdź, czy podział jest równy, zanim przeczytasz jakiekolwiek wyniki.
Prowadź test przez co najmniej jeden pełny cykl biznesowy, zwykle tydzień lub dłużej.
Decyduj dopiero w planowanym terminie zakończenia.
Plan testu
Pole
Twoja odpowiedź
Zmiana
Dlaczego uważamy, że zadziała
Metryka główna
Metryka ochronna
Obecny wskaźnik
Najmniejsza zmiana, która ma znaczenie
Potrzebna wielkość próby na wersję
Data zakończenia
Co mierzyć
Metrykę główną dla każdej wersji, z przedziałem ufności. Metrykę ochronną. Rzeczywisty podział użytkowników.
Sygnał zaliczenia do ustalenia przed startem
Punkt wyjścia Specky: zmiana pokonuje oryginał w Twojej metryce o ustalony margines, przy wystarczającym ruchu, żeby mu zaufać. To punkt wyjścia, a nie benchmark. Najpierw zapisz margines i wielkość próby.
Dziennik wyników
Wersja
Użytkownicy
Konwersje
Wskaźnik
Przedział
Metryka ochronna
Decyzja
Ilu użytkowników potrzebujesz do testu A/B?
Zależy to od Twojej obecnej konwersji i najmniejszej zmiany, którą warto wykryć, czyli minimalnego wykrywalnego efektu. Im mniejsze któreś z nich, tym więcej ruchu potrzebujesz. Według dwustronnego wzoru z darmowego kalkulatora Evana Millera, przy jego standardowej istotności 5% i mocy 80%, potrzebna próba na wersję wygląda tak:
Obecna konwersja
Aby wykryć względny wzrost o 5%
Względny wzrost o 10%
Względny wzrost o 20%
2%
około 310 000
około 78 000
około 19 800
5%
około 120 000
około 30 200
około 7700
12%
około 46 300
około 11 700
około 2900
20%
około 25 300
około 6300
około 1600
Zmniejszenie wykrywanego efektu o połowę mniej więcej czterokrotnie zwiększa potrzebny ruch, a niskie wskaźniki bazowe wymagają znacznie więcej osób niż wysokie.
Żeby sprawdzić bez kalkulatora, użyj reguły kciuka Evana Millera: n = 16σ² / δ², gdzie δ to minimalny efekt, a dla konwersji p mamy σ² = p(1 − p). Przy 12% i wzroście do 13,2%: 16 × 0,12 × 0,88 ÷ 0,012² ≈ 11 700 na wersję.
Przykład krok po kroku: od wielkości próby do daty zakończenia
Ten przykład jest ilustracyjny; odpowiada przykładowi opisanemu niżej.
Obecny wskaźnik: 12% odwiedzających się rejestruje.
Najmniejsza zmiana, która ma znaczenie: względny wzrost o 10%, z 12% do 13,2%.
Wielkość próby: około 11 700 na wersję, czyli około 23 400 odwiedzających łącznie.
Ruch: około 860 odwiedzających dziennie trafia na stronę rejestracji.
Czas trwania: 23 400 ÷ 860 ≈ 27 dni. Zaokrąglone do pełnych tygodni: 4 tygodnie.
Gdyby wyszło sześć miesięcy, nie przeprowadzaj mniejszego testu w nadziei, że się uda. Przetestuj większą zmianę, wybierz metrykę z wyższym wskaźnikiem bazowym albo użyj metody wymagającej mniej ruchu.
Jak długo powinien trwać test podzielony?
Aż osiągniesz planowaną wielkość próby i przez co najmniej jeden pełny cykl biznesowy, zwykle tydzień lub dłużej, bo użytkownicy w dni robocze i w weekendy zachowują się inaczej.
Dlaczego nie powinieneś podglądać wyników?
Dashboardy pokazują wartość p, która zakłada, że patrzysz raz, na końcu. Każde dodatkowe spojrzenie to kolejna szansa, że szum przekroczy próg. Evan Miller pokazał, że testowanie po każdej obserwacji i zatrzymanie przy pierwszym p < 0,05 daje odsetek fałszywych alarmów 26,1%, ponad pięć razy więcej niż 5%, które Ci się wydaje, że masz (Evan Miller, 2010).
Jeśli musisz zajrzeć wcześniej, podnieś poprzeczkę: jeśli podglądasz 10 razy, potrzebujesz raportowanej istotności 1,0%, żeby zachować prawdziwy poziom 5%.
Dlaczego „istotny” wynik nadal wymaga sprawdzenia?
Kohavi i współpracownicy wyliczają to dokładnie. Jeśli jeden pomysł na trzy naprawdę jest zwycięzcą, średnia, którą podali dla eksperymentów w Microsoft, istotny wynik jest prawdziwym trafieniem w około 89% przypadków. Jeśli prawdziwe przełomy zdarzają się raz na 500, spada to do 3,1%. Zaskakujące wyniki wymagają powtórzenia.
Co mierzyć w teście podzielonym?
Metrykę główną dla każdej wersji, z przedziałem ufności, nie tylko jako procent.
Jedną metrykę ochronną, która nie może się pogorszyć, na przykład konwersję do płatności, zwroty albo czas ładowania strony.
Rzeczywisty podział użytkowników. Jeśli planowałeś 50/50, a przy dużych liczbach wychodzi 52/48, coś jest zepsute. To niezgodność proporcji próby (sample ratio mismatch). Sprawdzenie wymaga tylko oczekiwanych proporcji i zaobserwowanych liczb, a wychwytuje szeroką gamę problemów z danymi (narzędzie SRM Lukasa Vermeera i współpracowników). Nie czytaj wyników, dopóki go nie przejdzie.
Metryki ochronne dla rzadkich zdarzeń wymagają dużo ruchu: wykrycie spadku o 10% przy konwersji do płatności 1,2% wymaga z grubsza 130 000 użytkowników na wersję. Jeśli nie możesz tego osiągnąć, zapisz z góry, co oznacza naruszenie, na przykład „każdy spadek liczby płacących klientów blokuje wdrożenie”.
Test podzielony a test strony docelowej a test fałszywych drzwi
Czy ta zmiana powoduje więcej zachowań, których chcemy?
Czy ktoś robi następny krok dla tej oferty?
Czy obecni użytkownicy próbują użyć funkcji, której jeszcze nie zbudowano?
Porównanie
Kontrola kontra wariant, losowo
Zwykle jedna strona wobec celu
Jeden przycisk wobec celu
Dowód
Przyczynowy, behawioralny
Zainteresowanie behawioralne
Zainteresowanie behawioralne
Użyj testu strony docelowej lub fałszywych drzwi, żeby sprawdzić, czy w ogóle jest zainteresowanie; użyj testu podzielonego, żeby sprawdzić, która z dwóch wersji wypada lepiej.
Jak wygląda test podzielony w praktyce?
Ten przykład jest wymyślony, żeby pokazać metodę. Zespół prowadzący narzędzie do rozliczeń podatkowych chce skrócić formularz rejestracji z sześciu pól do trzech. Przewidują, że rejestracje wzrosną o co najmniej 10%, i ustawiają konwersję do płatności jako metrykę ochronną.
Po czterech tygodniach i 12 000 odwiedzających w każdej grupie krótszy formularz zwiększa rejestracje o 14%. Ale konwersja do płatności spada i metryka ochronna zostaje naruszona: dodatkowe rejestracje to osoby o niższej intencji, które nigdy nie kończą.
Cel rejestracji zostaje osiągnięty, a metryka ochronna zawodzi, więc nie wdrażają zmiany w tej postaci. Próbują krótszego formularza z jednym dodatkowym pytaniem o rodzaj rozliczenia klienta.
Tak mógłby wyglądać dziennik:
Wersja
Użytkownicy
Rejestracje
Wskaźnik
Płacący klienci
Decyzja
Sześć pól (kontrola)
12 000
1440
12,0%
144
Trzy pola
12 000
1642
13,7%
131
Nie wdrażać
Wzrost rejestracji jest realny: +1,7 punktu procentowego, z 95% przedziałem od mniej więcej +0,8 do +2,5. Spadek liczby płacących, ze 144 do 131 klientów, jest zbyt mały, by go udowodnić przy takim ruchu, ale wcześniej spisana reguła metryki ochronnej zespołu mówiła, że mniej płacących klientów blokuje wydanie.
Jakie są najczęstsze błędy w testach podzielonych?
Podglądanie. Sprawdzanie wcześnie i zatrzymanie, gdy wygląda dobrze, daje fałszywe wygrane.
Zmienianie kilku rzeczy naraz. Nie dowiesz się, która zadziałała.
Brak metryki ochronnej. Możesz wygrać metrykę i przegrać biznes.
Za mały ruch. Test o zbyt małej mocy to tylko drogi szum.
Ignorowanie efektu nowości. Ludzie klikają w nowe rzeczy tylko dlatego, że są nowe.
Kiedy to nie działa: przy małym ruchu, przy dużych zakładach, których nie da się podzielić, przy efektach, które potrzebują miesięcy, i tam, gdzie użytkownicy rozmawiają ze sobą, więc grupy nie są niezależne.
Czy etyczne jest przeprowadzanie testu podzielonego bez informowania użytkowników?
Zwykłe zmiany, takie jak krótszy formularz czy nowy nagłówek, rutynowo testuje się bez informowania każdego użytkownika. Granicą jest szkoda. Nie testuj niczego, czego nie czułbyś się swobodnie wdrożyć dla wszystkich, nie pokazuj różnych cen podobnym klientom bez jasnej polityki i licz tylko osoby, które Twój baner zgód pozwala śledzić.
Jak to przeprowadzić w Specky
Na stronie Assumptions kliknij notatkę i wybierz Pick a test, a potem Split test. Specky wypełnia kroki, sygnał zaliczenia i harmonogram na dwa tygodnie.
Przy zmianie wewnątrz produktu przeprowadź podział własnym narzędziem do feature flag lub eksperymentów. Specky nie zmienia Twojego produktu. Odczytuje liczby z podłączonej analityki, a Ty dołączasz wynik jako dowód.
Jeśli testujesz stronę walidacyjną Specky, podział może odbyć się tam. Ustaw jedną kontrolę i do pięciu wariantów w Experiment analytics, a Specky pokaże konwersję na wersję, 95% przedziały, czy masz dość osób, oraz opcjonalną metrykę ochronną. Werdykt pozostaje ostrożny, dopóki próba jest mała.
Kliknij Start running i zapisz wynik w planowanym terminie zakończenia.
Zaliczenie pojawia się na tablicy jako Supported, bo kontrolowane porównanie tego, co ludzie zrobili, to zachowanie.
Co zrobić z każdym wynikiem?
Supported: Wdróż zmianę. Zanotuj wielkość wygranej i za miesiąc ponownie sprawdź analitykę, żeby zobaczyć, czy efekt się utrzymuje.
Unclear: Wynik mieści się w marginesie błędu. Zostaw prostszą wersję albo dowiedz się, dlaczego, za pomocą kilku wywiadów.
Contradicted: Zmiana nie miała wpływu albo pogorszyła sytuację. Nie wdrażaj jej. Każdy zakład oparty na tej notatce pojawia się teraz jako Contradicted.
Najczęściej zadawane pytania
Ile ruchu potrzebujesz do testu podzielonego?
Zależy to od Twojej obecnej konwersji i najmniejszej zmiany, która miałaby znaczenie. Przy konwersji 12% wykrycie względnego wzrostu o 10% wymaga około 11 700 użytkowników na wersję przy standardowych ustawieniach; przy 2% około 78 000. Jeśli nie możesz osiągnąć tej liczby w rozsądnym czasie, użyj innej metody.
Dlaczego nie należy kończyć testu podzielonego przed czasem?
Zatrzymanie, gdy wyniki wyglądają dobrze, znacznie zwiększa szansę na fałszywe wygrane, bo wyniki na początku mocno się wahają. W najgorszym przypadku opisanym przez Evana Millera testowanie po każdym odwiedzającym daje odsetek fałszywych alarmów 26,1% zamiast 5%. Ustal z góry datę zakończenia i wielkość próby.
Czym jest metryka ochronna?
Metryka ochronna (guardrail) to liczba, która nie może się pogorszyć w trakcie testu, nawet jeśli Twoja główna metryka się poprawia, na przykład konwersja do płatności, zwroty albo szybkość strony. Chroni Cię przed wygraniem jednej metryki kosztem szkody dla biznesu. Zapisz regułę, co oznacza naruszenie, zanim test się zacznie.
Jaka jest różnica między testem podzielonym a testem A/B?
W praktyce żadna. Oba pokazują zmianę losowej części użytkowników i porównują jedną metrykę z grupą kontrolną; badacze nazywają to kontrolowanym eksperymentem online. Testowanie kilku zmian w kombinacji to test wielowymiarowy, który wymaga znacznie więcej ruchu.
GDPR-aligned. EU workspace data is stored in Frankfurt, Germany. GDPR and EU data Built in Vienna, Austria. A product of influence solutions fm GmbH (FN 675374y). Imprint 14-day trial. Card required, and nothing is charged until day 14. 30-day refund after subscribing. See pricing