9 listopada 2026Zaktualizowano Fathy Shalaby12 min czytania
Szablon analizy zgłoszeń do supportu: znajdź zadanie, którego użytkownicy nie mogą dokończyć
Twoja skrzynka supportu to badanie, za które już zapłacono. Otaguj zgłoszenia według zadań użytkowników, zweryfikuj spójność i zobacz, co boli najbardziej.
Udostępnij
Ten artykuł został przetłumaczony z języka angielskiego. Przeczytaj oryginał
Analiza zgłoszeń do supportu to dwudniowy desk research: tagujesz ostatnie 200 kontaktów ze wsparciem według zadania, które klient próbował dokończyć, zliczasz tickety na zadanie i sprawdzasz, co sprawia najwięcej problemów. Klienci opisali już swój problem – z własnej woli i ze znacznikiem czasu. Taki test pokazuje ból, a nie gotowość do płacenia, i pomija każdego, kto odszedł po cichu.
Najważniejsze wnioski
„Analiza zgłoszeń do działu obsługi klienta” (ang. Customer support analysis) to jeden z pięciu eksperymentów discovery opartych na analizie danych w książce Davida J. Blanda i Alexa Osterwaldera Testing Business Ideas (kurs UPV).
Taguj według zadania, a nie obszaru produktu. „Próba wysłania faktury do księgowej” mówi ci, co trzeba naprawić; etykieta „Płatności” nie mówi nic.
Automatyczne tagi w helpdesku stworzono do routingu. Automatyczne tagowanie w Zendesk dopasowuje słowa w nowym tickecie do już używanych tagów i dodaje trzy najpopularniejsze (Zendesk).
Sprawdź swoje tagi, zanim przejdziesz do liczenia. Niech druga osoba otaguje 20 ticketów – w literaturze metodologicznej zgodność na poziomie 80% uznaje się za akceptowalne minimum (McHugh, 2012).
Wyjściowy sygnał sukcesu w Specky: dane zadanie znajduje się w top 3 powodów, dla których ludzie się z wami kontaktują.
Czym jest analiza zgłoszeń do supportu?
Analiza zgłoszeń do supportu polega na otagowaniu ostatnich kontaktów z obsługą klienta pod kątem zadania, które klient próbował zrealizować, aby sprawdzić, co generuje najwięcej problemów. „Kontakty” obejmują każdy kanał: e-mail, czat, wiadomości w aplikacji, notatki z rozmów telefonicznych, a także forum pomocy, jeśli je prowadzisz.
To jeden z najtańszych sposobów na oszacowanie skali problemu w działającym produkcie, ponieważ praca związana z opisaniem trudności została już wykonana. Różnica w porównaniu z rutynowym raportowaniem supportu tkwi w etykiecie. Zespoły wsparcia tagują pod kątem routingu i obciążenia pracą; na potrzeby decyzji produktowych tagujesz pod kątem zadania i tego, co je zablokowało – w duchu koncepcji jobs to be done.
Kiedy warto stosować analizę zgłoszeń, a kiedy nie?
Stosuj ją, gdy masz działający produkt i wystarczająco dużo kontaktów, by było co liczyć. To jeden z najtańszych sposobów na określenie wagi problemu, ponieważ klienci powiedzieli ci o nim sami z siebie i zostawili dokładny znacznik czasu.
Nie stosuj jej:
Dla produktu z garstką użytkowników. Dziesięć ticketów nie wystarczy, by cokolwiek uszeregować.
Do badania ludzi, którzy odeszli po cichu. Oni po prostu nie piszą do supportu.
Do odpowiedzi na pytania o pieniądze. Stos ticketów pokazuje ból, a to coś innego niż chęć zapłaty. Do tego celu lepiej wykorzystać test intencji zakupu z fałszywym zakupem.
Jakie ryzyko testuje ta metoda i jak mocne są dowody?
Ten eksperyment weryfikuje pożądalność (desirability): który problem doskwiera prawdziwym klientom najbardziej? Zebrane dowody mają charakter kierunkowy. Wynikają z realnych zachowań, bo ludzie zadali sobie trud, by napisać. Jednak sam wolumen zgłoszeń nie mówi ci, ile warta jest naprawa problemu. W naszym przewodniku po wyborze eksperymentu produktowego wyjaśniamy, jak interpretować ten poziom dowodów.
Gotowy do skopiowania szablon analizy zgłoszeń do supportu
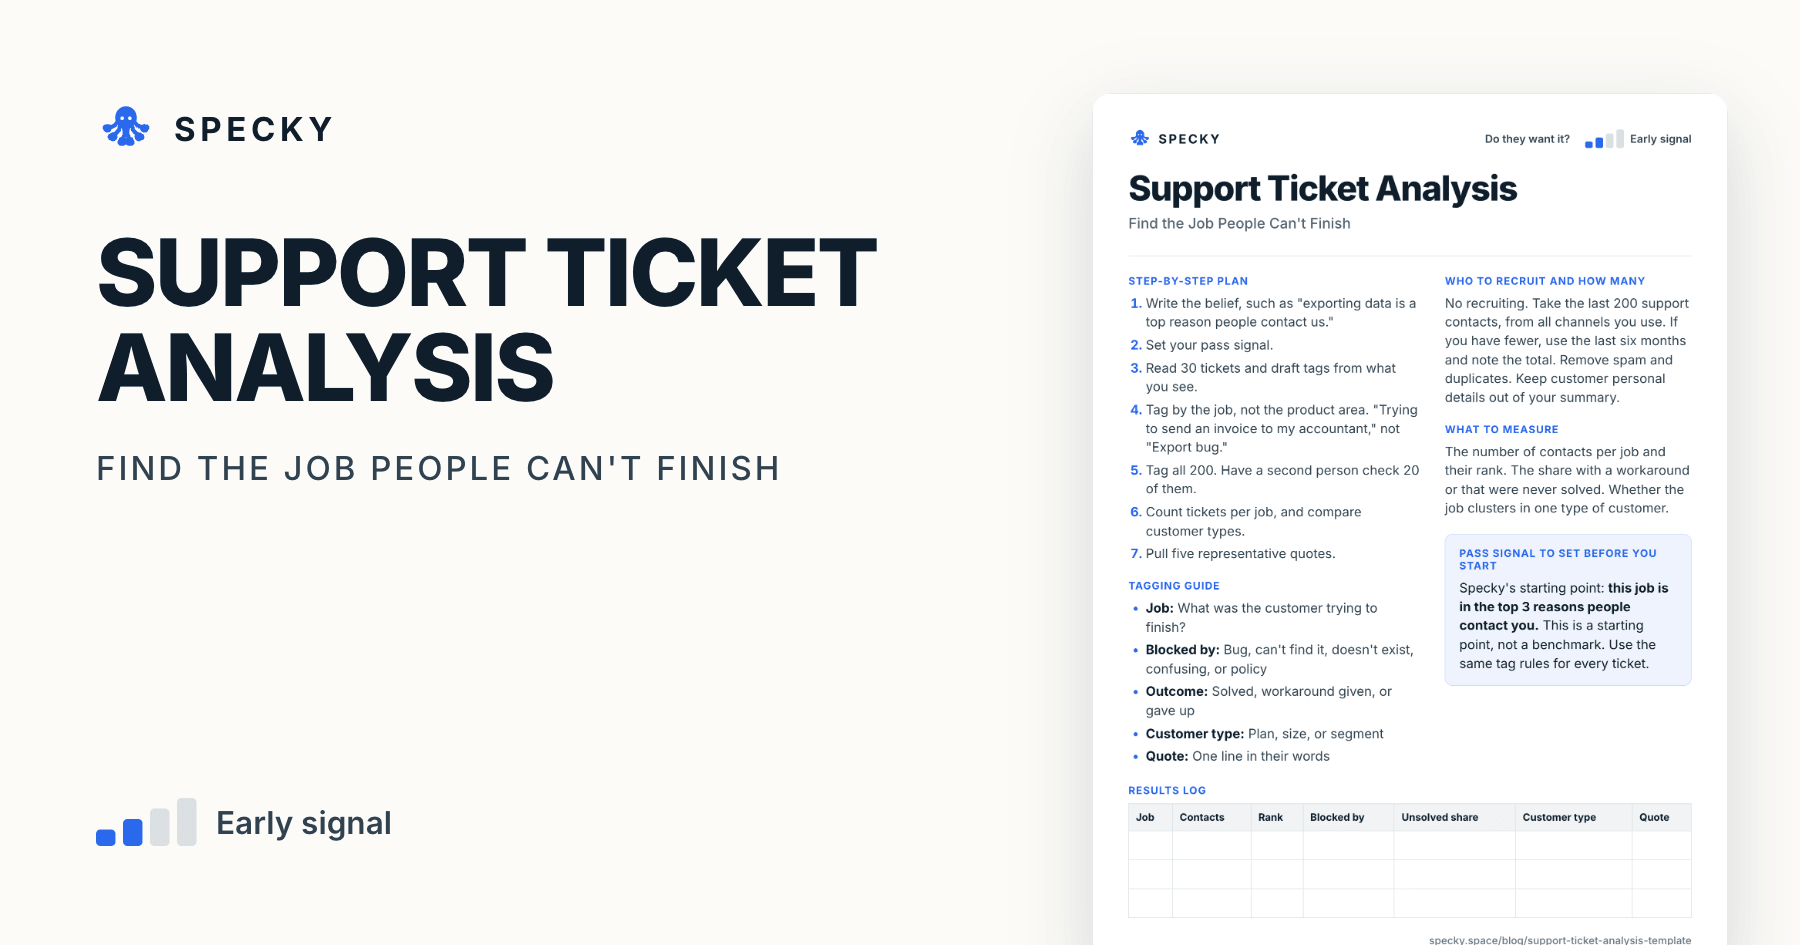
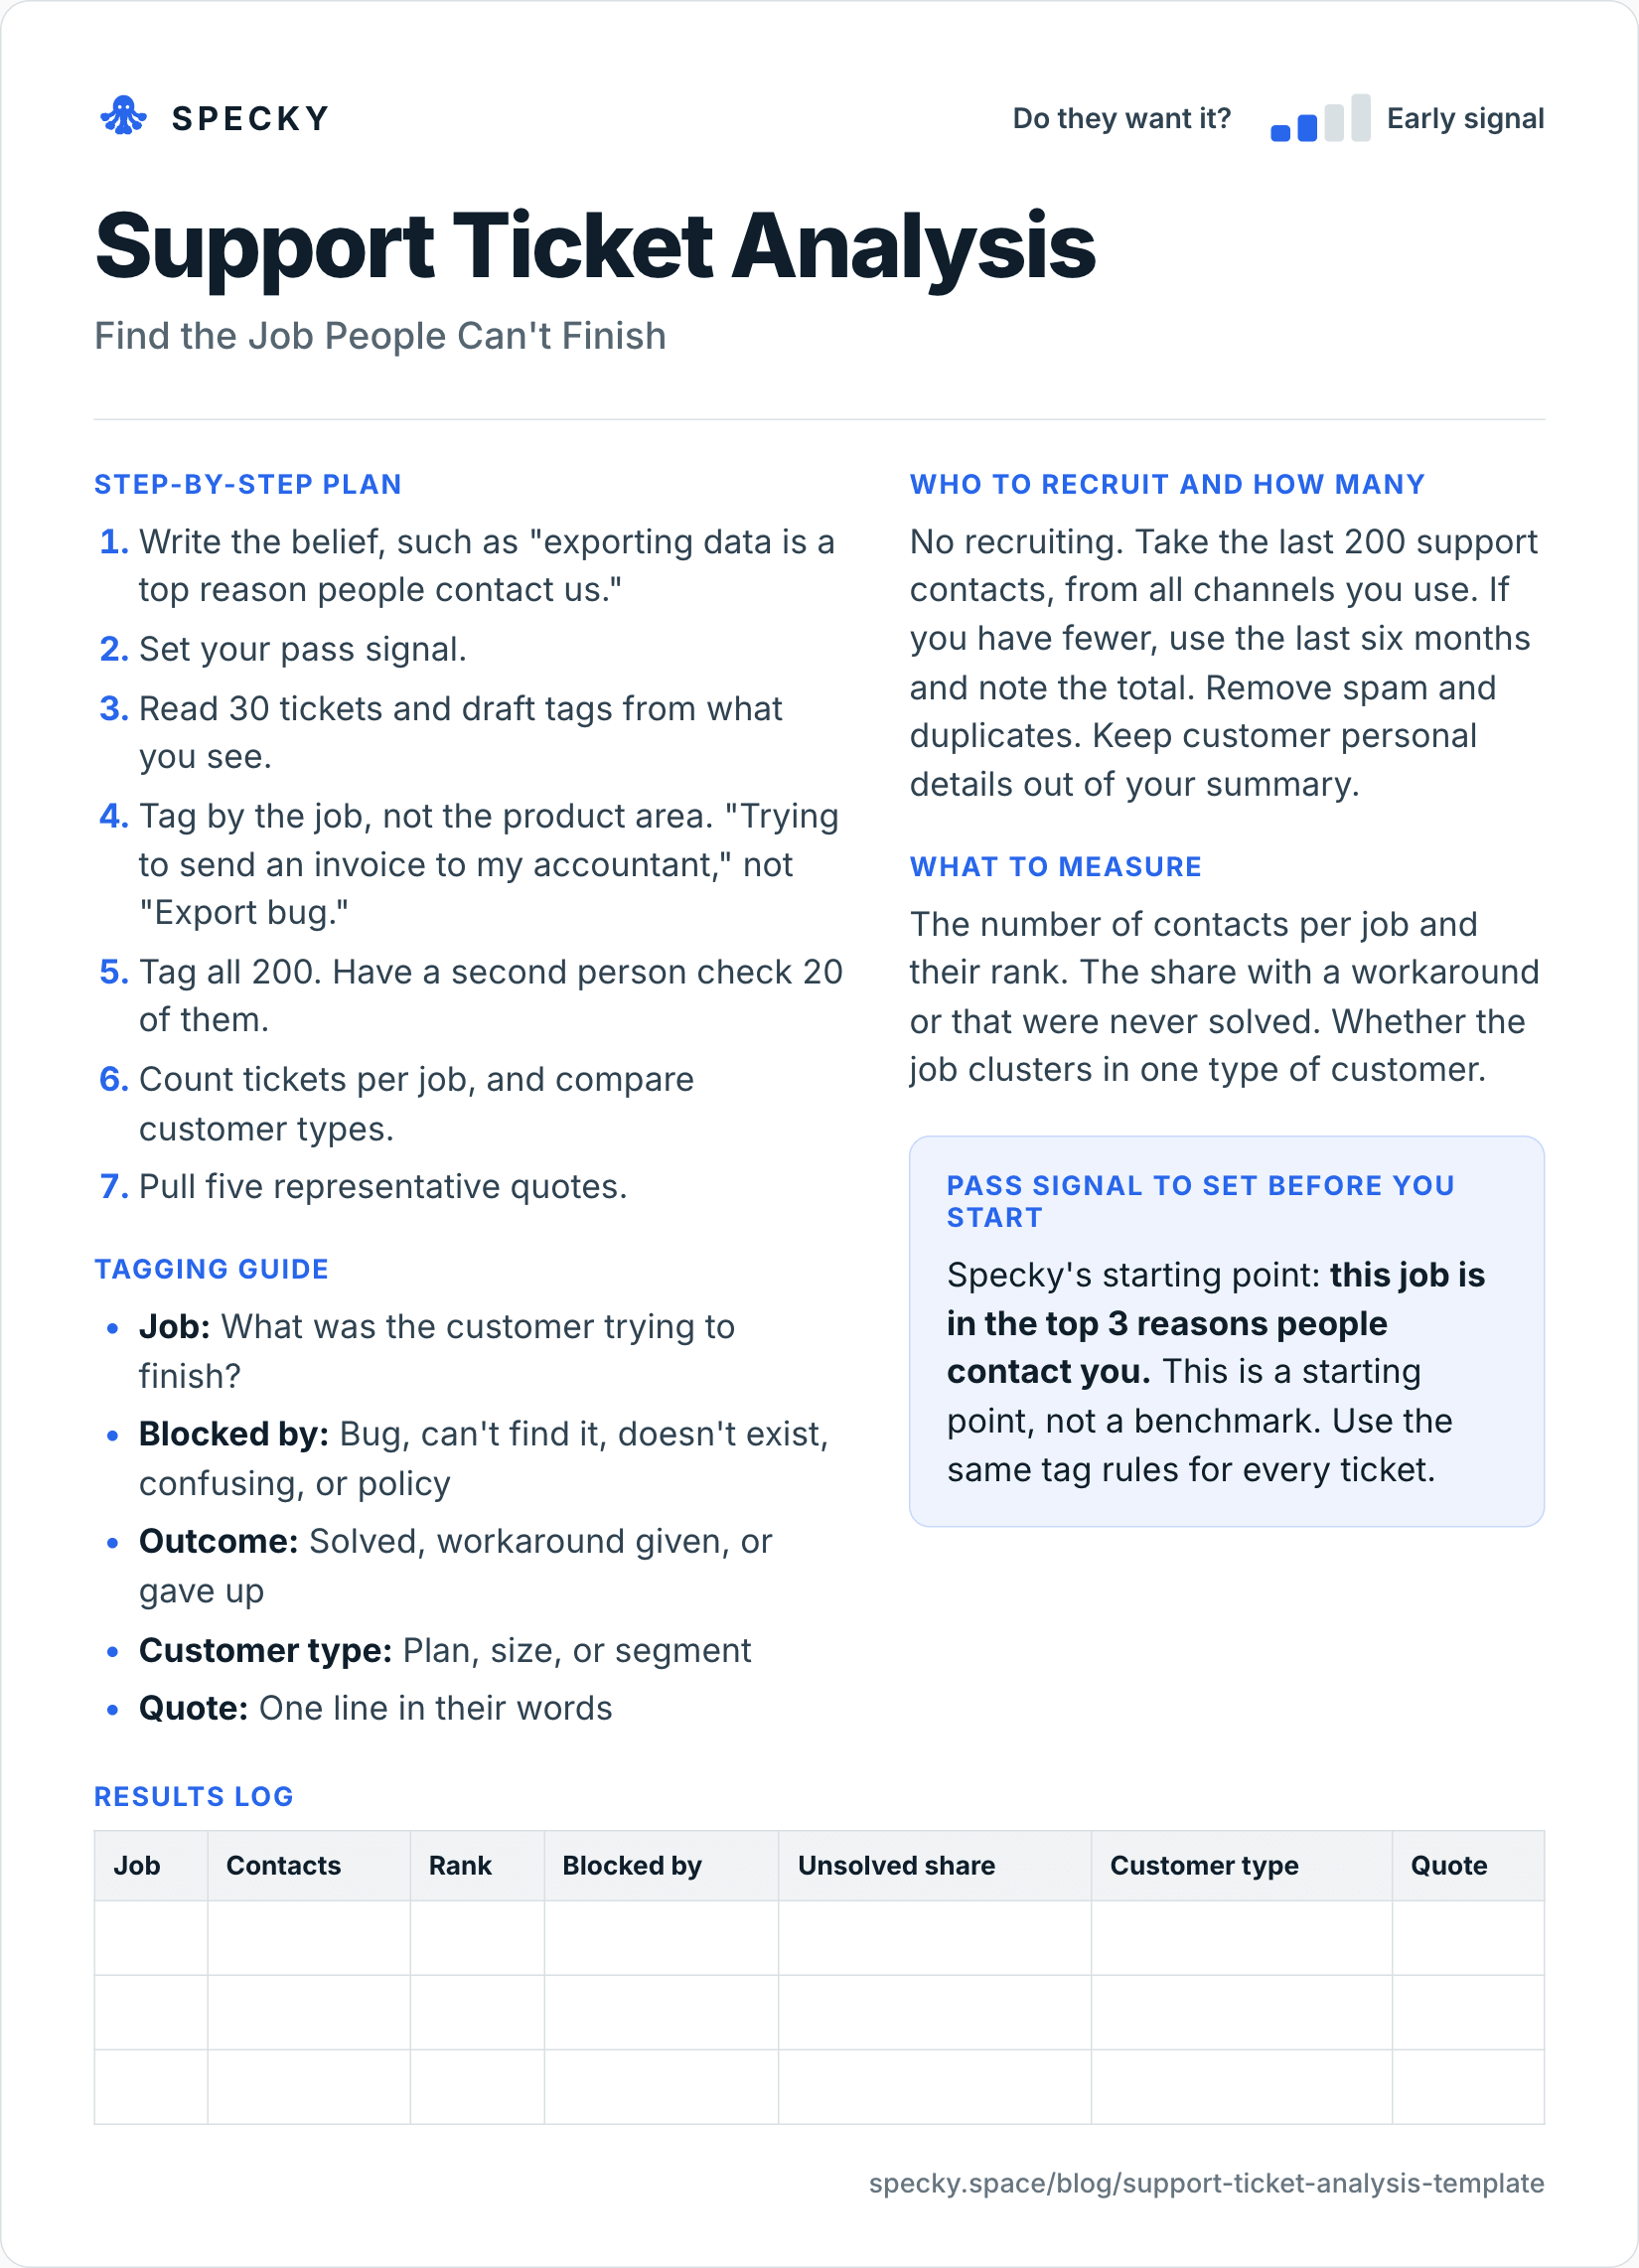
Otwórz grafikę w pełnym rozmiarze lub skopiuj poniższą wersję tekstową.
Kogo rekrutować i w jakiej liczbie
Bez rekrutacji. Weź ostatnie 200 kontaktów do supportu ze wszystkich kanałów, z których korzystasz. Jeśli masz ich mniej, sięgnij po zgłoszenia z ostatnich sześciu miesięcy i zanotuj łączną liczbę. Usuń spam i duplikaty. W podsumowaniu nie umieszczaj danych osobowych klientów.
Plan krok po kroku
Zapisz założenie, na przykład: „eksport danych to jeden z głównych powodów kontaktu z supportem”.
Ustal swój sygnał sukcesu.
Przeczytaj 30 ticketów i na tej podstawie stwórz wstępne tagi.
Taguj według zadania, a nie obszaru produktu. „Próba wysłania faktury do księgowej”, a nie „Błąd eksportu”.
Otaguj wszystkie 200 zgłoszeń. Poproś drugą osobę o niezależne sprawdzenie 20 z nich.
Zlicz tickety przypadające na dane zadanie i porównaj typy klientów.
Wybierz pięć reprezentatywnych cytatów.
Przewodnik po tagowaniu
Zadanie (Job): Co klient próbował zrobić/dokończyć?
Blokada (Blocked by): Bug, nie można znaleźć, funkcja nie istnieje, niejasne lub polityka firmy
Rezultat (Outcome): Rozwiązane, podano obejście (workaround) lub klient zrezygnował
Typ klienta: Plan, wielkość konta lub segment
Cytat: Jedno zdanie sformułowane słowami klienta
Co mierzyć
Liczbę kontaktów przypadających na zadanie i ich pozycję w rankingu. Odsetek spraw zakończonych obejściem lub nierozwiązanych. Występowanie problemu częściej u jednego typu klientów.
Sygnał sukcesu do ustalenia przed startem
Punkt wyjścia w Specky: to zadanie znajduje się w top 3 powodów, dla których ludzie kontaktują się z supportem. To propozycja startowa, a nie uniwersalny benchmark. Stosuj te same reguły tagowania do każdego ticketu.
Rejestr wyników
Zadanie
Liczba kontaktów
Pozycja
Blokada
% nierozwiązanych
Typ klienta
Cytat
Jak stworzyć rzetelny schemat tagowania ticketów?
Zanim otagujesz całe 200 zgłoszeń, przygotuj krótki słownik kodowy (tzw. codebook). Przewodnik Nielsen Norman Group po analizie tematycznej zaleca, by każdy kod miał nazwę, opis oraz przykłady wypowiedzi, które do niego pasują i nie pasują – co jest kluczowe, gdy koduje więcej niż jedna osoba (Nielsen Norman Group).
Praktyczny zestaw reguł dla ticketów wsparcia:
Pole
Zasada
Przykład pasujący
Przykład niepasujący
Zadanie
Fraza czasownikowa zrozumiała dla klienta
„Zwrot zaliczki dla klienta”
„Płatności”
Blokada
Dokładnie jedna z pięciu wartości
„Nie można znaleźć”: opcja istnieje, ale użytkownik jej nie odszukał
„Problem z UX”
Rezultat
Rozwiązane, podano obejście lub rezygnacja
„Support zwrócił środki ręcznie” = obejście
„Zamknięte”
Typ klienta
Pobrany z danych konta, a nie zgadywany
„Plan: Team, 6 stanowisk”
„Wygląda na dużego klienta”
Cztery zasady dbające o wiarygodność liczb:
Stwórz wstępne tagi na bazie 30 ticketów, a potem zamknij listę. Celuj w około 8 do 15 zadań. Przy większej liczbie nikt nie taguje spójnie.
Dbaj o to, by kategoria „Inne” była mała. Jeśli ląduje tam więcej niż co dziesiąte zgłoszenie, na liście brakuje ważnego zadania.
Jedno zadanie na ticket. Jeśli ticket porusza dwie kwestie, otaguj tę, od której klient zaczął, a drugą odnotuj na boku.
Taguj cały wątek, a nie tylko pierwszą linijkę. Prawdziwe zadanie często ujawnia się dopiero w drugiej lub trzeciej wiadomości.
Jak sprawdzić, czy twoje tagowanie jest wiarygodne?
Poproś drugą osobę o otagowanie 20 z 200 ticketów za pomocą tego samego słownika kodowego, bez wglądu w twoje oznaczenia. Policz tickety, w których oboje wybraliście to samo zadanie. Ten udział to wasza zgodność procentowa (percent agreement).
W artykule Mary McHugh z 2012 roku na temat rzetelności sędziowskiej (inter-rater reliability) wskazano, że wiele publikacji uznaje 80% zgodności za akceptowalne minimum, wyjaśniając zarazem, dlaczego statystyka kappa Cohena (uwzględniająca przypadkową zbieżność) daje zazwyczaj niższy wynik (McHugh, 2012). Na potrzeby dwudniowego testu produktowego zgodność procentowa jest wystarczająca: 16 na 20 zgłoszeń to 80%.
Jeśli uzyskacie niższy wynik, nie kłóćcie się o każdy pojedynczy ticket. Zidentyfikujcie dwa zadania, które myliły się wam najczęściej, przepiszcie ich definicje, dodając po jednym pasującym i niepasującym przykładzie, i otagujcie te zgłoszenia ponownie.
Czy warto ufać autotagom z narzędzi typu Zendesk lub Intercom?
Potraktuj je jako listę wyjściową, a nie gotowy wynik. Oba narzędzia zostały stworzone do routingu i rozliczania pracy supportu, co widać po ich kategoriach.
Tagi w Zendesk to słowa kluczowe dodające ticketom kontekst na potrzeby widoków, wyszukiwania, reguł biznesowych i raportów (Zendesk). Automatyczne tagowanie skanuje opisy nowych zgłoszeń pod kątem słów dłuższych niż dwa znaki, porównuje je z już używanymi tagami i dodaje trzy najlepiej pasujące, na przykład w celu routingu zgłoszeń (Zendesk). To dopasowywanie słów kluczowych w pierwszej wiadomości, a nie zrozumienie zadania użytkownika.
Inteligentna segregacja w Zendesk (intelligent triage) przewiduje temat, sentyment w pięciostopniowej skali oraz język (około 150 języków) na podstawie tematu ticketu i pierwszego publicznego komentarza, przypisując każdemu polu poziom pewności (Zendesk).
Intercom rozdziela trzy mechanizmy: tematy rozmów (conversation topics), które działają automatycznie i obejmują też minione konwersacje; atrybuty danych, które są ustrukturyzowane i mogą być wymagane przed zamknięciem wątku; oraz tagi, które oznaczają konkretne odpowiedzi i są nakładane ręcznie przez zespół lub reguły Workflows. Sam Intercom zaleca ich łączenie (Intercom).
Topics Explorer w Intercomie grupuje rozmowy za pomocą sztucznej inteligencji, a nie słów kluczowych. Po włączeniu analizuje ostatnie 90 dni, a potem aktualizuje się codziennie. Wymaga dodatku Pro i aktywnego bota Fin, nie ocenia sentymentu i może pominąć nietypowe rozmowy lub tematy o małym wolumenie (Intercom).
Praktyczny krok: wyeksportuj 200 kontaktów z dowolnymi istniejącymi tagami, zachowaj je w jednej kolumnie, a obok dodaj własne kolumny „Zadanie” i „Blokada”. Jeśli taka analiza wejdzie na stałe do twojego procesu, dodaj „Zadanie” jako pole wymagane przy zamykaniu ticketu – dzięki temu kolejna runda zajmie znacznie mniej czasu.
Przykładowa analiza (studium przypadku)
To hipotetyczny przykład obrazujący metodę. Zespół rozwijający aplikację do rezerwacji dla salonów kosmetycznych uważa, że głównym problemem są błędy synchronizacji kalendarza. Taguje ostatnie 200 kontaktów według zadania.
Synchronizacja kalendarza zajmuje dopiero ósme miejsce. W pierwszej trójce znalazły się: „zmiana terminu w imieniu klienta”, „zwrot zaliczki” oraz „dodanie drugiego pracownika”. Zadanie „zwrot zaliczki” wyróżnia się szczególnie: większość kontaktów kończyła się ręczną interwencją supportu.
Sygnał sukcesu dla synchronizacji kalendarza nie został osiągnięty. Zespół odnotowuje ten fakt i formułuje nowe założenie dotyczące samodzielnych zwrotów zaliczek przez użytkowników.
Liczby stojące za tym przykładem: po usunięciu 14 spamów i duplikatów zostało 200 ticketów. „Zmiana terminu w imieniu klienta” miała 34 zgłoszenia, „zwrot zaliczki” – 29, a „dodanie drugiego pracownika” – 22. Synchronizacja kalendarza miała 9. Spośród 29 kontaktów w sprawie zwrotu, 21 (72%) było zablokowanych przez status „funkcja nie istnieje” i wymagało ręcznego zwrotu przez konsultanta, a 18 pochodziło z salonów korzystających z dwóch najniższych planów. Druga osoba otagowała 20 ticketów i zgodziła się w 17 przypadkach (85%), więc ranking jest rzetelny.
Analiza zgłoszeń vs feedback od sprzedaży vs analiza analityki produktowej
Przeprowadź analizę zgłoszeń, aby zidentyfikować zadanie, a następnie weryfikację analityki produktowej, by sprawdzić, ile osób dociera do tego samego miejsca, nie pisząc do supportu. Jeśli potencjalni klienci wspominają o tym samym zadaniu przed podpisaniem umowy, feedback ze sprzedaży potwierdzi, że tracisz przez to nie tylko czas supportu, ale i deale.
Jakie są najczęstsze błędy w analizie zgłoszeń do supportu?
Tagowanie według obszaru produktu. Etykieta „Płatności” nic ci nie mówi. Dopiero zadanie podpowiada, co naprawić.
Analizowanie tylko ostatniego tygodnia. Jedno nieudane wdrożenie może zdominować cały tydzień.
Poleganie wyłącznie na automatycznych tagach z helpdesku. Stworzono je do routingu, a nie wyciągania wniosków produktowych.
Mylenie głośności z wartością biznesową. Najgłośniejsi klienci wcale nie muszą być twoimi najlepszymi klientami.
Zapominanie o tych, którzy milczą. Osoby, które zrezygnowały z produktu bez kontaktu z supportem, nie istnieją w tych danych.
Jak przeprowadzić to w Specky
Na stronie Assumptions kliknij notatkę, wybierz Pick a test, a następnie Customer support analysis. Specky uzupełni kroki, sygnał sukcesu i dwudniowy harmonogram.
Specky pobiera dane z podłączonych narzędzi. Jeśli masz zintegrowany system wsparcia (taki jak Zendesk, Intercom, Freshdesk czy Help Scout), poproś na czacie o pogrupowanie kontaktów według tego, co klient próbował osiągnąć. Przejrzyj te grupy samodzielnie – w końcu to tagowanie stanowi istotę testu.
Jeśli twoja skrzynka supportu nie jest połączona, otaguj wyeksportowany plik ręcznie i wklej zliczone dane.
Kliknij Start running, załącz liczby jako dowód i zarejestruj wynik.
Pozytywny wynik pojawi się na tablicy ze statusem Wczesny sygnał (Early signal), a nie Potwierdzone (Supported), ponieważ sam wolumen pokazuje ból, a nie gotowość do płacenia.
Co zrobić z każdym z wyników
Potwierdzone (jako Wczesny sygnał): Znasz już zadanie. Zbuduj tanie, ręczne rozwiązanie za pomocą testu concierge i sprawdź, czy liczba ticketów spadnie.
Niejednoznaczne: Zadanie znajduje się w środku stawki lub występuje tylko w jednej grupie. Przeprowadź kilka wywiadów z klientami z tego segmentu. Ćwiczenie ze statkiem (speed boat) pomoże sprawdzić, czy odczuwają ten problem tak mocno, jak sugerują liczby.
Obalone: To nie jest główny powód kontaktu. Przestań traktować go priorytetowo i zajmij się tym, co naprawdę boli użytkowników. Każde założenie powiązane z tą notatką zmieni status na Obalone.
Często zadawane pytania
Jak analizować zgłoszenia do działu obsługi klienta?
Przeczytaj 30 ostatnich ticketów i stwórz wstępne tagi na podstawie tego, co klienci próbowali zrobić. Zdefiniuj każdy tag w jednym zdaniu, a następnie otaguj 200 ostatnich kontaktów pod kątem zadania, blokady i rezultatu sprawy. Poproś drugą osobę o weryfikację 20 zgłoszeń, a na koniec zlicz tickety per zadanie, by zobaczyć, które z nich powodują najwięcej trudności i najczęściej pozostają nierozwiązane.
Ile ticketów z supportu należy przeanalizować?
Około 200 ostatnich kontaktów to praktyczny punkt wyjścia: próba wystarczająca, by wyłonić kluczowe zadania, i na tyle mała, by otagować ją ręcznie w jeden dzień. Jeśli masz mniej zgłoszeń, weź pod uwagę ostatnie sześć miesięcy i odnotuj łączną sumę. Unikaj analizowania danych z jednego tygodnia, bo pojedynczy nieudany release może zafałszować obraz.
Według jakich kryteriów tagować zgłoszenia do supportu?
Taguj według zadania, które klient próbował zrealizować, napotkanej blokady oraz sposobu zakończenia kontaktu. Dodaj typ klienta pobrany z danych konta. Tagi bazujące na modułach produktu (takie jak „Faktury” czy „Eksport”) pomagają w routingu, ale są zbyt ogólne, by podpowiedzieć, co zaprojektować lub naprawić.
Czy AI może otagować tickety za ciebie?
Może przygotować szybki pierwszy szkic. Inteligentna segregacja w Zendesk czy Topics Explorer w Intercomie grupują rozmowy automatycznie, ale zaprojektowano je z myślą o routingu i raportowaniu pracy działu, a model Zendeska ocenia tylko temat i pierwszy komentarz. Przejrzyj próbkę ręcznie i przypisz tagi według zadań – to właśnie proces tagowania przynosi najwięcej wiedzy.
Czy zgłoszenia do supportu pokazują, za co klienci zapłacą?
Nie. Zgłoszenia do supportu pokazują, gdzie klienci odczuwają ból, a nie to, czy zapłacą za jego usunięcie. Zadanie generujące mnóstwo kontaktów i wymagające ręcznych obejść jest świetnym kandydatem do zmian, ale połącz te wnioski z testem wymagającym realnej deklaracji, np. ofertą typu concierge lub testem intencji zakupu.
GDPR-aligned. EU workspace data is stored in Frankfurt, Germany. GDPR and EU data Built in Vienna, Austria. A product of influence solutions fm GmbH (FN 675374y). Imprint 14-day trial. Card required, and nothing is charged until day 14. 30-day refund after subscribing. See pricing