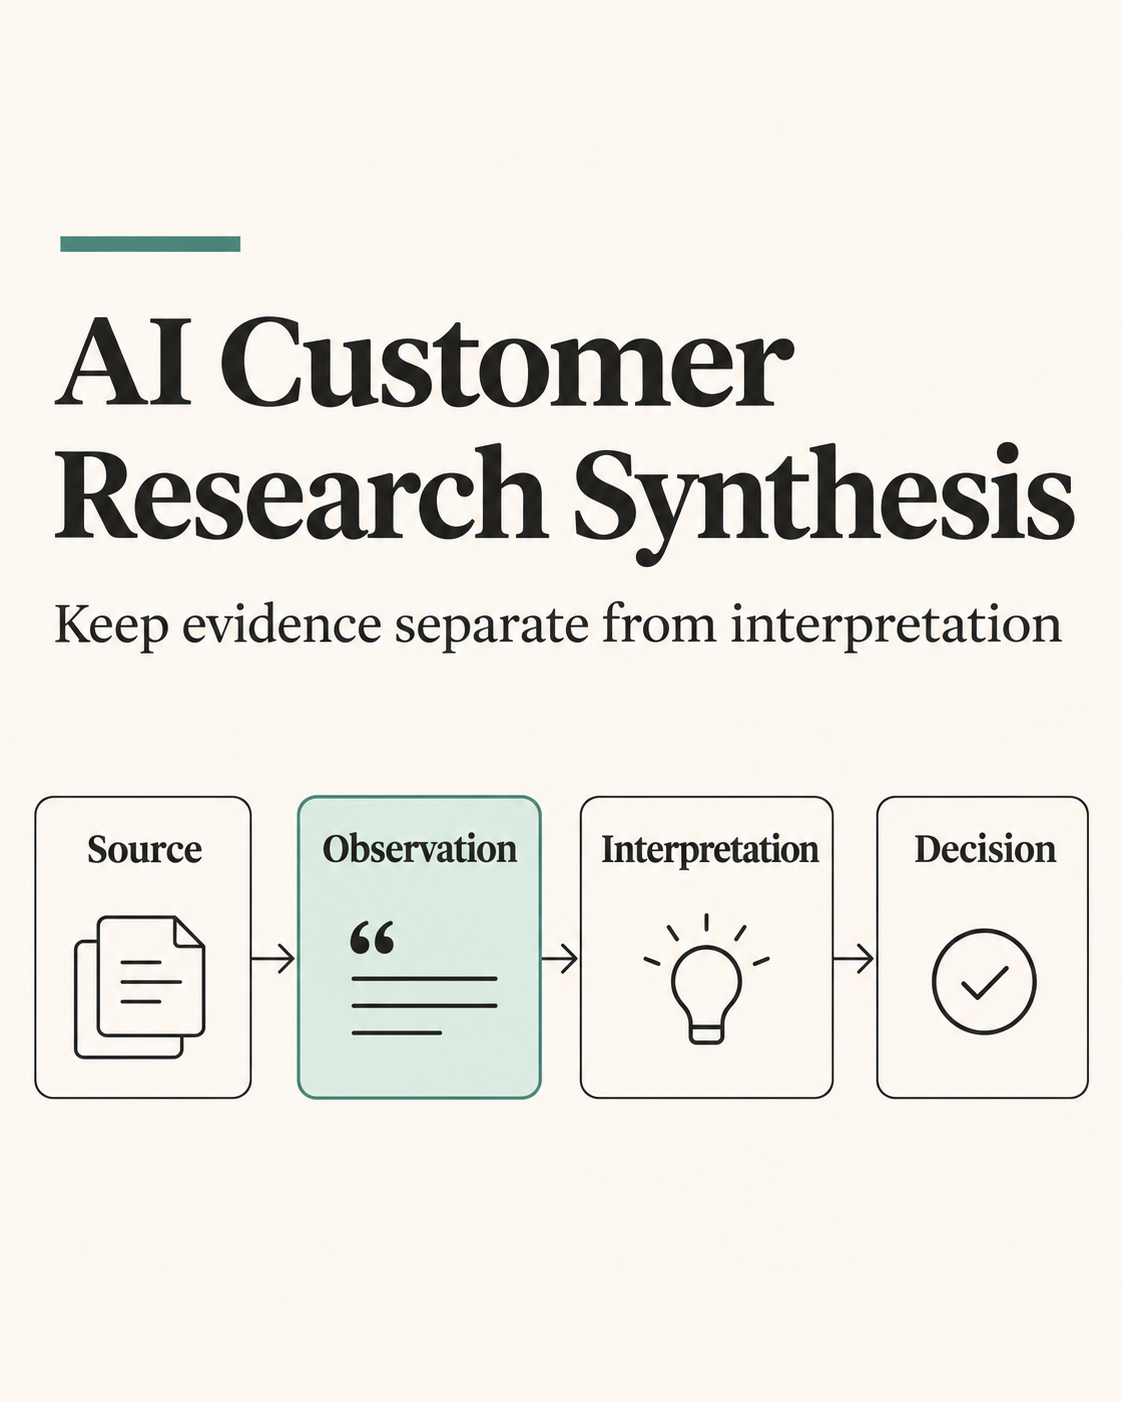
تجميع الأبحاث بالذكاء الاصطناعي: افصل الأدلة عن التفسير
يستطيع الذكاء الاصطناعي ترتيب مجلد من المقابلات في دقائق، لكن الدراسات تُظهر أنه يفوّته المحاور التفسيرية. سير عمل من خمس خطوات وموجّه (prompt) وقائمة مراجعة تُبقي كل ادعاء مرتبطًا بمصدره.
تجميع الأبحاث بالذكاء الاصطناعي (AI research synthesis) هو استخدام نموذج لغوي لتنظيم ملاحظات المقابلات وتذاكر الدعم وملاحظات الجلسات في محاور مرشّحة، بينما يراجع البشر كل محور على الأدلة الأصلية ويتحمّلون مسؤولية التفسير. يختصر المرور الأول من ساعات إلى دقائق. ويفشل حين تُعامَل المحاور المولَّدة على أنها نتائج: ففي المقارنات المنشورة، تتطابق النماذج مع الباحثين البشر في المحاور الوصفية أكثر بكثير مما تتطابق في المحاور التفسيرية.
يستطيع الذكاء الاصطناعي تحويل مجلد من ملاحظات المقابلات إلى ملخص مرتب في ثوانٍ. وهذا مفيد للعثور على مواد تستحق الفحص. لكنه أيضًا طريقة سهلة لتحويل تفسير غير مؤكد إلى قرار منتج يبدو واثقًا. هذا الدليل موجّه إلى المؤسسين وأوائل مديري المنتج (PM) ومهندسي المنتج الذين لديهم حفنة من المكالمات والتذاكر وملاحظات الاستخدام، لا قسم أبحاث يملك الوقت لإعادة قراءة كل شيء.
أبرز النقاط
في دراسة عام 2024، وجد كل من ChatGPT وBard خمسة من أصل سبعة محاور وجدها المرمِّزون البشر (71%)، لكنهما اتفقا مع البشر في 36–47% فقط من الرموز الفردية (Prescott et al., 2024).
استغرق تحليل الذكاء الاصطناعي نفسه نحو 20 دقيقة، مقابل متوسط 567 دقيقة للمرمِّزين البشر. السرعة حقيقية؛ أما الدقة فلا.
في 30 مقابلة سريرية يابانية، اتفق ChatGPT-4 مع الباحثين في أكثر من 80% من المحاور الوصفية، لكن في نحو 30% فقط من المحاور التي تتطلب تفسيرًا ثقافيًا أو عاطفيًا (Sakaguchi et al., 2025).
67% من ممارسي تجربة المستخدم (UX) الذين يحللون بيانات أبحاثهم بأنفسهم يستخدمون الذكاء الاصطناعي لذلك غالبًا أو دائمًا، ومع ذلك فجودة المخرجات هي أكبر عائق أمام التبنّي، ذكرها 54% (NN/g, 2026).
أبقِ أربع طبقات منفصلة: المصدر، الملاحظة، التفسير، القرار. يمكن للذكاء الاصطناعي أن يساعد في الأوليين. أما الأخريان فللبشر.
ما هو تجميع الأبحاث بالذكاء الاصطناعي، وما الذي لا ينبغي أن يفعله؟
التجميع (synthesis) هو الخطوة التي تلي المقابلات: إيجاد الأنماط والفروق ذات المعنى عبر المحادثات، ثم تقرير ما تعنيه لقرار المنتج. يشرح دليلنا حول كيفية تحليل مقابلات العملاء الطريقة اليدوية. أما تجميع الأبحاث بالذكاء الاصطناعي فيسلّم النموذج جزءًا من هذا العمل: النسخ الكتابي، واستخراج الملاحظات، وتجميع العبارات المتشابهة، وصياغة مسميات المحاور.
ما لا ينبغي أن يفعله هو الاستنتاج. فالنموذج لا يعرف استراتيجيتك، ولا سجل حساب العميل، ولا أي مشارك كان غير مناسب للدراسة. وعندما راجعت مجموعة نيلسن نورمان (Nielsen Norman Group) مولّدات الرؤى بالذكاء الاصطناعي عام 2023، لم تستطع الأدوات استيعاب أهداف الدراسة ولا النتائج السابقة ولا سياق كل مشارك، فخرجت محاورها بلا ترتيب أولويات ().
تخيّل ثلاثة مشاركين يصفون خطوة إعداد مربكة. يقول الأول إنه لم يعرف أي مصدر يربط. ويقول الثاني إنه ربط الحساب الخطأ. ويطلب الثالث قائمة مراجعة للإعداد.
الملاحظات محددة. أما «يحتاج المستخدمون إلى قائمة مراجعة للانضمام» فهي تفسير بالفعل. و«أداة اختيار التكامل هي المشكلة» تفسير آخر. ولا ينبغي حفظ أي منهما كأنه اقتباس مباشر.
يُبقي التجميع المفيد أربع طبقات ظاهرة:
المصدر: المقابلة الأصلية أو رسالة الدعم أو الجلسة المرصودة.
الملاحظة: ما قاله الشخص أو فعله، مع سياق كافٍ لتفسيره.
التفسير: الحاجة أو السبب أو النمط المحتمل الذي تستنتجه.
القرار: ما سيفعله الفريق أو يختبره أو يؤجله أو يتعلمه لاحقًا.
عندما تنهار هذه الطبقات في ملخص واحد، يفقد الفريق القدرة على الطعن في التفسير دون التشكيك في صحة المصدر نفسه. وتنص NN/g على قاعدة البحث صراحةً: يجب «التمييز بين تفسيراتنا أو افتراضاتنا وبين ما قاله المشاركون أو فعلوه» («differentiate between our interpretations or assumptions and what the participants said or did»، NN/g, 2023). وملخصات الذكاء الاصطناعي نثر سلس، والنثر السلس هو بالضبط المكان الذي يختفي فيه هذا الخط.
ما مدى دقة الذكاء الاصطناعي في تحليل الأبحاث النوعية؟
دقيق بما يكفي لإيجاد المحاور الواضحة؛ وغير دقيق بما يكفي للوثوق به في الدقيقة منها. وتشير المقارنات المنشورة في الاتجاه نفسه:
وجد Prescott وزملاؤه أن المرمِّزين البشر كانوا أفضل في المحاور الدقيقة والتفسيرية، وخلصوا إلى أن النُّهُج الهجينة ضرورية. ووصف Sakaguchi وزملاؤه ChatGPT-4 بأنه أداة مساعدة، وشدّدوا على استمرار الحاجة إلى الخبرة البشرية.
هذه دراسات في البحث الصحي وتجربة المستخدم، لا في اكتشاف المنتجات (discovery) في الشركات الناشئة، فلا تنقل النسب المئوية إلى مقابلاتك. لكنها تدعم قاعدة تشغيلية واحدة: كلما اعتمد المحور أكثر على السياق أو العاطفة أو ما تركه أحدهم دون قوله، قلّ ما ينبغي أن تثق بمسمّى مولَّد دون قراءة المصدر.
ماذا يقول الممارسون؟
يُظهر استطلاع NN/g في أكتوبر 2026 على 521 من ممارسي UX مدى اعتياد التحليل بالذكاء الاصطناعي (NN/g, 2026):
67% ممن يحللون بيانات أبحاثهم بأنفسهم يستخدمون الذكاء الاصطناعي لذلك غالبًا أو دائمًا.
نحو 9 من كل 10 ممن يستخدمونه في التحليل أو البحث المكتبي أو الترميز قالوا إنه جعل العمل أسرع.
54% ذكروا القلق من جودة المخرجات عائقًا، وهو الأكثر شيوعًا.
من بين 149 تعليقًا سلبيًا، كانت المخرجات غير الموثوقة وعبء التحقق منها الأكثر ذكرًا، في 40 تعليقًا.
61% لم يستخدموا الذكاء الاصطناعي قط لإجراء مقابلات مع المستخدمين.
تصف NN/g هذه العينة بأنها عينة ملاءمة، فاقرأها كاتجاه لا كتقدير للسوق. والاتجاه واضح: يستخدم الممارسون الذكاء الاصطناعي في التحليل لأنه أسرع، ويقضون الوقت الموفَّر في التحقق منه.
كيف تجري تجميع الأبحاث بالذكاء الاصطناعي خطوة بخطوة؟
خمس خطوات. الأوليان تحدثان قبل أن تفتح أي أداة ذكاء اصطناعي؛ وفي الأخيرتين يثبت البشر قيمتهم.
1. حدّد القرار قبل التلخيص
اكتب قرار المنتج الذي يُفترض أن يستنير بالبحث. على سبيل المثال:
هل نبسّط مسار الربط عند أول تشغيل، أم نشرح أولًا أي مصدر ينبغي للمستخدم ربطه؟
هذا يمنع موجّهًا عامًا مثل «حلّل هذه المقابلات» من إنتاج محاور جذابة لا تفيد في القرار المطروح. كما يسهّل ملاحظة أن المادة لا تجيب عن السؤال. وإذا لم تستطع تسمية القرار، فلست جاهزًا للتجميع؛ فقد تكون ما تزال في مرحلة عملية اكتشاف المنتج (product discovery) حيث تقرر ما ينبغي تعلمه.
2. جهّز المواد المصدرية بمسؤولية
استخدم فقط المواد التي يُسمح لفريقك بمعالجتها في أداة الذكاء الاصطناعي المختارة، وفق الموافقة التي منحها المشاركون. أزل التفاصيل الشخصية أو الحساسة ما لم يكن لديك سبب واضح ومعتمد للإبقاء عليها؛ وتشير NN/g إلى أن بعض أدوات البحث باتت تمحو الأسماء وعناوين البريد الإلكتروني ومعرّفات مشابهة تلقائيًا (NN/g, 2024). احتفظ بمعرّف للمصدر وتاريخ ليتمكن المراجع من إيجاد السجل الأصلي، مع التحكم في الوصول إلى النص المفرّغ الأصلي.
لا تدمج ملاحظات من فئات عملاء أو أسئلة بحث مختلفة دون وسمها. فمقابلة مع مؤسس وتذكرة دعم وجلسة قابلية استخدام مرصودة كلها قد تكون مفيدة؛ لكنها ليست أدلة قابلة للتبادل. ضع على كل سجل وسمًا بنوعه وبشريحة المشارك قبل أن يراه النموذج.
3. اطلب من الذكاء الاصطناعي أن يُنظّم لا أن يستنتج
أعطِ النموذج مهمة محدودة. اطلب منه أن:
يستخرج الملاحظات ذات الصلة بالقرار؛
يرفق بكل ملاحظة معرّف المصدر والمقطع الدقيق الذي يدعمها؛
يفصل التصريحات المباشرة عن الاحتياجات المستنتجة؛
يسرد الأمثلة المضادة والأدلة المتعارضة؛
يشير إلى السياق المفقود والأسئلة التي لا يستطيع الإجابة عنها؛
يتجنب عدّ الإشارات المتكررة مستخدمين مستقلين ما لم تدعم مجموعة المصادر هذا العدّ.
لا تطلب شخصية (persona) نهائية أو استنتاجًا على مستوى السوق أو خارطة طريق (roadmap) مرتبة اعتمادًا على بضع محادثات. فقد ينسّق النموذج عدم اليقين بحيث يختفي عن النظر ما لم تطلب منه صراحةً الإبقاء عليه. ووجدت NN/g أن التجميع بالذكاء الاصطناعي كثيرًا ما يجمع العناصر بحسب كلمات مفتاحية مشتركة لا بحسب معنى مشترك، فعامل المجموعات الأولى كوسيلة مساعدة على الفرز (NN/g, 2024).
4. تحقق من كل ادعاء قد يغيّر خارطة الطريق
ينبغي لمدير المنتج أو المؤسس أن يفتح المصدر الأصلي لكل محور مقترح عالي التأثير. تحقق مما إذا كان الاقتباس يدعم الادعاء، وهل يغيّر السياق المحيط معناه، وهل دمج النموذج تجارب أشخاص مختلفين.
ثم ابحث عن الأدلة التي لا تتفق. إذا وصف مستخدمان العَرَض نفسه لأسباب مختلفة، فاحتفظ بكلا التفسيرين. وإذا كانت قصة حية واحدة هي السند الوحيد لفكرة ما، فصنّفها إشارةً تستحق التحقيق لا نمطًا مثبتًا.
يبدو جدول المراجعة العملي هكذا:
المحور المقترح
المصدر الداعم
ما الذي لوحظ مباشرة؟
التفسير
دليل مضاد أو فجوة
الخطوة التالية
المصدر في الإعداد غير واضح
المقابلة 04، ملاحظة الجلسة
ربط الشخص حسابًا مختلفًا عمّا قصده
قد تكون مسميات الخيارات ملتبسة
ملاحظة واحدة؛ لا إعادة تشغيل للمهمة بعد
مراجعة التسجيل واختبار فهم المسميات
يريد المستخدمون قائمة مراجعة
المقابلة 07، النص المفرّغ
طلب الشخص قائمة مراجعة بعد أن تعثّر
قد يحتاجون إلى إرشاد عند نقطة القرار
قد يعكس الطلب تفضيل هذا الشخص
المقارنة بحالات الدعم ورصد أول استخدام
الجدول متواضع عمدًا. فهو لا يحوّل محادثتين إلى نسبة مئوية، ولا يزعم أن «المستخدمين» جميعهم يتصرفون بالطريقة نفسها.
5. سجّل القرار ومحفّز التعلّم الخاص به
بعد أن يراجع الفريق الأدلة، سجّل ما قرره ولماذا. أدرج صاحب القرار والمصادر الداعمة وأهم عدم يقين، وأي أدلة مستقبلية ستغيّر الاختيار. ويمنح سجل قرارات المنتج هذا مكانًا دائمًا.
على سبيل المثال:
القرار: اختبار أوصاف أوضح للمصادر قبل بناء قائمة مراجعة إعداد كاملة.
السبب: يشير مصدران مستقلان إلى عدم يقين عند اختيار الربط، لكننا لم نرصد جلسات أول استخدام كافية لنعرف هل المشكلة في المسميات أم الترتيب أم غياب الإرشاد.
محفّز المراجعة: إعادة النظر بعد مراجعة عدة جلسات إعداد تمثيلية، أو إذا أشارت بلاغات الدعم إلى نقطة إخفاق مختلفة.
يعتمد حجم العينة الذي تحتاجه على القرار والمخاطرة ومدى تنوع مستخدميك. لا تعامل عددًا ثابتًا من المقابلات كدليل على التشبّع أو التمثيل. وإن بقيت الأدلة متباينة، فقد تكون الخطوة المفيدة التالية ملاحظة أخرى لا ملخصًا أكثر صقلًا.
ما الموجّه الذي تستخدمه في تجميع الأبحاث بالذكاء الاصطناعي؟
استخدم مرورين: أحدهما للتنظيم، والآخر لمساعدتك على ترتيب أولويات التحقق. يمكنك تكييف هذا الموجّه الأول لمجموعة مصادر مسموح بها ومحمية بما يلزم:
ساعدني في تنظيم ملاحظات البحث هذه لأجل القرار: [سؤال القرار]. لكل ملاحظة مقترحة، أدرج معرّف المصدر والمقطع الدقيق الذي يدعمها. افصل الدليل المباشر عن التفسير. اسرد الأمثلة المتناقضة والسياق المفقود والتفسيرات البديلة. لا تستنتج التكرار خارج السجلات المقدمة. لا توصِ بقرار لخارطة الطريق. إذا تعذّر دعم ادعاء بمقطع، فصنّفه «غير مدعوم». أعد جدولًا يضم: الملاحظة، الاقتباس، المصدر، التفسير، سبب الثقة، الدليل المضاد، وسؤال المتابعة.
ثم شغّل موجّهًا ثانيًا على المخرجات:
لكل محور أعلاه، اسرد المشاركين المتمايزين (لا الإشارات) الذين يدعمونه، بحسب معرّف المصدر. أشِر إلى أي محور يدعمه مشارك واحد فقط، وأي اقتباس لا تجده حرفيًا في المصادر، وأي محور يجمع مشاركين من شرائح مختلفة.
المرور الثاني ليس تحققًا. فالنموذج الذي يراجع عمله بنفسه قد يكرر أخطاءه. إنه وسيلة لفرز المحاور بحيث يبدأ التحقق البشري بأضعفها. ولا يجعل أيٌّ من الموجّهين المخرجات موثوقة وحده؛ لكنهما معًا يجعلان فحصها أسهل.
كيف تفحص تجميعًا بالذكاء الاصطناعي قبل أن يصل إلى خارطة الطريق؟
انسخ هذه القائمة إلى مستند التجميع وضع علامة على بنودها قبل أن يتحول أي محور إلى تذكرة أو سطر في PRD:
القرار الذي يخدمه هذا التجميع مكتوب في الأعلى.
كل اقتباس حرفي: بحثت في النص المفرّغ ووجدته.
يذكر كل محور كم شخصًا متمايزًا يدعمه، لا كم إشارة.
يسمّي كل محور شريحة هؤلاء الأشخاص أو دورهم أو وضعهم.
الأدلة المضادة مدرجة تحت المحور الذي تطعن فيه.
الادعاءات عن سبب تصرف الناس أو شعورهم موسومة بأنها تفسير.
المحاور التي تقوم على شخص واحد موسومة بأنها إشارات تستحق التحقيق.
الأصوات الغائبة مسجّلة: من لم تتحدث إليه.
مثال تطبيقي: فحص تجميع في ساعة
هذا المثال توضيحي. لنفترض فريقًا من خمسة أشخاص لديه 8 مقابلات انضمام (onboarding)، ونحو 6 ساعات من التسجيلات، إضافة إلى 40 تذكرة دعم. يقترح GOV.UK نحو ساعة تحليل لكل ساعتين من البحث (GOV.UK)، فالمرور اليدوي على المكالمات وحدها يستغرق نحو 3 ساعات. وتنصح NN/g بتخصيص وقت للتحليل لا يقل عن وقت الجمع، وهذا يعني أكثر (NN/g, 2022).
يستغرق مرور الذكاء الاصطناعي 10 دقائق ويقترح 7 محاور مدعومة بـ 31 اقتباسًا. تراجع مديرة المنتج 3 محاور فقط يمكن أن تغيّر السبرنت التالي: 14 اقتباسًا، نحو 45 دقيقة قراءة. وتجد اقتباسين أُعيدت صياغتهما بدل أن يكونا حرفيين. ومحور واحد، «يريد المستخدمون قائمة مراجعة»، يقوم على شخصين طلبا أمرين مختلفين. ومحور آخر، «المصدر في الإعداد غير واضح»، يصمد عبر 5 من 8 مقابلات و9 تذاكر.
ذلك المحور الأخير وحده يدخل سجل القرارات، ويبقى طلبا قائمة المراجعة سؤالًا مفتوحًا. الوقت الإجمالي نحو ساعة، وكل ادعاء يصل إلى خارطة الطريق قرأه شخص في مصدره. وللانضباط نفسه مع المواصفات (specs) التي يكتبها الذكاء الاصطناعي، راجع تتبّع الادعاءات لمواجهة هلوسة المواصفات.
أي مهام التجميع تُسلَّم للذكاء الاصطناعي وأيها تحتفظ بها؟
كما لا يستطيع الذكاء الاصطناعي إصلاح عينة ضعيفة أو متحيزة. فإن لم تتحدث إلا إلى أسعد عملائك، فالتجميع المثالي لتلك المكالمات يبقى تجميعًا لأسعد عملائك. والأسئلة الأفضل تساعد؛ ويركّز قالب مقابلة العملاء لدينا على السلوك الأخير لا على الآراء.
أين يتموضع Specky
يقرأ Specky مكالمات العملاء والملاحظات وSlack وJira والتحليلات داخل Product Graph، ثم يصوغ مواصفات وتذاكر باقتباسات مضمّنة تعود إلى الأدلة، فيستطيع المراجع فتح المصدر خلف كل ادعاء. ويجري Alex، وكيل الأبحاث في Specky، مقابلات العملاء عبر رابط قابل للمشاركة، فلا ينتظر البحث التقاويم. وتبقى قاعدة هذا الدليل سارية: الاقتباس يجعل الادعاء قابلًا للتحقق، لا صحيحًا. وما يزال أحد أعضاء الفريق يقرأ المصدر قبل أن يصل الادعاء إلى خارطة الطريق.
الأسئلة الشائعة
هل يستطيع الذكاء الاصطناعي تجميع أبحاث العملاء وحده؟
لا. يستطيع الذكاء الاصطناعي النسخ الكتابي واستخراج الاقتباسات واقتراح المحاور أسرع بكثير من الإنسان، لكن المقارنات المنشورة تُظهر أنه لا يتفق مع المرمِّزين البشر إلا في 36–47% من الرموز الفردية ونحو 30% من المحاور التفسيرية. استخدمه للمرور الأول، ثم اطلب ممن يعرف المنتج والعملاء أن يراجع كل محور قد يغيّر قرارًا.
ما مدى دقة التحليل الموضوعي بالذكاء الاصطناعي مقارنة بالبشر؟
يعتمد ذلك على نوع المحور. فقد اتفق ChatGPT-4 مع الباحثين البشر في أكثر من 80% من المحاور الوصفية في دراسة 2025، لكن في نحو 30% فقط من المحاور التي تتطلب تفسيرًا ثقافيًا أو عاطفيًا. ووجدت دراسة 2024 أن الذكاء الاصطناعي طابق 71% من المحاور الاستقرائية للبشر. توقّع استرجاعًا جيدًا للموضوعات الواضحة وحكمًا ضعيفًا على المعنى.
كيف تمنع الذكاء الاصطناعي من اختلاق الاقتباسات؟
اشترط معرّف مصدر ومقطعًا دقيقًا لكل ملاحظة، وقل للنموذج أن يصنّف كل ما لا يستطيع دعمه «غير مدعوم». ثم ابحث في النص المفرّغ عن كل اقتباس يسند محورًا عالي التأثير. ووجدت NN/g أن بعض أدوات الأبحاث بالذكاء الاصطناعي نسبت اقتباسات دون ذكر الجلسة أو الطابع الزمني، ما يجعل هذا التحقق مستحيلًا، فاختر أدوات تذكر مصادرها.
هل من الآمن رفع مقابلات العملاء إلى أداة ذكاء اصطناعي؟
فقط إذا وافق المشاركون على هذه المعالجة وكانت مؤسستك قد اعتمدت الأداة لهذا النوع من البيانات. أزل الأسماء وعناوين البريد وأي معرّفات أخرى لا تحتاجها، وتحقق من مكان تخزين الأداة للبيانات ومعالجتها لها، وقيّد من يستطيع رؤية النصوص الخام. وبموجب اللائحة العامة لحماية البيانات (GDPR)، تُعدّ تسجيلات المقابلات ونصوصها بيانات شخصية متى أمكن تحديد هوية المشارك.
كم مقابلة تحتاج قبل أن يصبح التجميع بالذكاء الاصطناعي مفيدًا؟
يساعد الذكاء الاصطناعي منذ المقابلة الأولى، في النسخ الكتابي واستخراج الملاحظات. أما المحاور العابرة للمقابلات فتحتاج إلى عدة محادثات حول القرار نفسه قبل أن يستحق النمط التحقق منه. ويعتمد العدد المناسب على مدى تنوع مستخدميك ومخاطرة القرار. المقابلات تشرح لماذا يحدث أمر ما؛ واستخدم التحليلات أو استبيانًا لمعرفة عدد مرات حدوثه.
GDPR-aligned. EU workspace data is stored in Frankfurt, Germany. GDPR and EU data Built in Vienna, Austria. A product of influence solutions fm GmbH (FN 675374y). Imprint 14-day trial. Card required, and nothing is charged until day 14. 30-day refund after subscribing. See pricing