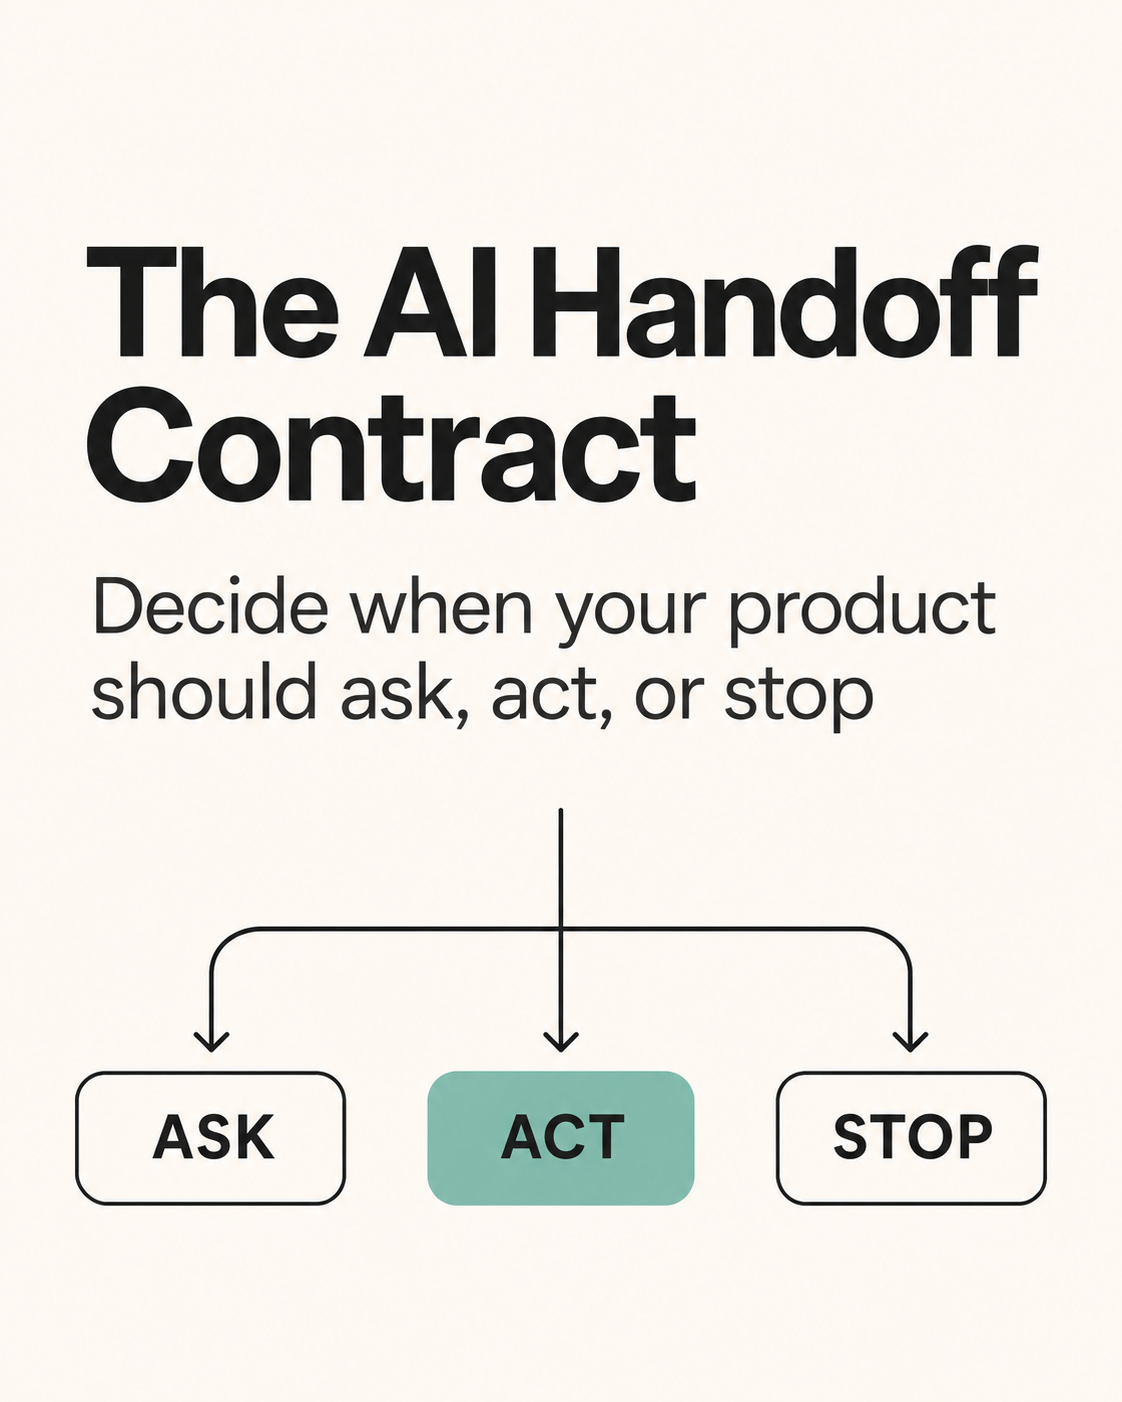
تسليم مهام وكيل الذكاء الاصطناعي: متى يجب أن يسأل منتجك أو يتصرف أو يتوقف؟
حدد متى ينبغي لوكيل الذكاء الاصطناعي أن يطلب التوضيح، أو يتصرف ضمن حدود واضحة، أو يتوقف ويسلّم التحكم للإنسان، مدعوماً ببيانات واقعية ونموذج عقد عملي يمكنك استخدامه.
تسليم مهام وكيل الذكاء الاصطناعي (AI agent handoff) هو اللحظة التي تنقل فيها ميزة الذكاء الاصطناعي التحكم مجدداً إلى الإنسان: إما لطلب معلومات ناقصة، أو للحصول على موافقة قبل اتخاذ إجراء له تبعات ملموسة، أو للتوقف بالكامل وترك المهمة لشخص يتولاها. ويحدد «عقد التسليم» (handoff contract)، قبل إطلاق المنتج، متى ينبغي للمنتج أن يسأل، ومتى يُسمح له بالتصرف بمفرده، ومتى يتحتم عليه التوقف، بالإضافة إلى ما يظهر للمستخدم في كل حالة من هذه الحالات.
أبرز النقاط المستفادة
يتوقف الوكلاء حالياً من تلقاء أنفسهم بوتيرة تفوق عدد المرات التي يوقفهم فيها البشر. ففي دراسة أجرتها Anthropic لنحو 500,000 جلسة عمل على Claude Code، طلب الوكيل توضيحات في المهام شديدة الصعوبة بأكثر من ضعف معدل طلبه في المهام البسيطة، وبمعدل يفوق عدد مرات مقاطعة البشر له (Anthropic, 2026).
كان السبب الأبرز لتوقف الوكيل هو طرح خيارات بين مسارات تنفيذية مختلفة (35%). بينما كان السبب الأول لمقاطعة البشر للوكيل هو تقديم سياق ناقص أو تصحيح مسار (32%). وكلتا الحالتين مشكلتان مرتبطتان بسياق المنتج وليستا عيباً في النموذج اللغوي نفسه.
يحدد دليل الوكلاء من OpenAI محفزين رئيسيين للتدخل البشري: تجاوز عتبات الفشل المسموحة، وتنفيذ إجراءات عالية المخاطر تتسم بالحساسية أو عدم القابلية للتراجع أو ارتفاع التبعات (OpenAI).
ثقة النموذج لا تعني منحه الصلاحية. كون النموذج «متأكداً بنسبة 90%» لا يمنحه تفويضاً لإرسال بريد إلكتروني أو تعديل سجل عميل.
وجود مراجع بشري لا يُعد شبكة أمان تلقائية. ففي تحليل تجميعي، أدت النصائح الخاطئة الصادرة عن أنظمة دعم اتخاذ القرار إلى رفع احتمالية اتخاذ قرار بشري غير صحيح بنسبة 26% (Goddard et al., 2012).
ما هو تسليم مهام وكيل الذكاء الاصطناعي؟
يحمل هذا المصطلح معنيين، ومن المفيد التمييز بينهما بدقة:
التسليم من وكيل إلى وكيل (Agent-to-agent handoff). في مكتبة Agents SDK من OpenAI، يتيح التسليم لوكيل ما أن يفوّض مهمة لوكيل آخر؛ مثل قيام وكيل الفرز بتمرير طلب استرداد مالي إلى وكيل الاسترداد المالي. يرى النموذج كل عملية تسليم كأداة (tool)، مثل transfer_to_refund_agent (OpenAI Agents SDK). ويصفه دليل OpenAI بأنه نقل في اتجاه واحد يحمل معه حالة المحادثة كاملة.
التسليم من وكيل إلى إنسان (Agent-to-human handoff). ينقل الوكيل هنا التحكم إلى شخص حقيقي لعدم قدرته على الاستمرار أو لعدم ملاءمة ذلك. ويقدم دليل OpenAI مثالين على ذلك: في خدمة العملاء، التصعيد إلى موظف دعم بشري؛ وفي وكلاء كتابة الأكواد، إعادة زمام التحكم إلى المستخدم.
هذا المقال يركز على النوع الثاني، وهو قرار يتعلق بالمنتج بالدرجة الأولى وليس مجرد تفصيل تقني في إدارة وتنسيق النماذج (orchestration). يستطيع وكيل المنتج أن يوصي بالخطوة التالية، أو يجهزها، أو ينفذها مباشرة. هذه ثلاثة سلوكيات متباينة تماماً، حتى لو كانت الشاشة تعرض زراً بسيطاً يرتدي مظهر الود ومكتوباً عليه «متابعة». السؤال الذي يحسمه «عقد التسليم» هو: ما الذي يُسمح لهذا المنتج بتقريره نيابة عن المستخدم، وبالاعتماد على أي معلومات، وما الذي يحدث إذا كانت الإجابة محاطة بالشكوك؟
يهتم المستخدمون بالوصول إلى هذه التوازنات الصحيحة. ففي استطلاع Stack Overflow لعام 2025، أبدى 86.9% من المطورين قلقهم بشأن دقة المعلومات الصادرة عن وكلاء الذكاء الاصطناعي، وأعرب 81.4% عن مخاوف تتعلق بالأمان وخصوصية بياناتهم عند استخدامهم (Stack Overflow, 2025). وتأتي سياسة التسليم الواضحة لتعالج هذين الأمرين معاً: حيث يقلل الوكيل من خطواته عندما تكون الأدلة ضعيفة، ولا يقترب من البيانات والوظائف دون إذن مسبق.
هذا جوهر عمل إدارة المنتجات. يضفي الـ PM تقديره لمتطلبات المجال: ما الذي يُعد تصرفاً مقبولاً، وما التنازلات المقبولة، وما الأخطاء التي توجب على المستخدم استلام زمام الأمور فوراً. بينما يتولى المهندسون ترجمة هذه السياسة إلى سلوك فعلي في بيئة الإنتاج لضمان اعتماديته. فالـ PM هنا لا يتدخل في ملكية الكود، بل في تحديد سلوكياته.
لماذا تعد عبارة «إبقاء الإنسان في حلقة التحكم» فضفاضة للغاية لوكلاء الذكاء الاصطناعي؟
توجيه الفريق بمجرد عبارة «احرص على إبقاء الإنسان في حلقة التحكم» (human in the loop) يترك الأسئلة الحرجة دون إجابة:
أي موظف هو الذي سيراجع، وهل يملك السياق الكافي للحكم السليم؟
هل يُراجع اقتراحاً، أم مسودة، أم إجراءً تم تنفيذه بالفعل؟
هل يمكنه تعديل الإجراء، أم أن خياره ينحصر في الموافقة فقط؟
ماذا يحدث لو لم يستجب أحد للمراجعة؟
ما الأخطاء التي لا يجوز تفويضها للذكاء الاصطناعي إطلاقاً؟
تطالب الأطر التنظيمية الفرق بحسم هذه التفاصيل، لكنها لا تقدم الإجابات الجاهزة. على سبيل المثال، يطالب إطار إدارة مخاطر الذكاء الاصطناعي NIST AI Risk Management Framework 1.0 المؤسسات بتحديد أدوار دقيقة للتشكيلات المشتركة بين الإنسان والذكاء الاصطناعي (GOVERN 3.2)، وتوثيق آليات الإشراف البشري (MAP 3.5)، ووضع آليات لتعطيل نظام الذكاء الاصطناعي أو إيقافه أو تجاوزه يدوياً عند خروجه عن حدود الاستخدام المقصود (MANAGE 2.4) (NIST).
ويذهب قانون الذكاء الاصطناعي الأوروبي (EU AI Act) إلى أبعد من ذلك في الأنظمة عالية المخاطر؛ إذ تلزم المادة 14 بأن يكون المشرفون البشريون على دراية كاملة بظاهرة «انحياز الأتمتة» (automation bias)، وأن يمتلكوا القدرة على تجاهل مخرجات النظام أو تعديلها أو التراجع عنها، وإيقاف عمله كلياً عبر زر «إيقاف» أو إجراء مماثل (EUR-Lex). وبعد صدور حزمة الـ Digital Omnibus، تسري هذه الالتزامات على الأنظمة عالية المخاطر المندرجة تحت الملحق الثالث (Annex III) اعتباراً من 2 ديسمبر 2027 (EUR-Lex, Regulation 2026/1744). ومع أن معظم وكلاء المنتجات لا يُصنفون كأنظمة عالية المخاطر، إلا أن خيارات: السؤال، والتجاوز، والتوقف تُمثل الحد الأدنى السليم لأي وكيل منها.
عملية المراجعة ذاتها تحتاج إلى تصميم وتخطيط. ففي مراجعة شملت 74 دراسة حول انحياز الأتمتة أجراها Goddard وزملاؤه، تبيّن أنه عندما كانت أنظمة دعم اتخاذ القرار تخطئ، ارتفعت احتمالية وقوع الإنسان في قرار خاطئ بنسبة 26%. فالمراجع الذي تظهر أمامه توصية مؤكدة بنبرة واثقة بجوار زر «موافقة» لا يمثل جهة تدقيق مستقلة على الإطلاق، ما لم يعرض المنتج بوضوح الأدلة الداعمة ويسهل عملية الاعتراض أو إبداء الرأي المخالف.
متى يجب على وكيل الذكاء الاصطناعي أن يسأل، أو يتصرف، أو يتوقف؟
اعتمد ثلاثة مسارات، واختر بينها بناءً على حجم التبعات ومستوى الصلاحيات، وليس وفقاً لدرجة ثقة النموذج اللغوي (confidence score).
اسأل (Ask) عندما يفتقر النظام إلى معلومات أو صلاحية يمكن أن تُغير مجرى القرار. اطرح سؤالاً واحداً محدداً، واشرح سبب أهمية إجابته، واترك للمستخدم حرية الاختيار. وإذا كانت المعلومة الناقصة اختيارية، قدم خياراً افتراضياً واضحاً للعيان.
تصرّف (Act) عندما تكون المهمة محددة بوضوح، والإجراء يقع تماماً ضمن نطاق ما طلبه المستخدم، وتبعات الخطأ مقبولة وغير كارثية لو أخطأ النظام. احرص على جعل الإجراء مرئياً وواضحاً وسهل الفحص أو التراجع عنه.
توقف (Stop) عندما يعجز النظام عن الاستمرار بمسؤولية: كأن يخرج الطلب عن النطاق المسموح به للمنتج، أو تكون الأدلة أضعف بكثير من مستوى التبعات، أو يتعذر الوصول إلى مصدر بيانات أساسي، أو يتم تجاوز حد المحاولات الفاشلة، أو تتطلب الخطوة التالية تجاوز حدود لم يفوضها المستخدم. اشرح السبب واقترح الخطوة التالية؛ مثل تعديل صياغة الطلب أو تحويله إلى شخص للمتابعة.
المسار
متى يُستخدم؟
ما الذي يراه المستخدم؟
مثال
اسأل (Ask)
نقص أو تعارض في المعلومات من شأنه تغيير النتيجة
سؤال محدد، وسبب أهميته، و2 إلى 4 خيارات
«هل نحدد الأولوية بحسب ملاءمة العميل أم بناءً على مؤشرات الشراء الحديثة؟»
تصرّف (Act)
الطلب واضح، والإجراء ضمن النطاق وقابل للتراجع عنه
النتيجة، وما تم تغييره، وخيار للتراجع
حفظ مسودة رد داخل مجلد المسودات الخاص بالمستخدم
تصرّف بعد التأكيد
الإجراء ضمن النطاق المسموح لكن تبعاته حساسة
معاينة واضحة مع طلب تأكيد صريح
إرسال الرد مباشرة إلى العميل
توقف (Stop)
خارج النطاق، أو ضعف في الأدلة، أو بلوغ حد الفشل، أو غياب التفويض
سبب التوقف مع بيان الخطوة التالية أو جهة التواصل البشرية
«لا أملك صلاحية تعديل بيانات الفوترة. إليك من يمكنه المساعدة.»
الثقة لا تعني الصلاحية. إفادة النموذج بأنه متأكد بنسبة 90% لا تمنحه الحق في إرسال بريد إلكتروني، أو تعديل سجل عميل، أو اعتماد قرار إنتاجي. فالمسار المتبع يُبنى على طبيعة المهمة، وقوة الأدلة، وصلاحية المستخدم، وتكلفة الخطأ. وللقرارات التي تعود بإجابات ثابتة، كالتصنيف أو التوجيه أو تقييم النقاط، يوضح إطار اتخاذ قرارات الذكاء الاصطناعي كيفية تحديد العتبات استناداً إلى تكلفة الأخطاء. ولتقييم قابلية الإجراء للتراجع من عدمه، يمكنك الرجوع إلى إطار قرارات المنتجات ذات الاتجاه الواحد والاتجاهين.
كيف يتقاسم البشر ووكلاء الذكاء الاصطناعي التحكم حالياً؟
تُعد دراسة Anthropic المنشورة في فبراير 2026 أفضل البيانات العامة المتاحة حتى اليوم؛ حيث حللت نحو 500,000 جلسة تفاعلية على أداة Claude Code و998,481 استدعاءً للأدوات (tool calls) عبر واجهتها البرمجية العامة (Anthropic, 2026).
أسباب توقف الوكيل تلقائياً:
سبب توقف Claude Code المؤقت
النسبة
طرح خيارات بين مسارات تنفيذ مختلفة
35%
جمع معلومات تشخيصية أو نتائج اختبارات
21%
استيضاح طلب غامض أو غير دقيق
13%
طلب بيانات اعتماد أو صلاحيات وصول
12%
طلب الموافقة قبل تنفيذ الإجراء
11%
أسباب مقاطعة البشر للوكيل: تزويد الوكيل بسياق مفقود أو تصحيحات (32%)، وبطء الوكيل أو تجمد استجابته أو قيامه بخطوات زائدة عن الحد (17%)، أو لرغبة المستخدم في تولي الخطوة التالية بنفسه (7%).
تطور الثقة مع اكتساب الخبرة: استخدم المستخدمون الجدد (أقل من 50 جلسة) وضع الموافقة التلقائية الكاملة في قرابة 20% من الجلسات، لترتفع النسبة إلى أكثر من 40% بحلول الجلسة 750. ومن المثير للاهتمام أن المستخدمين المتمرسين قاطعوا الوكيل بنسبة أكبر؛ حيث قاطعوا نحو 9% من التفاعلات مقارنة بقرابة 5% فقط للمستخدمين الذين خاضوا نحو 10 جلسات. وتفسر Anthropic ذلك بأنه مؤشر على المتابعة النشطة وليس تراجعاً عن الإشراف.
ملامح المخاطر عبر الـ API: صدرت 80% من استدعاءات الأدوات عن وكلاء مزودين بضابط حماية واحد على الأقل، مثل الصلاحيات المقيدة أو اشتراطات الموافقة؛ وتبين أن ما يصل إلى 73% منها تضمن تدخلاً بشرياً (واعتبر الباحثون هذه النسبة حداً أقصى تقريبياً)؛ في حين لم تتجاوز الإجراءات غير القابلة للتراجع نسبة 0.8%.
نستنتج من ذلك ثلاثة دروس لفرق المنتجات:
صمم خيار «السؤال» لتقديم خيارات وليس لسد النواقص فقط. السبب الأكبر لتوقف الوكيل كان تقديم بدائل لمسار العمل. اجعل ذلك شاشة رئيسية مدروسة تبرز الخيارات بوضوح.
أغلب المقاطعات سببها غياب السياق. ثلث التدخلات البشرية جاء لتقديم سياق أو تصحيح لم يكن متاحاً لدى الوكيل. تقديم سياق أوضح للمنتج منذ البداية يقلل من تكرار الأسئلة ومقاطعات المستخدم على حد سواء. ويوضح قالب وثيقة متطلبات المنتج لوكلاء البرمجة (PRD) إحدى الطرق العملية لتحقيق ذلك.
صمم آليات للتدخل السريع بدلاً من طلب الموافقة عند كل خطوة. توصي Anthropic بمنح المستخدمين رؤية واضحة وطرقاً سهلة لإعادة توجيه الوكيل، بدلاً من إلزامه بطلب اعتماد رسمي على كل خطوة صغيرة. فالمستخدمون الذين يثقون في الوكيل ما زالوا يطلبون آلية سريعة للتدخل عند الحاجة.
كيف تطبق المنتجات الواقعية مبادئ: اسأل، وتصرّف، وتوقف؟
تمثل أوضاع الصلاحيات (permission modes) في Claude Code نموذجاً واقعياً مطبقاً؛ إذ يحمل كل وضع منها سياسة تسليم مختلفة تماماً (وثائق Claude Code):
وضع Claude Code
ما يفعله دون استئذان
مسار التسليم الذي يمثله
اليدوي (default)
القراءة فقط؛ ويسأل قبل أي تعديل أو أمر بالطرفية أو وصول للشبكة
اسأل قبل أي كتابة
acceptEdits
القراءة، وتعديل الملفات، وأوامر الملفات الشائعة ضمن مجلد العمل
تصرّف في التغييرات منخفضة المخاطر والقابلة للتراجع؛ واسأل عما سواها
plan
القراءة والاستكشاف؛ وتُحظر التعديلات حتى توافق على الخطة
اسأل مرة واحدة في البداية مع تقديم الخطة
auto
كل شيء، مع وجود نموذج مصنف (classifier) يراجع كل إجراء
تصرّف، مع وجود نموذج مراجع يملك صلاحية التوقف
dontAsk
الأدوات المعتمدة مسبقاً فقط؛ ويرفض ما دون ذلك
تصرّف ضمن نطاق محدد وثابت؛ وتوقف عما يتجاوزه
يجدر بنا الانتباه إلى تفصيلين هنا: أولاً، يحظر الوضع التلقائي (auto mode) قائمة من الإجراءات الخطيرة بطبيعتها، كعمليات النشر في بيئات الإنتاج، وترحيل قواعد البيانات، والـ force push في Git، والحذف الجماعي على التخزين السحابي، ودمج طلبات السحب (pull requests) دون اعتماد بشري. هذه هي «قائمة التوقف» (stop list). ثانياً، إذا حظر النموذج المصنف الإجراء 3 مرات متتالية أو 20 مرة إجمالاً، يتوقف الوضع التلقائي مؤقتاً ويعود Claude Code إلى طرح الأسئلة. هذه هي عتبة الفشل (failure threshold)، وهو بالضبط المحفز الأول المذكور في دليل OpenAI. وتظل قواعد المنع الصريحة سارية في جميع الأوضاع دون استثناء، ممثلة حداً صارماً لا يمكن تجاوزه.
ويضيف دليل OpenAI منهجية لتحديد المسار المناسب لكل إجراء: إعطاء كل أداة تقييماً لمستوى المخاطرة (منخفض، متوسط، مرتفع) استناداً إلى طبيعة الصلاحيات (قراءة فقط مقابل كتابة)، وقابلية التراجع، والتفويضات المطلوبة، والأثر المالي؛ ومن ثم التوقف للمراجعة أو التصعيد إلى إنسان قبل تنفيذ العمليات عالية المخاطر. ومن أمثلة الإجراءات التي تستدعي إشرافاً بشرياً: إلغاء الطلبات، واعتماد مبالغ الاسترداد الكبيرة، وتحويل المدفوعات.
وتؤكد إرشادات Anthropic الهندسية المفهوم ذاته: يمكن للوكلاء التوقف لطلب الملاحظات البشرية عند نقاط فحص محددة أو عند مواجهة عقبات، كما يجب عليهم استقاء الحقائق الفعلية من البيئة التشغيلية عند كل خطوة، مع ضرورة وضع شروط توقف واضحة؛ مثل تحديد سقف أقصى لعدد التكرارات المسموحة (Anthropic, 2024).
كيف تكتب عقد تسليم مهام لوكيل الذكاء الاصطناعي؟
صِغ لكل تدفق عمل تدعمه بالذكاء الاصطناعي «نطاق عمل» بلغة واضحة وموجزة، بحيث يسهل مراجعته والتوافق عليه بين فرق المنتجات والتصميم والهندسة وخدمة العملاء.
حقل العقد
السؤال الذي تجيب عنه
المستخدم والمهمة (User and job)
من هو المستخدم وما العمل الذي يحاول إنجازه؟
الإجراءات المسموحة (Allowed actions)
ما الذي يُسمح للمنتج بتجهيزه أو تنفيذه، وما هو تصنيف مخاطره؟
السياق المطلوب (Required context)
ما الحقائق أو الصلاحيات أو المصادر التي يلزم وجودها؟
شرط السؤال (Ask condition)
ما التفاصيل الناقصة أو المتعارضة التي توجب العودة للمستخدم وسؤاله؟
شرط التوقف (Stop condition)
ما الذي يجعل متابعة الإجراء أمراً غير مقبول؟
عتبة الفشل (Failure threshold)
بعد كم محاولة فاشلة يسلم الوكيل المهمة للإنسان؟
التأكيد (Confirmation)
ما الإجراءات التي تتطلب فحصاً بشرياً صريحاً أو موافقة مسبقة؟
التصحيح والتراجع (Recovery)
كيف يمكن للمستخدم تعديل النتيجة أو التراجع عنها أو إعادة إسنادها؟
محفز مراجعة العقد (Review trigger)
ما الإشارة أو الموعد المحدد لإعادة النظر في هذا العقد وتحديثه؟
يصف هذا النطاق سلوك المنتج وليس آليات تنفيذه البرمجية؛ فلا يفرض نموذجاً معيناً، ولا صياغة الـ prompt، ولا واجهة برمجية أو بنية تحتية؛ فهذه تفاصيل توضع في الخطة الهندسية بعد توافق الفريق على ما يُفترض بالمنتج فعله.
انسخ هذا النموذج في ملخص المنتج (product brief):
## عقد التسليم: [تدفق العمل]
بالنسبة لـ [المستخدم] أثناء محاولته [المهمة]، يُسمح للمنتج بـ [الإجراء المسموح]
عندما يتوفر [السياق المطلوب].

اسأل عندما: [تكون المعلومات المحددة للقرار ناقصة أو متعارضة]
توقف عندما: [يحدث تجاوز للحدود، أو تضعف الأدلة، أو يتعذر المصدر، أو تغيب الصلاحية]
عتبة الفشل: سلّم المهمة بعد [n] محاولات فاشلة في [الخطوة]
اطلب التأكيد قبل: [إجراء له تبعات] (المخاطر: منخفضة / متوسطة / مرتفعة)
التصحيح: يمكن للمستخدم [التراجع / التعديل / إعادة الإسناد] عبر [الآلية]
المسؤول: [مدير المنتج] للسياسة التشغيلية، [المهندس] للتنفيذ البرمجي
يُراجع عند: [إشارة معينة، أو حادثة خطأ، أو تاريخ محدد]
بعد ذلك، راجع سيناريوهات واقعية بصحبة مدير المنتج والمهندس والمصمم وأحد المعنيين بالمهمة مباشرة. عدّل العقد باستمرار حتى يصبح لكل حالة مسار بديهي وواضح يفهمه المستخدم ويدرك ما جرى من خلاله.
احتفظ بسجل القرارات
عند اعتماد الفريق للعقد، وثّق التصرفات المسموح بها، والمستخدمين أو المواقف التي يغطيها، والأدلة الداعمة له، والمسؤول عنه، وحالات الاختبار التي تتحقق منه، والمؤشرات التي تستوجب مراجعته. فإذا بدأ المنتج لاحقاً في طرح أسئلة زائدة، أو تصرف بناءً على شواهد ضعيفة، أو توقف دون توفير خطوة تالية مفيدة، سيسهل على الفريق تتبع أصل المشكلة في السياسة الموضوعة. ويكفيك هنا استخدام سجل قرارات المنتج. كما أن هذا التوثيق يمنع تداخل المسؤوليات: فمديرو المنتجات يحددون السلوك المستهدف والتنازلات المسموحة، بينما يتولى المهندسون مسؤولية التنفيذ البرمجي وإدارة الصلاحيات والاعتمادية وأمان التشغيل.
مثال عملي: تحديد أولويات العملاء المحتملين في المبيعات
هذا مثال توضيحي. تخيل ميزة ذكاء اصطناعي تساعد فريق المبيعات في تصنيف العملاء المحتملين وترتيب أولوياتهم. قد تبدو شركة كبرى ذات تمويل ضخم فرصة واعدة ومغرية، ولكن قد تكون شركة أخرى أصغر أظهرت إشارة شراء واضحة الأسبوع الماضي أكثر جاهزية وأهمية من حيث التوقيت. كلا الأمرين صحيح؛ ومن هنا يحتاج المنتج إلى سياسة واضحة تحدد أيهما يقدم على الآخر.
يمكن أن ينص العقد على ما يلي:
الإجراء المسموح: اقتراح مستوى الأولوية (المخاطر: منخفضة، لأنه مجرد اقتراح) مع استعراض الأدلة الداعمة له.
السياق المطلوب: معايير ملاءمة الحسابات المعتمدة لدى الفريق، وتاريخ ومصدر كل مؤشر شراء.
اسأل: اطلب من الفريق تحديد قاعدة الأولوية إذا لم تكن مواصفات «أفضل عميل محتمل» محددة بوضوح بعد.
توقف: لا تستنتج نية الشراء من مجرد حجم الشركة، ولا تدّعِ جاهزية العميل للشراء دون وجود مصدر معتمد.
عتبة الفشل: إذا فشلت عملية إثراء البيانات مرتين لأحد الحسابات، ضعه تحت تصنيف «يحتاج مراجعة يدوية» بدلاً من التخمين.
التأكيد: يراجع مندوب المبيعات مستوى الأولوية قبل تطبيقه على الـ pipeline المشترك (المخاطر: متوسطة، لأن زملاء آخرين يبنون قراراتهم عليه).
التصحيح: يمكن للمراجع تعديل تصنيف الأولوية مع توثيق سبب التغيير.
يبرز هذا العقد قراراً لا يمكن للنموذج حسمه بمفرده: هل يجب على الفريق تقديم معيار ملاءمة الشركة، أم حداثة إشارة الشراء، أم تحقيق توازن صريح بينهما؟ هنا تبرز خبرة مدير المنتج في مجاله، أو دوره في جمع المعنيين لتوضيح هذه الخيارات وجعلها قابلة للفحص. يطبق النموذج القاعدة المتفق عليها، ولا ينبغي له أن يخترعها.
كيف تختبر عقد التسليم قبل إطلاق المنتج؟
أنشئ مجموعة صغيرة من الحالات الممثلة للواقع، واختبر ما إذا كان المنتج يختار المسار المناسب ويوضح أسبابه بشفافية. واحرص على تضمين الحالات التالية:
الطلب مكتمل والإجراء قابل للتراجع (المتوقع: تصرّف).
غياب معلومة لازمة وتغيّر النتيجة بناءً على الإجابة (المتوقع: اسأل).
تعارض بين مصدرين للبيانات (المتوقع: اسأل مع عرض كلا المصدرين).
طلب المستخدم أمراً يتجاوز الصلاحيات المحددة له (المتوقع: توقف).
الأدلة المتوفرة أضعف من أن تبرر حجم التبعات (المتوقع: توقف أو اسأل).
فشل خدمة يعتمد عليها النظام أو تعذر الوصول إلى المصدر (المتوقع: أعد المحاولة حتى العتبة، ثم سلّم للإنسان).
سجل لكل حالة المسار المتوقع والسبب وما يظهر للمستخدم؛ على سبيل المثال: «اسأل لغياب تاريخ مؤشر الشراء؛ اعرض مصدر الحساب ودع مندوب المبيعات يضيفه أو يتجاوزه». هذه صياغة يمكن اختبارها بوضوح، على عكس التوجيهات العامة مثل «توخَّ الحذر».
ناقش المخرجات الواقعية مع أصحاب الخبرة العملية في هذا المجال. وإذا اختلف المراجعون في تقييمهم، لا تكتفِ بأخذ متوسط درجاتهم والمضي قدماً؛ بل ابحث عن القرار الجوهري الغائب في السياسة؛ فقد يفضل أحد المراجعين ملاءمة الشركة بينما يركز الآخر على الإلحاح الزمني. احسم هذا الخلاف، وثّقه في العقد، وأضف حالة اختبار عملية تجعل هذا التمييز قابلاً للاختبار. تتلخص الدورة في: مراقبة حالة، وتحديد موضع التقدير البشري، والاتفاق على السياسة، وتحديث الحالات، ثم إعادة مراجعة السلوك مجدداً. ويوضح إطار تقييم الذكاء الاصطناعي لفرق المنتجات كيفية تحويل هذه الحالات إلى مجموعة تقييم متكاملة (eval set).
ولا تغني هذه الحالات التجريبية عن المراقبة المباشرة في بيئة الإنتاج أو ضوابط الأمان الهندسية، بل تضمن توافق الفريق مسبقاً على ما يُفترض بالمنتج تحقيقه.
كيف تجعل خيار «السؤال» حالة منتج مفيدة؟
اللجوء للسؤال لا يعني بالضرورة زيادة الأمان؛ فكثرة المقاطعات تلقي بعبء العمل مجدداً على كاهل المستخدم وتترك انطباعاً بأن الميزة غير مكتملة. ينبغي ألا يظهر السؤال إلا إذا كانت الإجابة ستغير النتيجة فعلياً. وتتعامل المبادئ الـ 18 للتفاعل بين الإنسان والذكاء الاصطناعي من مايكروسوفت — والتي تلخص أبحاثاً تزيد عن 20 عاماً — مع تصرف النظام عند الخطأ كمرحلة تصميمية مستقلة بذاتها ومفصولة عن مسار التفاعل الاعتيادي (Microsoft Research, 2019).
تتضمن شاشة التسليم الجيدة والمفيدة ما يلي:
ما استنتجه النظام وأنجزه حتى هذه اللحظة
المعلومة الناقصة أو المتعارضة تحديداً
توضيح كيف ستؤثر هذه المعلومة على الخطوة التالية
تقديم خيارين إلى أربعة خيارات واضحة، تشمل «التقرير لاحقاً» إن كان ذلك آمناً
إذا كان بإمكان المستخدم تصحيح النتيجة بأمان بعد رؤية المعاينة، فقد تكون خطوة التأكيد أفضل من طرح سؤال مفتوح. وإذا كان المنتج قادراً على تنفيذ إجراء قابل للتراجع مع إتاحة خيار تراجع واضح، فقد لا يحتاج لمقاطعة المستخدم على الإطلاق.
أخطاء شائعة في تسليم مهام وكيل الذكاء الاصطناعي
اعتبار الثقة صلاحية. تشير النسبة المئوية إلى مدى يقين النموذج من إجابته، وليس إلى امتلاكه تفويضاً من المستخدم بتنفيذ الإجراء.
السؤال عن كل صغيرة وكبيرة. تكرار طلبات الاعتماد يدرب المستخدمين لا إرادياً على النقر على «موافقة» دون قراءة، وهو ما يوقعهم عمداً في فخ «انحياز الأتمتة».
التوقف في طريق مسدود دون خطوة بديلة. الاكتفاء بعبارة «لا يمكنني المساعدة في هذا» دون تقديم تبرير أو توفير مسار للتواصل مع إنسان يضع المستخدم أمام باب مغلق.
إهمال عتبات الفشل. بدون حد أقصى للمحاولات، قد يدخل الوكيل في حلقة تكرار لا نهائية عند تعثر إحدى الخطوات. حدد رقماً واضحاً وسلّم المهمة فور بلوغه.
تطبيق عقد موحد على جميع الإجراءات. تصفح البيانات للقراءة فقط يختلف جذرياً عن سداد المدفوعات من حيث المسار المطلوب؛ لذا ينبغي تقييم مخاطر كل إجراء على حدة.
السياسات غير المعلنة. إذا اختلف المراجعون حول الإجابة الصحيحة، فالعيب يكمن في غياب قاعدة واضحة في العقد، وليس في النموذج نفسه.
إغفال محفز مراجعة العقد. يتغير سلوك الوكلاء وطباع المستخدمين باستمرار؛ لذا حدد من البداية الإشارة أو التاريخ الذي يوجب إعادة فتح العقد ومراجعته.
دور منصة Specky
يطبق خادم بروتوكول سياق النموذج (MCP) الخاص بـ Specky هذا المبدأ على الوكلاء الذين يعملون داخل مساحة عمل المنتجات: إذ ينشئ الوكلاء وثائق الـ PRD والأفكار والقرارات والتذاكر في حالة مسودة (draft) أو مقترح (proposed)، ليكون صندوق وارد مدير المنتج (PM Inbox) هو طابور المراجعة والاعتماد، ولا يحدث النشر التلقائي إلا إذا طلب المستخدم ذلك صراحة في نفس أمر التفاعل. ويمكنك توثيق كل عقد تسليم داخل سجل القرارات (Decision Log) مباشرة إلى جانب الأدلة والبيانات التي استندت إليها في صياغته. لمعرفة المزيد حول هذا المسار الموسع، تفضل بزيارة Specky لمديري المنتجات التقنيين.
الأسئلة الشائعة
ما هو تسليم مهام وكيل الذكاء الاصطناعي (AI agent handoff)؟
تسليم مهام وكيل الذكاء الاصطناعي هو نقل ميزة الذكاء الاصطناعي التحكم إما إلى وكيل آخر أو إلى إنسان. وفي تصميم المنتجات، يشير هذا المصطلح غالباً إلى التسليم من الوكيل للإنسان: حيث يطلب الوكيل معلومات ناقصة، أو يطلب الموافقة قبل تنفيذ إجراء مهم، أو يتوقف كلياً ليتولى شخص ما المتابعة. ويحدد عقد التسليم هذه المحفزات بدقة قبل مرحلة الإطلاق.
متى ينبغي لوكيل الذكاء الاصطناعي أن يطلب تأكيداً؟
يطلب التأكيد قبل الإجراءات ذات الأثر الملموس التي تقع ضمن نطاق صلاحياته: مثل إرسال رسائل للعملاء، أو تعديل السجلات المشتركة، أو الإنفاق المالي، أو أي إجراء يصعب التراجع عنه. قيّم كل إجراء بدرجة مخاطرة (منخفضة، أو متوسطة، أو مرتفعة) بناءً على صلاحيات التعديل، وقابلية التراجع، والتراخيص المطلوبة، والأثر المالي؛ واشترط التأكيد للإجراءات المتوسطة والمرتفعة. أما الإجراءات منخفضة المخاطر والقابلة للتراجع، فيمكن تنفيذها مباشرة مع إتاحة خيار تراجع بارز.
ما الفرق بين التسليم من وكيل إلى وكيل والتسليم من وكيل إلى إنسان؟
التسليم من وكيل إلى وكيل هو تفويض داخلي ضمن المنظومة: كما في مكتبة Agents SDK من OpenAI، حين يمرر وكيل الفرز طلب استرداد مالي إلى وكيل الاسترداد عبر استدعاء أداة برمجية. أما التسليم من وكيل إلى إنسان فهو إعادة التحكم إلى شخص حقيقي لعجز الوكيل عن المتابعة أو لعدم ملاءمة ذلك؛ فالأول خيار يتعلق بإدارة التنسيق والتشغيل (orchestration)، بينما الثاني قرار متعلق بالمنتج وإدارة الصلاحيات والمخاطر.
هل يكفي «إبقاء الإنسان في حلقة التحكم» لضمان أمان وكيل الذكاء الاصطناعي؟
كلا. لا يحقق المراجع البشري الفائدة المرجوة إلا إذا امتلك الأدلة الداعمة، والوقت الكافي، ووسيلة واضحة وسهلة للاعتراض. وقد أظهرت مراجعة شملت 74 دراسة أن النصائح الخاطئة الصادرة عن أنظمة الدعم رفعت نسبة اتخاذ القرارات غير الصحيحة بمقدار 26%. حدد بدقة من يراجع ماذا، وما الذي يراه، وما الذي يحق له تعديله، وما الإجراء المتخذ في حال عدم استجابة أحد.
كم مرة ينبغي لوكيل الذكاء الاصطناعي أن يقاطع المستخدم؟
ينبغي ألا يقاطعه إلا إذا كانت الإجابة كفيلة بتغيير مخرجات القرار، أو كان الإجراء يتطلب صلاحيات لا يملكها الوكيل. وتكشف بيانات Anthropic لعام 2026 أن Claude Code طلب استيضاحات في المهام المعقدة بنسبة أكبر من المهام البسيطة، بينما قاطع المستخدمون ذوو الخبرة الوكيل في نحو 9% فقط من التفاعلات. احرص على قياس معدل طرح الأسئلة في منتجك ونسبة ما يجيب عنه المستخدمون بإجابات مفيدة ومؤثرة.
هل يفرض قانون الذكاء الاصطناعي في الاتحاد الأوروبي (EU AI Act) تسليماً بشرياً لوكلاء الذكاء الاصطناعي؟
تفرض المادة 14 على الأنظمة عالية المخاطر تمكين المشرفين البشريين من استيعاب حدود قدرات النظام، والتنبه لانحياز الأتمتة، والقدرة على تجاوز مخرجات النظام أو إلغائها وإيقافه كلياً. وبعد اعتماد حزمة الـ Digital Omnibus، ستسري هذه الالتزامات على الأنظمة عالية المخاطر المشمولة بالملحق الثالث اعتباراً من 2 ديسمبر 2027. ورغم أن أغلب وكلاء المنتجات لا يندرجون تحت هذه الفئة، إلا أن نهج: اسأل، وتجاوز، وتوقف يعد أفضل الممارسات الموصى باتباعها.
GDPR-aligned. EU workspace data is stored in Frankfurt, Germany. GDPR and EU data Built in Vienna, Austria. A product of influence solutions fm GmbH (FN 675374y). Imprint 14-day trial. Card required, and nothing is charged until day 14. 30-day refund after subscribing. See pricing