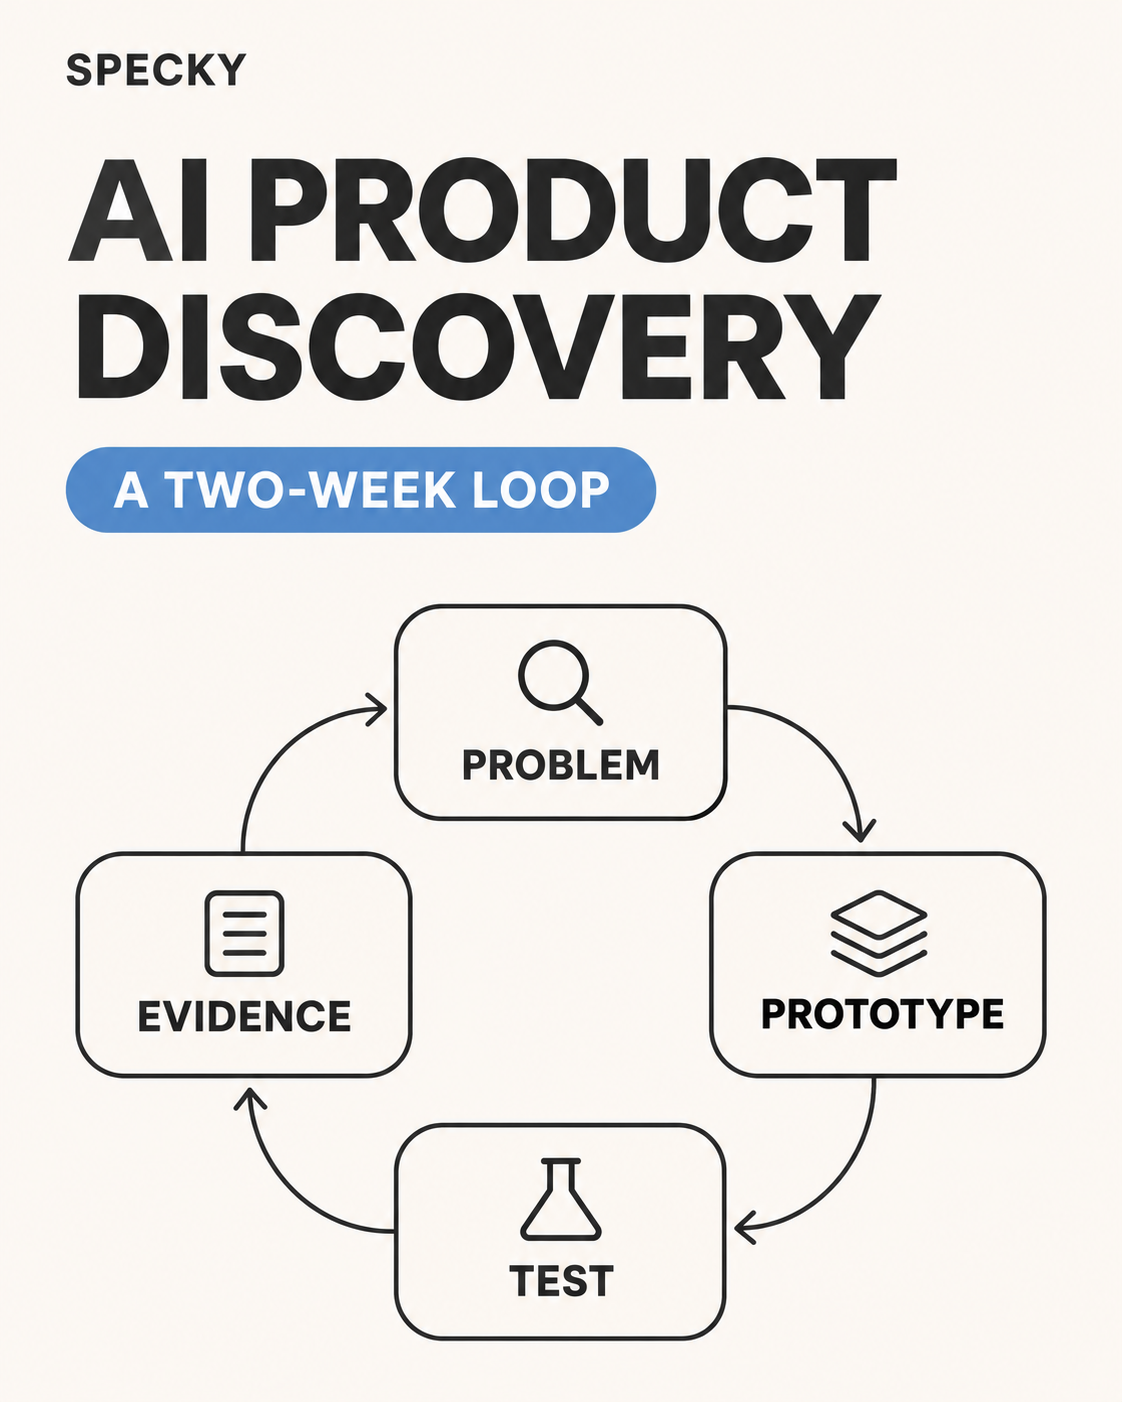
اكتشاف المنتج بالذكاء الاصطناعي للشركات الناشئة: سير عمل عملي في أسبوعين
الذكاء الاصطناعي يجعل النماذج الأولية رخيصة، لذلك أصبح الـ discovery هو العمل الذي يمنع الفرق الصغيرة من بناء الشيء الخطأ. استخدم هذه الحلقة التي تمتد أسبوعين لاختبار مشكلة حقيقية قبل أن توسّع نطاق البناء.
اكتشاف المنتج بالذكاء الاصطناعي (AI product discovery) هو عمل اتخاذ القرار بشأن ما سيُبنى، وبشأن ما إذا كان للذكاء الاصطناعي مكان فيه، استنادًا إلى أدلة من العملاء لا إلى مدى سرعة ظهور النموذج الأولي. وبالنسبة إلى شركة ناشئة، تتسع نسخة عملية منه لأسبوعين: حدّد قرارًا واحدًا، واجمع أدلة مباشرة، واختر أخطر افتراض، واختبره بأصغر نموذج أولي ممكن، ثم سجّل ما إذا كنتم ستواصلون أو تغيّرون أو تتوقفون مؤقتًا أو توقفون العمل.
أهم النقاط
أصبح البناء أرخص؛ أما معرفة ما يجب بناؤه فلم تصبح أرخص. 84% من المطوّرين يستخدمون أدوات الذكاء الاصطناعي أو يخططون لاستخدامها، ومع ذلك يقول 66% إن أكبر إحباط لديهم هو مخرجات «صحيحة تقريبًا، لكن ليست تمامًا» (Stack Overflow، 2025).
تبدو السرعة حقيقية حتى حين لا تكون كذلك. في تجربة METR لعام 2025، استغرق مطوّرون ذوو خبرة وقتًا أطول بنسبة 19% مع الذكاء الاصطناعي، بينما اعتقدوا أنهم أسرع بنسبة 20% (METR، 2025).
معظم ما يُسلَّم من عمل لا يُستخدم: 80% من الميزات في المنتج المتوسط نادرًا ما تُستخدم أو لا تُستخدم أبدًا (Pendo، 2019).
43% من الشركات الناشئة المدعومة برأس مال مغامر التي أغلقت منذ 2023 ذكرت ضعف ملاءمة المنتج للسوق (product-market fit) (CB Insights، 2026).
يستطيع الذكاء الاصطناعي تنظيم الأدلة وبناء أدوات الاختبار. لكنه لا يستطيع أن يكون هو الدليل: فالمستخدمون المحاكَون يأتون إيجابيين أكثر من اللازم وسطحيين أكثر من اللازم (Nielsen Norman Group، 2024).
لماذا يصبح اكتشاف المنتج أهم حين يجعل الذكاء الاصطناعي البناء رخيصًا؟
تحوّل أدوات البرمجة بالذكاء الاصطناعي الفكرة إلى نموذج أولي يعمل في ظهيرة واحدة. في استطلاع Stack Overflow Developer Survey لعام 2025، قال 84% من المشاركين إنهم يستخدمون أدوات الذكاء الاصطناعي في التطوير أو يخططون لذلك، ويستخدمها 47.1% يوميًا (Stack Overflow، 2025). ولا شيء من ذلك يخبرك بما إذا كانت المشكلة تهمّ أحدًا.
رقمان يوضحان كلفة تجاوز الـ discovery. وجد تحليل Pendo لـ 615 اشتراكًا في منتجات أن 12% من الميزات تولّد 80% من الاستخدام اليومي، وأن 80% منها نادرًا ما تُستخدم أو لا تُستخدم أبدًا (Pendo، 2019). وحين راجعت CB Insights 431 شركة مدعومة برأس مال مغامر أغلقت منذ 2023، وجدت أسبابًا لـ 385 منها؛ وذكرت نسبة 43% ضعف ملاءمة المنتج للسوق ().
وهناك أيضًا فخ الإدراك. أجرت METR تجربة عشوائية مع 16 مطوّرًا من ذوي الخبرة في المصادر المفتوحة على 246 مهمة حقيقية. توقّع المطوّرون أن يسرّعهم الذكاء الاصطناعي بنسبة 24%؛ ومع السماح به استغرقت المهام وقتًا أطول بنسبة 19%، ومع ذلك قدّروا بعد ذلك أنهم كانوا أسرع بنسبة 20% (METR، 2025). ونبّهت METR منذ ذلك الحين إلى أن هذه نتائج مطلع 2025، ونشرت دراسة متابعة عن أدوات أحدث، لكن الدرس يصلح للـ discovery: إذا عجز الفريق عن معرفة ما إذا كان الذكاء الاصطناعي جعل البرمجة أسرع، فسيجد صعوبة في معرفة ما إذا كان عرض تجريبي أنيق قد أثبت وجود طلب.
إذن يتحرك عنق الزجاجة. حين يكون التنفيذ رخيصًا، يصبح الـ discovery هو العمل الذي يمنع فريقًا صغيرًا من بناء المزيد من الخطأ، وبسرعة أكبر.
ما هو اكتشاف المنتج الموجَّه بالذكاء الاصطناعي؟
تشمل العبارة مهمتين. الأولى استخدام الذكاء الاصطناعي داخل عملية الـ discovery: صياغة رسائل التواصل، وتفريغ المقابلات ووسمها، وتجميع الملاحظات في مجموعات، وسرد الافتراضات الخفية، وبناء نماذج أولية للاختبار. والثانية اكتشاف ما إذا كانت ميزة الذكاء الاصطناعي تستحق البناء أصلًا. يغطي سير العمل هذا الأمرين، وفي كليهما يظل أفراد الفريق مسؤولين عن الأدلة وعن القرار.
المقابلات الاستكشافية العميقة التي لا يُعرف مسارها مسبقًا
التحليل والتركيب
التجميع، والوسم، وملخصات أولية مرتبطة بمصادرها
الحكم على معنى النمط
الافتراضات
سرد الافتراضات الخفية، والدفاع عن الحالة المعاكسة
ترتيبها بحسب خطرها على القرار
النماذج الأولية
بناء نموذج قابل للنقر أو شريحة رقيقة في ساعات
اختيار ما يجب أن يُظهره الاختبار
القرار
صياغة سجل القرار
اتخاذ القرار وتحمّل مسؤوليته
يرسم الممارسون هذا الخط فعلًا. في استطلاع أجرته Nielsen Norman Group عام 2026 على 521 من ممارسي تجربة المستخدم، قال 67% ممن يحللون بيانات الأبحاث إنهم يستخدمون الذكاء الاصطناعي كثيرًا أو دائمًا في هذه المهمة، لكن 11% فقط استخدموا مُحاوِرين بالذكاء الاصطناعي، و61% لم يستخدموا الذكاء الاصطناعي قط لإجراء مقابلات مع المستخدمين (Nielsen Norman Group، 2026). يُوثَق بالذكاء الاصطناعي في التحليل أكثر بكثير مما يُوثَق به في المحادثة نفسها. (إذا أردت أن تقيّم المُحاوِرين بالذكاء الاصطناعي تقييمًا جيدًا، فاطّلع على دليلنا عن مقابلات العملاء التي يديرها الذكاء الاصطناعي.)
ماذا ينبغي أن يجيب عنه الـ discovery قبل أن تفتح وكيل برمجة؟
وضّح خمسة أسئلة أولًا:
من هو المستخدم، وما المهمة الأخيرة التي يحاول إنجازها؟
ما الدليل على أن المهمة مؤلمة أو مهمة؟
ما الذي لا يزال افتراضًا؟
لماذا قد يساعد الذكاء الاصطناعي أكثر من سير عمل أبسط أو قاعدة حتمية؟
أي نتيجة ستغيّر قرار المنتج التالي؟
وهي تقابل المخاطر الأربعة الكبرى عند مارتي كاجان: القيمة (هل سيستخدمونه أو يشترونه)، وسهولة الاستخدام (هل سيتمكنون من فهمه)، والجدوى التقنية (هل نستطيع بناءه)، والجدوى التجارية (هل ينجح للأعمال) (SVPG، 2017). وتضيف ميزات الذكاء الاصطناعي فحصًا آخر: هل يتفوق النموذج على خط أساس أبسط؟ يغطي اختبارنا ذو الأسئلة الأربعة لمعرفة ما إذا كان ينبغي أن تستخدم الميزة الذكاء الاصطناعي هذه المقارنة.
إذا لم تستطع الإجابة عن الأسئلة الخمسة بعد، فالخطوة التالية محادثة مع عميل، أو مراجعة تذاكر الدعم، أو اختبار يدوي، لا نموذج أولي أكبر.
كيف تدير حلقة اكتشاف منتج بالذكاء الاصطناعي في أسبوعين؟
اعتبر التوقيت عونًا على التخطيط لا وعدًا. يستطيع مؤسس منفرد ضغطه؛ وقد يحتاج منتج خاضع للتنظيم أو عالي المخاطر إلى مراجعة أكثر. حافظ على الترتيب: تعلّم، ثم اختر خطرًا، ثم اختبر، ثم قرّر.
الأيام
العمل
المخرَج
1–2
تحديد القرار
مستخدم واحد، ومهمة واحدة، وقرار واحد يمكن للأدلة أن تغيّره
3–4
جمع أدلة مباشرة
ملاحظات مرتبطة بمحادثات حقيقية، وسلوك مُلاحَظ، وتذاكر أو بيانات استخدام
5–6
اختيار أخطر افتراض
اختبار له إشارة نجاح وشرط فشل، مكتوبان
7–8
بناء أصغر اختبار مفيد
نموذج، أو خدمة concierge، أو نموذج أولي، أو شريحة من سير العمل
9–10
الملاحظة والقرار
سجل قرار: المواصلة، أو التغيير، أو الإيقاف المؤقت، أو التوقف
اليومان 1–2: حدّد قرارًا واحدًا
اكتب جملة واحدة:
هل ينبغي أن نساعد [مستخدمًا محددًا] على إنجاز [مهمة محددة] عن طريق [التغيير المقترح]؟
ثم اسرد الافتراضات التي تقوم عليها، مفصولة بحسب النوع:
افتراض المشكلة: يقضي مهندس منتج منفرد وقتًا حقيقيًا في تحويل طلبات المستخدمين المتفرقة إلى قرار بشأن ما سيُبنى.
افتراض الحل: يمكن لسير عمل مدعوم بالذكاء الاصطناعي تنظيم تلك الأدلة دون أن يفقد المصدر أو يبالغ فيما تثبته.
افتراض المخاطر: يستطيع المستخدم أن يتحقق من النتيجة ويصحّحها قبل أن تؤثر في قرار بناء.
هذه أمثلة توضيحية، لا ادعاءات عملاء. الهدف أن يصبح كل افتراض مرئيًا لتختبرها واحدًا تلو الآخر؛ وتفعل خريطة الافتراضات المجانية ذلك في دقائق.
اختر مجموعة ضيقة بحسب الدور أو سير العمل أو القيد. عبارة «الشركات الناشئة» واسعة جدًا. أما «المؤسسون التقنيون لأدوات B2B الذين يقرؤون محادثات الدعم قبل ترتيب الأولويات» فتمنح الاختبار نقطة انطلاق.
اليومان 3–4: اجمع أدلة مباشرة
ابدأ بمواد يستطيع فريقك فحصها:
ملاحظات من محادثات عن مهمة حديثة ومحددة
طلبات الدعم وأسئلة الـ onboarding
بيانات استخدام المنتج التي تُظهر أين يتوقف الناس أو يكررون العمل
مشاركة شاشة أو ملاحظة لتنفيذ مهمة
مكالمات المبيعات أو نجاح العملاء، موسومة بسياقها
افصل الملاحظات عن التفسيرات. «نسخ المستخدم بيانات الحساب نفسها إلى ثلاث شاشات» ملاحظة. «يحتاج إلى وكيل ذكاء اصطناعي» فرضية.
كم محادثة؟ تقترح Nielsen Norman Group أن تبدأ بخمس أو ست، وأن تحلل أثناء العمل، وتتوقف حين تكفّ المقابلات الجديدة عن إضافة شيء. في دراسة Guest وBunce وJohnson ظهر 34 من أصل 36 رمزًا متكررًا بعد ست مقابلات؛ وقدّر عمل Griffin وHauser عن احتياجات العملاء أن 20–30 مقابلة تكشف 90–95% من الاحتياجات في فئة واسعة (Nielsen Norman Group، 2021). في حلقة تمتد أسبوعين حول مهمة واحدة ضيقة، تكفي عادةً خمس إلى ثماني محادثات لإيجاد اللغة والأسباب المحتملة. لكنها لا تكفي أبدًا لتقدير مدى شيوع المشكلة؛ فذلك يحتاج دراسة كمية.
استخدم أسئلة قائمة على القصص («حدّثني عن آخر مرة…») لا «هل كنت ستستخدم…؟». يتضمن قالب مقابلة العملاء لدينا نصًّا يمكنك نسخه. دع الذكاء الاصطناعي يفرّغ ويوسم ويربط كل ملاحظة بمصدرها؛ ولا تدعه يملأ الفجوات.
اليومان 5–6: اختر الافتراض الأعلى خطرًا على القرار
لا تختبر كل مجهول. أعطِ كل افتراض درجة من 1 إلى 5 على سؤالين، ثم اضرب:
الأثر: إذا كان هذا خطأ، فكم من إعادة العمل أو الضرر بالمستخدم سيترتب؟
عدم اليقين: ما مدى قلة الأدلة المباشرة لدينا؟
اختبر أعلى حاصل ضرب أولًا. في ميزة الذكاء الاصطناعي، لا يكون الافتراض الخطِر غالبًا «هل يريدونها» بل «هل يستطيع النظام التعامل مع تنوّع المدخلات الحقيقية» أو «هل يستطيع الناس اكتشاف خطأ قبل أن يهمّ».
ضع دائمًا خط أساس أبسط إلى جانب نسخة الذكاء الاصطناعي. يستحق النموذج مكانه حين تكون المدخلات متغيرة أو غير منظّمة ويكسب المستخدم شيئًا لا تقدمه قاعدة أو مربع بحث أو قالب.
اليومان 7–8: ابنِ ما يحتاجه الاختبار فقط
النموذج الأولي أداة للتعلّم، لا دليل في ذاته. ابنِ ما يكفي فقط لعرض الافتراض الخطِر على الشخص المناسب:
نموذج قابل للنقر لسؤال عن سير العمل
نسخة concierge، يُنتج فيها شخص النتيجة يدويًا
نموذج أولي ضيق يعمل على مجموعة صغيرة وممثِّلة من المدخلات الحقيقية
تنفيذ رقيق خلف إطلاق محدود
خط أساس بلا ذكاء اصطناعي للمقارنة
اكتب ما ستلاحظه قبل أن تبني. إذا كان السؤال هو هل يستطيع المستخدمون مراجعة ملخص يولّده الذكاء الاصطناعي وتصحيحه، فيجب أن يتضمن الاختبار التصحيح. وإذا كان وكيل برمجة بالذكاء الاصطناعي يبني الاختبار، فأعطه تكليفًا محدود النطاق: المستخدم، والمهمة، والأدلة، والنطاق، والسلوك المتوقع، وحالات الفشل، وكيف ستتحقق من النتيجة. قالب PRD لوكلاء البرمجة بالذكاء الاصطناعي نقطة بداية.
في أسئلة سهولة الاستخدام، يُعدّ خمسة مشاركين افتراضًا سليمًا. يُظهر نموذج Jakob Nielsen أن خمسة مستخدمين يكتشفون نحو 85% من مشكلات سهولة الاستخدام، ويوصي بثلاث جولات من خمسة، مع إصلاحات بينها، بدلًا من جولة واحدة من 15 (Nielsen Norman Group، 2000).
اليومان 9–10: لاحظ مهمة حقيقية ثم قرّر
اطلب من أشخاص من المجموعة المستهدفة إنجاز مهمة واقعية. راقب قبل أن تسأل عن رأيهم. دوّن أين يترددون، أو يصحّحون المخرجات، أو يلجؤون إلى حل بديل، أو يتوقفون.
اختر إشارة نجاح أو اثنتين تناسبان المهمة: الإنجاز، أو الوقت اللازم للإنهاء، أو معدل التصحيح، أو نجاح التسليم، أو هل يعودون. وفي ميزات الذكاء الاصطناعي، سجّل أيضًا حالات الفشل المهمة، وزمن الاستجابة، وكلفة كل تشغيل حين تؤثر في التجربة. ودرجة تقييم أفضل في الاختبار غير المتصل ليست دليلًا على تحسّن تجربة المستخدم.
القرار
استخدمه حين
المواصلة
تكون المشكلة مدعومة وحقق الاختبار إشارة النجاح المكتوبة مسبقًا
التغيير
تبدو المشكلة حقيقية، لكن سير العمل أو الجمهور أو السلوك لم يتطابق
الإيقاف المؤقت
لا يزال مجهول عالي الخطورة يحتاج إلى أدلة أو مراجعة
التوقف
تضعف الأدلة المشكلة، أو يضيف الحل القليل مقارنة بخيار أبسط
هذا ليس إثباتًا إحصائيًا لملاءمة المنتج للسوق. لكنه يجعل القرار التالي قابلًا للتتبع بدل أن يتوقف على من كتب أكثر الأوامر (prompts) ثقة.
كيف تبدو الحلقة عمليًا؟
ما يلي مثال توضيحي، وليس شركة حقيقية.
لنفترض أن فريق B2B من أربعة أشخاص يعتقد أن قادة الدعم يفقدون ساعات كل أسبوع في تحويل التذاكر إلى تقرير أخطاء لفريق الهندسة، ويريد بناء أداة تلخيص بالذكاء الاصطناعي.
اليومان 1–2. القرار: هل ينبغي أن نساعد قادة الدعم في شركات SaaS التي يعمل بها 20–100 شخص على إعداد تقرير الأخطاء الأسبوعي عبر صياغته من التذاكر؟
اليومان 3–4. ست مقابلات. خمسة من ستة يُعدّون هذا التقرير؛ أربعة يقضون فيه 60–90 دقيقة كل أسبوع؛ واثنان يلصقان التذاكر في روبوت محادثة بالفعل ويصحّحان المخرجات يدويًا.
اليومان 5–6. «يكتبون التقرير أسبوعيًا» تحصل على أثر 5 × عدم يقين 1 = 5. «يثقون بمسودة الذكاء الاصطناعي بما يكفي لإرسالها بعد مراجعة قصيرة» تحصل على 5 × 4 = 20. يُختبر الثاني. إشارة النجاح، المكتوبة قبل الاختبار: أن يرسل 3 على الأقل من 5 قادة المسودة بعد 15 دقيقة تحرير أو أقل.
اليومان 7–8. اختبار concierge: يصوغ المؤسس كل تقرير بنموذج لغوي من التذاكر الحقيقية المصدَّرة من القائد، إلى جانب جدول بسيط لعدد التذاكر كخط أساس بلا ذكاء اصطناعي.
اليومان 9–10. أرسل أربعة من خمسة المسودة؛ وكان الوسيط الزمني للتحرير 12 دقيقة. لكن ثلاثة من خمسة فضّلوا الجدول البسيط لقسم الأعداد ولم يثقوا بالذكاء الاصطناعي إلا في الجزء السردي.
تحققت إشارة النجاح، ومع ذلك فالقرار هو التغيير لا المواصلة: ابنِ الأعداد كجدول حتمي، واستخدم الذكاء الاصطناعي لفقرة الملخص فقط. وهذه نسخة أولى أصغر وأرخص وأجدر بالثقة من تلك التي بدأ بها الفريق.
أمر ذكاء اصطناعي قابل لإعادة الاستخدام لاكتشاف مدعوم بالأدلة
استخدم الذكاء الاصطناعي لتنظيم مواد تقدّمها أنت، لا لاختلاق أدلة سوقية. أبقِ ملاحظات المصدر متاحة ليتمكن شخص من التحقق من كل ادعاء.
أنت تساعد فريق منتج صغيرًا على تحضير قرار discovery واحد. استخدم الأدلة التي أقدّمها فقط.
افصل بين الملاحظات المباشرة وأقوال المستخدمين وتفسيرات الفريق والأسئلة التي بلا إجابة. اربط كل ملاحظة بوسم مصدرها. أشِر إلى التناقضات والسياق الناقص. لا تختلق اقتباسات أو مستخدمين أو حجم سوق أو تكرارات أو نسبًا مئوية.
من هذه الأدلة، حدّد الافتراض الواحد الذي قد يغيّر القرار أكثر من غيره. اقترح أصغر اختبار يمكنه تقليل ذلك الغموض. ضمّن المستخدم المستهدف، والمهمة، والسلوك المتوقع، وحالات الفشل المحتملة، وإشارة نجاح أو اثنتين قابلتين للملاحظة، والنتيجة التي ستغيّر القرار. قارن نهج الذكاء الاصطناعي بخط أساس أبسط. صنّف كل التوصيات فرضيات إلى أن تُختبر.
راجع المخرجات بمقارنتها بالملاحظات الأصلية. وإذا عجز النموذج عن الإشارة إلى مصدر لادعاء ما، فاحذف الادعاء أو اذهب واحصل على الدليل.
كيف تقيّم أداة اكتشاف منتج موجَّهة بالذكاء الاصطناعي؟
قبل أن تثق بتوصيات أداة، شغّلها على قرار سابق تعرف نتيجته مسبقًا، ثم تحقق من سبعة أمور:
الاستشهادات. هل يرتبط كل موضوع أو ادعاء باقتباس أو تذكرة أو مكالمة تستطيع فتحها؟
الملاحظة مقابل التفسير. هل تفصل ما قاله الناس عمّا استنتجه النموذج؟
أعداد لا صفات. هل تخبرك بعدد المصادر التي تدعم موضوعًا («6 من 14 مكالمة») بدل أن تسميه «إشارة قوية»؟
المراجعة البشرية. هل يستطيع شخص تصحيح المخرجات أو رفضها قبل أن تصل إلى مواصفة أو تذكرة؟
الموافقة ومعالجة البيانات. أين تُخزَّن البيانات، وهل يُطلب من المشاركين في المقابلات موافقتهم ويُخبَرون حين يتحدثون إلى ذكاء اصطناعي؟
حدود صادقة. هل تقول متى تكون الأدلة ضعيفة، أم تعود كل فكرة بصيغة تبدو جيدة؟ المجاملة هي العيب الذي وجدته Nielsen Norman Group في المستخدمين المحاكَين (2024).
ملاءمة الباقة المجانية. هل تستطيع إجراء حلقة كاملة على الباقة المجانية أو التجريبية قبل أن تدفع؟ وإن لم تستطع، فاختبرها على القرار الوارد أعلاه على أي حال، ضمن حد زمني.
الأداة التي تفشل في الأمور الثلاثة الأولى ستجعلك أسرع في الخطأ.
ما الأخطاء التي ترتكبها الفرق حين تستخدم الذكاء الاصطناعي لتتحرك أسرع؟
اعتبار نموذج أولي مولَّد تحققًا. هو يثبت أن شيئًا ما يمكن بناؤه، لا أن المستخدم المستهدف يحتاج إليه.
استخدام مستخدمين اصطناعيين كدليل من العملاء. يمكن للذكاء الاصطناعي أن يساعد في التدرّب على دليل مقابلة أو اكتشاف حالات حدّية. أما الإجابات المحاكاة فلا تحل محل المحادثات أو السلوك المُلاحَظ.
سؤال أحدهم عمّا إذا كانت الفكرة تعجبه. اسأل عن مهمة حديثة وراقب الشخص وهو يجرّب سير عمل واقعيًا.
قياس المخرجات بدل المهمة. الأوامر المنفَّذة والشيفرة المدمجة والميزات المطلقة إشارات تسليم، وليست دليلًا على أن العميل أنجز مهمة بنجاح أكبر.
ترك مقياس يخفي مفاضلة. قد تحصل نتيجة الذكاء الاصطناعي على درجة جيدة في التقييم ومع ذلك تبدو بطيئة أو مربكة أو يصعب تصحيحها. اقرن الفحوص التقنية بمهمة للمستخدم.
إبقاء الأدلة في أدوات منفصلة. سجّل المصدر والقرار والاختبار والنتيجة معًا لترى لاحقًا ما الذي غيّر رأيك.
متى تكون هذه الحلقة الأداة الخاطئة: إذا كنت تحتاج إلى معرفة عدد الأشخاص الذين لديهم مشكلة ما، فأجرِ استطلاعًا أو حلّل بيانات الاستخدام. وإذا كان المنتج حرجًا للسلامة أو خاضعًا للتنظيم، فأسبوعان وقت قصير جدًا للمراجعة. وإذا كنت تختار بين فكرتين جيدتين اجتازتا الـ discovery، فأنت بحاجة إلى ترتيب الأولويات، لا إلى مزيد من المقابلات. وللاطلاع على صيغة أقصر تدور حول سؤال واحد، انظر سبرنت اكتشاف بالذكاء الاصطناعي؛ ولإبقاء الأدلة حديثة بعد انتهاء الحلقة، اجعلها عادة أسبوعية للاكتشاف المستمر.
أين يندرج Specky
Specky نظام منتج أصيل في الذكاء الاصطناعي مبني حول هذا النوع من الحلقات. يقرأ مكالمات العملاء والملاحظات وSlack وJira والتحليلات داخل Product Graph، فتبقى أدلة اليومين 3–4 مرتبطة بمصدرها. ويجري Alex، وكيل البحث في Specky، مقابلات العملاء عبر رابط قابل للمشاركة، فلا تنتظر خطوة الأدلة تقاويم المواعيد. وحين تصل إلى قرار، يصوغ PRD Editor المواصفة باستشهادات مضمّنة تعود إلى تلك الأدلة، ويسجّل Decision Log سبب مواصلتك أو تغييرك أو إيقافك المؤقت أو توقفك. وللاطلاع على العملية الأوسع من المشكلة إلى الإطلاق، انظر دليل عملية اكتشاف المنتج.
الأسئلة الشائعة
ما هو اكتشاف المنتج بالذكاء الاصطناعي؟
اكتشاف المنتج بالذكاء الاصطناعي هو استخدام أدلة العملاء والمنتج لتقرير أي مشكلة تُحَل، وهل الذكاء الاصطناعي جزء مفيد من الحل، وأي اختبار صغير ينبغي إجراؤه قبل بناء أكبر. تساعد أدوات الذكاء الاصطناعي في التحليل والمقابلات والنماذج الأولية، لكن الفريق يظل مسؤولًا عن التحقق من المصادر واتخاذ القرار. وبلا أدلة حقيقية من العملاء، يكون الأمر مجرد تخمين أسرع.
هل يستطيع الذكاء الاصطناعي التحقق من صحة فكرة شركة ناشئة؟
لا. يستطيع الذكاء الاصطناعي تنظيم الأدلة وتوليد صيغ للاختبار وبناء نموذج أولي بسرعة، لكنه لا يستطيع إثبات أن العملاء الحقيقيين يعانون من المشكلة أو أنهم سيتبنّون الحل. وجدت Nielsen Norman Group أن المستخدمين المحاكَين إيجابيون وسطحيون أكثر من اللازم مقارنة بالحقيقيين. استخدم المحادثات والمهام المُلاحَظة وسلوك المنتج كأدلة، واعتبر التحليل المولَّد بالذكاء الاصطناعي فرضية إلى أن يقارنه شخص بالمصادر.
كم ينبغي أن يستغرق اكتشاف المنتج لشركة ناشئة؟
لقرار واحد ضيق، نحو أسبوعين: يومان لتحديده، ويومان لجمع الأدلة، ويومان لاختيار أخطر افتراض، ويومان لبناء اختبار، ويومان للملاحظة والقرار. يستطيع المؤسسون المنفردون ضغط ذلك في بضعة أيام. أما الأسئلة الاستراتيجية الواسعة والمنتجات الخاضعة للتنظيم وكل ما يحتاج إلى بيانات الانتشار فتستغرق وقتًا أطول، وينبغي أن يستمر الـ discovery أسبوعيًا بعد انتهاء الحلقة.
ما أفضل أدوات اكتشاف المنتج بالذكاء الاصطناعي؟
تعتمد أفضل أداة على الخطوة. تفيد أدوات التفريغ والتحليل أكثر في مرحلة الأدلة، ويناسب المُحاوِرون بالذكاء الاصطناعي الأسئلة القصيرة المنظّمة، وتبني وكلاء البرمجة نماذج الاختبار الأولية، وتُظهر أدوات التحليلات السلوك الحقيقي. وأيًّا كان اختيارك، تحقق من أن كل ادعاء يرتبط بمصدر، وأنها تذكر أعدادًا لا صفات، وأن شخصًا يستطيع تصحيح المخرجات قبل أن تشكّل قرارًا.
كيف يختلف اكتشاف المنتج عن تطوير المنتج؟
يقلّل اكتشاف المنتج عدم اليقين بشأن المستخدم والمشكلة والحل. أما تطوير المنتج فيبني المنتج ويشغّله. وهما يتداخلان: قد يكون النموذج الأولي جزءًا من اختبار اكتشاف، وينبغي أن يغذّي الاستخدام بعد الإطلاق جولة التعلّم التالية. والسؤال المفيد هو هل يختبر الفريق افتراضًا الآن أم يسلّم تغييرًا تحقق منه بالفعل.
GDPR-aligned. EU workspace data is stored in Frankfurt, Germany. GDPR and EU data Built in Vienna, Austria. A product of influence solutions fm GmbH (FN 675374y). Imprint 14-day trial. Card required, and nothing is charged until day 14. 30-day refund after subscribing. See pricing