قالب خطة اختبار A/B هو خطة من صفحة واحدة تملؤها قبل اختبار التقسيم (split test): التغيير الواحد، والمقياس الرئيسي، ومقياس الحماية (guardrail)، وحجم العينة، وتاريخ الانتهاء. ثم يعرض اختبار التقسيم هذا التغيير على حصة عشوائية من الزيارات الحقيقية ويقارن المقياس الذي سمّيته قبل أن يبدأ. اكتب الخطة أولًا، لأن معظم اختبارات التقسيم تفشل قبل الإطلاق.
أهم النقاط
معظم الأفكار تخسر. كان معدل نجاح الأفكار في Bing نحو 10-20%، وكان الفائزون يحرّكون المقاييس الرئيسية بين 0.1% و1.0% (Kohavi et al., KDD 2014).
احسب حجم العينة قبل أن تبدأ. عند معدل تحويل 12%، يحتاج اكتشاف زيادة نسبية قدرها 10% إلى نحو 11,700 مستخدم لكل نسخة عند ثقة 95% وقدرة إحصائية 80% (حاسبة Evan Miller).
لا تختلس النظر. إن الاختبار بعد كل زائر والتوقف عند أول نتيجة “ذات دلالة” يرفع معدل الإيجابيات الكاذبة من 5% إلى 26.1% (Evan Miller, 2010).
سمِّ مقياس حماية واحدًا، وهو مقياس يجب ألا يسوء.
ما هو اختبار التقسيم (split test)؟
يغيّر اختبار التقسيم شيئًا واحدًا لحصة من زياراتك الحقيقية ويقارن مقياسًا سمّيته قبل بدء الاختبار.
وهو الشيء نفسه الذي يسمى اختبار A/B: النسخة A هي الأصلية (المجموعة الضابطة)، والنسخة B فيها التغيير، ويُوزَّع الناس عشوائيًا. ولأن التغيير هو الفرق المنهجي الوحيد، فإن فجوة واضحة في المقياس تشير إلى التغيير.
في كتاب Testing Business Ideas لـ David J. Bland وAlex Osterwalder، اختبار التقسيم تجربة تحقق من نوع “call to action”، إلى جانب اختبار صفحة الهبوط والبيع المسبق. ويقيّمه ملصق Strategyzer بـ 2 من 5 في التكلفة و3 من 5 في مدة التشغيل و3 من 5 في قوة الدليل (مكتبة تجارب Strategyzer).
متى تُجري اختبار تقسيم، ومتى لا تفعل؟
استخدمه عندما يكون لديك زيارات كافية وتريد أن تعرف ما إذا كان تغيير محدد قد تسبّب في نتيجة. إنه أكثر الطرق موثوقية للإجابة عن ذلك. وقد يفاجئك أيضًا. في مقالهما في Harvard Business Review عام 2017، يروي Ron Kohavi وStefan Thomke قصة تغيير صغير في طريقة عرض عناوين الإعلانات في Bing، أعطى نتائج قوية جدًا إلى حد أنها أطلقت تنبيهًا داخليًا لأنها بدت أجمل من أن تكون حقيقية. وكانت الفكرة قد بقيت في الـ backlog أكثر من ستة أشهر. رفعت الإيرادات 12%، أي ما قيمته أكثر من 100 مليون دولار سنويًا في الولايات المتحدة وحدها.
هذه القصة هي الاستثناء. في ورقة بحثية عام 2014، كتب Kohavi وزملاؤه أن معظم تجارب Bing تفشل، وأن النتائج القوية استثنائيًا تستدعي قانون Twyman: “Any figure that looks interesting or different is usually wrong!”
يختبر الرغبة (desirability): هل تجعل هذه النسخة الناس يفعلون أكثر مما تريد؟ الدليل هو السلوك، من أشخاص حقيقيين لا يعرفون أنهم في اختبار. وهو يقيس ما يحدث خلال فترة الاختبار، ولذلك قد يفوته الأثر بعيد المدى. راجع دليلنا لاختيار تجربة منتج.
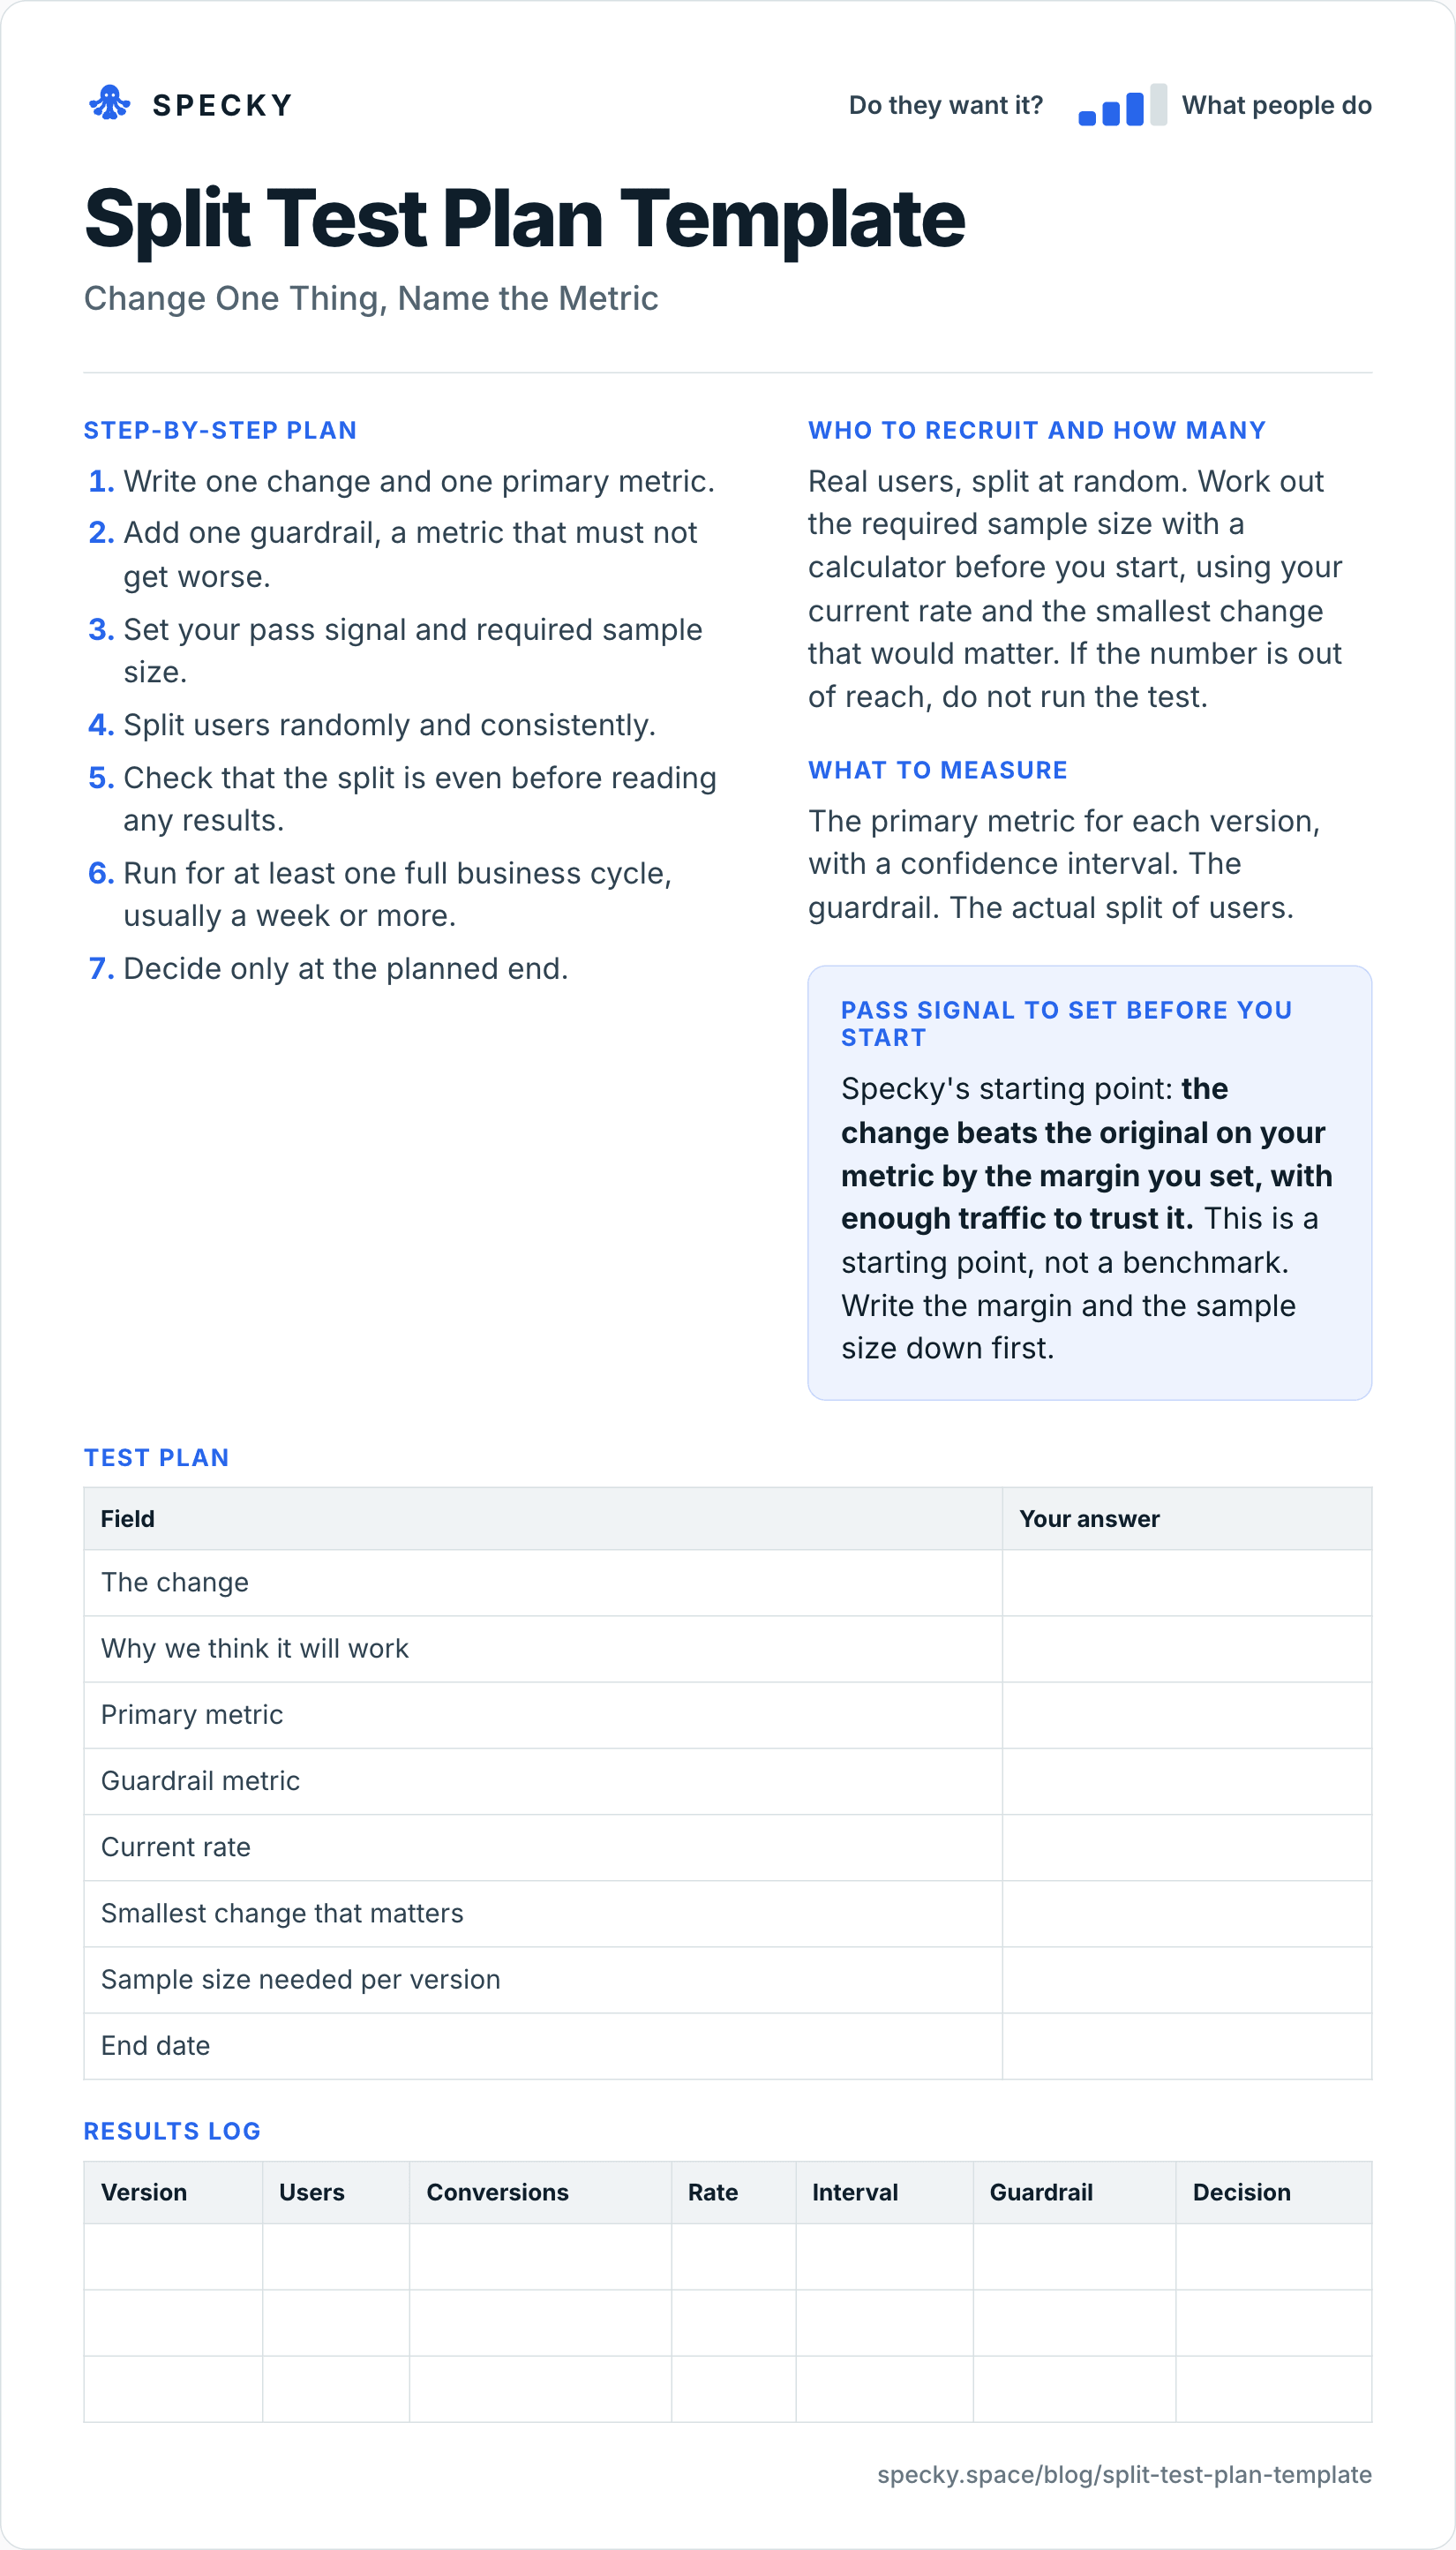
قالب خطة اختبار A/B (انسخه واستخدمه)
افتح الصورة بحجمها الكامل، أو انسخ النسخة النصية أدناه.
من تستقطب وكم عددهم
مستخدمون حقيقيون، يُقسَّمون عشوائيًا. احسب حجم العينة المطلوب بحاسبة قبل أن تبدأ، مستخدمًا معدلك الحالي وأصغر تغيير يهم. فإذا كان الرقم بعيد المنال، فلا تُجرِ الاختبار.
خطة خطوة بخطوة
اكتب تغييرًا واحدًا ومقياسًا رئيسيًا واحدًا.
أضف مقياس حماية واحدًا، وهو مقياس يجب ألا يسوء.
حدّد إشارة النجاح وحجم العينة المطلوب.
قسّم المستخدمين عشوائيًا وبشكل ثابت.
تأكد من أن التقسيم متساوٍ قبل قراءة أي نتائج.
شغّل الاختبار دورة عمل كاملة واحدة على الأقل، وعادةً أسبوعًا أو أكثر.
لا تقرر إلا عند النهاية المخططة.
خطة الاختبار
الحقل
إجابتك
التغيير
لماذا نعتقد أنه سينجح
المقياس الرئيسي
مقياس الحماية
المعدل الحالي
أصغر تغيير يهم
حجم العينة المطلوب لكل نسخة
تاريخ الانتهاء
ما الذي تقيسه
المقياس الرئيسي لكل نسخة، مع فاصل ثقة. ومقياس الحماية. والتقسيم الفعلي للمستخدمين.
إشارة النجاح التي تحددها قبل البدء
نقطة انطلاق Specky: التغيير يتفوق على الأصل في مقياسك بالهامش الذي حدّدته، مع زيارات كافية للوثوق به. هذه نقطة انطلاق، وليست معيارًا مرجعيًا. اكتب الهامش وحجم العينة أولًا.
سجل النتائج
النسخة
المستخدمون
التحويلات
المعدل
الفاصل
مقياس الحماية
القرار
كم مستخدمًا تحتاج إلى اختبار A/B؟
يعتمد ذلك على معدل التحويل الحالي لديك وأصغر تغيير يستحق الاكتشاف، أي أدنى أثر يمكن اكتشافه. وكلما صغر أي منهما احتجت إلى زيارات أكثر. باستخدام الصيغة ثنائية الطرف في حاسبة Evan Miller المجانية، عند دلالتها القياسية 5% وقدرتها 80%، هذه هي العينة المطلوبة لكل نسخة:
معدل التحويل الحالي
لاكتشاف زيادة نسبية 5%
زيادة نسبية 10%
زيادة نسبية 20%
2%
نحو 310,000
نحو 78,000
نحو 19,800
5%
نحو 120,000
نحو 30,200
نحو 7,700
12%
نحو 46,300
نحو 11,700
نحو 2,900
20%
نحو 25,300
نحو 6,300
نحو 1,600
تقليل الأثر الذي تريد اكتشافه إلى النصف يضاعف الزيارات المطلوبة أربع مرات تقريبًا، والمعدلات الأساسية المنخفضة تحتاج إلى عدد أكبر بكثير من الناس من المعدلات المرتفعة.
وللتحقق دون حاسبة، استخدم قاعدة Evan Miller التقريبية: n = 16σ² / δ²، حيث δ هو الأثر الأدنى، ولمعدل تحويل p تكون σ² = p(1 − p). عند 12% وزيادة إلى 13.2%: 16 × 0.12 × 0.88 ÷ 0.012² ≈ 11,700 لكل نسخة.
مثال محلول: من حجم العينة إلى تاريخ الانتهاء
هذا المثال توضيحي؛ وهو يطابق المثال المحلول أدناه.
المعدل الحالي: 12% من الزوار يسجلون.
أصغر تغيير يهم: زيادة نسبية 10%، من 12% إلى 13.2%.
حجم العينة: نحو 11,700 لكل نسخة، أي نحو 23,400 زائر في المجموع.
الزيارات: نحو 860 زائرًا يوميًا يصلون إلى صفحة التسجيل.
إذا كانت الإجابة ستة أشهر، فلا تُجرِ اختبارًا أصغر وتأمل الخير. اختبر تغييرًا أكبر، أو اختر مقياسًا بمعدل أساسي أعلى، أو استخدم طريقة تحتاج إلى زيارات أقل.
كم من الوقت يجب أن يستمر اختبار التقسيم؟
حتى تصل إلى حجم العينة المخطط، ولمدة دورة عمل كاملة واحدة على الأقل، وعادةً أسبوعًا أو أكثر، لأن المستخدمين في أيام الأسبوع يتصرفون بشكل مختلف عن مستخدمي عطلة نهاية الأسبوع.
لماذا لا ينبغي أن تختلس النظر إلى النتائج؟
تعرض لوحات البيانات قيمة p تفترض أنك تنظر مرة واحدة، في النهاية. وكل نظرة إضافية فرصة أخرى كي تتجاوز الضوضاء الحد. أظهر Evan Miller أن الاختبار بعد كل ملاحظة والتوقف عند أول p < 0.05 يعطي معدل إيجابيات كاذبة 26.1%، أي أكثر من خمسة أضعاف الـ 5% التي تظن أنها لديك (Evan Miller, 2010).
وإذا كان لا بد أن تنظر مبكرًا، فارفع المعيار: إذا نظرت 10 مرات فأنت بحاجة إلى دلالة معلنة قدرها 1.0% للحفاظ على معدل حقيقي 5%.
لماذا تحتاج النتيجة “ذات الدلالة” إلى تحقق مع ذلك؟
يشرح Kohavi وزملاؤه الحساب. إذا كانت فكرة من كل ثلاث فكرة رابحة حقًا، وهو المتوسط الذي أبلغوا عنه عبر تجارب Microsoft، فإن النتيجة ذات الدلالة تكون إيجابية حقيقية بنسبة 89% تقريبًا. وإذا كانت الاختراقات الحقيقية واحدة من كل 500، فتنخفض إلى 3.1%. والنتائج المفاجئة تحتاج إلى إعادة تشغيل.
ماذا ينبغي أن تقيس في اختبار التقسيم؟
المقياس الرئيسي لكل نسخة، مع فاصل ثقة، لا مجرد نسبة مئوية.
مقياس حماية واحد يجب ألا يسوء، مثل التحويل المدفوع أو المبالغ المستردة أو زمن تحميل الصفحة.
التقسيم الفعلي للمستخدمين. إذا خططت لـ 50/50 وحصلت على 52/48 مع أعداد كبيرة، ففي الأمر خلل. وهذا هو عدم تطابق نسبة العينة (sample ratio mismatch). ويحتاج فحصه فقط إلى النسب المتوقعة والأعداد المرصودة، ويكشف طيفًا واسعًا من مشكلات البيانات (أداة فحص SRM من Lukas Vermeer وزملائه). لا تقرأ النتائج حتى ينجح.
تحتاج مقاييس الحماية على الأحداث النادرة إلى زيارات كثيرة: اكتشاف انخفاض 10% في تحويل مدفوع قدره 1.2% يتطلب نحو 130,000 مستخدم لكل نسخة. وإذا لم تستطع بلوغ ذلك، فدوّن مسبقًا ما يُعد خرقًا، مثل “أي انخفاض في العملاء الدافعين يوقف الإطلاق”.
اختبار التقسيم مقابل اختبار صفحة الهبوط مقابل اختبار الباب الوهمي
هل يحاول المستخدمون الحاليون استخدام ميزة لم تُبنَ بعد؟
المقارنة
ضابط مقابل نسخة بديلة، عشوائيًا
عادةً صفحة واحدة مقابل هدف
زر واحد مقابل هدف
الدليل
سببي، سلوكي
اهتمام سلوكي
اهتمام سلوكي
استخدم اختبار صفحة الهبوط أو الباب الوهمي لمعرفة ما إذا كان هناك اهتمام أصلًا؛ واستخدم اختبار التقسيم لمعرفة أي النسختين أفضل.
كيف يبدو اختبار التقسيم عمليًا؟
هذا المثال مختلق لتوضيح الطريقة. فريق يدير أداة لتقديم الإقرارات الضريبية يريد تقصير نموذج التسجيل من ستة حقول إلى ثلاثة. يتوقعون أن ترتفع عمليات التسجيل 10% على الأقل، ويحددون التحويل المدفوع مقياس حماية.
بعد أربعة أسابيع و12,000 زائر في كل مجموعة، يزيد النموذج الأقصر عمليات التسجيل 14%. لكن التحويل المدفوع ينخفض، ويُخرَق مقياس الحماية: فالتسجيلات الإضافية من أشخاص أقل نية لا يكملون أبدًا.
ينجح هدف التسجيل ويفشل مقياس الحماية، فلا يطلقونه كما هو. ويجرّبون نموذجًا أقصر مع سؤال إضافي عن نوع إقرار العميل.
وهكذا قد يبدو السجل:
النسخة
المستخدمون
التسجيلات
المعدل
العملاء الدافعون
القرار
ستة حقول (ضابط)
12,000
1,440
12.0%
144
ثلاثة حقول
12,000
1,642
13.7%
131
لا تُطلق
الزيادة في التسجيلات حقيقية: +1.7 نقطة مئوية، بفاصل 95% يبلغ نحو +0.8 إلى +2.5. أما انخفاض الدافعين، من 144 إلى 131 عميلًا، فهو أصغر من أن يُثبت بهذا القدر من الزيارات، لكن قاعدة مقياس الحماية التي كتبها الفريق مسبقًا قالت إن انخفاض عدد العملاء الدافعين يوقف الإصدار.
ما أكثر أخطاء اختبارات التقسيم شيوعًا؟
اختلاس النظر. الفحص المبكر والتوقف عندما يبدو الأمر جيدًا ينتج انتصارات كاذبة.
تغيير عدة أشياء. لن تعرف أيها نجح.
غياب مقياس الحماية. قد تربح مقياسًا وتخسر العمل.
زيارات قليلة جدًا. الاختبار ضعيف القدرة الإحصائية مجرد ضوضاء باهظة.
تجاهل أثر الجِدّة. ينقر الناس على الأشياء الجديدة لمجرد أنها جديدة.
متى لا ينجح: مع الزيارات القليلة، وللرهانات الكبيرة التي لا يمكن تقسيمها، وللآثار التي تستغرق شهورًا، وحيث يتحدث المستخدمون إلى بعضهم فلا تكون المجموعات مستقلة.
هل من الأخلاقي إجراء اختبار تقسيم دون إخبار المستخدمين؟
تُختبر التغييرات العادية، مثل نموذج أقصر أو عنوان جديد، بشكل روتيني دون إخبار كل مستخدم. والحد الفاصل هو الضرر. لا تختبر أي شيء لا ترتاح لإطلاقه للجميع، ولا تعرض أسعارًا مختلفة على عملاء متشابهين دون سياسة واضحة، ولا تحتسب إلا من يسمح لك شعار الموافقة بتتبعهم.
كيف تنفّذه في Specky
في صفحة Assumptions، انقر على الملاحظة واختر Pick a test، ثم Split test. يملأ Specky الخطوات وإشارة النجاح وجدولًا زمنيًا من أسبوعين.
بالنسبة إلى تغيير داخل منتجك، نفّذ التقسيم بأداة feature flags أو التجارب الخاصة بك. لا يغيّر Specky منتجك. إنه يقرأ الأرقام من التحليلات المتصلة، وأنت ترفق النتيجة كدليل.
إذا كنت تختبر صفحة تحقق من Specky، فيمكن أن يحدث التقسيم هناك. أعدّ ضابطًا واحدًا وما يصل إلى خمس نسخ بديلة في Experiment analytics، ويعرض Specky التحويل لكل نسخة وفواصل 95% وما إذا كان لديك عدد كافٍ من الناس ومقياس حماية اختياريًا. ويبقى الحكم حذرًا ما دامت العينة صغيرة.
انقر على Start running، وسجّل النتيجة عند النهاية المخططة.
يظهر النجاح على اللوحة بوصفه Supported، لأن مقارنة مضبوطة لما فعله الناس هي سلوك.
ماذا تفعل مع كل نتيجة؟
Supported: أطلق التغيير. دوّن حجم المكسب وافحص التحليلات مرة أخرى بعد شهر لترى هل يستمر الأثر.
Unclear: النتيجة ضمن هامش الخطأ. احتفظ بالنسخة الأبسط، أو اعرف السبب عبر بضع مقابلات.
Contradicted: لم يكن للتغيير أثر، أو جعل الأمور أسوأ. لا تطلقه. وأي رهان قائم على هذه الملاحظة يظهر الآن بوصفه Contradicted.
الأسئلة الشائعة
كم تحتاج من الزيارات لاختبار تقسيم؟
يعتمد ذلك على معدل التحويل الحالي لديك وأصغر تغيير يهم. عند معدل تحويل 12%، يتطلب اكتشاف زيادة نسبية 10% نحو 11,700 مستخدم لكل نسخة بالإعدادات القياسية؛ وعند 2%، نحو 78,000. وإذا لم تستطع بلوغ الرقم في وقت معقول، فاستخدم طريقة مختلفة.
لماذا لا ينبغي إيقاف اختبار التقسيم مبكرًا؟
التوقف عندما تبدو النتائج جيدة يجعل الانتصارات الكاذبة أرجح بكثير، لأن النتائج تتأرجح في البداية. وفي أسوأ حالات Evan Miller، يعطي الاختبار بعد كل زائر معدل إيجابيات كاذبة 26.1% بدلًا من 5%. حدّد مسبقًا تاريخ الانتهاء وحجم العينة.
ما هو مقياس الحماية (guardrail)؟
مقياس الحماية رقم يجب ألا يسوء أثناء الاختبار، حتى لو تحسن مقياسك الرئيسي، مثل التحويل المدفوع أو المبالغ المستردة أو سرعة الصفحة. وهو يمنعك من ربح مقياس مع الإضرار بالعمل. اكتب قاعدة ما يُعد خرقًا قبل أن يبدأ الاختبار.
ما الفرق بين اختبار التقسيم واختبار A/B؟
لا فرق عمليًا. كلاهما يعرض تغييرًا على حصة عشوائية من المستخدمين ويقارن مقياسًا واحدًا بمجموعة ضابطة؛ ويسميه الباحثون تجربة مضبوطة عبر الإنترنت. أما اختبار عدة تغييرات معًا فهو اختبار متعدد المتغيرات، ويحتاج إلى زيارات أكثر بكثير.
GDPR-aligned. EU workspace data is stored in Frankfurt, Germany. GDPR and EU data Built in Vienna, Austria. A product of influence solutions fm GmbH (FN 675374y). Imprint 14-day trial. Card required, and nothing is charged until day 14. 30-day refund after subscribing. See pricing