5. November 2026Aktualisiert am Fathy Shalaby16 Min. Lesezeit
KI-Research-Synthese: Belege und Interpretation sauber trennen
KI sortiert einen Ordner voller Interviews in Minuten, übersieht laut Studien aber interpretative Themen. Ein Workflow in fünf Schritten, ein Prompt und eine Review-Checkliste halten jede Aussage an ihre Quelle gebunden.
Teilen
Dieser Artikel wurde aus dem Englischen übersetzt. Original lesen
KI-Research-Synthese heißt: Ein Sprachmodell ordnet Interviewnotizen, Support-Tickets und Beobachtungen aus Sessions zu möglichen Themen, während Menschen jedes Thema gegen die Originalbelege prüfen und die Interpretation verantworten. Der erste Durchgang schrumpft von Stunden auf Minuten. Es geht schief, wenn generierte Themen wie Erkenntnisse behandelt werden: In veröffentlichten Vergleichen stimmen Modelle bei deskriptiven Themen weit häufiger mit menschlichen Forschenden überein als bei interpretativen.
KI macht aus einem Ordner voller Interviewnotizen in Sekunden eine ordentliche Zusammenfassung. Das ist nützlich, um Material zu finden, das du dir genauer ansehen solltest. Es ist aber auch ein einfacher Weg, aus einer unsicheren Interpretation eine selbstbewusst klingende Produktentscheidung zu machen. Dieser Leitfaden richtet sich an Gründer:innen, erste PMs und Product Engineers, die eine Handvoll Calls, Tickets und Nutzungsnotizen haben, aber keine Research-Abteilung, die alles noch einmal in Ruhe liest.
Das Wichtigste in Kürze
In einer Studie von 2024 fanden ChatGPT und Bard jeweils 5 der 7 Themen, die menschliche Codierer:innen fanden (71 %), stimmten bei den einzelnen Codes aber nur zu 36–47 % mit den Menschen überein (Prescott et al., 2024).
Dieselbe KI-Analyse dauerte rund 20 Minuten, die menschlichen Codierer:innen brauchten im Schnitt 567 Minuten. Die Geschwindigkeit ist echt, die Präzision nicht.
Bei 30 japanischen klinischen Interviews stimmte ChatGPT-4 bei über 80 % der deskriptiven Themen mit den Forschenden überein, aber nur bei rund 30 % der Themen, die kulturelle oder emotionale Interpretation erforderten (Sakaguchi et al., 2025).
67 % der UX-Praktiker:innen, die ihre eigenen Research-Daten auswerten, nutzen dafür oft oder immer KI. Trotzdem ist die Qualität der Ergebnisse mit 54 % die größte Hürde bei der Einführung (NN/g, 2026).
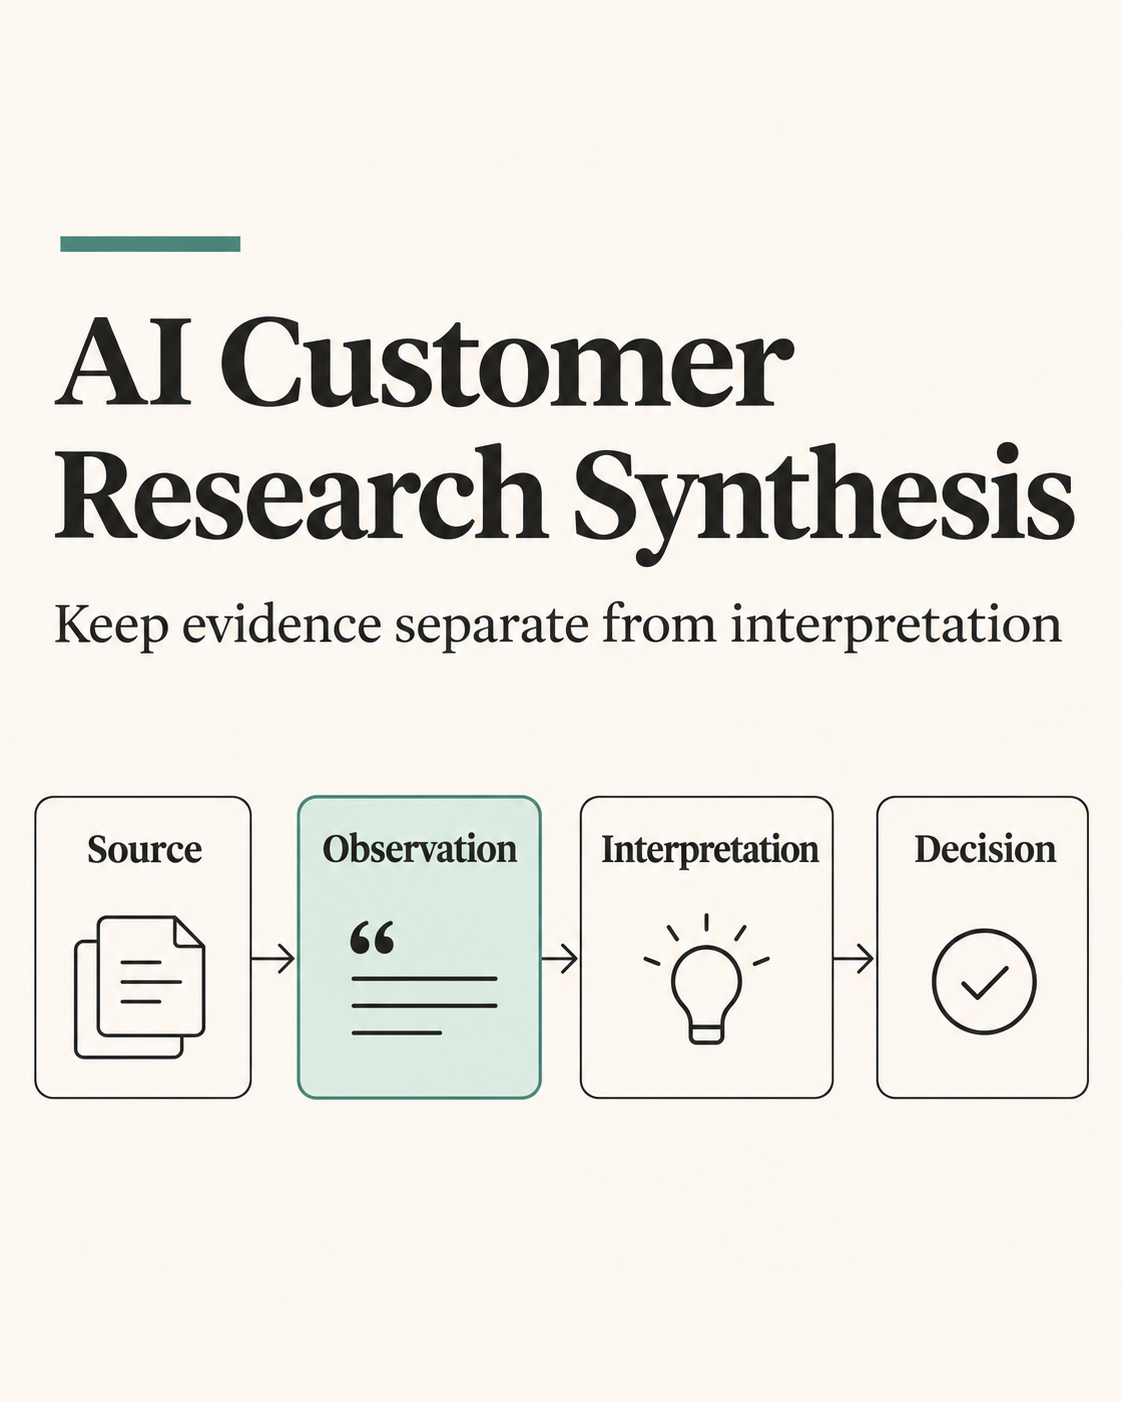
Halte vier Ebenen auseinander: Quelle, Beobachtung, Interpretation, Entscheidung. Bei den ersten beiden darf KI helfen. Die letzten beiden gehören Menschen.
Was ist KI-Research-Synthese, und was sollte sie nicht tun?
Synthese ist der Schritt nach den Interviews: Muster und bedeutsame Unterschiede über mehrere Gespräche hinweg finden und dann entscheiden, was sie für eine Produktentscheidung heißen. Unser Leitfaden zu beschreibt die manuelle Methode. Bei KI-Research-Synthese übernimmt ein Modell Teile dieser Arbeit: transkribieren, Beobachtungen herausziehen, ähnliche Aussagen clustern und Themenlabels entwerfen.
Schlussfolgern sollte es nicht. Ein Modell kennt weder deine Strategie noch die Account-Historie des Kunden, noch weiß es, welche Teilnehmerin für die Studie schlecht geeignet war. Als die Nielsen Norman Group 2023 KI-Insight-Generatoren untersuchte, konnten die Tools Studienziele, frühere Erkenntnisse und Kontext zu den einzelnen Teilnehmenden nicht aufnehmen, und ihre Themen kamen deshalb unpriorisiert heraus (NN/g, 2023).
Warum sind Belege und Geschichte zwei verschiedene Dinge?
Stell dir drei Interviewte vor, die einen verwirrenden Einrichtungsschritt beschreiben. Eine sagt, sie habe nicht gewusst, welche Quelle sie verbinden soll. Ein anderer hat das falsche Konto verbunden. Eine dritte wünscht sich eine Checkliste für die Einrichtung.
Die Beobachtungen sind konkret. „Nutzer brauchen eine Onboarding-Checkliste“ ist bereits eine Interpretation. „Die Integrationsauswahl ist das Problem“ ist eine weitere. Keine von beiden sollte abgelegt werden, als wäre sie ein wörtliches Zitat.
Eine brauchbare Synthese hält vier Ebenen sichtbar:
Quelle: das ursprüngliche Interview, die Support-Nachricht oder die beobachtete Session.
Beobachtung: was die Person gesagt oder getan hat, mit genug Kontext, um es zu deuten.
Interpretation: das mögliche Bedürfnis, die Ursache oder das Muster, das du daraus ableitest.
Entscheidung: was das Team tut, testet, zurückstellt oder als Nächstes lernen will.
Wenn diese Ebenen in einer einzigen Zusammenfassung verschmelzen, kann das Team die Interpretation nicht mehr hinterfragen, ohne gleich die Quelle selbst in Zweifel zu ziehen. NN/g formuliert die Regel der Forschung direkt: Man müsse „zwischen unseren Interpretationen oder Annahmen und dem, was die Teilnehmenden gesagt oder getan haben, unterscheiden“ („differentiate between our interpretations or assumptions and what the participants said or did“, NN/g, 2023). KI-Zusammenfassungen sind flüssige Prosa, und genau in flüssiger Prosa verschwindet diese Linie.
Wie genau ist KI bei der Analyse qualitativer Daten?
Genau genug, um die offensichtlichen Themen zu finden, aber nicht genau genug, um ihr bei den feinen zu trauen. Die veröffentlichten Vergleiche zeigen in dieselbe Richtung:
Vage Zusammenfassungen, kein Kontext, Zitate ohne Quelle
Nicht gemessen
Prescott und Kolleg:innen stellten fest, dass menschliche Codierer:innen bei nuancierten, interpretativen Themen besser waren, und folgerten, dass hybride Ansätze nötig sind. Sakaguchi und Kolleg:innen bezeichneten ChatGPT-4 als Hilfswerkzeug und betonten, dass menschliche Expertise weiterhin gebraucht wird.
Das sind Studien aus der Gesundheitsforschung und dem UX-Bereich, nicht aus dem Startup-Discovery, übertrage die Prozentwerte also nicht auf deine eigenen Interviews. Sie stützen aber eine Faustregel: Je stärker ein Thema von Kontext, Emotion oder dem Ungesagten abhängt, desto weniger solltest du einem generierten Label trauen, ohne die Quelle zu lesen.
Was berichten Praktiker:innen?
Die Umfrage von NN/g vom Oktober 2026 unter 521 UX-Praktiker:innen zeigt, wie selbstverständlich KI-Analyse geworden ist (NN/g, 2026):
67 % derer, die ihre eigenen Research-Daten auswerten, nutzen dafür oft oder immer KI.
Rund 9 von 10 derjenigen, die KI für Analyse, Desk Research oder Codierung einsetzen, sagten, dass die Arbeit dadurch schneller wurde.
54 % nannten Bedenken wegen der Ausgabequalität als Hürde, die häufigste überhaupt.
Unter 149 negativen Kommentaren kamen unzuverlässige Ergebnisse und der Aufwand, sie zu überprüfen, am häufigsten vor, nämlich in 40.
61 % hatten KI noch nie genutzt, um Nutzer zu interviewen.
NN/g beschreibt das als Gelegenheitsstichprobe, lies es also als Tendenz und nicht als Marktschätzung. Die Tendenz ist eindeutig: Praktiker:innen nutzen KI für die Analyse, weil sie schneller ist, und stecken die gesparte Zeit in die Kontrolle.
Wie läuft KI-Research-Synthese Schritt für Schritt?
Fünf Schritte. Die ersten beiden passieren, bevor du ein KI-Tool öffnest. In den letzten beiden zeigen Menschen, was sie wert sind.
1. Die Entscheidung festlegen, bevor du zusammenfasst
Schreib die Produktentscheidung auf, über die die Research informieren soll. Zum Beispiel:
Sollen wir den Verbindungsablauf beim ersten Start vereinfachen, oder zuerst erklären, welche Quelle Nutzer verbinden sollen?
So verhinderst du, dass ein breiter Prompt wie „Analysiere diese Interviews“ ansprechende Themen liefert, die bei der anstehenden Entscheidung nicht helfen. Außerdem fällt leichter auf, wenn das Material die Frage gar nicht beantwortet. Wenn du die Entscheidung nicht benennen kannst, bist du noch nicht bereit für die Synthese; vielleicht steckst du noch in der Phase des Product-Discovery-Prozesses, in der es darum geht, was du überhaupt lernen willst.
2. Das Ausgangsmaterial verantwortungsvoll vorbereiten
Verwende nur Material, das dein Team im gewählten KI-Tool verarbeiten darf, im Rahmen der Einwilligung der Teilnehmenden. Entferne personenbezogene oder sensible Angaben, es sei denn, du hast einen klaren, freigegebenen Grund, sie zu behalten. NN/g weist darauf hin, dass manche Research-Tools Namen, E-Mail-Adressen und ähnliche Kennungen inzwischen automatisch entfernen (NN/g, 2024). Führe eine Quellen-ID und ein Datum mit, damit Reviewer den Originaldatensatz finden, und kontrolliere gleichzeitig den Zugriff auf das zugrunde liegende Transkript.
Vermische Notizen aus verschiedenen Kundengruppen oder zu verschiedenen Forschungsfragen nicht ohne Kennzeichnung. Ein Gründerinterview, ein Support-Ticket und eine beobachtete Usability-Session können alle nützlich sein; sie sind aber keine austauschbaren Belege. Kennzeichne jeden Datensatz mit seinem Typ und dem Segment der Teilnehmenden, bevor das Modell ihn sieht.
3. Die KI ordnen lassen, nicht schlussfolgern
Gib dem Modell eine klar begrenzte Aufgabe. Es soll:
Beobachtungen herausziehen, die für die Entscheidung relevant sind;
jeder Beobachtung eine Quellen-ID und die genaue belegende Passage zuordnen;
direkte Aussagen von abgeleiteten Bedürfnissen trennen;
Gegenbeispiele und widersprüchliche Belege auflisten;
fehlenden Kontext und Fragen markieren, die es nicht beantworten kann;
wiederholte Erwähnungen nicht als unabhängige Nutzer zählen, solange die Quellenlage diese Zählung nicht stützt.
Verlang keine endgültige Persona, keine marktweite Schlussfolgerung und keine gerankte Roadmap auf Basis weniger Gespräche. Ein Modell kann Unsicherheit aus dem Blick formatieren, wenn du nicht ausdrücklich verlangst, sie beizubehalten. NN/g stellte fest, dass KI-Clustering Einträge oft nach gemeinsamen Schlüsselwörtern statt nach gemeinsamer Bedeutung gruppiert. Behandle die ersten Cluster also als Sortierhilfe (NN/g, 2024).
4. Jede Aussage prüfen, die die Roadmap verändern könnte
Ein PM oder eine Gründerin sollte für jedes vorgeschlagene Thema mit hoher Wirkung die Originalquelle öffnen. Prüfe, ob das Zitat die Aussage trägt, ob der Kontext drumherum seine Bedeutung verändert und ob das Modell die Erfahrungen verschiedener Personen vermischt hat.
Suche dann nach Belegen, die nicht passen. Wenn zwei Nutzer dasselbe Symptom aus unterschiedlichen Gründen beschreiben, behalte beide Erklärungen. Wenn eine einzige anschauliche Geschichte die einzige Stütze einer Idee ist, kennzeichne sie als Signal, dem du nachgehen solltest, und nicht als bewiesenes Muster.
Eine praktische Review-Tabelle sieht so aus:
Vorgeschlagenes Thema
Stützende Quelle
Was wurde direkt beobachtet?
Interpretation
Gegenbelege oder Lücke
Nächster Schritt
Die Quelle bei der Einrichtung ist unklar
Interview 04, Session-Notiz
Person hat ein anderes Konto verbunden als beabsichtigt
Die Bezeichnungen der Auswahl sind möglicherweise mehrdeutig
Eine Beobachtung; noch kein Replay der Aufgabe
Aufzeichnung ansehen und Verständlichkeit der Bezeichnungen testen
Nutzer wollen eine Checkliste
Interview 07, Transkript
Person bat nach einem Hänger um eine Checkliste
Sie brauchen womöglich Hilfestellung am Entscheidungspunkt
Der Wunsch kann die persönliche Vorliebe dieser Person sein
Mit Support-Fällen vergleichen und die erste Nutzung beobachten
Die Tabelle ist bewusst zurückhaltend. Sie macht aus zwei Gesprächen keinen Prozentwert und behauptet nicht, dass sich „die Nutzer“ alle gleich verhalten.
5. Die Entscheidung und ihren Lern-Trigger festhalten
Sobald das Team die Belege geprüft hat, halte fest, was es entschieden hat und warum. Nimm den Verantwortlichen für die Entscheidung auf, die stützenden Quellen, die wichtigste Unsicherheit und welche künftigen Belege die Entscheidung ändern würden. Ein Product Decision Log gibt dem ein dauerhaftes Zuhause.
Zum Beispiel:
Entscheidung: Klarere Beschreibungen der Quellen testen, bevor wir eine vollständige Einrichtungs-Checkliste bauen.
Warum: Zwei unabhängige Quellen deuten auf Unsicherheit bei der Verbindungsauswahl hin, aber wir haben noch nicht genug erste Sessions beobachtet, um zu wissen, ob das Problem an den Bezeichnungen, der Reihenfolge oder fehlender Anleitung liegt.
Review-Trigger: Erneut prüfen, nachdem mehrere repräsentative Einrichtungs-Sessions angesehen wurden, oder wenn Support-Meldungen auf eine andere Fehlerstelle zeigen.
Die Stichprobe, die du brauchst, hängt von der Entscheidung, vom Risiko und von der Vielfalt deiner Nutzer ab. Behandle eine feste Interviewzahl nicht als Beweis für Sättigung oder Repräsentativität. Bleibt die Beleglage gemischt, ist der nächste nützliche Schritt vielleicht eine weitere Beobachtung und keine glattere Zusammenfassung.
Welchen Prompt solltest du für die KI-Research-Synthese verwenden?
Arbeite in zwei Durchgängen: einer zum Ordnen, einer, der dir beim Priorisieren der Prüfung hilft. Diesen ersten Prompt kannst du für eine zulässige, angemessen geschützte Quellenmenge anpassen:
Hilf mir, diese Research-Notizen für die folgende Entscheidung zu ordnen: [Entscheidungsfrage]. Gib zu jeder vorgeschlagenen Beobachtung die Quellen-ID und die genaue belegende Passage an. Trenne direkte Belege von Interpretation. Liste widersprüchliche Beispiele, fehlenden Kontext und alternative Erklärungen auf. Schließe nicht über die vorliegenden Datensätze hinaus auf Häufigkeit. Empfiehl keine Roadmap-Entscheidung. Wenn eine Aussage nicht durch eine Passage belegt werden kann, kennzeichne sie als unbelegt. Gib eine Tabelle mit Beobachtung, Zitat, Quelle, Interpretation, Begründung der Sicherheit, Gegenbelegen und Folgefrage zurück.
Lass dann einen zweiten Prompt über das Ergebnis laufen:
Liste für jedes Thema oben die einzelnen Teilnehmenden (nicht die Erwähnungen) auf, die es stützen, nach Quellen-ID. Markiere jedes Thema, das nur von einer Person gestützt wird, jedes Zitat, das du nicht wortgetreu in den Quellen findest, und jedes Thema, das Teilnehmende aus verschiedenen Segmenten kombiniert.
Der zweite Durchgang ist keine Verifizierung. Ein Modell, das seine eigene Arbeit prüft, kann die eigenen Fehler wiederholen. Er hilft dir aber, die Themen zu sortieren, sodass die menschliche Prüfung bei den schwächsten beginnt. Keiner der beiden Prompts macht das Ergebnis für sich allein verlässlich; zusammen machen sie es leichter prüfbar.
Wie prüfst du eine KI-Synthese, bevor sie auf die Roadmap kommt?
Kopiere diese Checkliste in dein Synthese-Dokument und hak sie ab, bevor ein Thema zu einem Ticket oder einer PRD-Zeile wird:
Die Entscheidung, über die diese Synthese informiert, steht ganz oben.
Jedes Zitat ist wortgetreu: Du hast das Transkript durchsucht und es gefunden.
Jedes Thema nennt, wie viele verschiedene Personen es stützen, nicht wie viele Erwähnungen.
Jedes Thema nennt das Segment, die Rolle oder die Situation dieser Personen.
Gegenbelege stehen unter dem Thema, das sie infrage stellen.
Aussagen dazu, warum Menschen handeln oder wie sie sich fühlen, sind als Interpretation markiert.
Themen, die auf einer einzigen Person beruhen, sind als Signale zum Nachgehen gekennzeichnet.
Fehlende Stimmen sind vermerkt: mit wem du nicht gesprochen hast.
Praxisbeispiel: eine Synthese in einer Stunde prüfen
Dieses Beispiel ist illustrativ. Nehmen wir ein Team aus fünf Personen mit 8 Onboarding-Interviews, rund 6 Stunden Aufzeichnungen und 40 Support-Tickets. GOV.UK empfiehlt etwa 1 Stunde Analyse pro 2 Stunden Research (GOV.UK), ein manueller Durchgang allein für die Calls dauert also grob 3 Stunden. NN/g rät, für die Analyse mindestens so viel Zeit einzuplanen wie für die Erhebung, was mehr wäre (NN/g, 2022).
Der KI-Durchgang dauert 10 Minuten und schlägt 7 Themen vor, belegt durch 31 Zitate. Die PM prüft nur die 3 Themen, die den nächsten Sprint verändern könnten: 14 Zitate, etwa 45 Minuten Lesen. Sie findet 2 Zitate, die paraphrasiert statt wörtlich sind. Ein Thema, „Nutzer wollen eine Checkliste“, beruht auf 2 Personen, die um unterschiedliche Dinge gebeten haben. Ein anderes, „Die Quelle bei der Einrichtung ist unklar“, trägt über 5 von 8 Interviews und 9 Tickets.
Nur dieses letzte Thema kommt ins Entscheidungsprotokoll, die 2 Checklisten-Wünsche bleiben als offene Frage stehen. Die Gesamtzeit liegt bei etwa einer Stunde, und jede Aussage, die es auf die Roadmap schafft, wurde von einem Menschen in ihrer Quelle gelesen. Dieselbe Disziplin bei KI-geschriebenen Specs findest du im Claim Trace gegen Spec-Halluzinationen.
Welche Synthese-Aufgaben gibst du an die KI, und welche behältst du?
Aufgabe
An die KI geben?
Warum
Menschliche Kontrolle
Transkription
Ja
Ausgereift und schnell
Namen, Fachjargon und Durcheinanderreden stichprobenartig prüfen
Personenbezogene Daten entfernen
Ja, mit Review
Erspart einen mühsamen Schritt
Bestätigen, dass nichts Identifizierendes übrig bleibt
Beobachtungen mit Zitaten herausziehen
Ja
Gut darin, Passagen zu finden
Zitate müssen wörtlich sein und eine Quelle haben
Erstes Clustering
Ja
Schnelle Sortierhilfe
Nach Situation statt nach Schlüsselwort neu gruppieren
Erwähnungen sind keine Personen; die Stichproben sind klein
Für Verbreitung Analytics oder eine Umfrage nutzen
Usability-Sessions anhand von Transkripten analysieren
Nein
Transkripte verpassen, was Nutzer getan haben (NN/g, 2023)
Die Aufzeichnung ansehen
Empfehlen, was gebaut werden soll
Nein
Dem Modell fehlen Strategie und Abwägungen
Das Team entscheidet
Frühere Research durchsuchen
Ja
Gut für „Was haben Kunden zu X gesagt?“
Die Quelle öffnen, bevor du zitierst
Welche typischen Fehler gibt es bei der KI-Research-Synthese?
Eine flüssige Zusammenfassung als Erkenntnis behandeln. Glätte ist kein Beleg. Ein Thema ist erst eine Erkenntnis, wenn jemand seine Quellen gelesen hat.
Erwähnungen als Personen zählen. Ein genervter Kunde, der ein Problem fünfmal anspricht, ist ein Datenpunkt, nicht fünf.
Segmente vermischen. Eine Solo-Gründerin und ein Team mit 50 Leuten können dasselbe Symptom aus verschiedenen Gründen beschreiben. Wer sie mittelt, erfindet einen Nutzer, den es nicht gibt.
Gegenbeispiele weglassen. Modelle neigen dazu, Spannungen zu einer glatten Geschichte aufzulösen. Frag ausdrücklich nach Widersprüchen und halte sie sichtbar.
Die Zusammenfassung die Quelle ersetzen lassen. Halte das Transkript oder Ticket bei jeder Aussage einen Klick entfernt, sonst kann später niemand die Interpretation hinterfragen.
Zu spät synthetisieren. Erkenntnisse verblassen. Teams, die Continuous Discovery betreiben, synthetisieren wenige Interviews auf einmal, solange der Kontext frisch ist.
KI kann auch eine dünne oder verzerrte Stichprobe nicht reparieren. Wenn du nur mit deinen zufriedensten Kunden gesprochen hast, ist eine perfekte Synthese dieser Calls trotzdem eine Synthese deiner zufriedensten Kunden. Bessere Fragen helfen; unser Kundeninterview-Template konzentriert sich auf aktuelles Verhalten statt auf Meinungen.
Wo Specky ins Spiel kommt
Specky liest Kundengespräche, Feedback, Slack, Jira und Analytics in einen Product Graph ein und entwirft daraus Specs und Tickets mit Inline-Zitaten, die zurück auf die Belege verweisen, damit ein Reviewer die Quelle hinter jeder Aussage öffnen kann. Alex, der Research-Agent von Specky, führt Kundeninterviews über einen teilbaren Link, sodass die Research nicht auf Kalender warten muss. Die Regel aus diesem Leitfaden gilt trotzdem: Ein Zitat macht eine Aussage prüfbar, nicht wahr. Jemand im Team liest die Quelle weiterhin, bevor die Aussage auf die Roadmap kommt.
Häufig gestellte Fragen
Kann KI Kundenresearch allein synthetisieren?
Nein. KI kann viel schneller als ein Mensch transkribieren, Zitate herausziehen und Themen vorschlagen, aber veröffentlichte Vergleiche zeigen, dass sie nur bei 36–47 % der einzelnen Codes und bei etwa 30 % der interpretativen Themen mit menschlichen Codierer:innen übereinstimmt. Nutze sie für den ersten Durchgang, und lass dann jemanden, der Produkt und Kunden kennt, jedes Thema prüfen, das eine Entscheidung verändern könnte.
Wie genau ist KI bei der thematischen Analyse im Vergleich zu Menschen?
Das hängt von der Art des Themas ab. ChatGPT-4 stimmte in einer Studie von 2025 bei über 80 % der deskriptiven Themen mit menschlichen Forschenden überein, aber nur bei rund 30 % der Themen, die kulturelle oder emotionale Interpretation erforderten. Eine Studie von 2024 ergab, dass die KI 71 % der induktiven Themen der Menschen traf. Rechne mit gutem Recall bei offensichtlichen Themen und schwachem Urteil bei Bedeutung.
Wie verhinderst du, dass KI Zitate erfindet?
Verlang für jede Beobachtung eine Quellen-ID und die genaue Passage, und sag dem Modell, es solle alles, was es nicht belegen kann, als unbelegt kennzeichnen. Durchsuche dann das Transkript nach jedem Zitat, das ein Thema mit hoher Wirkung stützt. NN/g stellte fest, dass manche KI-Research-Tools Zitate zuordneten, ohne die Session oder den Zeitstempel zu nennen, was diese Prüfung unmöglich macht. Wähle also Tools, die ihre Quellen angeben.
Ist es sicher, Kundeninterviews in ein KI-Tool hochzuladen?
Nur wenn die Teilnehmenden in diese Verarbeitung eingewilligt haben und deine Organisation das Tool für diese Art von Daten freigegeben hat. Entferne Namen, E-Mail-Adressen und andere Kennungen, die du nicht brauchst, prüfe, wo das Tool Daten speichert und verarbeitet, und beschränke, wer die rohen Transkripte sehen darf. Nach der DSGVO sind Interviewaufzeichnungen und Transkripte personenbezogene Daten, sobald eine teilnehmende Person identifizierbar ist.
Wie viele Interviews brauchst du, bevor KI-Synthese nützlich wird?
KI hilft schon ab dem ersten Interview, bei Transkription und beim Herausziehen von Beobachtungen. Für interviewübergreifende Themen brauchst du mehrere Gespräche zur selben Entscheidung, bevor sich die Prüfung eines Musters lohnt. Die richtige Zahl hängt davon ab, wie vielfältig deine Nutzer sind und wie riskant die Entscheidung ist. Interviews erklären, warum etwas passiert; wie oft es passiert, erfährst du über Analytics oder eine Umfrage.
GDPR-aligned. EU workspace data is stored in Frankfurt, Germany. GDPR and EU data Built in Vienna, Austria. A product of influence solutions fm GmbH (FN 675374y). Imprint 14-day trial. Card required, and nothing is charged until day 14. 30-day refund after subscribing. See pricing