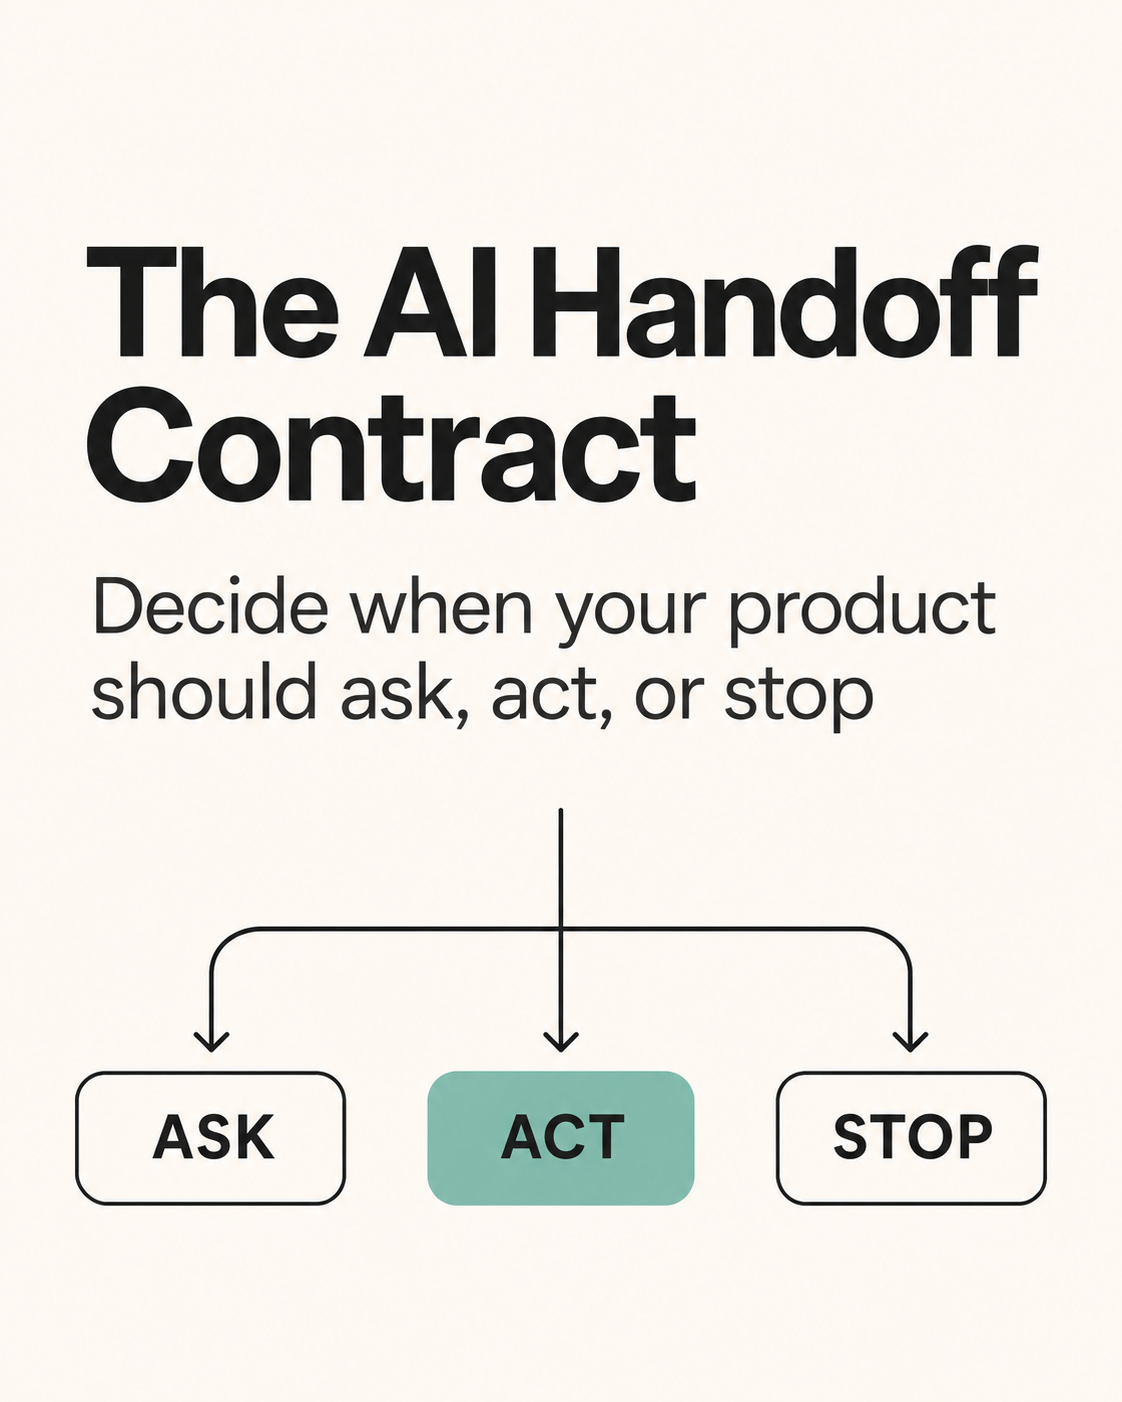
KI-Agent-Handoff: Wann dein Produkt fragen, handeln oder stoppen sollte
Entscheide, wann ein KI-Agent nachfragen, innerhalb klarer Grenzen handeln oder stoppen und an einen Menschen übergeben sollte – mit echten Daten zur geteilten Kontrolle und einer Vorlage für deinen Handoff-Vertrag.
Teilen
Dieser Artikel wurde aus dem Englischen übersetzt. Original lesen
Ein KI-Agent-Handoff ist der Moment, in dem ein KI-Feature die Kontrolle an einen Menschen zurückgibt: um fehlende Informationen einzuholen, um vor einer folgenreichen Aktion eine Freigabe einzuholen, oder um ganz zu stoppen und jemanden übernehmen zu lassen. Ein Handoff-Vertrag legt vor dem Launch fest, wann das Produkt nachfragen sollte, wann es selbstständig handeln darf und wann es stoppen muss – und was Nutzer jeweils zu sehen bekommen.
Das Wichtigste in Kürze
Agenten stoppen sich bereits häufiger selbst, als dass Menschen sie unterbrechen. In Anthropics Studie über rund 500.000 Claude-Code-Sitzungen bat der Agent bei den schwierigsten Aufgaben mehr als doppelt so oft um Klärung wie bei einfachen – und öfter, als Menschen ihn unterbrachen (Anthropic, 2026).
Der häufigste Grund für den Stopp des Agenten war, eine Auswahl zwischen verschiedenen Lösungsansätzen vorzulegen (35 %). Der häufigste Grund für Unterbrechungen durch Menschen war, fehlenden Kontext oder Korrekturen nachzureichen (32 %). Beides sind Probleme des Produktkontexts, keine Modellprobleme.
OpenAIs Leitfaden für Agenten nennt zwei Auslöser für menschliches Eingreifen: das Überschreiten von Fehlerschwellen und Aktionen mit hohem Risiko, die sensibel, unumkehrbar oder folgenschwer sind (OpenAI).
Modell-Konfidenz ist keine Erlaubnis. „90 % sicher“ berechtigt nicht dazu, eine E-Mail zu verschicken oder einen Kundendatensatz zu ändern.
Ein menschlicher Reviewer ist nicht automatisch ein Sicherheitsnetz. In einer Metaanalyse erhöhte ein falscher Ratschlag von Systemen zur Entscheidungsunterstützung das Risiko einer falschen Entscheidung um 26 % (Goddard et al., 2012).
Was ist ein KI-Agent-Handoff?
Der Begriff hat zwei Bedeutungen, und es hilft, sie klar zu trennen.
Agent-to-Agent-Handoff. Im Agents SDK von OpenAI ermöglichen Handoffs einem Agenten, eine Aufgabe an einen anderen zu delegieren – etwa wenn ein Triage-Agent eine Erstattungsanfrage an einen Refund-Agenten übergibt. Das Modell sieht jeden Handoff als Tool, beispielsweise transfer_to_refund_agent (OpenAI Agents SDK). OpenAIs Leitfaden beschreibt dies als eine einseitige Übergabe, die den Konversationsstatus mitnimmt.
Agent-to-Human-Handoff. Der Agent übergibt die Kontrolle an einen Menschen, weil er nicht weitermachen kann oder sollte. Der Leitfaden von OpenAI nennt zwei Beispiele: im Kundenservice die Eskalation an einen menschlichen Supportmitarbeiter; bei einem Coding-Agenten die Rückgabe der Kontrolle an den Nutzer.
In diesem Artikel geht es um die zweite Variante – und die ist eine Produktentscheidung, kein reines Orchestrierungsdetail. Ein Produkt-Agent kann einen nächsten Schritt vorschlagen, ihn vorbereiten oder ihn direkt ausführen. Das sind drei grundlegend verschiedene Verhaltensweisen, selbst wenn auf dem Bildschirm immer nur ein freundlicher „Weiter“-Button zu sehen ist. Die Frage, die ein Handoff-Vertrag beantwortet, lautet: Was darf dieses Produkt im Namen des Nutzers entscheiden, auf Basis welcher Informationen, und was passiert, wenn die Antwort unsicher ist?
Für Nutzer ist das entscheidend. In der Stack-Overflow-Umfrage 2025 machten sich 86,9 % der Entwickler Sorgen um die Richtigkeit von Informationen aus KI-Agenten, und 81,4 % hatten Sicherheits- und Datenschutzbedenken bezüglich ihrer Daten bei deren Nutzung (Stack Overflow, 2025). Eine klare Handoff-Policy adressiert beides: Der Agent tut bei schwacher Faktenlage weniger, und er fasst ohne Erlaubnis weniger an.
Genau das ist Produktarbeit. Als PM bringst du das Domänenwissen ein: Was gilt als angemessene Handlung, welche Kompromisse sind akzeptabel und bei welchen Fehlern muss zwingend der Nutzer übernehmen? Engineers setzen diese Vorgaben in stabiles Produktverhalten um. Als PM übernimmst du damit nicht die Code-Verantwortung.
Warum ist „Human in the Loop“ für einen KI-Agenten zu vage?
Ein Briefing, in dem steht „Wir behalten einen Human in the Loop“, lässt die entscheidenden Fragen offen:
Welche Person prüft das überhaupt, und verfügt sie über den nötigen Kontext, um das zu beurteilen?
Prüft sie einen Vorschlag, einen Entwurf oder eine bereits durchgeführte Aktion?
Kann sie die Aktion ändern oder nur freigeben?
Was passiert, wenn niemand antwortet?
Welche Fehler dürfen unter keinen Umständen delegiert werden?
Regelwerke fordern Teams dazu auf, diese Fragen zu klären – die Antworten liefern sie jedoch nicht mit. Das NIST AI Risk Management Framework 1.0 verlangt von Organisationen, Rollen für Mensch-KI-Konfigurationen zu definieren (GOVERN 3.2), Prozesse für menschliche Aufsicht zu dokumentieren (MAP 3.5) und Mechanismen vorzusehen, um ein KI-System zu übersteuern, zu entkoppeln oder zu deaktivieren, wenn es sich außerhalb des vorgesehenen Zwecks verhält (MANAGE 2.4) (NIST).
Der EU AI Act geht bei Hochrisikosystemen noch weiter. Artikel 14 schreibt vor, dass Personen, die diese Systeme beaufsichtigen, sich des Automation Bias bewusst bleiben, Ausgaben ignorieren, überstimmen oder rückgängig machen und das System über einen „Stopp“-Knopf oder ein ähnliches Verfahren unterbrechen können müssen (EUR-Lex). Nach dem Digital Omnibus gelten diese Pflichten für Hochrisikosysteme nach Anhang III ab dem 2. Dezember 2027 (EUR-Lex, Verordnung 2026/1744). Die meisten Produkt-Agenten sind zwar keine Hochrisikosysteme, aber Fragen, Überstimmen und Stoppen sind für jeden von ihnen ein sinnvoller Mindeststandard.
Auch das Review selbst muss durchdacht gestaltet sein. Goddard und Kollegen untersuchten 74 Studien zu Automation Bias und stellten fest: Lag ein Entscheidungsunterstützungssystem falsch, stieg das Risiko einer falschen Entscheidung durch den Menschen um 26 %. Ein Reviewer, der eine selbstbewusst formulierte Empfehlung und einen „Freigeben“-Button sieht, ist keine unabhängige Kontrollinstanz – es sei denn, das Produkt legt die Belege offen und macht Widerspruch denkbar einfach.
Wann sollte ein KI-Agent fragen, handeln oder stoppen?
Nutze drei Pfade und wähle zwischen ihnen nach Tragweite und Befugnis – nicht nach dem Konfidenzwert des Modells.
Fragen (Ask): Wenn dem System Informationen oder Befugnisse fehlen, die die Entscheidung verändern könnten. Stelle eine konkrete Frage, zeige auf, warum die Antwort wichtig ist, und lass den Nutzer wählen. Wenn das fehlende Detail optional ist, biete einen klar sichtbaren Standardwert an.
Handeln (Act): Wenn die Aufgabe präzise definiert ist, die Aktion im Rahmen dessen liegt, was der Nutzer verlangt hat, und die Konsequenzen verkraftbar sind, falls das System falschliegt. Halte die Aktion sichtbar und sorge dafür, dass sie sich leicht überprüfen oder rückgängig machen lässt.
Stoppen (Stop): Wenn das System nicht verantwortungsvoll fortfahren kann: Die Anfrage liegt außerhalb des zulässigen Produktrahmens, die Belege sind für die Tragweite zu dünn, eine erforderliche Quelle ist nicht erreichbar, eine Fehlerschwelle wurde erreicht oder der nächste Schritt würde Grenzen überschreiten, die der Nutzer nicht autorisiert hat. Erkläre den Grund und biete einen nächsten Schritt an, etwa die Anfrage anzupassen oder an einen Menschen zu übergeben.
Pfad
Wann nutzen
Was der Nutzer sieht
Beispiel
Fragen
Fehlende oder widersprüchliche Infos würden das Ergebnis verändern
Eine Frage, warum sie wichtig ist, 2–4 Optionen
„Nach Account-Fit oder nach aktuellem Kaufsignal priorisieren?“
Handeln
Anfrage ist klar, Aktion liegt im Rahmen und ist umkehrbar
Das Ergebnis, was geändert wurde, ein Undo
Antwortentwurf in den Entwürfen des Nutzers gespeichert
Handeln nach Bestätigung
Aktion liegt im Rahmen, hat aber spürbare Konsequenzen
Eine Vorschau und eine explizite Bestätigung
Die Antwort direkt an den Kunden senden
Stoppen
Außerhalb des Rahmens, zu wenige Belege, Fehlerschwelle erreicht oder unautorisiert
Den Grund und einen nächsten Schritt oder Ansprechpartner
„Ich kann Rechnungsdaten nicht ändern. Hier erfährst du, wer das kann.“
Konfidenz ist keine Erlaubnis. Wenn ein Modell sagt, dass es sich zu 90 % sicher ist, gibt ihm das noch lange nicht das Recht, eine E-Mail zu verschicken, einen Kundendatensatz zu ändern oder eine Produktentscheidung festzuschreiben. Der Pfad hängt von der Aufgabe, den Belegen, der Befugnis des Nutzers und den Kosten eines Fehlers ab. Für Entscheidungen, die eine feste Antwort liefern (wie Klassifizieren, Routen oder Bewerten), zeigt das Framework für KI-Entscheidungen, wie man Schwellenwerte anhand der Fehlerkosten festlegt. Zur Einschätzung, wie umkehrbar eine Aktion ist, hilft der Leitfaden zu One-Way- vs. Two-Way-Door-Produktentscheidungen.
Wie teilen sich KI-Agenten und Menschen heute die Kontrolle?
Anthropics Studie vom Februar 2026 liefert die bislang besten öffentlich verfügbaren Daten. Sie analysierte rund 500.000 interaktive Claude-Code-Sitzungen und 998.481 Tool-Aufrufe über die öffentliche API (Anthropic, 2026).
Warum der Agent von sich aus stoppte:
Grund für die Pause von Claude Code
Anteil
Um eine Auswahl zwischen Lösungsansätzen vorzulegen
35 %
Um Diagnoseinformationen oder Testergebnisse einzuholen
21 %
Um eine vage Anfrage zu klären
13 %
Um Zugangsdaten oder Berechtigungen anzufragen
12 %
Um vor der Ausführung eine Freigabe einzuholen
11 %
Warum Menschen unterbrachen: Um fehlenden Kontext oder Korrekturen nachzureichen (32 %), weil der Agent langsam war, hing oder zu viel auf einmal tat (17 %), und um den nächsten Schritt selbst zu übernehmen (7 %).
Wie sich Vertrauen mit der Erfahrung veränderte: Neue Nutzer (unter 50 Sitzungen) nutzten die vollständige automatische Freigabe in rund 20 % der Sitzungen; ab 750 Sitzungen stieg dieser Wert auf über 40 %. Erfahrene Nutzer unterbrachen allerdings auch häufiger – in rund 9 % der Turns gegenüber rund 5 % bei Nutzern mit etwa 10 Sitzungen. Anthropic deutet das als aktives Monitoring, nicht als ein Aufgeben der Aufsicht.
Wie das Risikoprofil auf der API aussah: 80 % der Tool-Aufrufe stammten von Agenten mit mindestens einer Sicherheitsvorkehrung, etwa eingeschränkten Berechtigungen oder Freigabepflichten; bis zu 73 % schienen einen Human in the Loop zu haben (die Autoren bezeichnen dies als Obergrenze); und nur 0,8 % der Aktionen schienen unumkehrbar zu sein.
Daraus ergeben sich drei Lektionen für Produktteams:
Gestalte das „Fragen“ für Wahlmöglichkeiten, nicht nur für Lücken. Der mit Abstand häufigste Grund für eine Pause des Agenten war, eine Wahl zwischen verschiedenen Ansätzen anzubieten. Mache daraus einen vollwertigen Screen mit klaren Optionen.
Die meisten Unterbrechungen entstehen durch fehlenden Kontext. Ein Drittel der menschlichen Eingriffe diente dazu, Kontext oder Korrekturen zu liefern, die dem Agenten fehlten. Besserer Produktkontext von Beginn an reduziert sowohl Nachfragen als auch Unterbrechungen. Das PRD-Template für KI-Coding-Agenten zeigt, wie man diesen bereitstellt.
Design für Interventionen, nicht für die Freigabe jedes einzelnen Schritts. Anthropic empfiehlt, Nutzern Sichtbarkeit und einfache Möglichkeiten zu geben, einen Agenten umzuleiten, anstatt für jede einzelne Aktion eine Freigabe zu verlangen. Nutzer, die dem Agenten mehr vertrauen, wollen dennoch jederzeit schnell eingreifen können.
Wie setzen reale Produkte Fragen, Handeln und Stoppen um?
Die Berechtigungsmodi von Claude Code sind ein hervorragendes Praxisbeispiel, da jeder Modus eine andere Handoff-Policy abbildet (Claude Code docs):
Claude-Code-Modus
Was er ohne Nachfrage tut
Hinterlegter Handoff-Pfad
Manual (default)
Nur Lesezugriff; fragt vor Bearbeitungen, Shell-Befehlen und Netzwerkzugriffen
Fragen vor jedem Schreibzugriff
acceptEdits
Lesezugriff, Dateiänderungen und gängige Dateibefehle im Arbeitsverzeichnis
Handeln bei risikoarmen, umkehrbaren Änderungen; Fragen beim Rest
plan
Liest und analysiert; Änderungen blockiert, bis du einen Plan freigibst
Einmal vorab fragen, anhand eines Plans
auto
Alles, wobei ein Klassifikator jede Aktion prüft
Handeln, mit einem Prüfmodell, das stoppen kann
dontAsk
Nur vorab freigegebene Tools; alles andere wird verweigert
Handeln innerhalb fester Grenzen; Stoppen außerhalb
Zwei Details lohnen sich zum Nachahmen. Erstens: Der Auto-Modus blockiert standardmäßig eine Liste folgenreicher Aktionen – darunter Production-Deployments und -Migrationen, Force-Pushes, Massenlöschungen im Cloud-Speicher und das Mergen von Pull Requests, die kein Mensch freigegeben hat. Das ist eine Stopp-Liste. Zweitens: Blockiert der Klassifikator eine Aktion 3-mal hintereinander oder 20-mal insgesamt, pausiert der Auto-Modus und Claude Code kehrt zum Nachfragen zurück. Das ist eine Fehlerschwelle – genau der erste Auslöser in OpenAIs Leitfaden. Deny-Regeln gelten in jedem Modus, was die harte Grenze darstellt.
OpenAIs Leitfaden liefert zudem einen Ansatz, um festzulegen, welche Aktionen welchen Pfad erfordern: Weise jedem Tool eine niedrige, mittlere oder hohe Risikostufe zu – basierend auf Lese- versus Schreibzugriff, Umkehrbarkeit, erforderlichen Berechtigungen und finanziellen Auswirkungen. Pausiere dann für Prüfungen oder eskaliere vor Rufen mit hohem Risiko an einen Menschen. Als Beispiele für Aktionen, die eine menschliche Aufsicht auslösen sollten, nennt OpenAI das Stornieren von Bestellungen, das Autorisieren hoher Rückerstattungen und das Ausführen von Zahlungen.
Anthropics eigene Leitlinien für Agenten betonen denselben Punkt aus technischer Sicht: Agenten können an Prüfpunkten oder bei Blockern für menschliches Feedback anhalten, sollten sich bei jedem Schritt verlässliche Fakten aus der Umgebung holen und brauchen Abbruchbedingungen wie eine maximale Anzahl von Iterationen (Anthropic, 2024).
Wie schreibt man einen Handoff-Vertrag für KI-Agenten?
Formuliere für jeden KI-unterstützten Workflow einen Handlungsrahmen in einfacher Sprache – kurz genug, damit Produktmanagement, Design, Engineering und Support ihn gemeinsam prüfen können.
Vertragsfeld
Zu beantwortende Frage
Nutzer und Job
Wer versucht was zu erledigen?
Erlaubte Aktionen
Was darf das Produkt vorbereiten oder tun, und mit welcher Risikostufe?
Erforderlicher Kontext
Welche Fakten, Berechtigungen oder Quellen müssen vorhanden sein?
Frage-Bedingung
Welches fehlende oder widersprüchliche Detail geht zurück an den Nutzer?
Stopp-Bedingung
Was macht ein Weitermachen unzumutbar?
Fehlerschwelle
Nach wie vielen Fehlversuchen wird übergeben?
Bestätigung
Welche Aktionen erfordern eine explizite Prüfung oder Freigabe?
Recovery
Wie kann der Nutzer das Ergebnis korrigieren, rückgängig machen oder abgeben?
Revisionsauslöser
Welches Signal oder Datum öffnet den Vertrag zur Überprüfung?
Dieser Rahmen beschreibt das Verhalten, nicht die Implementierung. Er schreibt kein bestimmtes Modell, keinen Prompt, keine API und keine Architektur vor; das gehört in den technischen Entwurf, sobald Einigkeit darüber herrscht, was das Produkt tun soll.
Kopiere diese Vorlage in ein Product Brief:
## Handoff-Vertrag: [Workflow]
Für [Nutzer], der versucht, [Job] zu erledigen, darf das Produkt [erlaubte Aktion],
wenn [erforderlicher Kontext] vorliegt.

Fragen, wenn: [entscheidungsrelevante Information fehlt oder widersprüchlich ist]
Stoppen, wenn: [Grenze erreicht, schwache Belege, fehlende Quelle oder unautorisierter Schritt]
Fehlerschwelle: übergeben nach [n] Fehlversuchen bei [Schritt]
Bestätigen vor: [folgenreiche Aktion] (Risiko: niedrig / mittel / hoch)
Recovery: Nutzer kann [rückgängig machen / bearbeiten / neu zuweisen] über [Mechanismus]
Owner: [PM] für Policy, [Engineer] für Implementierung
Revision, wenn: [Signal, Incident oder Datum]
Gehe den Vertrag anschließend mit einem PM, einem Engineer, einem Designer und jemandem aus dem operativen Bereich an echten Beispielen durch. Passe den Vertrag so lange an, bis jedes Beispiel einen nachvollziehbaren Pfad hat und für den Nutzer jederzeit ersichtlich ist, was passiert ist.
Führe ein Decision Log
Sobald das Team einen Vertrag freigibt, halte fest, was erlaubt ist, welche Nutzer oder Situationen abgedeckt sind, welche Belege dahinterstehen, wer der Owner ist, welche Testfälle ihn absichern und was eine Überprüfung auslösen würde. Wenn das Produkt später zu oft nachfragt, auf schwacher Datenbasis handelt oder ohne sinnvollen nächsten Schritt abbricht, kann das Team das Verhalten direkt auf die Policy zurückführen. Ein Product Decision Log reicht dafür völlig aus. Es verhindert zudem verwässerte Zuständigkeiten: PMs definieren das gewünschte Verhalten und die Trade-offs; Engineers verantworten Implementierung, Berechtigungen, Zuverlässigkeit und Betriebssicherheit.
Praxisbeispiel: Priorisierung von Vertriebs-Leads
Hier ist ein anschauliches Beispiel. Stell dir ein KI-Feature vor, das ein Vertriebsteam bei der Sortierung von Leads unterstützt. Ein großes Unternehmen mit solider Finanzierung wirkt attraktiv. Ein kleineres Unternehmen mit einem frischen Kaufsignal aus der letzten Woche ist womöglich dringlicher. Beide Fakten können zutreffen; das Produkt braucht dennoch eine klare Regel, was schwerer wiegt.
Der Vertrag könnte so aussehen:
Erlaubte Aktion: Eine Prioritätsstufe vorschlagen (Risiko: niedrig, da es ein Vorschlag ist) und die Belege dahinter transparent machen.
Erforderlicher Kontext: Die Kriterien des Teams für den Account-Fit sowie Datum und Quelle jedes Kaufsignals.
Fragen: Die Priorisierungsregel des Teams abfragen, falls „bester Lead“ noch nicht definiert wurde.
Stoppen: Nicht von der Unternehmensgröße auf ein Kaufsignal schließen und niemals ohne Quelle behaupten, ein Account sei kaufbereit.
Fehlerschwelle: Schlägt die Datenanreicherung für einen Account zweimal fehl, wird er als „manuelle Prüfung erforderlich“ markiert, statt Vermutungen anzustellen.
Bestätigung: Ein Vertriebsmitarbeiter prüft die Einstufung, bevor sie die gemeinsame Pipeline verändert (Risiko: mittel, da andere danach handeln).
Recovery: Der Prüfer kann die Einstufung ändern und den Grund dafür festhalten.
Der Vertrag legt eine Entscheidung offen, die das Modell nicht eigenständig treffen kann: Soll dieses Team Passgenauigkeit, Dringlichkeit oder eine definierte Balance aus beidem priorisieren? Als PM bringst du die nötige Fachkompetenz ein – oder holst die richtigen Personen an einen Tisch – und machst den Trade-off überprüfbar. Das Modell wendet die gewählte Regel an; es soll sich keine eigene ausdenken.
Wie testet man einen Handoff-Vertrag vor dem Launch?
Erstelle eine kleine Reihe repräsentativer Fälle und prüfe, ob das Produkt den richtigen Pfad wählt und diesen verständlich erklärt. Berücksichtige dabei folgende Szenarien:
Die Anfrage ist vollständig und die Aktion umkehrbar (erwartet: Handeln).
Ein notwendiger Fakt fehlt und unterschiedliche Antworten würden das Ergebnis ändern (erwartet: Fragen).
Zwei Quellen widersprechen sich (erwartet: Fragen unter Offenlegung beider Quellen).
Der Nutzer verlangt etwas außerhalb der definierten Befugnisse (erwartet: Stoppen).
Die Belege sind im Verhältnis zu den Konsequenzen zu dünn (erwartet: Stoppen oder Fragen).
Eine Abhängigkeit schlägt fehl oder eine Quelle ist nicht erreichbar (erwartet: Wiederholen bis zur Schwelle, dann übergeben).
Halte für jeden Fall den erwarteten Pfad, die Begründung und das fest, was der Nutzer sehen soll: „Fragen, weil das Datum des Kaufsignals fehlt; Account-Quelle anzeigen und dem Vertriebler erlauben, es zu ergänzen oder zu überspringen.“ Das ist überprüfbar. „Vorsichtig sein“ ist es nicht.
Gehe echte Outputs mit Leuten durch, die die Domäne genau kennen. Wenn sich die Reviewer uneinig sind, bilde nicht einfach den Mittelwert aus ihren Bewertungen, um das Thema abzuhaken. Finde heraus, welche unausgesprochene Grundsatzentscheidung dahintersteckt: Vielleicht optimiert ein Reviewer auf Passgenauigkeit, ein anderer auf Dringlichkeit. Löse diesen Konflikt, schreibe die Entscheidung in den Vertrag und ergänze einen Fall, der die Unterscheidung testbar macht. Die Schleife lautet: Fall beobachten, Ermessensspielraum identifizieren, Policy vereinbaren, Testfälle aktualisieren, Verhalten erneut prüfen. Das KI-Evaluation-Framework für Produktteams zeigt, wie man solche Fälle zu einem vollständigen Eval-Set ausbaut.
Diese Testfälle ersetzen weder das Production-Monitoring noch technische Sicherheitsnetze. Aber sie stellen sicher, dass im Team Einigkeit darüber herrscht, was das Produkt eigentlich tun soll.
Wie macht man „Fragen“ zu einem nützlichen Produktzustand?
Nachfragen ist nicht automatisch die sicherere Variante. Zu viele Unterbrechungen wälzen die Arbeit wieder auf den Nutzer ab und lassen das Feature unfertig wirken. Eine Frage sollte nur dann auftauchen, wenn die Antwort das Ergebnis tatsächlich verändern kann. Microsofts 18 Guidelines for Human-AI Interaction, die über 20 Jahre Forschung zusammenfassen, behandeln das Verhalten eines Systems bei Fehlern als eine eigene Designphase – getrennt von der regulären Interaktion (Microsoft Research, 2019).
Ein nützlicher Handoff-Screen zeigt:
was das System bisher erarbeitet hat
welche Information fehlt oder widersprüchlich ist
warum das die nächste Aktion beeinflusst
zwei bis vier klare Optionen, inklusive „Später entscheiden“, sofern das gefahrlos möglich ist
Kann der Nutzer das Ergebnis anhand einer Vorschau problemlos korrigieren, ist ein Bestätigungsschritt oft besser als eine Frage. Wenn das Produkt eine umkehrbare Aktion ausführen und ein klares Undo anbieten kann, muss es den Arbeitsfluss womöglich gar nicht unterbrechen.
Typische Fehler bei KI-Agent-Handoffs
Konfidenz mit Erlaubnis verwechseln. Eine Wahrscheinlichkeit sagt dir, wie sicher sich das Modell ist – nicht, ob der Nutzer die Aktion autorisiert hat.
Wegen jeder Kleinigkeit fragen. Ständige Freigabeaufforderungen trainieren Nutzer darauf, ungelesen auf „Freigeben“ zu klicken – Automation Bias par excellence.
Stoppen ohne nächsten Schritt. Ein einfaches „Dabei kann ich nicht helfen“ ohne Begründung oder Weg zu einem Menschen ist eine Sackgasse.
Keine Fehlerschwelle. Ohne Retry-Limit kann sich ein Agent in einer fehlerhaften Schleife verfangen. Lege eine Zahl fest und übergib, sobald sie erreicht ist.
Ein einziger Vertrag für jede Aktion. Reine Leseabfragen und Zahlungen erfordern völlig unterschiedliche Pfade. Bewerte jede Aktion separat.
Versteckte Policies. Wenn sich Reviewer über das richtige Ergebnis uneinig sind, fehlt dem Vertrag eine Regel – nicht dem Modell.
Kein Revisionsauslöser. Agenten und Nutzer verändern sich. Benenne das Signal oder das Datum, an dem der Vertrag erneut auf den Tisch kommt.
Wie Specky hier reinpasst
Speckys eigener MCP-Server folgt genau diesem Muster für Agenten, die in einem Produkt-Workspace arbeiten: Agenten erstellen PRDs, Insights, Decisions und Tickets als Entwurf oder Vorschlag, die PM Inbox dient als Review-Queue, und ein automatisches Veröffentlichen erfolgt nur, wenn der Nutzer es im selben Turn explizit anfordert. Du kannst jeden Handoff-Vertrag direkt im Decision Log festhalten – genau neben den Belegen, auf denen er basiert. Sieh dir Specky für technische PMs an, um den gesamten Workflow kennenzulernen.
Häufig gestellte Fragen (FAQ)
Was ist ein KI-Agent-Handoff?
Ein KI-Agent-Handoff ist die Übergabe der Kontrolle durch ein KI-Feature – entweder an einen anderen Agenten oder an einen Menschen. Im Produktdesign meint man damit meist den Fall Agent-to-Human: Der Agent fragt nach fehlenden Informationen, bittet vor folgenreichen Aktionen um Freigabe oder stoppt und lässt eine Person übernehmen. Ein Handoff-Vertrag definiert diese Auslöser vor dem Launch.
Wann sollte ein KI-Agent um Bestätigung bitten?
Vor Aktionen, die folgenschwer sind, aber innerhalb des Rahmens liegen: Nachrichten an Kunden senden, geteilte Datensätze ändern, Geld ausgeben oder alles, was sich nur schwer rückgängig machen lässt. Stufe jede Aktion anhand von Schreibzugriff, Umkehrbarkeit, Berechtigungen und finanziellen Auswirkungen als niedrig, mittel oder hoch ein – und verlange bei mittlerem oder hohem Risiko eine Bestätigung. Risikoarme, umkehrbare Aktionen können stattdessen mit einer sichtbaren Undo-Option ausgeführt werden.
Was ist der Unterschied zwischen Agent-to-Agent- und Agent-to-Human-Handoff?
Ein Agent-to-Agent-Handoff ist eine interne Delegation im System: Im Agents SDK von OpenAI übergibt ein Triage-Agent eine Erstattungsanfrage per Tool-Call an einen Refund-Agenten. Ein Agent-to-Human-Handoff gibt die Kontrolle an eine Person zurück, weil der Agent nicht weitermachen kann oder sollte. Ersteres ist eine Frage der Orchestrierung; Letzteres ist eine Produktentscheidung über Befugnisse und Risiken.
Reicht „Human in the Loop“ aus, um einen KI-Agenten sicher zu machen?
Nein. Eine prüfende Person hilft nur, wenn sie die nötigen Belege, die Zeit und eine einfache Möglichkeit zum Widerspruch hat. Eine Übersichtsarbeit von 74 Studien ergab, dass ein falscher Ratschlag von Systemen zur Entscheidungsunterstützung das Risiko einer Fehlentscheidung um 26 % erhöhte. Definiere genau, wer was prüft, was zu sehen ist, was geändert werden kann und was passiert, wenn niemand reagiert.
Wie oft sollte ein KI-Agent den Nutzer unterbrechen?
Nur dann, wenn die Antwort das Ergebnis tatsächlich verändern könnte oder die Aktion Befugnisse erfordert, die dem Agenten fehlen. In Anthropics Daten von 2026 bat Claude Code bei komplexen Aufgaben häufiger um Klärung als bei einfachen, und erfahrene Nutzer unterbrachen in rund 9 % der Turns. Miss deine eigene Nachfragerate und den Anteil der Fragen, die von Nutzern sinnvoll beantwortet werden.
Verlangt der EU AI Act einen menschlichen Handoff für KI-Agenten?
Für Hochrisikosysteme verlangt Artikel 14, dass Aufsichtspersonen Grenzen verstehen, sich des Automation Bias bewusst bleiben, Ergebnisse überstimmen oder rückgängig machen und das System stoppen können. Nach dem Digital Omnibus gelten diese Pflichten für Hochrisikosysteme nach Anhang III ab dem 2. Dezember 2027. Die meisten Produkt-Agenten fallen nicht darunter, doch das Muster aus Fragen, Überstimmen und Stoppen ist in jedem Fall Best Practice.
GDPR-aligned. EU workspace data is stored in Frankfurt, Germany. GDPR and EU data Built in Vienna, Austria. A product of influence solutions fm GmbH (FN 675374y). Imprint 14-day trial. Card required, and nothing is charged until day 14. 30-day refund after subscribing. See pricing