4. November 2026Aktualisiert am Fathy Shalaby16 Min. Lesezeit
KI-Product-Discovery für Startups: Ein praxisnaher Zwei-Wochen-Workflow
KI macht Prototypen billig – deshalb ist Discovery jetzt die Arbeit, die kleine Teams davor bewahrt, das Falsche zu bauen. Mit diesem Zwei-Wochen-Zyklus testest du ein echtes Problem, bevor du einen Build hochskalierst.
Teilen
Dieser Artikel wurde aus dem Englischen übersetzt. Original lesen
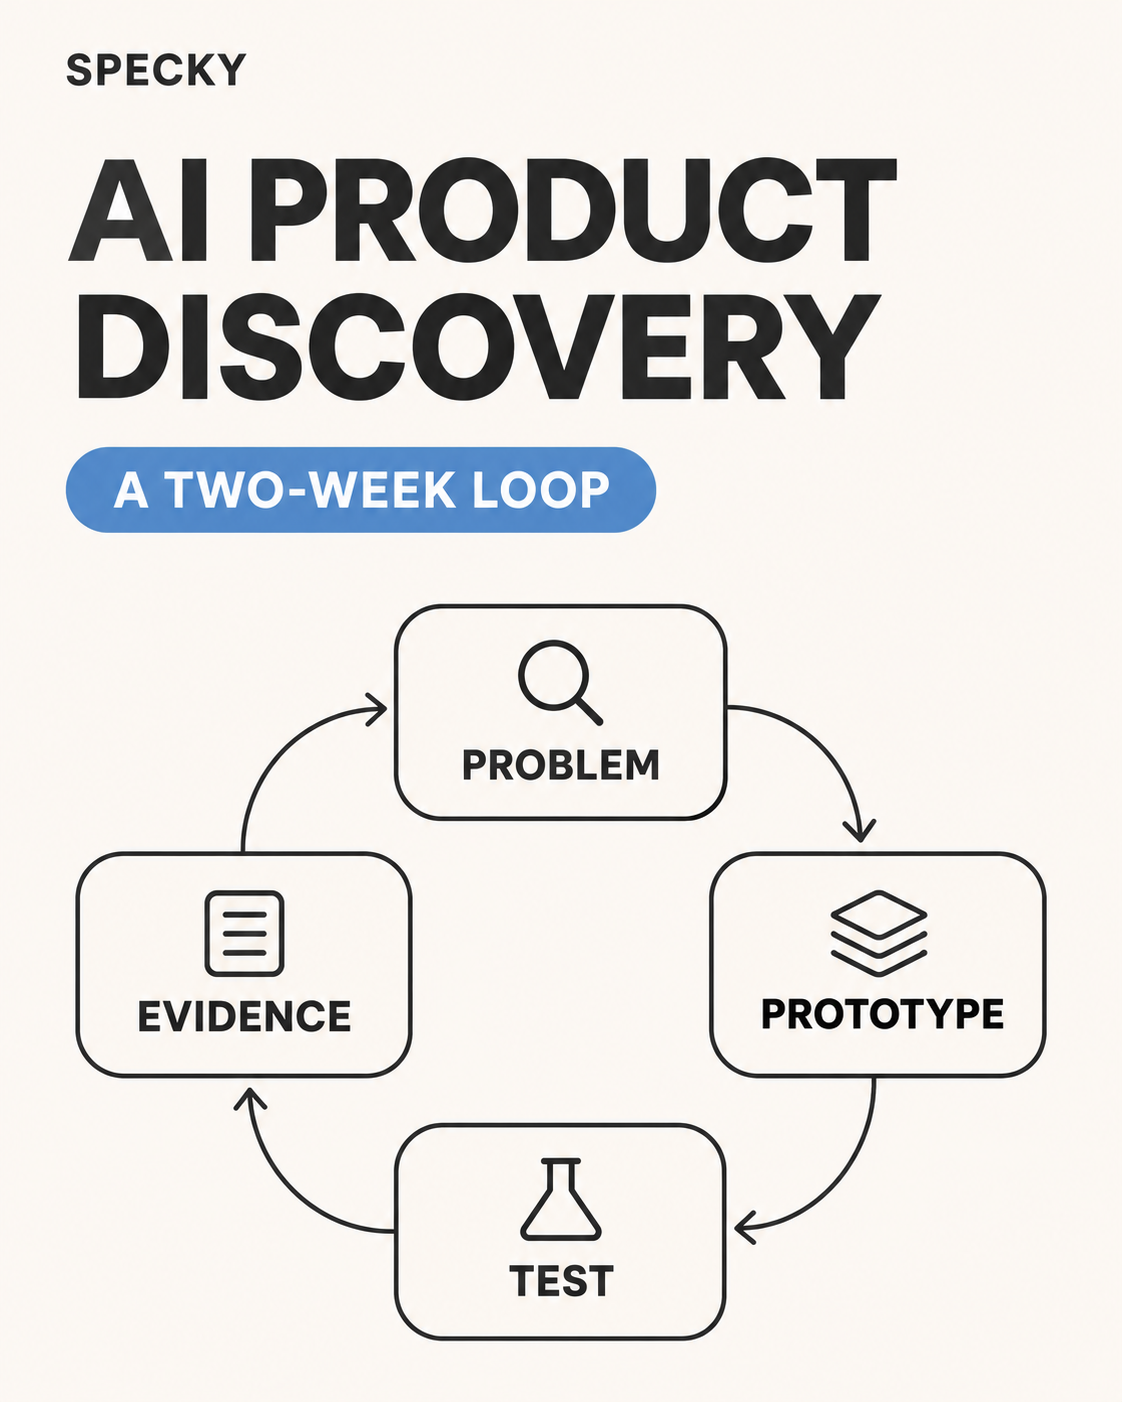
KI-Product-Discovery ist die Arbeit, zu entscheiden, was gebaut wird und ob KI dabei überhaupt eine Rolle spielen sollte – auf Basis von Kundenbelegen und nicht danach, wie schnell ein Prototyp entsteht. Für ein Startup passt eine praxistaugliche Version in zwei Wochen: eine Entscheidung klar formulieren, direkte Belege sammeln, die riskanteste Annahme auswählen, sie mit dem kleinstmöglichen Prototyp testen und dann festhalten, ob ihr weitermacht, ändert, pausiert oder stoppt.
Die wichtigsten Erkenntnisse
Bauen ist billiger geworden, zu wissen, was man bauen soll, nicht. 84 % der Entwickler:innen nutzen KI-Tools oder planen es, doch 66 % nennen als größte Frustration Ergebnisse, die „fast richtig, aber eben nicht ganz“ sind (Stack Overflow, 2025).
Tempo fühlt sich auch dann real an, wenn es das nicht ist. In METRs Studie von 2025 brauchten erfahrene Entwickler:innen mit KI 19 % länger, glaubten aber, 20 % schneller zu sein (METR, 2025).
Das meiste ausgelieferte Werk bleibt ungenutzt: 80 % der Features in einem durchschnittlichen Produkt werden selten oder nie genutzt (Pendo, 2019).
43 % der VC-finanzierten Startups, die seit 2023 dichtgemacht haben, nannten einen schwachen Product-Market-Fit als Grund (CB Insights, 2026).
KI kann Belege ordnen und Testinstrumente bauen. Sie kann aber nicht selbst der Beleg sein: Simulierte Nutzer:innen fallen zu positiv und zu oberflächlich aus (Nielsen Norman Group, 2024).
Warum ist Product Discovery wichtiger, wenn KI das Bauen billig macht?
KI-Coding-Tools machen aus einer Idee an einem Nachmittag einen lauffähigen Prototyp. In der Stack Overflow Developer Survey 2025 gaben 84 % der Befragten an, KI-Tools in der Entwicklung zu nutzen oder dies zu planen, und 47,1 % nutzen sie täglich (Stack Overflow, 2025). Nichts davon sagt dir, ob das Problem für irgendjemanden wichtig ist.
Zwei Zahlen zeigen, was es kostet, Discovery zu überspringen. Pendos Analyse von 615 Produkt-Abonnements ergab: 12 % der Features erzeugen 80 % der täglichen Nutzung, und 80 % werden selten oder nie genutzt (). Und als CB Insights 431 VC-finanzierte Unternehmen untersuchte, die seit 2023 geschlossen haben, fand es für 385 davon Gründe; 43 % nannten einen schwachen Product-Market-Fit ().
Dazu kommt eine Wahrnehmungsfalle. METR führte eine randomisierte Studie mit 16 erfahrenen Open-Source-Entwickler:innen an 246 realen Aufgaben durch. Die Entwickler:innen erwarteten von KI eine Beschleunigung um 24 %; mit erlaubter KI dauerten die Aufgaben 19 % länger, und trotzdem schätzten sie hinterher, 20 % schneller gewesen zu sein (METR, 2025). METR hat diese Ergebnisse inzwischen als Anfang-2025-Resultate eingeordnet und eine Folgestudie zu neueren Tools veröffentlicht, aber die Lehre für Discovery bleibt: Wenn ein Team nicht sagen kann, ob KI das Programmieren schneller gemacht hat, wird es auch schwer beurteilen können, ob eine schicke Demo Nachfrage bewiesen hat.
Der Engpass verschiebt sich also. Wenn die Umsetzung billig ist, ist Discovery die Arbeit, die ein kleines Team davon abhält, schneller noch mehr vom Falschen zu bauen.
Was ist KI-gestützte Product Discovery?
Der Begriff umfasst zwei Aufgaben. Die erste: KI innerhalb des Discovery-Prozesses einsetzen, also Outreach entwerfen, Interviews transkribieren und taggen, Feedback clustern, versteckte Annahmen auflisten und Test-Prototypen bauen. Die zweite: herausfinden, ob sich ein KI-Feature überhaupt zu bauen lohnt. Dieser Workflow deckt beides ab, und in beiden Fällen behalten die Menschen im Team die Verantwortung für die Belege und die Entscheidung.
Discovery-Aufgabe
Wobei KI hilft
Was beim Menschen bleibt
Recruiting
Outreach entwerfen, Screener-Antworten sortieren
Entscheiden, wer als Zielnutzer:in zählt
Interviews
Transkription; KI-moderierte Interviews für strukturierte Fragen
Tiefe explorative Interviews, bei denen der Weg unklar ist
Synthese
Clustern, Taggen, erste Zusammenfassungen mit Quellenverweis
Beurteilen, was ein Muster bedeutet
Annahmen
Versteckte Annahmen auflisten, den Gegenfall durchspielen
Sie nach Entscheidungsrisiko ordnen
Prototypen
In Stunden einen klickbaren Mock oder einen dünnen Durchstich bauen
Festlegen, was der Test zeigen muss
Entscheidung
Das Entscheidungsprotokoll entwerfen
Die Entscheidung treffen und verantworten
Praktiker:innen ziehen diese Linie bereits. In einer Umfrage der Nielsen Norman Group von 2026 unter 521 UX-Praktiker:innen gaben 67 % derer, die Forschungsdaten auswerten, an, dafür oft oder immer KI zu nutzen, aber nur 11 % hatten KI-Interviewer eingesetzt, und 61 % hatten KI noch nie für Nutzerinterviews verwendet (Nielsen Norman Group, 2026). Der Analyse vertraut man bei KI deutlich mehr als dem Gespräch selbst. (Wenn du KI-Interviewer gründlich abwägen willst, lies unseren Leitfaden zu KI-moderierten Kundeninterviews.)
Was sollte Discovery klären, bevor du einen Coding-Agenten öffnest?
Beantworte zuerst fünf Fragen:
Wer ist der Nutzer bzw. die Nutzerin, und welche kürzlich erledigte Aufgabe will er oder sie abschließen?
Welcher Beleg zeigt, dass die Aufgabe schmerzhaft oder wichtig ist?
Was ist noch eine Annahme?
Warum könnte KI mehr helfen als ein einfacherer Workflow oder eine deterministische Regel?
Welches Ergebnis würde die nächste Produktentscheidung ändern?
Diese Fragen entsprechen Marty Cagans vier großen Risiken: Value (werden sie es nutzen oder kaufen), Usability (finden sie sich zurecht), Feasibility (können wir es bauen) und Business Viability (funktioniert es für das Unternehmen) (SVPG, 2017). KI-Features bringen einen weiteren Check mit: Schlägt das Modell eine einfachere Baseline? Unser Vier-Fragen-Test, ob ein Feature KI nutzen sollte, deckt diesen Vergleich ab.
Wenn du die fünf Fragen noch nicht beantworten kannst, ist der nächste Schritt ein Kundengespräch, eine Durchsicht von Support-Tickets oder ein manueller Test – nicht ein größerer Prototyp.
Wie läufst du einen zweiwöchigen KI-Product-Discovery-Zyklus?
Sieh den Zeitplan als Planungshilfe, nicht als Versprechen. Ein Solo-Gründer kann ihn straffen; regulierte oder risikoreiche Produkte brauchen womöglich mehr Prüfung. Behalte die Reihenfolge bei: lernen, ein Risiko wählen, testen, entscheiden.
Tage
Arbeit
Ergebnis
1–2
Die Entscheidung klar formulieren
Ein:e Nutzer:in, ein Job, eine Entscheidung, die die Belege ändern könnten
3–4
Direkte Belege sammeln
Notizen zu echten Gesprächen, beobachtetes Verhalten, Tickets oder Nutzungsdaten
5–6
Die riskanteste Annahme wählen
Ein Test mit einem Erfolgssignal und einer Misserfolgsbedingung, schriftlich festgehalten
7–8
Den kleinsten sinnvollen Test bauen
Ein Mock, ein Concierge-Service, ein Prototyp oder ein Workflow-Ausschnitt
9–10
Beobachten und entscheiden
Ein Entscheidungsprotokoll: weitermachen, ändern, pausieren oder stoppen
Tage 1–2: Eine Entscheidung klar formulieren
Schreib einen Satz:
Sollten wir [bestimmte Nutzer:innen] dabei helfen, [bestimmte Aufgabe] zu erledigen, indem wir [vorgeschlagene Änderung] umsetzen?
Liste dann die Annahmen darunter auf, getrennt nach Typ:
Problemannahme: Ein Solo-Product-Engineer verbringt echte Zeit damit, verstreute Nutzeranfragen in eine Entscheidung darüber zu verwandeln, was gebaut wird.
Lösungsannahme: Ein KI-gestützter Workflow kann diese Belege ordnen, ohne die Quelle zu verlieren oder zu überzeichnen, was sie beweisen.
Risikoannahme: Der Nutzer kann das Ergebnis prüfen und korrigieren, bevor es eine Build-Entscheidung beeinflusst.
Das sind Beispiele, keine Kundenaussagen. Es geht darum, jede Annahme sichtbar zu machen, damit du sie einzeln testen kannst; die kostenlose Assumption Map erledigt das in wenigen Minuten.
Wähle eine enge Gruppe nach Rolle, Workflow oder Rahmenbedingung. „Startups“ ist zu breit. „Technische Gründer:innen von B2B-Tools, die Support-Gespräche lesen, bevor sie Arbeit priorisieren“ gibt dem Test einen Ausgangspunkt.
Tage 3–4: Direkte Belege sammeln
Starte mit Material, das dein Team prüfen kann:
Notizen aus Gesprächen über eine kürzlich erledigte, konkrete Aufgabe
Support-Anfragen und Onboarding-Fragen
Produktnutzung, die zeigt, wo Leute stocken oder Arbeit wiederholen
Eine Bildschirmübertragung oder Aufgabenbeobachtung
Sales- oder Customer-Success-Calls, mit ihrem Kontext gekennzeichnet
Halte Beobachtungen und Interpretationen auseinander. „Der Nutzer hat dieselben Kontodaten in drei Masken kopiert“ ist eine Beobachtung. „Er braucht einen KI-Agenten“ ist eine Hypothese.
Wie viele Gespräche? Die Nielsen Norman Group empfiehlt, mit fünf oder sechs zu beginnen, laufend auszuwerten und aufzuhören, wenn neue Interviews nichts Neues mehr bringen. In der Studie von Guest, Bunce und Johnson waren 34 von 36 häufigen Codes nach sechs Interviews aufgetaucht; Griffin und Hauser schätzten in ihrer Arbeit zu Kundenbedürfnissen, dass 20–30 Interviews 90–95 % der Bedürfnisse in einer breiten Kategorie aufdecken (Nielsen Norman Group, 2021). Für einen Zwei-Wochen-Zyklus zu einem engen Job reichen meist fünf bis acht Gespräche, um Sprache und plausible Ursachen zu finden. Um zu schätzen, wie verbreitet ein Problem ist, reichen sie nie; dafür braucht es eine quantitative Studie.
Stell Fragen, die auf Geschichten zielen („Erzähl mir von dem letzten Mal, als …“), nicht „Würdest du … nutzen?“. Unser Template für Kundeninterviews enthält ein kopierbares Skript. Lass die KI transkribieren, taggen und jede Notiz mit ihrer Quelle verknüpfen; lass sie keine Lücken füllen.
Tage 5–6: Die Annahme mit dem höchsten Entscheidungsrisiko wählen
Teste nicht jede Unbekannte. Bewerte jede Annahme bei zwei Fragen von 1 bis 5 und multipliziere:
Impact: Wenn das falsch ist, wie viel Nacharbeit oder Schaden für Nutzer:innen folgt daraus?
Unsicherheit: Wie wenige direkte Belege haben wir?
Teste zuerst das höchste Produkt. Bei einem KI-Feature lautet die riskante Annahme oft nicht „Wollen sie es?“, sondern „Kommt das System mit der echten Vielfalt an Eingaben klar?“ oder „Können Leute einen Fehler erkennen, bevor er zählt?“.
Stell der KI-Version immer eine einfachere Baseline zur Seite. Ein Modell verdient seinen Platz, wenn die Eingabe variabel oder unstrukturiert ist und die Nutzer:innen etwas gewinnen, das eine Regel, ein Suchfeld oder eine Vorlage nicht liefern kann.
Tage 7–8: Nur bauen, was der Test braucht
Ein Prototyp ist ein Lerninstrument, kein Beleg an sich. Baue gerade so viel, dass du die riskante Annahme der richtigen Person vorlegen kannst:
Ein klickbarer Mock für eine Workflow-Frage
Eine Concierge-Variante, bei der ein Mensch das Ergebnis von Hand erstellt
Ein schmaler Prototyp, der auf einer kleinen, repräsentativen Menge echter Eingaben läuft
Eine dünne Implementierung hinter einem begrenzten Rollout
Eine Baseline ohne KI zum Vergleich
Schreib auf, was du beobachten wirst, bevor du baust. Wenn die Frage lautet, ob Nutzer:innen eine KI-Zusammenfassung prüfen und korrigieren können, muss der Test das Korrigieren enthalten. Wenn ein KI-Coding-Agent den Test baut, gib ihm ein klar begrenztes Briefing: Nutzer:in, Aufgabe, Belege, Umfang, erwartetes Verhalten, Fehlerfälle und wie du das Ergebnis prüfst. Das PRD-Template für KI-Coding-Agenten ist ein Ausgangspunkt.
Bei Usability-Fragen sind fünf Teilnehmende ein solider Standard. Jakob Nielsens Modell zeigt, dass fünf Nutzer:innen etwa 85 % der Usability-Probleme finden, und er empfiehlt drei Runden à fünf, mit Korrekturen dazwischen, statt einer Runde mit 15 (Nielsen Norman Group, 2000).
Tage 9–10: Eine echte Aufgabe beobachten und entscheiden
Bitte Leute aus der Zielgruppe, eine realistische Aufgabe zu erledigen. Schau zu, bevor du fragst, was sie denken. Notiere, wo sie zögern, das Ergebnis korrigieren, auf einen Workaround ausweichen oder abbrechen.
Wähle ein oder zwei Erfolgssignale, die zur Aufgabe passen: Abschluss, Zeit bis zur Fertigstellung, Korrekturrate, erfolgreiche Übergabe oder ob sie wiederkommen. Protokolliere bei KI-Features außerdem die wichtigen Fehlerfälle, die Latenz und die Kosten pro Durchlauf, soweit sie die Erfahrung prägen. Ein besserer Offline-Evaluationswert ist kein Beweis dafür, dass sich die Nutzererfahrung verbessert hat.
Entscheidung
Wann du sie wählst
Weitermachen
Das Problem ist belegt und der Test hat sein vorab formuliertes Erfolgssignal erreicht
Ändern
Das Problem wirkt real, aber Workflow, Zielgruppe oder Verhalten passten nicht
Pausieren
Eine riskante Unbekannte braucht noch Belege oder eine Prüfung
Stoppen
Die Belege schwächen das Problem, oder die Lösung bringt gegenüber einer einfacheren Option wenig
Das ist kein statistischer Nachweis für Product-Market-Fit. Es macht aber die nächste Entscheidung nachvollziehbar, statt sie davon abhängig zu machen, wer den selbstbewusstesten Prompt geschrieben hat.
Wie sieht der Zyklus in der Praxis aus?
Das Folgende ist ein illustratives Beispiel, kein echtes Unternehmen.
Sagen wir, ein B2B-Team aus vier Leuten glaubt, dass Support-Leads jede Woche Stunden damit verlieren, aus Tickets einen Bug-Report für das Engineering zu machen, und will einen KI-Summarizer bauen.
Tage 1–2. Entscheidung: Sollen wir Support-Leads bei SaaS-Unternehmen mit 20–100 Leuten helfen, ihren wöchentlichen Bug-Report zu erstellen, indem wir ihn aus Tickets entwerfen?
Tage 3–4. Sechs Interviews. Fünf von sechs erstellen so einen Report; vier brauchen dafür jede Woche 60–90 Minuten; zwei kopieren Tickets bereits in einen Chatbot und korrigieren das Ergebnis von Hand.
Tage 5–6. „Sie schreiben den Report wöchentlich“ bekommt Impact 5 × Unsicherheit 1 = 5. „Sie vertrauen einem KI-Entwurf genug, um ihn nach kurzer Prüfung zu versenden“ bekommt 5 × 4 = 20. Die zweite Annahme wird getestet. Erfolgssignal, vor dem Test festgelegt: mindestens 3 von 5 Leads verschicken den Entwurf nach höchstens 15 Minuten Bearbeitung.
Tage 7–8. Ein Concierge-Test: Der Gründer entwirft jeden Report mit einem Sprachmodell aus den echten exportierten Tickets der Leads, ergänzt um eine einfache Ticketzähl-Tabelle als Baseline ohne KI.
Tage 9–10. Vier von fünf verschickten den Entwurf; die mittlere Bearbeitungszeit lag bei 12 Minuten. Aber drei von fünf bevorzugten für den Zähl-Abschnitt die einfache Tabelle und vertrauten der KI nur beim Fließtext.
Das Erfolgssignal wurde erreicht, doch die Entscheidung lautet Ändern, nicht Weitermachen: Die Zahlen als deterministische Tabelle bauen und KI nur für den Zusammenfassungsabsatz nutzen. Das ist eine kleinere, günstigere und vertrauenswürdigere erste Version als die, mit der das Team gestartet ist.
Ein wiederverwendbarer KI-Prompt für belegbasierte Discovery
Nutze KI, um Material zu ordnen, das du ihr gibst – nicht, um Marktbelege zu erfinden. Halte die Quellnotizen bereit, damit ein Mensch jede Aussage prüfen kann.
Du hilfst einem kleinen Produktteam, eine Discovery-Entscheidung vorzubereiten. Nutze ausschließlich die Belege, die ich dir gebe.
Trenne direkte Beobachtungen, Aussagen von Nutzer:innen, Interpretationen des Teams und offene Fragen. Verknüpfe jede Beobachtung mit ihrem Quellenlabel. Markiere Widersprüche und fehlenden Kontext. Erfinde keine Zitate, Nutzer:innen, Marktgrößen, Häufigkeiten oder Prozentwerte.
Bestimme anhand dieser Belege die eine Annahme, die die Entscheidung am stärksten verändern könnte. Schlage den kleinsten Test vor, der diese Unsicherheit verringern kann. Nimm Zielnutzer:in, Aufgabe, erwartetes Verhalten, wahrscheinliche Fehlerfälle, ein oder zwei beobachtbare Erfolgssignale und das Ergebnis auf, das die Entscheidung ändern würde. Vergleiche den KI-Ansatz mit einer einfacheren Baseline. Kennzeichne alle Empfehlungen als Hypothesen, bis sie getestet sind.
Prüfe die Ausgabe gegen die ursprünglichen Notizen. Wenn das Modell für eine Aussage keine Quelle nennen kann, streich die Aussage oder hol dir den Beleg.
Wie bewertest du ein Tool für KI-gestützte Product Discovery?
Bevor du den Empfehlungen eines Tools vertraust, lass es an einer vergangenen Entscheidung laufen, deren Ausgang du schon kennst, und prüfe dann sieben Dinge:
Quellenangaben. Verweist jedes Thema und jede Aussage auf ein Zitat, ein Ticket oder einen Call, das bzw. den du öffnen kannst?
Beobachtung vs. Interpretation. Hält es auseinander, was Leute gesagt haben und was das Modell daraus geschlossen hat?
Zahlen statt Adjektive. Sagt es dir, wie viele Quellen ein Thema stützen („6 von 14 Calls“), statt es ein „starkes Signal“ zu nennen?
Menschliche Prüfung. Kann ein Mensch die Ausgabe korrigieren oder ablehnen, bevor sie in eine Spec oder ein Ticket gelangt?
Einwilligung und Datenhandling. Wo werden Daten gespeichert, und werden Interviewteilnehmende um ihre Einwilligung gebeten und informiert, wenn sie mit einer KI sprechen?
Ehrliche Grenzen. Sagt es, wenn die Belege dünn sind, oder klingt jede Idee am Ende gut? Gefälligkeit ist genau der Fehler, den die Nielsen Norman Group bei simulierten Nutzer:innen festgestellt hat (2024).
Passung zum Gratis-Tarif. Kannst du einen kompletten Zyklus im kostenlosen Tarif oder in der Testphase durchlaufen, bevor du zahlst? Falls nicht, teste es trotzdem an der oben beschriebenen Entscheidung, mit einem Zeitlimit.
Ein Tool, das schon die ersten drei Punkte nicht besteht, macht dich nur schneller darin, falsch zu liegen.
Welche Fehler machen Teams, wenn sie mit KI schneller werden wollen?
Einen generierten Prototyp als Validierung behandeln. Er beweist, dass sich etwas bauen lässt, nicht, dass die Zielnutzer:in es braucht.
Synthetische Nutzer:innen als Kundenbeleg verwenden. KI kann helfen, einen Interviewleitfaden zu proben oder Randfälle zu finden. Simulierte Antworten ersetzen weder Gespräche noch beobachtetes Verhalten.
Fragen, ob jemandem die Idee gefällt. Frag nach einer kürzlich erledigten Aufgabe und beobachte, wie die Person einen realistischen Workflow durchspielt.
Output statt den Job messen. Ausgeführte Prompts, gemergter Code und ausgelieferte Features sind Delivery-Signale, kein Beweis dafür, dass Kund:innen eine Aufgabe erfolgreicher erledigt haben.
Eine Metrik einen Zielkonflikt verdecken lassen. Ein KI-Ergebnis kann in der Evaluation gut abschneiden und sich trotzdem langsam, verwirrend oder schwer korrigierbar anfühlen. Kombiniere technische Prüfungen mit einer Nutzeraufgabe.
Belege in getrennten Tools verstreuen. Halte Quelle, Entscheidung, Test und Ergebnis zusammen, damit du später siehst, was deine Meinung geändert hat.
Wann dieser Zyklus das falsche Werkzeug ist: Wenn du wissen willst, wie viele Leute ein Problem haben, mach eine Umfrage oder werte Nutzungsdaten aus. Ist das Produkt sicherheitskritisch oder reguliert, sind zwei Wochen für die Prüfung zu kurz. Und wenn du zwischen zwei guten Ideen entscheidest, die beide die Discovery bestanden haben, brauchst du Priorisierung, nicht mehr Interviews. Für ein kürzeres Format mit nur einer Frage siehe den KI-Discovery-Sprint; damit die Belege nach dem Zyklus frisch bleiben, mach daraus eine wöchentliche Continuous-Discovery-Routine.
Wo Specky ins Spiel kommt
Specky ist ein KI-natives Produktsystem, das um genau diesen Zyklus herum gebaut ist. Es liest Kundengespräche, Feedback, Slack, Jira und Analytics in einen Product Graph ein, sodass die Belege aus den Tagen 3–4 mit ihrer Quelle verknüpft bleiben. Alex, Speckys Research-Agent, führt Kundeninterviews über einen teilbaren Link, damit der Beleg-Schritt nicht auf Kalender warten muss. Sobald du zu einer Entscheidung kommst, entwirft der PRD Editor die Spec mit Inline-Zitaten, die auf diese Belege zurückverweisen, und das Decision Log hält fest, warum du weitergemacht, geändert, pausiert oder gestoppt hast. Den größeren Prozess vom Problem bis zum Release findest du im Leitfaden zum Product-Discovery-Prozess.
Häufig gestellte Fragen
Was ist KI-Product-Discovery?
KI-Product-Discovery heißt, Kunden- und Produktbelege zu nutzen, um zu entscheiden, welches Problem gelöst werden soll, ob KI ein nützlicher Teil der Lösung ist und welcher kleine Test vor einem größeren Build laufen sollte. KI-Tools helfen bei Synthese, Interviews und Prototypen, aber das Team bleibt dafür verantwortlich, Quellen zu prüfen und die Entscheidung zu treffen. Ohne echte Kundenbelege ist es nur schnelleres Raten.
Kann KI eine Startup-Idee validieren?
Nein. KI kann Belege ordnen, Testvarianten erzeugen und schnell einen Prototyp bauen, aber sie kann nicht zeigen, dass echte Kund:innen das Problem haben oder die Lösung übernehmen werden. Die Nielsen Norman Group fand simulierte Nutzer:innen im Vergleich zu echten übermäßig positiv und oberflächlich. Nutze Gespräche, beobachtete Aufgaben und Produktverhalten als Belege, und behandle KI-generierte Analysen als Hypothese, bis ein Mensch sie gegen die Quellen geprüft hat.
Wie lange sollte Product Discovery für ein Startup dauern?
Für eine enge Entscheidung etwa zwei Wochen: zwei Tage zum Formulieren, zwei zum Sammeln von Belegen, zwei zur Wahl der riskantesten Annahme, zwei zum Bauen eines Tests und zwei zum Beobachten und Entscheiden. Solo-Gründer:innen können das auf wenige Tage straffen. Breite strategische Fragen, regulierte Produkte und alles, was Verbreitungsdaten braucht, dauern länger, und die Discovery sollte nach dem Zyklus wöchentlich weiterlaufen.
Was sind die besten Tools für KI-Product-Discovery?
Das beste Tool hängt vom Schritt ab. Transkriptions- und Synthese-Tools helfen am meisten in der Beleg-Phase, KI-Interviewer eignen sich für kurze strukturierte Fragen, Coding-Agenten bauen Test-Prototypen, und Analytics-Tools zeigen echtes Verhalten. Was du auch wählst: Prüfe, ob jede Aussage auf eine Quelle verweist, ob es Zahlen statt Adjektive liefert und ob ein Mensch die Ausgabe korrigieren kann, bevor sie eine Entscheidung prägt.
Wie unterscheidet sich Product Discovery von Product Development?
Product Discovery verringert die Unsicherheit über Nutzer:in, Problem und Lösung. Product Development baut und betreibt das Produkt. Beides überschneidet sich: Ein Prototyp kann Teil eines Discovery-Tests sein, und die Nutzung nach dem Release sollte in die nächste Lernrunde einfließen. Die hilfreiche Frage ist, ob das Team gerade eine Annahme testet oder eine bereits validierte Änderung ausliefert.
GDPR-aligned. EU workspace data is stored in Frankfurt, Germany. GDPR and EU data Built in Vienna, Austria. A product of influence solutions fm GmbH (FN 675374y). Imprint 14-day trial. Card required, and nothing is charged until day 14. 30-day refund after subscribing. See pricing