10. Oktober 2026Aktualisiert am Fathy Shalaby15 Min. Lesezeit
Abnahme-Checkliste für KI-generierten Code: Der Review-Leitfaden für PMs
Bauen ist billig geworden, das Abnehmen nicht. Die vierstufige Acceptance Ladder hilft PMs, von Agenten gebaute Änderungen an Entscheidung, Brief, Randfällen und Ergebnis zu prüfen.
Teilen
Dieser Artikel wurde aus dem Englischen übersetzt. Original lesen
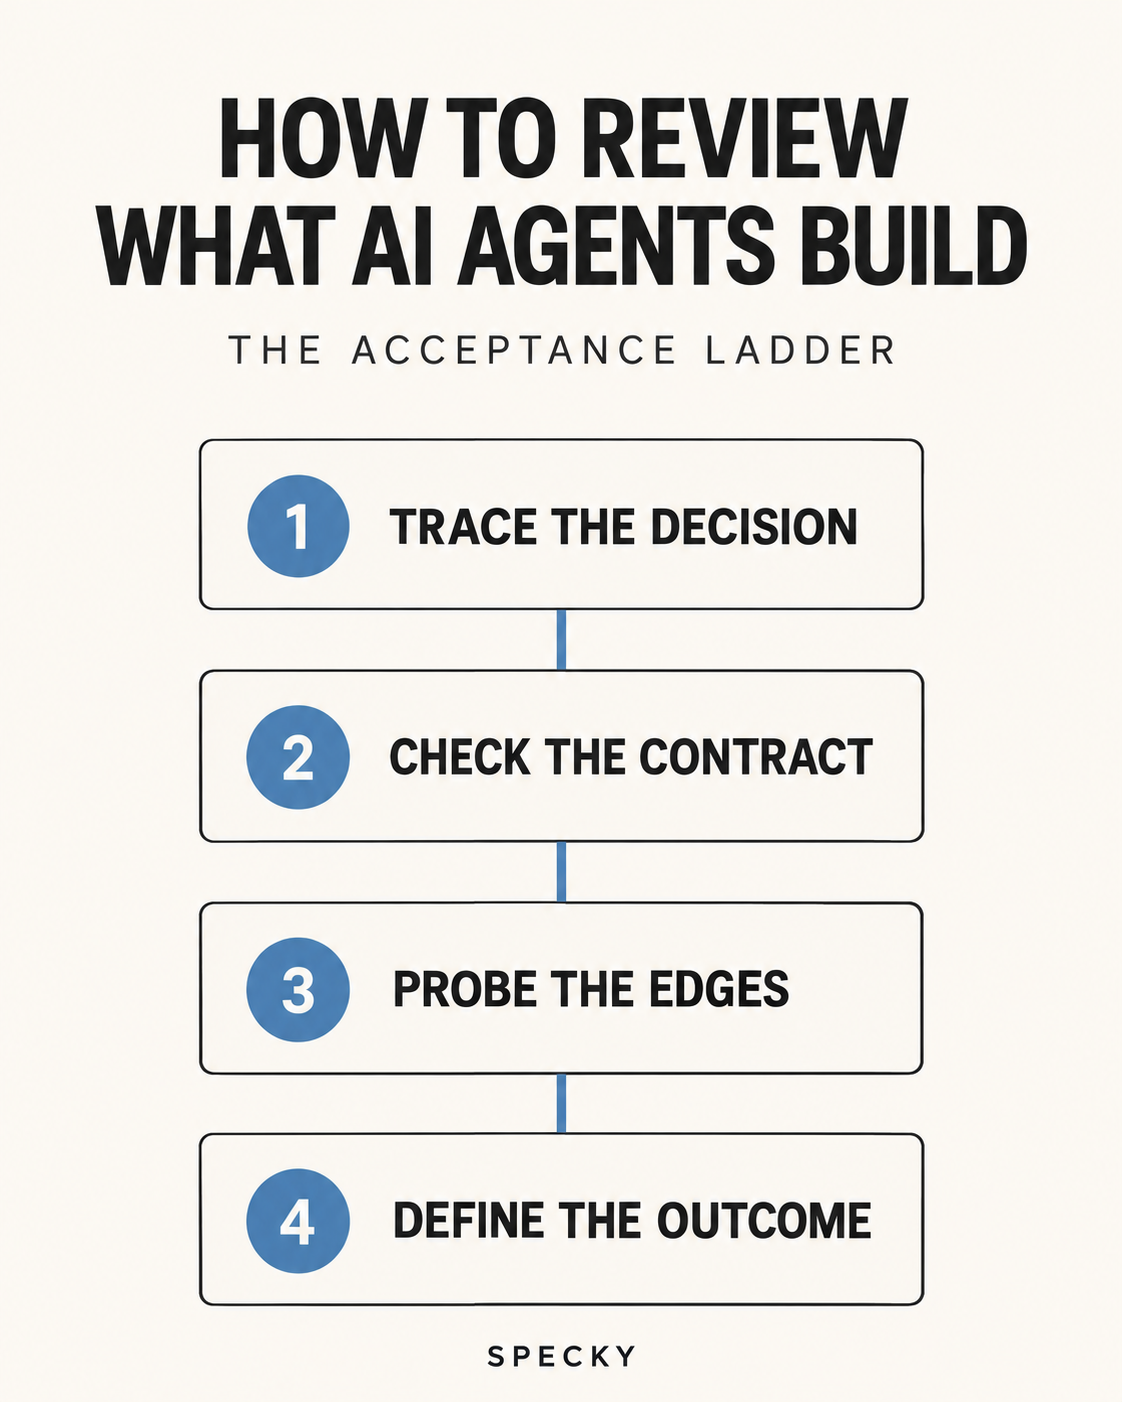
Eine Abnahme-Checkliste für KI-generierten Code ist die kurze Liste von Prüfungen, die ein Product Manager durchgeht, bevor eine von einem Agenten gebaute Änderung als fertig gilt. Entwickler:innen prüfen, wie der Code geschrieben ist; der PM prüft, ob es die richtige Änderung ist. Wir nutzen vier Stufen, in dieser Reihenfolge: auf eine Entscheidung zurückführen, mit dem Brief vergleichen, Randfälle testen und festlegen, woran du erkennst, dass es funktioniert hat.
Das Wichtigste in Kürze
Anthropic beschreibt die Softwareentwicklung als Wandel „vom Schreiben von Code hin zum Orchestrieren von Agenten, die Code schreiben“ (Anthropic, 2026). Die knappe Fähigkeit wandert auf den Review-Platz.
66 % der Entwickler:innen nennen als größten Frust mit KI-Tools Lösungen, die fast richtig sind, aber eben nicht ganz (Stack Overflow, 2025). Fast richtige Änderungen bestehen einen „sieht gut aus“-Review.
Flüssige Ausgaben verzerren das Urteil: In einer randomisierten Studie glaubten Entwickler:innen, KI habe sie 20 % schneller gemacht, obwohl sie 19 % langsamer geworden waren (METR, 2025).
Agenten neigen dazu, zu viel zu bauen. Der Überschuss-Durchgang (Verhalten auflisten, nach dem niemand gefragt hat) ist die Prüfung, die die meisten Teams auslassen.
Die Checkliste ersetzt weder Code- noch Security-Review: In einem Test von 2025 führten 45 % der KI-generierten Codebeispiele bekannte Schwachstellen ein (Veracode, 2025).
Warum ist „sieht gut aus“ die falsche Messlatte für KI-generierten Code?
Die meisten Teams prüfen Agenten-Output so, wie sie früher einen Pull Request von Menschen geprüft haben: den Diff überfliegen, in der Vorschau herumklicken, freigeben. Das funktioniert, wenn eine Kollegin den Kontext aus dem Planungsmeeting und den Kundengesprächen im Kopf hat. Es scheitert, wenn ein Agent nur das mitbringt, was im Brief steht.
Ist der Brief vage, füllt der Agent die Lücke mit dem statistisch plausibelsten Verhalten, und plausibel ist nicht dasselbe wie richtig. Die Änderung kompiliert, die Vorschau rendert, der Happy Path funktioniert, und der PM gibt frei. Zwei Wochen später fällt jemandem auf, dass sie stillschweigend eine Bedingung fallen ließ, die niemand aufgeschrieben hatte, oder ein benachbartes Problem löste statt des im Brief genannten. Am Code war nichts falsch. Der Abnahmeschritt hat nur nie die richtigen Fragen gestellt.
Drei Dinge machen Agenten-Output schwerer beurteilbar als menschlichen:
Menge. Billige Generierung bedeutet mehr Änderungskandidaten pro Woche, und die Review-Zeit wird zum Engpass.
Selbstsicherheit. Agenten beschreiben ihre eigene Arbeit eloquent. Eine saubere Zusammenfassung ist kein Beleg. METRs Studie von 2025 mit 16 erfahrenen Entwickler:innen und 246 echten Issues ergab, dass die Entwickler:innen erwarteten, durch KI 24 % schneller zu sein, und nach der Arbeit immer noch glaubten, 20 % schneller gewesen zu sein, während das gemessene Ergebnis 19 % langsamer war (METR, 2025). METR sagt inzwischen, dass diese Ergebnisse von Anfang 2025 veraltet sind, und seine Folgestudie vom Februar 2026 fand geringe geschätzte Beschleunigungen, die es als unzuverlässiges Signal bezeichnet (METR, 2026). Die bleibende Lehre ist die Wahrnehmungslücke, nicht die Geschwindigkeitszahl.
Fehlende Absichtsspur. Ohne Verbindung von der Änderung zurück zur Entscheidung, die sie umsetzt, kannst du „wie spezifiziert gebaut“ nicht von „wie vermutet gebaut“ unterscheiden.
Die Delivery-Daten weisen in dieselbe Richtung. Googles DORA-Forschung 2024 fand, dass ein um 25 % höherer KI-Einsatz mit 7,5 % besserer Dokumentationsqualität, 3,4 % besserer Codequalität und 3,1 % schnellerem Code-Review einherging. Zugleich schätzten die Forschenden, dass mit steigender Nutzung der Delivery-Durchsatz um 1,5 % und die Delivery-Stabilität um 7,2 % sanken (DORA, 2024). Der Bericht 2025 fasst es zusammen: KI verstärkt die vorhandenen Stärken und Schwächen einer Organisation (DORA, 2025). Ein schwacher Abnahmeschritt ist eine der Schwächen, die sie verstärkt.
Was sollte ein PM prüfen und was ein:e Engineer?
Teile den Review auf. Googles Engineering Practices listen auf, worauf ein Code-Reviewer achtet: Design, Funktionalität, Komplexität, Tests, Benennung, Kommentare, Stil, Konsistenz, Dokumentation und Kontext (Google). Das meiste davon ist Engineering-Arbeit. Eine Frage auf der Liste gehört zum Produkt: „Is what the developer intended good for the users of this code?“
Frage
Wer ist zuständig
Wo wird sie beantwortet
Ist der Code gut gestaltet, lesbar und getestet?
Engineer
Code-Review
Ist er sicher und behandelt er Berechtigungen korrekt?
Engineer (mit Security-Tooling)
Code-Review, Scanner
Welche Entscheidung oder welchen Beleg setzt diese Änderung um?
PM
Acceptance Ladder, Stufe 1
Wurde gebaut, was der Brief sagt, und nur das?
PM
Stufe 2
Verhält es sich bei leeren, Fehler-, Grenz-, Berechtigungs- und Wiederholungsfällen vertretbar?
PM und Engineer gemeinsam
Stufe 3
Wie und wann erfahren wir, dass es für Nutzer:innen funktioniert hat?
PM
Stufe 4
In einem Solo-Founder-Team trägt eine Person beide Hüte. Mach die beiden Reviews trotzdem in getrennten Durchgängen: Code auf Korrektheit zu lesen und Verhalten auf Absicht zu lesen, beansprucht unterschiedliche Aufmerksamkeit.
Die Acceptance Ladder: vier Prüfungen, bevor eine Agenten-Änderung fertig ist
Jede Stufe stellt eine Frage. Du steigst nur auf die nächste Stufe, wenn die aktuelle bestanden ist. Bleibt eine Änderung auf Stufe eins hängen, verbringst du keine Zeit mit Stufe vier.
Stufe 1: Nachvollziehbarkeit. Welche Entscheidung wird hier umgesetzt?
Beantworte, bevor du irgendeinen Code liest, eine Frage: Auf welche Entscheidung oder welchen Beleg geht diese Änderung zurück?
Eine Änderung sollte auf einen konkreten Eintrag verweisen: einen Decision-Record, eine Customer Insight, eine Opportunity, ein Experiment. Wenn du ihn nicht in einem Satz nennen kannst, halte an. Entweder war die Arbeit nie begründet, oder die Begründung steckt in jemandes Kopf und der Agent hat sie nie gesehen.
In Specky ist dafür der Product Graph da. Entscheidungen, Insights und Tickets sind verknüpfte Knoten, sodass ein Agentenlauf den umgebenden Kontext ziehen kann, bevor er irgendetwas plant. Die erste Prüfung des Reviewers ist schlicht, ob diese Verknüpfung existiert und ob der zitierte Beleg das aussagt, was die Änderung behauptet.
Stammt der Brief selbst aus einem KI-Entwurf, prüfe zuerst dessen Belege, bevor du den Code dagegen prüfst. Unser Claim Trace für KI-geschriebene Specs dauert etwa 15 Minuten.
Bestehensbedingung: eine Entscheidung oder Insight, benannt, mit Belegen, die in zwei Klicks erreichbar sind.
Stufe 2: Vertrag. Wurde gebaut, was der Brief sagt, und nur das?
Vergleiche die Änderung jetzt Zeile für Zeile mit dem schriftlichen Brief. Nicht „fühlt sich richtig an“, sondern ein wörtlicher Diff zwischen Akzeptanzkriterien und beobachtetem Verhalten.
Mach zwei Durchgänge:
Abdeckungs-Durchgang. Finde für jedes Akzeptanzkriterium im Brief das Verhalten, das es erfüllt. Markiere jedes als erfüllt, teilweise erfüllt oder fehlend.
Überschuss-Durchgang. Liste Verhalten auf, das die Änderung einführt und nach dem kein Kriterium gefragt hat. Agenten fügen oft hilfreiche Extras hinzu: eine neue Einstellung, eine zusätzliche Spalte, einen Fallback-Pfad. Jedes davon ist ungeprüfter Scope. Behalte es oder streiche es bewusst.
Den Überschuss-Durchgang lassen Teams aus, und genau hier unterscheidet sich Agentenarbeit am stärksten von menschlicher. Nach unserer Erfahrung baut ein Mensch gegenüber einem Brief eher zu wenig, ein Agent eher zu viel.
Bestehensbedingung: jedes Kriterium als erfüllt markiert, jedes Überschuss-Element ausdrücklich behalten oder entfernt.
Stufe 3: Randfälle. Was passiert, wenn die Eingabe falsch, leer oder feindlich ist?
Agenten sind auf dem Happy Path stark, weil Prompts den beschreiben. Stufe drei geht dorthin, wo Prompts selten hinkommen. Schreib fünf Situationen auf und probiere jede aus:
Leerer Zustand: noch keine Daten.
Fehlerzustand: der Upstream-Aufruf schlägt fehl.
Grenzfall: die größte und die kleinste realistische Eingabe.
Berechtigung: jemand, der das nicht sehen sollte, versucht es.
Wiederholung: die Aktion läuft zweimal hintereinander.
Du brauchst kein vollständiges QA. Du brauchst die fünf Situationen, auf die ein echter Kunde in der ersten Woche stößt. Wenn der Brief dafür kein Verhalten festlegte, ist das ein Mangel im Brief, und die Korrektur gehört in den Brief, nicht nur in den Code.
Die Berechtigungsprüfung ist bei KI-generiertem Code wichtiger. Veracode testete 2025 mehr als 100 Sprachmodelle und stellte fest, dass 45 % der generierten Codebeispiele Sicherheitstests nicht bestanden, bei Java mit einer Durchfallquote von 72 %, und dass 86 % der relevanten Beispiele sich nicht gegen Cross-Site-Scripting wehrten (Veracode, 2025). Ein PM kann das nicht auditieren, aber darauf bestehen, dass „ein Nutzer ohne Zugriff versucht, das zu sehen“ ein schriftliches, getestetes Kriterium ist und dass Security-Tooling bei jeder Agenten-Änderung läuft.
Bestehensbedingung: Alle fünf Situationen verhalten sich so, dass du sie vor einem Kunden vertreten würdest.
Stufe 4: Nachweis des Ergebnisses. Woran erkennen wir, dass es funktioniert hat?
Eine Änderung kann die ersten drei Stufen bestehen und trotzdem nutzlos sein. Die letzte Stufe fragt, was du messen wirst und wann du nachsiehst.
Schreib die Prüfung vor dem Release auf: die Metrik oder das Signal, die erwartete Richtung und ein Datum. „Wir schauen mal, wie es läuft“ ist keine Prüfung. Hier wird auch der Hype herausgefiltert: Ein Feature, das schnell live geht, aber keine Ergebnisprüfung hat, ist eine Vermutung mit Deploy-Datum.
Bestehensbedingung: ein benanntes Signal, eine erwartete Richtung und ein Kalenderdatum zum Ablesen.
Kopierbare Abnahme-Checkliste für KI-generierten Code
Füge das in die Pull-Request-Vorlage oder das Ticket ein. Ein Block pro von einem Agenten gebauter Änderung.
ABNAHME-CHECKLISTE: [Änderung / PR-Link]
Reviewer: [Name]   Datum: [Datum]

STUFE 1 NACHVOLLZIEHBARKEIT
[ ] Entscheidung oder Insight, die hier umgesetzt wird: [Link]
[ ] Beleg dahinter ist in zwei Klicks erreichbar und sagt, was der Brief behauptet

STUFE 2 VERTRAG
Abdeckung (eine Zeile pro Akzeptanzkriterium):
  [Kriterium 1]  erfüllt / teilweise / fehlt
  [Kriterium 2]  erfüllt / teilweise / fehlt
Überschuss (Verhalten, nach dem kein Kriterium gefragt hat):
  [Element]  behalten (Kriterium ergänzt) / streichen (separat angelegt)

STUFE 3 RANDFÄLLE
[ ] Leerer Zustand   [ ] Fehlerzustand   [ ] Grenzeingabe
[ ] Berechtigung     [ ] Wiederholte Aktion
Mängel im Brief (in den Brief eintragen, nicht nur in den Code): [Liste]

STUFE 4 ERGEBNIS
Signal: [Metrik]   Erwartete Richtung: [hoch/runter]   Ablesen am: [Datum]

ENGINEERING (nicht Sache des PM, aber bestätige, dass es passiert ist)
[ ] Code-Review erledigt   [ ] Tests ergänzt/aktualisiert   [ ] Security-Checks gelaufen

ERGEBNIS: abnehmen / mit Brief-Änderungen zurückgeben
Wie sieht die Checkliste bei einer echten Änderung aus?
Angenommen, dein Team hat einen Agenten gebeten, einer Feedback-Inbox die Aktion „Mehrfach archivieren“ hinzuzufügen.
Stufe 1. Der Brief verlinkt eine Insight: Der Support verbringt Zeit damit, veraltete Einträge aufzuräumen, und drei Kundengespräche erwähnen es. Der Beleg ist erreichbar. Bestanden.
Stufe 2. Der Abdeckungs-Durchgang findet alle vier Kriterien erfüllt. Der Überschuss-Durchgang findet, dass der Agent außerdem einen „Rückgängig“-Toast und einen neuen Filter-Tab „Archiviert“ ergänzt hat. Das Rückgängig lohnt sich und bekommt nachträglich ein Kriterium. Der Filter-Tab ändert die Navigation und war nicht gewünscht, also wird er gestrichen und als separate Opportunity angelegt. Nach einer Änderung bestanden.
Stufe 3. Der leere Zustand zeigt ein leeres Panel ohne Erklärung. Durchgefallen. Die Korrektur kommt als fehlendes Kriterium in den Brief und geht dann zurück an den Agenten.
Stufe 4. Das Signal ist die mediane Zeit bis zum Leeren der Inbox, erwartet sinkend, abzulesen in zwei Wochen.
Der Review brachte einen Durchfall und zwei Änderungen, vor dem Release entdeckt. Ein „sieht gut aus“-Review hätte das leere Panel und den ungewünschten Navigations-Tab zusammen ausgeliefert.
In die Checkliste eingetragen lautet die Ergebniszeile: 4 von 4 Kriterien erfüllt, 2 Überschuss-Elemente (1 behalten, 1 gestrichen), 1 von 5 Randfällen durchgefallen, Ergebnis-Ablesung für Tag 14 geplant. Mit einer Brief-Änderung zurückgeben.
Wie schreibst du Akzeptanzkriterien, die ein Agent nicht missverstehen kann?
Die Ladder ist nur so gut wie die Kriterien in Stufe zwei. Atlassian definiert Akzeptanzkriterien als die Bedingungen, die eine Arbeit erfüllen muss, um abgeschlossen zu sein, und nennt die Eigenschaften guter Kriterien: klar, testbar, auf das Ergebnis statt auf die Methode ausgerichtet, wo möglich messbar und voneinander unabhängig (Atlassian). Für Agenten ist testbar am wichtigsten: Ein Kriterium, das ein Agent nicht prüfen kann, ist ein Kriterium, das er interpretieren wird.
Given-When-Then, von Daniel Terhorst-North und Chris Matts im Rahmen von Behaviour-Driven Development entwickelt, ist dafür eine gute Form (Fowler, 2013). Given ist der Zustand davor, When die Aktion, Then die erwartete Änderung.
Vage (der Agent rät)
Testbar (der Agent kann prüfen)
Archivieren funktioniert gut
Given 3 ausgewählte Einträge, when der Nutzer auf Archivieren klickt, then verschwinden alle 3 innerhalb von 1 Sekunde aus der Inbox-Liste
Leere Zustände behandeln
Given keine Einträge in der Inbox, when die Seite lädt, then zeige „Nichts zu prüfen“ und einen Link zu den Einstellungen
Nur Admins dürfen archivieren
Given ein Nutzer mit der Rolle Viewer, when er die Inbox öffnet, then wird der Archivieren-Button nicht angezeigt und die API gibt 403 zurück
Mach es schnell
Given 500 Einträge, when der Nutzer alle auswählt und archiviert, then ist die Aktion in unter 3 Sekunden abgeschlossen
Nichts kaputt machen
Given ein archivierter Eintrag, when der Nutzer seinen Direktlink öffnet, then öffnet er sich schreibgeschützt mit dem Label „Archiviert“
Die Ladder funktioniert am besten, wenn ein Teil davon nicht manuell läuft. Zwei praktische Schritte:
Validiere den Plan, bevor der Agent Code schreibt. Specky bietet das über seinen MCP-Server für Coding-Agenten: Ein Agent ruft validate_agent_plan gegen deine Engineering-Standards auf, bevor er anfängt, und validate_agent_change, bevor er Erfolg meldet. Das zieht Stufe zwei nach vorn, sodass der Plan gegen die Regeln geprüft wird, solange Änderungen noch billig sind.
Halte die Belege angehängt. Wenn die Entscheidung, der Brief, der Agentenlauf und die Ergebnisprüfung alle Knoten in einem Graphen sind, ist Stufe eins keine Suche mehr. Der Reviewer öffnet die Änderung, und der Grund steht schon daneben.
Die Ladder in einem kleinen Team nutzen
Du brauchst kein Review-Board. Für Solo-Founder oder ein Team aus drei bis zehn Personen ist die Ladder eine Fünf-Minuten-Gewohnheit pro Änderung, und die Reihenfolge zählt mehr als das Zeremoniell.
Beginne damit, Akzeptanzkriterien als kurze, prüfbare Sätze im Brief selbst zu schreiben, etwa „archivierte Einträge verschwinden aus der Inbox-Liste“ statt „Archivieren funktioniert gut“. Solche Sätze machen den Abdeckungs-Durchgang mechanisch statt zur Geschmacksfrage. Führe als Nächstes eine feste Liste deiner fünf Randsituationen, damit Stufe drei nicht jedes Mal neu erfunden wird. Mach schließlich die Ergebnisprüfung zum Teil der Definition of Done: Hat die Änderung kein Signal und kein Datum, ist sie nicht merge-bereit.
Wenn eine Änderung eine Stufe nicht besteht, widerstehe dem Drang, sie im Review-Thread zu flicken. Gib sie zurück und ergänze das fehlende Kriterium im Brief. Der Brief ist das dauerhafte Artefakt; der Thread verschwindet. Über einen Monat werden deine Briefs schärfer, und deine Durchfallquote auf den Stufen zwei und drei sinkt, das ist der eigentliche Gewinn.
Was du an deinem eigenen Review-Prozess messen solltest
Behandle die Ladder als einen Prozess, den du untersuchen kannst:
Verteilung der Stufen-Durchfälle. Landen die meisten Durchfälle auf Stufe zwei, sind deine Briefs das Problem. Landen sie auf Stufe drei, überspringen deine Prompts Randfälle.
Überschussquote. Wie oft fügt ein Agent ungefragten Scope hinzu? Eine steigende Quote bedeutet, dass deine Briefs zu viel Spielraum lassen.
Abschlussquote der Ergebnisprüfung. Wie viele ausgelieferte Änderungen bekamen ihre Stufe-vier-Auswertung zum festgelegten Datum? Diese Zahl zeigt, ob du lernst oder nur auslieferst.
Dafür brauchst du kein Dashboard. Eine Tabelle mit einer Zeile pro geprüfter Änderung reicht im ersten Monat.
Wann funktioniert diese Checkliste nicht?
Sie ist kein Code- oder Security-Review. Die Ladder prüft Absicht und Verhalten. Da in DORAs Umfrage 2024 39 % der Entwickler:innen angaben, KI-generiertem Code wenig oder gar nicht zu vertrauen, bleiben Engineering-Review und automatisierte Prüfungen Pflicht (DORA, 2024).
Sie ist bei Kleinigkeiten übertrieben. Eine Textkorrektur oder Farbänderung braucht höchstens Stufe zwei. Spar dir die volle Ladder für alles auf, was ein Kunde nutzt oder was Daten oder Berechtigungen berührt.
Sie kann eine schlechte Entscheidung nicht retten. Stufe eins prüft, dass eine Entscheidung existiert, nicht dass sie richtig war. Ist das zugrunde liegende Problem unklar, geh zurück zu einem Problem Statement, bevor du mehr Code prüfst.
Sie hängt davon ab, dass die Ergebnis-Ablesung wirklich stattfindet. Koppel Stufe vier bei KI-Features, deren Output selbst variiert, mit einem KI-Evaluations-Framework statt mit einer einzelnen Metrik.
Häufig gestellte Fragen
Was ist eine Abnahme-Checkliste für KI-generierten Code?
Sie ist eine kurze Liste von Produktprüfungen, die vor der Abnahme einer von einem Agenten gebauten Änderung laufen: welche Entscheidung sie umsetzt, ob sie zum Brief passt und nicht mehr, wie sie sich in fünf Randsituationen verhält und woran du erkennst, dass sie funktioniert hat. Sie steht neben dem Code-Review, nicht an dessen Stelle.
Sollten Product Manager Code prüfen, den KI-Agenten geschrieben haben?
PMs sollten Verhalten prüfen, nicht Code-Stil. Lies den Brief gegen das, was die Änderung tut, spiel die Randfälle in einer Vorschau durch und prüfe den Ergebnisplan. Überlass Design, Tests und Security den Engineers und dem Tooling. In einem Solo-Team machst du beides, aber in getrennten Durchgängen.
Wie lange dauert ein Abnahme-Review?
Bei einer typischen Änderung in Feature-Größe etwa fünf Minuten, sobald deine Briefs testbare Kriterien enthalten und du eine feste Liste von Randfällen führst. Die ersten Reviews dauern länger, weil sie fehlende Kriterien offenlegen. Diese Zeit wandert ins Schreiben besserer Briefs, statt zu verschwinden.
Was ist der Unterschied zwischen Akzeptanzkriterien und einer Definition of Done?
Akzeptanzkriterien gelten für eine einzelne Änderung: was dieses Feature leisten muss. Eine Definition of Done gilt für jede Änderung: Code geprüft, Tests bestanden, Security-Checks gelaufen, Ergebnisprüfung eingeplant. Atlassian merkt an, dass beide Begriffe manchmal austauschbar verwendet werden, aber wer sie trennt, macht Agenten-Reviews einfacher.
Warum fügen KI-Agenten Features hinzu, nach denen niemand gefragt hat?
Agenten füllen Lücken im Brief mit plausiblem Verhalten, und Extras wie Rückgängig-Buttons, Filter oder Einstellungen sind plausibel. Manche sind nützlich. Das Problem ist, dass jedes davon ungeprüfter Scope ist. Der Überschuss-Durchgang in Stufe zwei zwingt dich, jedes Extra bewusst zu behalten oder zu streichen und für alles, was du behältst, ein Kriterium zu ergänzen.
Kann ein KI-Agent seine Arbeit selbst an den Akzeptanzkriterien prüfen?
Teilweise. Agenten können Tests ausführen und Verhalten mit schriftlichen Kriterien vergleichen, und Tools, die einen Plan vor dem Coden validieren, fangen Fehler früh ab. Aber Agenten beschreiben ihre eigene Arbeit eloquent, und Eloquenz ist kein Beleg. Stufe eins (ist das die richtige Entscheidung?) und Stufe vier (hat es Nutzer:innen geholfen?) übernimmt weiterhin ein Mensch.
GDPR-aligned. EU workspace data is stored in Frankfurt, Germany. GDPR and EU data Built in Vienna, Austria. A product of influence solutions fm GmbH (FN 675374y). Imprint 14-day trial. Card required, and nothing is charged until day 14. 30-day refund after subscribing. See pricing