4 de noviembre de 2026Actualizado el Fathy Shalaby14 min de lectura
Cómo priorizar casos de uso de IA: una tabla de puntuación para equipos de producto
Compara ideas de producto con IA mediante una tabla de puntuación ponderada: evidencia de usuarios, impacto, ventaja de la IA, capacidad de evaluación, control de fallos y tiempo para aprender. Elige qué probar a continuación, no qué lanzar.
Para priorizar casos de uso de IA, compara problemas de usuarios en lugar de funcionalidades de IA y después elige cuál probar primero. Puntúa cada candidato según la solidez de la evidencia del problema, el resultado esperado para el usuario, la ventaja de la IA frente a una opción más simple, la capacidad de evaluación, el control de fallos y el tiempo necesario para aprender. Aplica tres condiciones de preparación antes de puntuar y trata el resultado como una forma de sacar a la luz los compromisos, no como una previsión.
Esta decisión es distinta de preguntarse si una funcionalidad concreta debería usar IA. El test de adecuación a la IA en cuatro preguntas ayuda a evaluar una sola funcionalidad. Esta tabla de puntuación ayuda a un fundador, a un primer product hire, a un PM o a un product engineer a decidir cuál de varios candidatos merece la atención limitada del equipo.
Ideas clave
La mayoría de las iniciativas de IA se atascan antes de dar resultados. La encuesta de BCG a 1.000 directivos de 59 países halló que el 74 % de las empresas aún no había demostrado un valor tangible de la IA y que solo el 26 % lograba ir más allá de las pruebas de concepto (BCG, 2024).
El estudio de MIT NANDA de 2025, basado en 150 entrevistas y 300 implantaciones públicas, concluyó que solo alrededor del 5 % de los pilotos de IA lograron una aceleración rápida de los ingresos (Fortune, 2025).
Rara vez el límite es el modelo. Las empresas líderes de BCG dedican el 10 % de sus recursos a los algoritmos, el 20 % a la tecnología y los datos, y el 70 % a las personas y los procesos.
La PAIR Guidebook de Google enumera casos en los que la IA probablemente no es mejor, entre ellos mantener la previsibilidad y minimizar los errores costosos (Google PAIR).
Da el mayor peso a la evidencia del problema y al resultado para el usuario. En la tabla de abajo suman el 55 % del total.
¿Por qué fracasan tantos casos de uso de IA?
Los equipos suelen elegir los proyectos de IA como eligen las demos: por lo que impresiona en un prototipo. Los datos sobre los fracasos apuntan a otra cosa.
La brecha está en el valor, no en la capacidad. BCG encontró que solo el 4 % de las empresas tenía las capacidades de IA más avanzadas en todas las funciones, y que las líderes dedicaban la mayor parte del esfuerzo a las personas y los procesos, no a los algoritmos (BCG, 2024).
Los flujos de trabajo deciden los resultados. El informe de MIT NANDA atribuyó el fracaso a una «brecha de aprendizaje» en las herramientas y las organizaciones, y no a la calidad de los modelos, y halló que las herramientas compradas a proveedores especializados tenían éxito alrededor del 67 % de las veces, mientras que los desarrollos internos lo tenían aproximadamente un tercio de las veces (Fortune, 2025). Lee qué midió realmente la cifra del 95 % antes de citarla.
Los usuarios comprueban el resultado. En la encuesta de Stack Overflow de 2025, el 46 % de los desarrolladores desconfiaba de la precisión de las herramientas de IA frente al 33 % que confiaba en ella, y el 66 % señaló las respuestas «casi correctas, pero no del todo» como su mayor frustración (Stack Overflow, 2025). Si tus usuarios no pueden verificar un resultado, o bien lo ignorarán o bien se fiarán de él cuando no deberían.
El patrón: elige un problema de usuario acotado y con evidencia, con una forma visible de comprobar la calidad, y los proyectos de IA se comportan como cualquier apuesta de producto. Si te saltas esos pasos, el prototipo se convierte en la estrategia.
Empieza por problemas candidatos, no por funcionalidades de IA
Una lista de ideas suele mezclar cosas distintas: problemas de usuarios, funcionalidades solicitadas, experimentos y posibilidades técnicas. Normaliza cada candidato antes de compararlo.
Para cada idea, anota:
Usuario y situación: ¿quién se encuentra con el problema y cuándo?
Job: ¿qué intenta conseguir?
Enfoque actual: ¿qué hace hoy, incluidos los parches y soluciones provisionales?
Evidencia: ¿qué se observó directamente y dónde puede consultarlo el equipo?
Resultado deseado: ¿qué sería mejor para el usuario?
Aportación de la IA: ¿qué parte de la tarea puede beneficiarse del lenguaje, la síntesis o la adaptación?
Coste del fallo: ¿qué podría salir mal y quién lo notaría?
Primera prueba: ¿cuál es el experimento más pequeño que puede responder una pregunta relevante?
«Añadir un asistente de roadmap con IA» no está listo para compararse. «Un primer product hire pasa el viernes combinando solicitudes de soporte y notas de entrevistas antes de decidir qué investigar» es un candidato más útil: nombra a un usuario, una tarea y una evidencia que el equipo puede buscar.
No tomes una petición de un stakeholder, un voto a favor o un prototipo convincente como prueba de que un problema es habitual. Mantén adjunta la fuente original y anota lo que no demuestra. El bucle de discovery de producto con IA muestra una forma de dos semanas de reunir y revisar esas señales.
¿Qué condiciones de preparación debe cumplir antes un caso de uso de IA?
Una puntuación alta no debería ocultar un motivo básico para esperar. Antes de ordenar las ideas, comprueba tres condiciones:
El problema del usuario es lo bastante concreto como para investigarlo. Puedes nombrar a un usuario, describir una situación reciente e identificar al menos una fuente o un paso claro de discovery.
Se puede observar un resultado útil. El equipo puede decir qué debería mejorar y qué salvaguarda no debe empeorar.
Un fallo costoso tiene un control visible. El equipo puede detectar, revisar, limitar o revertir el fallo en cuestión antes de ampliar la funcionalidad.
Si una idea no cumple una condición, señala la evidencia o el trabajo de diseño que falta. Puede quedarse en la lista, pero no debería ganar solo porque un prototipo sea fácil de construir.
¿Cómo se puntúan y se comparan los casos de uso de IA?
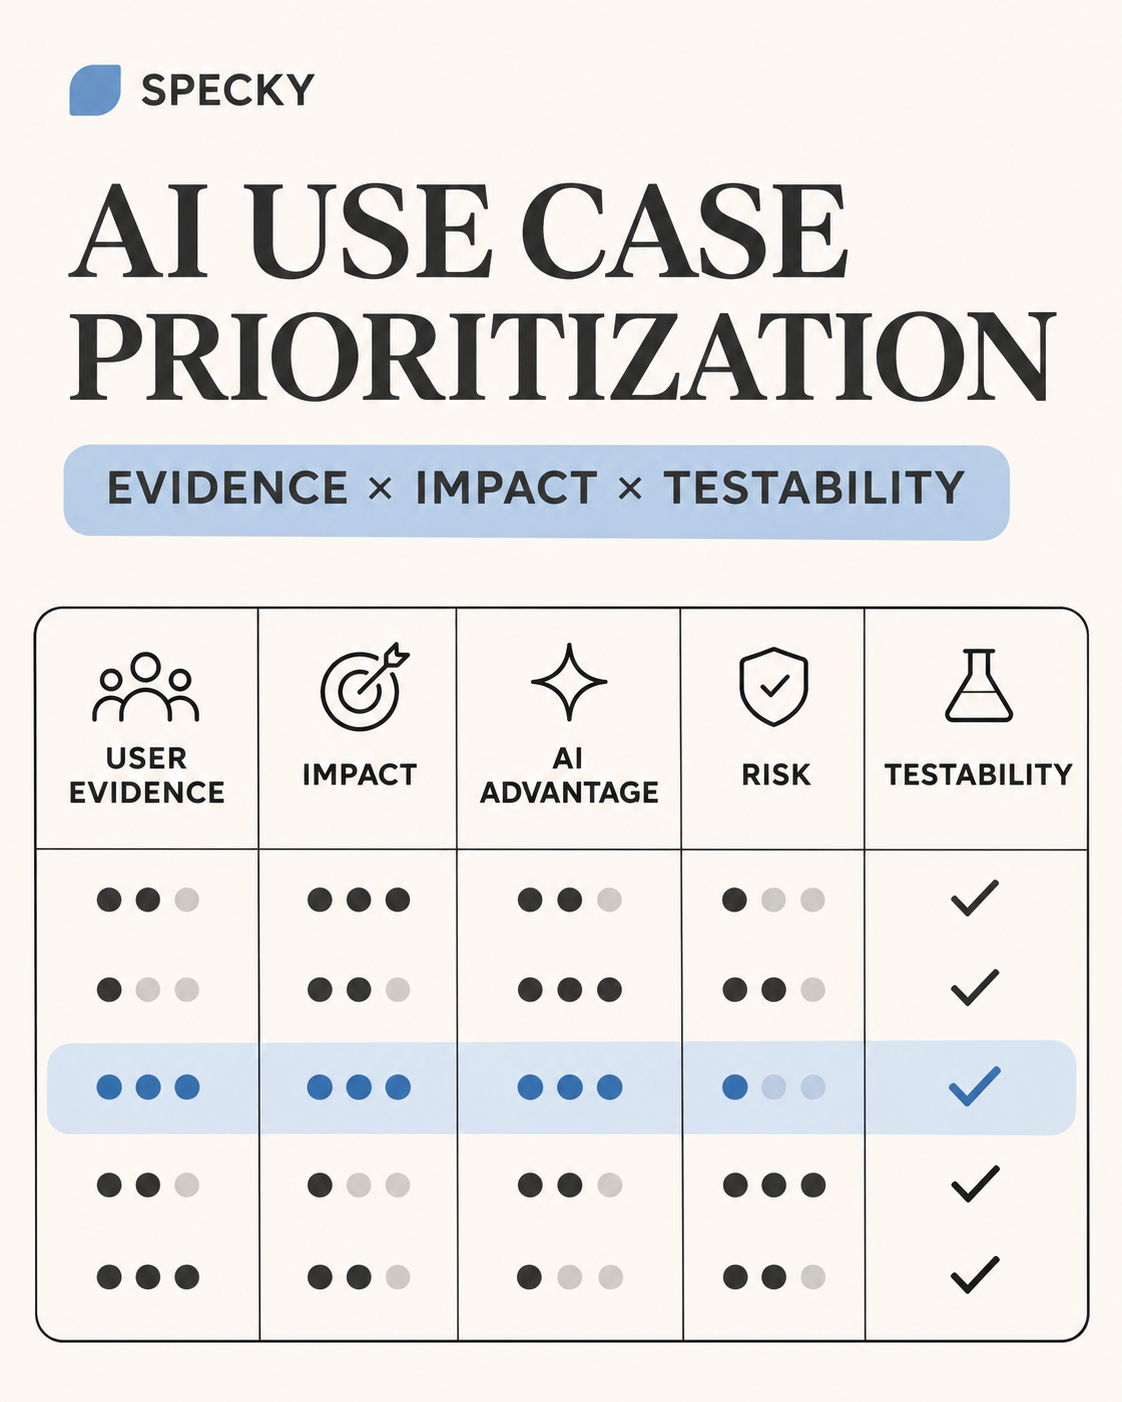
Usa una puntuación de 1 a 5 para cada dimensión. Los pesos de abajo son un punto de partida para la conversación, no una fórmula validada por la investigación. Cámbialos si la estrategia o el perfil de riesgo de tu equipo lo exigen. Deja la justificación por escrito junto a cada puntuación.
Dimensión
Peso
1 – débil
3 – mixto
5 – fuerte
Evidencia del problema
30 %
Sobre todo una suposición
Una señal creíble, patrón poco claro
Evidencia repetida y comprobable de los usuarios previstos
Resultado para el usuario
25 %
El beneficio es vago o interno
Beneficio plausible para el usuario, con lagunas
Una tarea o un resultado concreto debería mejorar
Ventaja de la IA
15 %
Una regla o una búsqueda normal puede funcionar igual de bien
La IA podría ayudar en una parte
La IA aborda variación real, lenguaje o síntesis
Capacidad de evaluación
15 %
Sin ejemplos ni criterios de revisión
Algunos ejemplos, quedan lagunas importantes
Hay casos representativos y comprobaciones de calidad observables
Control de fallos
10 %
Los errores podrían pasar inadvertidos o ser difíciles de revertir
Existe alguna revisión o alternativa
Los errores son visibles, acotados y recuperables durante la prueba
Tiempo para aprender
5 %
La prueba exige una integración amplia o un compromiso largo
Es posible un piloto con dependencias
Una prueba pequeña y reversible puede responder la siguiente pregunta
Calcula una puntuación ponderada dividiendo la puntuación entre 5 y multiplicándola por el peso, y después suma los seis resultados. El máximo es 100. Usa el número para estructurar la conversación, no para dar a entender que una idea con 4,1 es objetivamente mejor que una con 3,9. Un riesgo grave o una condición de preparación incumplida siguen necesitando una decisión directa.
Ejemplo: comparar tres posibles flujos de trabajo con IA
El ejemplo siguiente es hipotético. Ilustra cómo podría comparar ideas un equipo pequeño; no es un resultado de un cliente de Specky ni una investigación de mercado.
Candidato
Evidencia que revisar
Principal incertidumbre
Primera prueba razonable
Agrupar en temas las notas de entrevistas con clientes
Entrevistas recientes y el tiempo actual de síntesis
Si los temas sugeridos conservan los desacuerdos y el contexto de las fuentes
Pedir a los revisores que rastreen cada tema hasta los extractos originales y señalen los contraejemplos que falten
Redactar un brief de producto a partir de la evidencia de clientes
Ejemplos de briefs, documentos fuente y pasos de reescritura
Si el borrador ahorra trabajo de revisión sin añadir afirmaciones sin respaldo
Exigir enlaces a las fuentes para las afirmaciones de hechos y que un PM o un product engineer revise el borrador
Ordenar automáticamente las peticiones del roadmap
Fuentes de las peticiones, historial de decisiones y cómo se fijan hoy las prioridades
Si un ranking oculta contexto que falta o se confunde con una decisión
Mostrar primero la evidencia y los compromisos; dejar la decisión de priorización en manos de una persona
Ahora puntúalos. De nuevo, los números son ilustrativos:
Dimensión (peso)
Agrupar notas de entrevistas
Redactar brief de producto
Ordenar roadmap automáticamente
Evidencia del problema (30 %)
4 → 24
3 → 18
2 → 12
Resultado para el usuario (25 %)
4 → 20
4 → 20
2 → 10
Ventaja de la IA (15 %)
5 → 15
4 → 12
3 → 9
Capacidad de evaluación (15 %)
3 → 9
3 → 9
1 → 3
Control de fallos (10 %)
4 → 8
3 → 6
1 → 2
Tiempo para aprender (5 %)
5 → 5
4 → 4
2 → 2
Puntuación ponderada (sobre 100)
81
69
38
Condiciones de preparación
Cumple
Cumple
No cumple la condición 3
La idea de agrupar entrevistas lidera por 12 puntos y tiene la prueba más barata, así que va primero. La de redactar briefs es un segundo piloto razonable una vez que el primero haya producido criterios de revisión que el equipo pueda reutilizar. La idea del ranking automático no cumple la condición de control de fallos: una lista ordenada parece tener autoridad, y una equivocada podría orientar el roadmap sin que nadie lo note. Se queda en la lista con una nota sobre lo que tendría que cambiar.
¿En qué se diferencia una tabla de casos de uso de IA de RICE?
Tabla de casos de uso de IA
RICE
Valor frente a esfuerzo
Unidad que se compara
Problemas de usuarios con un ángulo de IA
Funcionalidades o proyectos
Funcionalidades o proyectos
Evaluación y riesgo de fallo
Puntuados explícitamente (25 % combinado)
Integrados en Confidence
No se contemplan
Pregunta «¿bastaría una herramienta más simple?»
Sí, mediante la ventaja de la IA
No
No
Resultado
Qué prueba hacer primero
Orden de construcción
Cuadrícula aproximada
Ideal para
Elegir entre ideas de IA
Secuenciar un backlog ya puntuado
Ordenar rápido
RICE sigue teniendo su lugar cuando una funcionalidad de IA ya se ha ganado su sitio y pasa al backlog ordinario. Para esa etapa, consulta RICE con IA.
¿Cuándo es la IA la herramienta equivocada para un caso de uso?
«La IA lo hace más inteligente» no es una justificación útil de una puntuación. Nombra el trabajo concreto en el que un modelo puede ayudar y compáralo con la referencia útil más simple:
¿La tarea implica lenguaje variado o evidencia no estructurada?
¿Importa la síntesis entre varias fuentes?
¿Puede un usuario comprobar el resultado contra esas fuentes?
¿Resolvería el mismo problema una búsqueda, una regla, un filtro o un flujo corto?
¿Qué coste, latencia, revisión y mantenimiento añade la versión con IA?
La People + AI Guidebook de Google es una referencia útil para fundamentar el diseño de IA en las necesidades de los usuarios. Enumera casos en los que la IA probablemente es mejor, como la personalización, la predicción y la comprensión del lenguaje natural, y casos en los que probablemente no lo es, como mantener la previsibilidad, minimizar los errores costosos, ofrecer transparencia total y optimizar para una alta velocidad y un bajo coste. No valida los pesos de esta tabla. Para decidir si una funcionalidad propuesta necesita siquiera un modelo, usa el test de adecuación a la IA.
¿Cómo se diseña la primera prueba de un caso de uso de IA?
No hagas un piloto de toda una idea de roadmap cuando una prueba acotada puede responder la siguiente pregunta. Elige la prueba según lo que menos se sabe:
Incertidumbre sobre el problema: observa el flujo de trabajo actual o entrevista a personas sobre un caso reciente y concreto.
Incertidumbre sobre la adecuación de la IA: compara el modelo con una regla, una búsqueda o el proceso manual actual con ejemplos representativos.
Incertidumbre sobre la confianza: deja que los usuarios previstos inspeccionen, corrijan, rechacen o deshagan el resultado.
Incertidumbre sobre el resultado: elige una medida ligada a la tarea del usuario, más una salvaguarda de calidad, errores, coste o tiempo.
Escribe las condiciones para continuar y para parar antes de ver los resultados. Por ejemplo, continúa solo si las personas pueden verificar el resultado, se superan las comprobaciones de calidad acordadas y la prueba mejora la tarea sin crear una carga de revisión inaceptable. Fija los umbrales reales con el equipo en función de las consecuencias y del punto de partida; no existe una nota de aprobado universal.
El NIST AI Risk Management Framework, publicado el 26 de enero de 2023 y de uso voluntario, organiza el trabajo sobre riesgos en Govern, Map, Measure y Manage. El NIST añadió un perfil de IA generativa (NIST-AI-600-1) el 26 de julio de 2024. Úsalos como guía para plantear preguntas específicas de tu producto, no como una certificación ni como sustituto de una revisión por expertos del ámbito.
Tabla de puntuación para priorizar casos de uso de IA, lista para copiar
Candidato:
Usuario y situación:
Job to be done:
Enfoque actual o solución provisional:

Evidencia y enlaces a las fuentes:
Lo que muestra la evidencia:
Lo que no muestra:

Resultado deseado para el usuario:
Aportación de la IA:
Referencia útil más simple:

Evidencia del problema (1–5):      x 30 % / 5 =
Resultado para el usuario (1–5):   x 25 % / 5 =
Ventaja de la IA (1–5):            x 15 % / 5 =
Capacidad de evaluación (1–5):     x 15 % / 5 =
Control de fallos (1–5):           x 10 % / 5 =
Tiempo para aprender (1–5):        x  5 % / 5 =
Puntuación ponderada (sobre 100):
Motivo de cada puntuación:

Condiciones de preparación:
[ ] Problema de usuario concreto y evidencia
[ ] Resultado observable y salvaguarda
[ ] El fallo es detectable, acotado o reversible

¿Construir, comprar o configurar una herramienta existente?:
Prueba útil más pequeña:
Responsable:
Continuar si:
Parar o rediseñar si:
Fecha de revisión:
Conserva los enlaces a la evidencia original junto con la tabla. Si una puntuación cambia, anota qué información nueva la cambió. Un registro de decisiones de producto ligero puede conservar la justificación y las condiciones para volver a plantear la decisión.
Errores habituales al priorizar casos de uso de IA
Ordenar por la calidad de la demo. Un prototipo que funciona con cinco entradas elegidas a mano dice poco sobre la centésima entrada real.
Saltarse la referencia. Si un filtro o una búsqueda guardada resuelve el 80 % del problema, la versión con IA tiene que superar eso, no superar la nada.
Lanzar cinco pilotos a la vez. Un equipo pequeño no puede evaluarlos en paralelo, y el esfuerzo de revisión se le achaca al flujo de trabajo equivocado.
Construir lo que podrías comprar. Los datos de MIT NANDA sugieren que las herramientas especializadas compradas tienen éxito con más frecuencia que los desarrollos internos. Añade «comprar o configurar» como opción antes de puntuar.
Sin política por escrito. En la encuesta de Productboard de 2025, el 65 % de 379 profesionales de producto de grandes empresas dijo que su compañía tenía una política de IA documentada, es decir, aproximadamente un tercio no la tenía (Productboard, 2025). Decide qué datos puede tocar un piloto antes de que empiece.
Cómo pueden usar la tabla los product engineers y los builders
Los product engineers y los fundadores técnicos suelen ver un camino de implementación antes de que el equipo haya comparado los problemas de fondo. Usa esa rapidez para abaratar una prueba, no para saltarte la evidencia del problema. Los ingenieros pueden identificar las limitaciones de acceso a los datos y de integración, preparar ejemplos representativos y hacer que un prototipo sea reversible. Los product builders pueden ayudar a sacar a la luz las suposiciones de la especificación y a explicitar el camino de revisión.
Deja el criterio de producto en manos del equipo. La IA puede organizar la evidencia de los candidatos o redactar opciones; no debería convertir en silencio una puntuación en un compromiso de roadmap. Para un flujo de discovery relacionado, liderado por ingeniería, consulta customer discovery para product engineers. Para llevar una idea elegida a un borrador de requisitos, usa el generador de PRD con IA gratuito y mantén adjunta la evidencia de origen.
Preguntas frecuentes
¿Qué es la priorización de casos de uso de IA?
La priorización de casos de uso de IA compara problemas de usuarios y flujos de trabajo candidatos para decidir cuál investigar o probar primero. Una comparación útil incluye la evidencia de usuarios, el resultado esperado, la ventaja concreta de la IA, la capacidad de evaluación y los controles de fallos. Termina con una prueba elegida y condiciones de parada, no con un compromiso de roadmap.
¿Cómo se priorizan las funcionalidades de IA?
Empieza por el problema del usuario y la solución provisional actual. Aplica las condiciones de preparación, compara los candidatos con criterios coherentes y haz una prueba pequeña con la idea de mayor prioridad cuyos riesgos se puedan controlar. Mantén visibles la puntuación y la justificación para que la nueva evidencia pueda cambiar la decisión.
¿Debería un equipo pequeño construir varias funcionalidades de IA a la vez?
Normalmente conviene probar menos ideas a la vez cuando el equipo no puede evaluarlas en paralelo. Un piloto acotado facilita atribuir el esfuerzo de revisión, los problemas de calidad y los resultados de usuario a un flujo de trabajo concreto. Elige el alcance según la evidencia disponible y la capacidad.
¿Qué pasa si dos casos de uso de IA tienen puntuaciones parecidas?
Compara la incertidumbre que reduciría cada prueba, el daño si el flujo de trabajo falla y si las ideas dependen de los mismos datos o de la misma integración. Si la evidencia sigue sin desempatar, haz un paso de discovery o una prueba pequeña y reversible en lugar de inventar precisión en la puntuación.
¿Predice la puntuación de un caso de uso de IA el éxito del producto?
No. Una puntuación es un resumen estructurado de la evidencia y las suposiciones actuales. No predice la adopción, los ingresos ni el product-market fit. Valida el problema del usuario y mide qué ocurre en un flujo de trabajo real.
¿Por qué dar más peso a la evidencia del problema que a la ventaja de la IA?
Porque los datos sobre los fracasos apuntan a los problemas y los flujos de trabajo, no a los modelos. Las empresas líderes de BCG dedicaron el 70 % de sus recursos de IA a las personas y los procesos y solo el 10 % a los algoritmos. Un modelo potente aplicado a un problema sin demostrar sigue fracasando, mientras que un modelo modesto aplicado a una tarea bien documentada y verificable puede aportar valor rápidamente.
Elige una prueba y actualiza la decisión con evidencia
Un buen proceso para priorizar casos de uso de IA hace que la elección y su incertidumbre se vean con más facilidad. Compara problemas candidatos, muestra por qué una prueba va primero y anota qué cambiaría la decisión. El objetivo es descubrir qué flujo de trabajo crea un beneficio real para el usuario, no poner la IA en el roadmap por defecto.
GDPR-aligned. EU workspace data is stored in Frankfurt, Germany. GDPR and EU data Built in Vienna, Austria. A product of influence solutions fm GmbH (FN 675374y). Imprint 14-day trial. Card required, and nothing is charged until day 14. 30-day refund after subscribing. See pricing