4 novembre 2026Mis à jour le Fathy Shalaby14 min de lecture
Comment prioriser les cas d’usage de l’IA : une grille de notation pour les équipes produit
Comparez vos idées de produits IA avec une grille pondérée : preuves côté utilisateurs, impact, apport de l’IA, capacité d’évaluation, maîtrise des erreurs et temps pour apprendre. Choisissez ce que vous allez tester ensuite, pas ce que vous allez livrer.
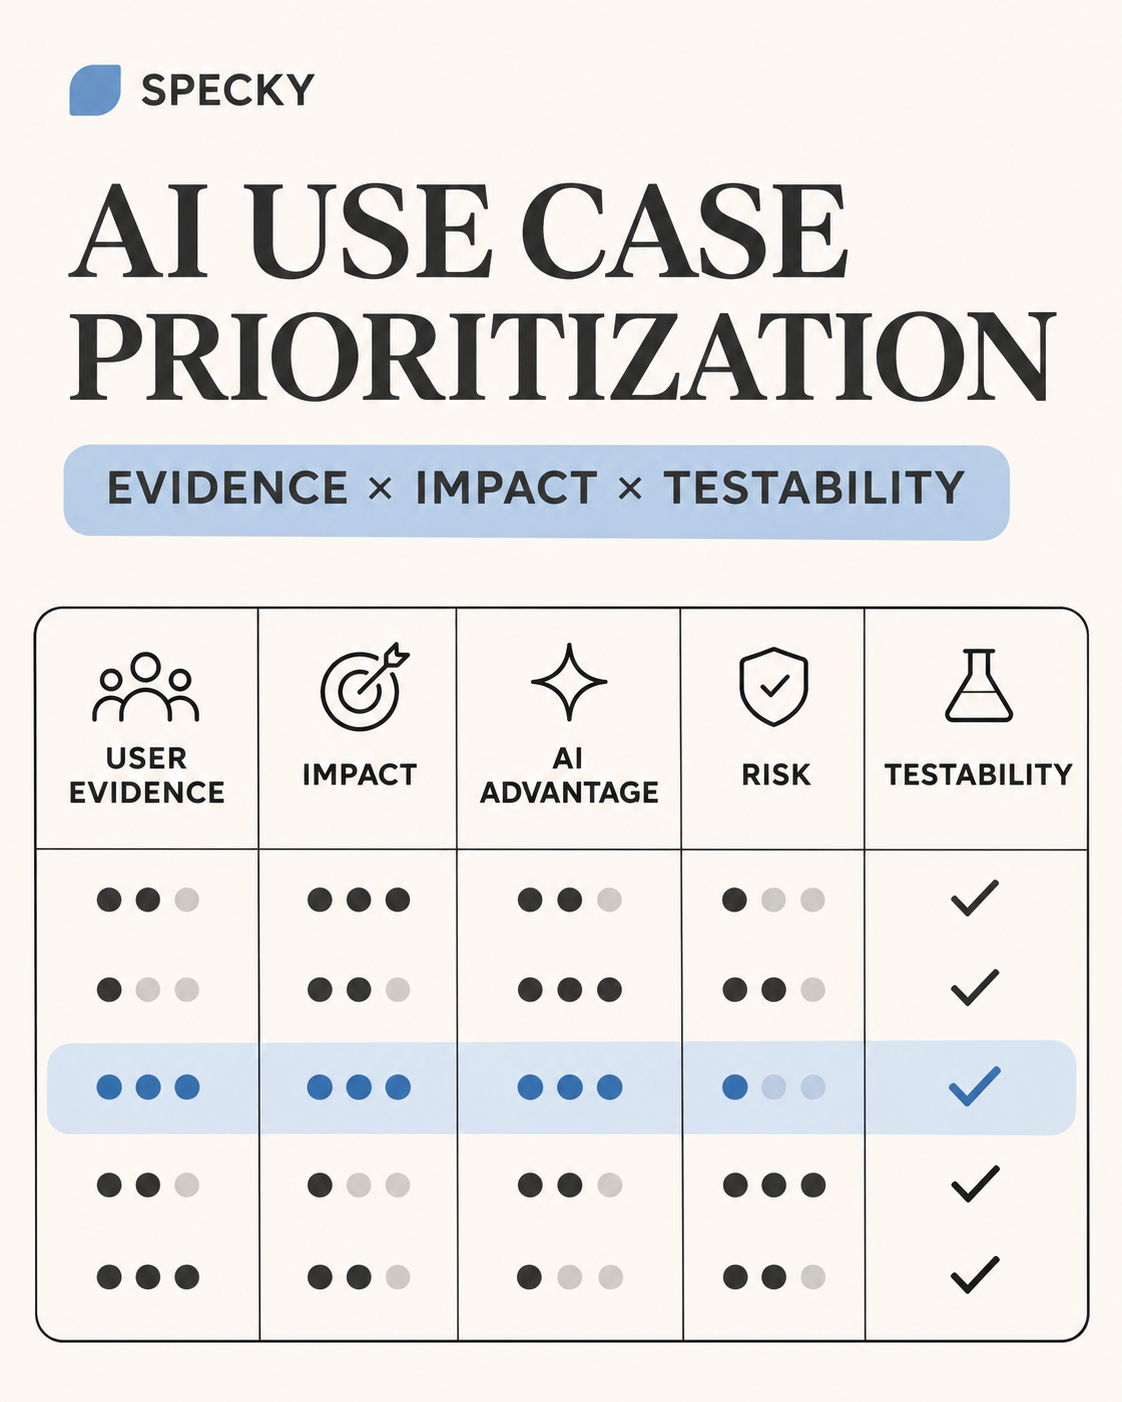
Pour prioriser les cas d’usage de l’IA, comparez des problèmes utilisateurs plutôt que des fonctionnalités d’IA, puis choisissez celui que vous testerez en premier. Notez chaque candidat selon la solidité des preuves du problème, le résultat attendu pour l’utilisateur, l’avantage de l’IA par rapport à une option plus simple, la capacité d’évaluation, la maîtrise des erreurs et le temps nécessaire pour apprendre. Appliquez trois critères de préparation avant de noter, et considérez le résultat comme un moyen de faire apparaître les arbitrages, pas comme une prévision.
C’est une décision différente de celle qui consiste à se demander si une fonctionnalité donnée doit utiliser l’IA. Le test d’adéquation à l’IA en quatre questions aide à évaluer une seule fonctionnalité. Cette grille aide un fondateur, un premier product hire, un PM ou un product engineer à décider lequel de plusieurs candidats mérite l’attention limitée de l’équipe.
Points clés
La plupart des initiatives d’IA s’enlisent avant d’être rentables. D’après l’enquête de BCG auprès de 1 000 dirigeants dans 59 pays, 74 % des entreprises n’avaient pas encore démontré de valeur tangible issue de l’IA, et seules 26 % parvenaient à dépasser le stade des preuves de concept (BCG, 2024).
L’étude 2025 de MIT NANDA, fondée sur 150 entretiens et 300 déploiements publics, a conclu qu’environ 5 % seulement des projets pilotes d’IA avaient atteint une accélération rapide du chiffre d’affaires (Fortune, 2025).
La contrainte vient rarement du modèle. Les entreprises en pointe selon BCG consacrent 10 % de leurs ressources aux algorithmes, 20 % à la technologie et aux données, et 70 % aux personnes et aux processus.
Le PAIR Guidebook de Google énumère des cas où l’IA n’est probablement pas meilleure, notamment lorsqu’il faut préserver la prévisibilité et minimiser les erreurs coûteuses (Google PAIR).
Pondérez au plus haut les preuves du problème et le résultat utilisateur. Dans la grille ci-dessous, ils pèsent 55 % du total.
Pourquoi tant de cas d’usage de l’IA échouent-ils ?
Les équipes choisissent généralement leurs projets d’IA comme elles choisissent leurs démos : selon ce qui impressionne dans un prototype. Les données sur les échecs pointent ailleurs.
Le manque porte sur la valeur, pas sur la capacité. BCG a constaté que 4 % seulement des entreprises disposaient des capacités d’IA les plus avancées dans toutes les fonctions, et que les entreprises en pointe consacraient l’essentiel de leurs efforts aux personnes et aux processus, pas aux algorithmes (BCG, 2024).
Ce sont les workflows qui décident des résultats. Le rapport de MIT NANDA attribue l’échec à un « écart d’apprentissage » dans les outils et les organisations plutôt qu’à la qualité des modèles, et constate que les outils achetés auprès de fournisseurs spécialisés réussissaient environ 67 % du temps, contre environ un tiers pour les développements internes (Fortune, 2025). Lisez ce que mesurait réellement le chiffre de 95 % avant de le citer.
Les utilisateurs vérifient le résultat. Dans l’enquête Stack Overflow 2025, 46 % des développeurs se méfiaient de la précision des outils d’IA contre 33 % qui leur faisaient confiance, et 66 % citaient les réponses « presque justes, mais pas tout à fait » comme leur principale source de frustration (Stack Overflow, 2025). Si vos utilisateurs ne peuvent pas vérifier un résultat, ils l’ignoreront ou lui feront confiance alors qu’ils ne le devraient pas.
Le schéma est le suivant : choisissez un problème utilisateur étroit et étayé, avec un moyen visible de vérifier la qualité, et les projets d’IA se comportent comme n’importe quel pari produit. Si vous sautez ces étapes, le prototype devient la stratégie.
Partez de problèmes candidats, pas de fonctionnalités d’IA
Une liste d’idées mélange souvent des choses différentes : des problèmes utilisateurs, des fonctionnalités demandées, des expériences et des possibilités techniques. Normalisez chaque candidat avant de le comparer.
Pour chaque idée, notez :
Utilisateur et situation : qui rencontre le problème, et quand ?
Job : que cherche cette personne à accomplir ?
Approche actuelle : que fait-elle aujourd’hui, y compris les contournements ?
Preuves : qu’a-t-on observé directement, et où l’équipe peut-elle le consulter ?
Résultat souhaité : qu’est-ce qui serait mieux pour l’utilisateur ?
Apport de l’IA : quelle partie de la tâche peut profiter du langage, de la synthèse ou de l’adaptation ?
Coût de l’erreur : que pourrait-il mal se passer, et qui le remarquerait ?
Premier test : quelle est la plus petite expérience capable de répondre à une question utile ?
« Ajouter un assistant de roadmap IA » n’est pas prêt à être comparé. « Un premier product hire passe son vendredi à regrouper des demandes du support et des notes d’entretiens avant de décider quoi explorer » est un candidat plus utile : il nomme un utilisateur, une tâche et des preuves que l’équipe peut chercher.
Ne considérez pas une demande de partie prenante, un vote ou un prototype convaincant comme la preuve qu’un problème est répandu. Gardez la source d’origine attachée et notez ce qu’elle n’établit pas. La boucle de discovery produit avec l’IA présente une méthode sur deux semaines pour recueillir et examiner ces signaux.
Quels critères de préparation un cas d’usage de l’IA doit-il remplir d’abord ?
Un score élevé ne doit pas masquer une raison fondamentale d’attendre. Avant de classer les idées, vérifiez trois critères :
Le problème utilisateur est assez précis pour être étudié. Vous pouvez nommer un utilisateur, décrire une situation récente et identifier au moins une source ou une étape de discovery claire.
Un résultat utile est observable. L’équipe peut dire ce qui doit s’améliorer et quel garde-fou ne doit pas se dégrader.
Une erreur coûteuse a un contrôle visible. L’équipe peut détecter, examiner, limiter ou annuler l’erreur concernée avant d’étendre la fonctionnalité.
Si une idée échoue à un critère, signalez la preuve ou le travail de conception qui manque. Elle peut rester sur la liste, mais elle ne doit pas l’emporter simplement parce qu’un prototype est facile à construire.
Comment noter et comparer les cas d’usage de l’IA ?
Utilisez une note de 1 à 5 pour chaque dimension. Les pondérations ci-dessous sont un point de départ pour la discussion, pas une formule validée par la recherche. Modifiez-les si la stratégie ou le profil de risque de votre équipe l’exige. Gardez la justification écrite à côté de chaque note.
Dimension
Poids
1 – faible
3 – mitigé
5 – fort
Preuves du problème
30 %
Surtout une hypothèse
Un signal crédible, schéma peu clair
Preuves répétées et vérifiables auprès des utilisateurs visés
Résultat utilisateur
25 %
Bénéfice flou ou purement interne
Bénéfice utilisateur plausible, avec des zones d’ombre
Une tâche ou un résultat précis devrait s’améliorer
Apport de l’IA
15 %
Une règle ou une recherche classique peut faire aussi bien
L’IA pourrait aider sur une partie
L’IA répond à une vraie variabilité, au langage ou à la synthèse
Capacité d’évaluation
15 %
Aucun exemple ni critère de revue
Quelques exemples, des lacunes importantes subsistent
Cas représentatifs et contrôles de qualité observables disponibles
Maîtrise des erreurs
10 %
Les erreurs pourraient être silencieuses ou difficiles à annuler
Une certaine revue ou un repli existe
Erreurs visibles, circonscrites et réparables pour le test
Temps pour apprendre
5 %
Le test exige une large intégration ou un engagement long
Un pilote est possible avec des dépendances
Un petit test réversible peut répondre à la question suivante
Calculez un score pondéré en divisant la note par 5 puis en multipliant par le poids, puis additionnez les six résultats. Le maximum est 100. Servez-vous du chiffre pour structurer la discussion, pas pour laisser entendre qu’une idée à 4,1 est objectivement meilleure qu’une idée à 3,9. Un risque sérieux ou un critère de préparation non validé exige quand même une décision directe.
Exemple : comparer trois workflows d’IA possibles
L’exemple ci-dessous est hypothétique. Il illustre comment une petite équipe pourrait comparer des idées ; ce n’est ni un résultat client de Specky ni une étude de marché.
Candidat
Preuves à examiner
Principale incertitude
Premier test judicieux
Regrouper en thèmes les notes d’entretiens clients
Entretiens récents et temps de synthèse actuel
Les thèmes proposés préservent-ils les désaccords et le contexte des sources ?
Demander aux relecteurs de rattacher chaque thème à des extraits d’origine et de signaler les contre-exemples manquants
Rédiger un brief produit à partir de preuves clients
Exemples de briefs, documents sources et étapes de réécriture
Le brouillon fait-il gagner du temps de revue sans ajouter d’affirmations non étayées ?
Exiger des liens vers les sources pour les affirmations factuelles et faire relire le brouillon par un PM ou un product engineer
Classer automatiquement les demandes de roadmap
Sources des demandes, historique des décisions et manière dont les priorités sont fixées aujourd’hui
Un classement masque-t-il un contexte manquant ou est-il pris pour une décision ?
Montrer d’abord les preuves et les arbitrages ; laisser la décision de priorisation à une personne
Notons-les maintenant. Là encore, les chiffres sont purement illustratifs :
Dimension (poids)
Regrouper les notes d’entretiens
Rédiger un brief produit
Classer automatiquement la roadmap
Preuves du problème (30 %)
4 → 24
3 → 18
2 → 12
Résultat utilisateur (25 %)
4 → 20
4 → 20
2 → 10
Apport de l’IA (15 %)
5 → 15
4 → 12
3 → 9
Capacité d’évaluation (15 %)
3 → 9
3 → 9
1 → 3
Maîtrise des erreurs (10 %)
4 → 8
3 → 6
1 → 2
Temps pour apprendre (5 %)
5 → 5
4 → 4
2 → 2
Score pondéré (sur 100)
81
69
38
Critères de préparation
Validés
Validés
Échoue au critère 3
L’idée de regrouper les entretiens mène de 12 points et a le test le moins cher, elle passe donc en premier. La rédaction de briefs est un second pilote raisonnable, une fois que le premier aura produit des critères de revue réutilisables par l’équipe. L’idée du classement automatique échoue sur la maîtrise des erreurs : une liste classée paraît faire autorité, et une liste erronée pourrait orienter discrètement la roadmap. Elle reste sur la liste, avec une note sur ce qui devrait changer.
En quoi une grille de cas d’usage de l’IA diffère-t-elle de RICE ?
Grille de cas d’usage de l’IA
RICE
Valeur vs effort
Unité comparée
Problèmes utilisateurs avec un angle IA
Fonctionnalités ou projets
Fonctionnalités ou projets
Évaluation et risque d’erreur
Notés explicitement (25 % cumulés)
Intégrés dans Confidence
Non couverts
Demande « un outil plus simple suffirait-il ? »
Oui, via l’apport de l’IA
Non
Non
Résultat
Quel test lancer en premier
Ordre de construction
Grille approximative
Idéal pour
Choisir entre des idées d’IA
Séquencer un backlog déjà noté
Tri rapide
RICE garde sa place une fois qu’une fonctionnalité d’IA a fait ses preuves et rejoint le backlog ordinaire. Pour cette étape, voyez le scoring RICE avec l’IA.
Quand l’IA est-elle le mauvais outil pour un cas d’usage ?
« L’IA rend cela plus intelligent » n’est pas une justification de note utile. Nommez le travail précis pour lequel un modèle peut aider, puis comparez-le à la référence utile la plus simple :
La tâche implique-t-elle un langage varié ou des preuves non structurées ?
La synthèse entre plusieurs sources compte-t-elle ?
Un utilisateur peut-il vérifier le résultat à partir de ces sources ?
Une recherche, une règle, un filtre ou un court workflow résoudrait-il le même problème ?
Quels coûts, quelle latence, quelle revue et quelle maintenance la version IA ajoute-t-elle ?
Le People + AI Guidebook de Google est une référence utile pour ancrer la conception de l’IA dans les besoins des utilisateurs. Il énumère des cas où l’IA est probablement meilleure, comme la personnalisation, la prédiction et la compréhension du langage naturel, et des cas où elle ne l’est probablement pas, comme préserver la prévisibilité, minimiser les erreurs coûteuses, offrir une transparence complète et optimiser pour une vitesse élevée et un faible coût. Il ne valide pas les pondérations de cette grille. Pour décider si une fonctionnalité précise a vraiment besoin d’un modèle, utilisez le test d’adéquation à l’IA.
Comment concevoir le premier test d’un cas d’usage de l’IA ?
Ne pilotez pas toute une idée de roadmap quand un test ciblé peut répondre à la question suivante. Choisissez le test en fonction de ce que vous connaissez le moins :
Incertitude sur le problème : observez le workflow actuel ou interrogez des personnes sur un cas récent et concret.
Incertitude sur l’adéquation de l’IA : comparez le modèle à une règle, à une recherche ou au processus manuel actuel sur des exemples représentatifs.
Incertitude sur la confiance : laissez les utilisateurs visés inspecter, corriger, rejeter ou annuler le résultat.
Incertitude sur le résultat : choisissez une mesure liée à la tâche de l’utilisateur, plus un garde-fou sur la qualité, les erreurs, le coût ou le temps.
Écrivez les conditions de poursuite et d’arrêt avant de regarder les résultats. Par exemple, ne continuez que si les gens peuvent vérifier le résultat, si les contrôles de qualité convenus sont réussis et si le test améliore la tâche sans créer un travail de revue inacceptable. Fixez les seuils réels avec l’équipe, en fonction des conséquences et de la situation de départ ; il n’existe pas de note de réussite universelle.
Le NIST AI Risk Management Framework, publié le 26 janvier 2023 et destiné à un usage volontaire, organise le travail sur les risques en quatre fonctions : Govern, Map, Measure et Manage. Le NIST y a ajouté un profil pour l’IA générative (NIST-AI-600-1) le 26 juillet 2024. Servez-vous-en comme d’autant de pistes pour formuler des questions propres à votre produit, pas comme d’une certification ni comme d’un substitut à une revue par des experts du domaine.
Grille de priorisation des cas d’usage de l’IA à copier
Candidat :
Utilisateur et situation :
Job to be done :
Approche actuelle ou contournement :

Preuves et liens vers les sources :
Ce que montrent les preuves :
Ce qu’elles ne montrent pas :

Résultat utilisateur souhaité :
Apport de l’IA :
Référence utile la plus simple :

Preuves du problème (1–5) :      x 30 % / 5 =
Résultat utilisateur (1–5) :     x 25 % / 5 =
Apport de l’IA (1–5) :           x 15 % / 5 =
Capacité d’évaluation (1–5) :    x 15 % / 5 =
Maîtrise des erreurs (1–5) :     x 10 % / 5 =
Temps pour apprendre (1–5) :     x  5 % / 5 =
Score pondéré (sur 100) :
Raison de chaque note :

Critères de préparation :
[ ] Problème utilisateur précis et preuves
[ ] Résultat observable et garde-fou
[ ] L’erreur est détectable, circonscrite ou réversible

Construire, acheter ou configurer un outil existant ? :
Plus petit test utile :
Responsable :
Continuer si :
Arrêter ou repenser si :
Date de revue :
Conservez les liens vers les preuves d’origine avec la grille. Si une note change, consignez l’information nouvelle qui l’a modifiée. Un journal de décisions produit léger peut conserver la justification et les conditions qui permettent de revenir sur le choix.
Erreurs courantes lors de la priorisation des cas d’usage de l’IA
Classer selon la qualité de la démo. Un prototype qui fonctionne sur cinq entrées triées sur le volet dit peu de chose sur la centième entrée réelle.
Sauter la référence. Si un filtre ou une recherche enregistrée résout 80 % du problème, la version IA doit faire mieux que cela, pas mieux que rien.
Lancer cinq pilotes à la fois. Une petite équipe ne peut pas les évaluer en parallèle, et l’effort de revue est imputé au mauvais workflow.
Construire ce que l’on pourrait acheter. Les données de MIT NANDA suggèrent que les outils spécialisés achetés réussissent plus souvent que les développements internes. Ajoutez « acheter ou configurer » comme option avant de noter.
Aucune politique écrite. Dans l’enquête 2025 de Productboard, 65 % de 379 professionnels produit en entreprise ont déclaré que leur société disposait d’une politique d’IA documentée, donc environ un tiers n’en avait pas (Productboard, 2025). Décidez quelles données un pilote peut toucher avant son lancement.
Comment les product engineers et les builders peuvent utiliser la grille
Les product engineers et les fondateurs techniques voient souvent une voie d’implémentation avant que l’équipe ait comparé les problèmes sous-jacents. Utilisez cette rapidité pour rendre un test moins coûteux, pas pour faire l’impasse sur les preuves du problème. Les ingénieurs peuvent repérer les contraintes d’accès aux données et d’intégration, préparer des exemples représentatifs et rendre un prototype réversible. Les product builders peuvent aider à faire ressortir les hypothèses dans la spécification et à expliciter le circuit de revue.
Laissez le jugement produit à l’équipe. L’IA peut organiser les preuves des candidats ou rédiger des options ; elle ne doit pas transformer discrètement un score en engagement de roadmap. Pour un workflow de discovery connexe, mené côté ingénierie, voyez la customer discovery pour les product engineers. Pour transformer une idée retenue en brouillon d’exigences, utilisez le générateur de PRD IA gratuit et gardez les preuves sources attachées.
Questions fréquentes
Qu’est-ce que la priorisation des cas d’usage de l’IA ?
La priorisation des cas d’usage de l’IA compare des problèmes utilisateurs et des workflows candidats pour décider lequel étudier ou tester en premier. Une comparaison utile inclut les preuves côté utilisateurs, le résultat attendu, l’avantage précis de l’IA, la capacité d’évaluation et les contrôles d’erreur. Elle se termine par un test choisi et des conditions d’arrêt, pas par un engagement de roadmap.
Comment prioriser les fonctionnalités d’IA ?
Partez du problème utilisateur et du contournement actuel. Appliquez les critères de préparation, comparez les candidats selon des critères cohérents, et lancez un petit test sur l’idée la plus prioritaire dont les risques sont maîtrisables. Gardez visibles le score et la justification, afin que de nouvelles preuves puissent changer la décision.
Une petite équipe doit-elle construire plusieurs fonctionnalités d’IA à la fois ?
En général, testez moins d’idées à la fois quand l’équipe ne peut pas les évaluer en parallèle. Un pilote ciblé permet plus facilement d’attribuer l’effort de revue, les problèmes de qualité et les résultats utilisateurs à un workflow précis. Choisissez le périmètre en fonction des preuves disponibles et de votre capacité.
Que faire si deux cas d’usage de l’IA ont des scores proches ?
Comparez l’incertitude que chaque test lèverait, le préjudice si le workflow échoue, et la question de savoir si les idées reposent sur les mêmes données ou la même intégration. Si les preuves ne départagent toujours pas, faites une étape de discovery ou un petit test réversible plutôt que d’inventer de la précision dans la notation.
Le score d’un cas d’usage de l’IA prédit-il le succès du produit ?
Non. Un score est un résumé structuré des preuves et des hypothèses actuelles. Il ne prédit ni l’adoption, ni le chiffre d’affaires, ni l’adéquation produit-marché. Validez le problème utilisateur et mesurez ce qui se passe dans un vrai workflow.
Pourquoi pondérer les preuves du problème au-dessus de l’apport de l’IA ?
Parce que les données sur les échecs désignent les problèmes et les workflows, pas les modèles. Les entreprises en pointe selon BCG consacrent 70 % de leurs ressources d’IA aux personnes et aux processus, et 10 % seulement aux algorithmes. Un modèle puissant appliqué à un problème non prouvé échoue quand même, alors qu’un modèle modeste sur une tâche bien étayée et vérifiable peut apporter rapidement de la valeur.
Choisissez un test, puis mettez la décision à jour avec des preuves
Un processus utile pour prioriser les cas d’usage de l’IA rend le choix et son incertitude plus faciles à voir. Comparez des problèmes candidats, montrez pourquoi un test passe en premier, et consignez ce qui changerait la décision. L’objectif est de découvrir quel workflow crée un vrai bénéfice pour l’utilisateur, pas de mettre l’IA sur la roadmap par défaut.
GDPR-aligned. EU workspace data is stored in Frankfurt, Germany. GDPR and EU data Built in Vienna, Austria. A product of influence solutions fm GmbH (FN 675374y). Imprint 14-day trial. Card required, and nothing is charged until day 14. 30-day refund after subscribing. See pricing