10 octobre 2026Mis à jour le Fathy Shalaby15 min de lecture
Checklist d’acceptation du code généré par IA : le guide de revue du PM
Construire est devenu bon marché ; accepter le résultat, non. L’Acceptance Ladder en quatre échelons aide les PM à examiner les changements produits par des agents au regard de la décision, du brief, des cas limites et du résultat.
Une checklist d’acceptation du code généré par IA est la courte liste de contrôles qu’un product manager effectue avant qu’un changement produit par un agent soit considéré comme terminé. Les ingénieurs examinent la façon dont le code est écrit ; le PM vérifie qu’il s’agit du bon changement. Nous utilisons quatre échelons, dans l’ordre : le rattacher à une décision, le comparer au brief, éprouver les cas limites et définir comment vous saurez que cela a fonctionné.
L’essentiel
Anthropic décrit le développement logiciel comme un basculement « de l’écriture de code à l’orchestration d’agents qui écrivent du code » (Anthropic, 2026). La compétence rare se déplace vers le siège du relecteur.
66 % des développeurs disent que leur principale frustration avec les outils d’IA tient à des solutions presque justes, mais pas tout à fait (Stack Overflow, 2025). Les changements presque justes passent une revue « ça a l’air bien ».
Un résultat fluide fausse le jugement : dans un essai randomisé, des développeurs pensaient que l’IA les avait rendus 20 % plus rapides alors qu’elle les avait ralentis de 19 % (METR, 2025).
Les agents ont tendance à construire trop. Le passage « surplus » (lister les comportements que personne n’a demandés) est le contrôle que la plupart des équipes sautent.
La checklist ne remplace ni la revue de code ni la revue de sécurité : 45 % des échantillons de code générés par IA dans un test de 2025 introduisaient des vulnérabilités connues (Veracode, 2025).
Pourquoi « ça a l’air bien » est-il le mauvais critère pour le code généré par IA ?
La plupart des équipes examinent la production d’un agent comme elles examinaient une pull request humaine : parcourir le diff, cliquer dans la prévisualisation, approuver. Cela fonctionne quand un collègue porte le contexte de la réunion de planification et des appels clients. Cela échoue quand un agent ne porte que ce que le brief a encodé.
Si le brief était vague, l’agent comble le vide avec le comportement le plus plausible statistiquement, et plausible n’est pas synonyme de correct. Le changement compile, la prévisualisation s’affiche, le chemin nominal fonctionne, et le PM approuve. Deux semaines plus tard, quelqu’un remarque qu’il a discrètement abandonné une contrainte que personne n’avait écrite, ou résolu un problème voisin au lieu de celui du brief. Le code n’avait rien de faux. L’étape d’acceptation n’a simplement jamais posé les bonnes questions.
Trois éléments rendent la production d’un agent plus difficile à juger que celle d’un humain :
Le volume. Une génération bon marché signifie plus de changements candidats par semaine, et le temps de revue devient le goulot d’étranglement.
L’assurance. Les agents décrivent leur propre travail avec aisance. Un résumé soigné n’est pas une preuve. L’essai 2025 de METR, avec 16 développeurs expérimentés et 246 tickets réels, a montré que les développeurs s’attendaient à ce que l’IA les accélère de 24 % et, après le travail, croyaient toujours qu’elle les avait accélérés de 20 %, alors que le résultat mesuré était un ralentissement de 19 % (METR, 2025). METR indique désormais que ces résultats du début de 2025 sont dépassés, et son suivi de février 2026 a trouvé de faibles gains estimés qu’il qualifie de signal peu fiable (METR, 2026). La leçon durable est l’écart de perception, pas le chiffre de vitesse.
L’absence de trace d’intention. Sans lien entre le changement et la décision qu’il met en œuvre, vous ne pouvez pas distinguer « construit comme spécifié » de « construit comme déduit ».
Les données de livraison vont dans le même sens. La recherche DORA 2024 de Google a constaté qu’une hausse de 25 % de l’adoption de l’IA était associée à une qualité de documentation meilleure de 7,5 %, une qualité de code meilleure de 3,4 % et une revue de code plus rapide de 3,1 %. Pourtant, à mesure que l’adoption augmentait, les chercheurs ont aussi estimé une baisse de 1,5 % du débit de livraison et de 7,2 % de la stabilité de livraison (DORA, 2024). Le rapport 2025 le résume : l’IA amplifie les forces et les faiblesses existantes d’une organisation (DORA, 2025). Une étape d’acceptation faible est l’une des faiblesses qu’elle amplifie.
Que doit vérifier un PM, et que doit vérifier un ingénieur ?
Séparez la revue. Les pratiques d’ingénierie de Google énumèrent ce que cherche un relecteur de code : conception, fonctionnalité, complexité, tests, nommage, commentaires, style, cohérence, documentation et contexte (Google). L’essentiel relève de l’ingénierie. Une question de la liste appartient au produit : « Is what the developer intended good for the users of this code? »
Question
Qui en est responsable
Où y répond-on
Le code est-il bien conçu, lisible et testé ?
Ingénieur
Revue de code
Est-il sûr, et gère-t-il correctement les permissions ?
Ingénieur (avec des outils de sécurité)
Revue de code, scanners
Quelle décision ou quelle preuve ce changement met-il en œuvre ?
PM
Acceptance Ladder, échelon 1
A-t-il construit ce que disait le brief, et seulement cela ?
PM
Échelon 2
Se comporte-t-il de façon défendable sur les cas vide, erreur, limite, permission et répétition ?
PM et ingénieur ensemble
Échelon 3
Comment et quand saurons-nous que cela a fonctionné pour les utilisateurs ?
PM
Échelon 4
Dans une équipe de fondateur solo, une seule personne porte les deux casquettes. Faites tout de même les deux revues en passes séparées : lire du code pour sa justesse et lire un comportement pour son intention mobilisent une attention différente.
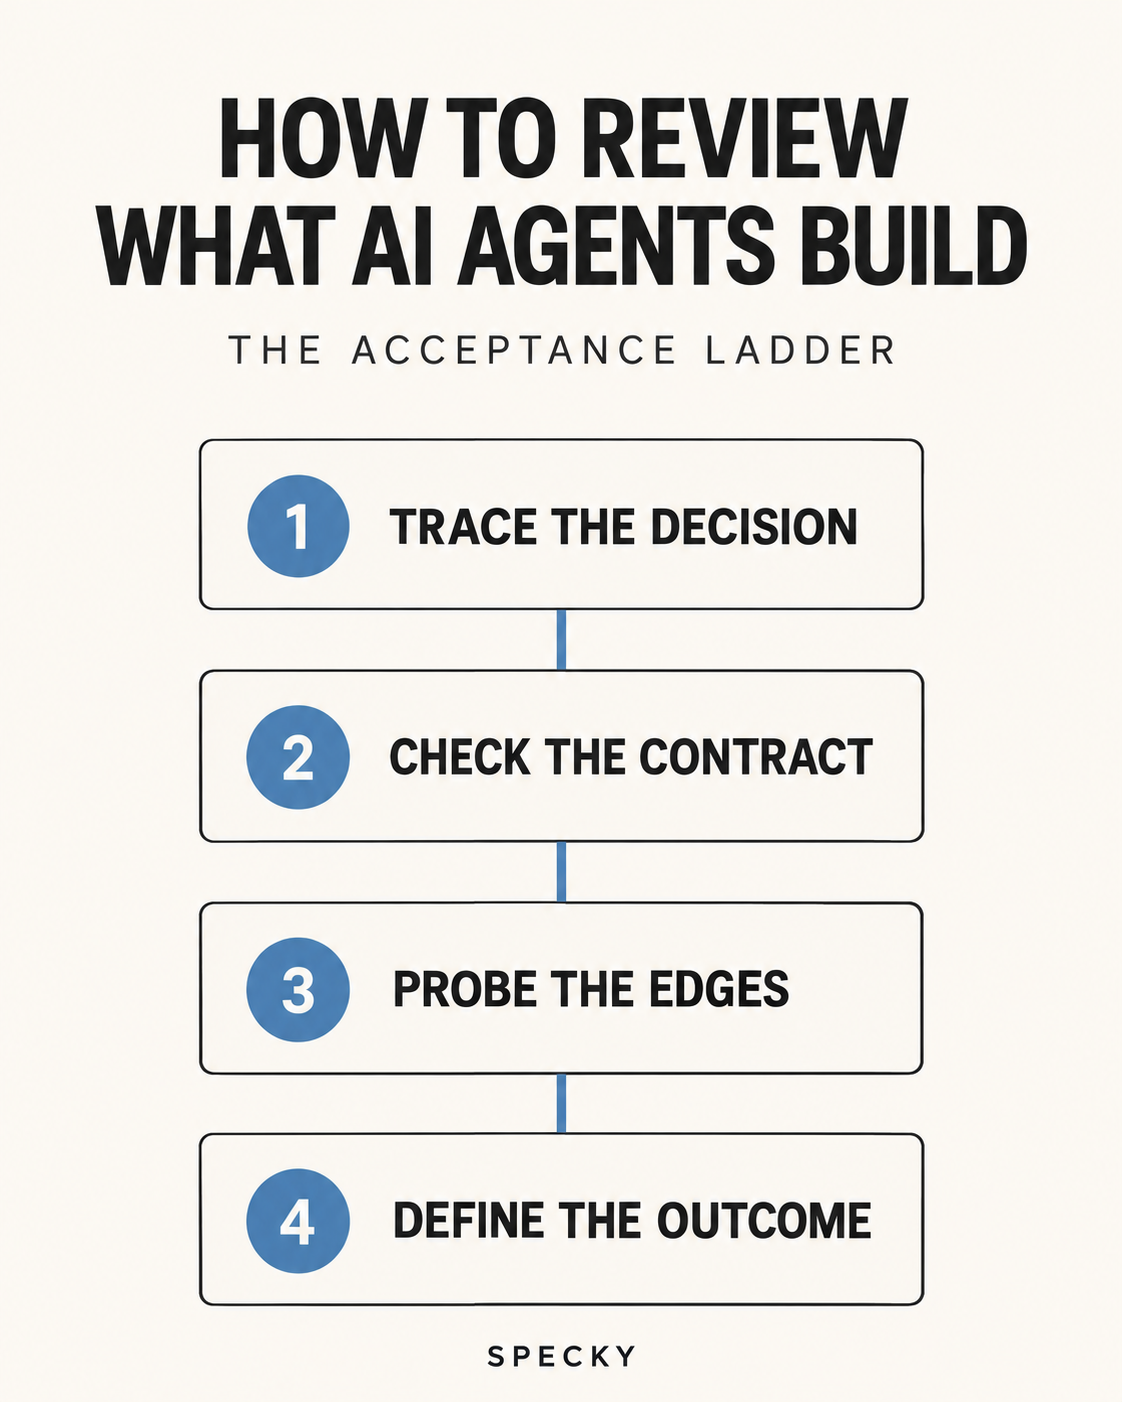
L’Acceptance Ladder : quatre contrôles avant qu’un changement produit par un agent soit terminé
Chaque échelon pose une question. Vous ne montez à l’échelon suivant que si le précédent est validé. Si un changement bloque à l’échelon un, vous ne perdez pas de temps sur l’échelon quatre.
Échelon 1 : Traçabilité. Quelle décision est mise en œuvre ?
Avant de lire le moindre code, répondez à une question : à quelle décision ou à quelle preuve ce changement se rattache-t-il ?
Un changement doit pointer vers un élément précis : un enregistrement de décision, un insight client, une opportunité, une expérimentation. Si vous ne pouvez pas le nommer en une phrase, arrêtez-vous. Soit le travail n’a jamais été justifié, soit la justification est dans la tête de quelqu’un et l’agent ne l’a jamais vue.
Dans Specky, c’est à cela que sert le Product Graph. Décisions, insights et tickets sont des nœuds liés, de sorte qu’une exécution d’agent peut récupérer le contexte environnant avant de planifier quoi que ce soit. Le premier contrôle du relecteur consiste simplement à vérifier que ce lien existe et que la preuve citée dit bien ce que le changement affirme.
Si le brief lui-même provient d’un brouillon d’IA, vérifiez ses preuves avant de vérifier le code par rapport à lui. Notre Claim Trace pour les specs rédigées par IA prend environ 15 minutes.
Condition de validation : une décision ou un insight, nommé, dont la preuve est accessible en deux clics.
Échelon 2 : Contrat. A-t-il construit ce que disait le brief, et seulement cela ?
Comparez maintenant le changement au brief écrit, ligne par ligne. Pas « est-ce que ça paraît juste », mais un diff littéral entre les critères d’acceptation et le comportement observé.
Faites deux passes :
Passe de couverture. Pour chaque critère d’acceptation du brief, trouvez le comportement qui le satisfait. Marquez chacun comme satisfait, partiellement satisfait ou manquant.
Passe de surplus. Listez les comportements que le changement introduit et qu’aucun critère n’a demandés. Les agents ajoutent souvent des extras utiles : un nouveau paramètre, une colonne supplémentaire, un chemin de repli. Chacun est un périmètre non relu. Gardez-le ou supprimez-le délibérément.
La passe de surplus est celle que les équipes sautent, et c’est là que le travail d’un agent diffère le plus de celui d’un humain. D’après notre expérience, une personne a tendance à construire trop peu par rapport à un brief, et un agent trop.
Condition de validation : chaque critère marqué comme satisfait, chaque élément en surplus explicitement conservé ou retiré.
Échelon 3 : Cas limites. Que se passe-t-il quand l’entrée est erronée, vide ou hostile ?
Les agents sont forts sur le chemin nominal parce que c’est ce que décrivent les prompts. L’échelon trois va là où les prompts vont rarement. Écrivez cinq situations et essayez-les une à une :
État vide : pas encore de données.
État d’erreur : l’appel en amont échoue.
Limite : l’entrée réaliste la plus grande et la plus petite.
Permission : un utilisateur qui ne devrait pas voir cela essaie de le faire.
Répétition : l’action s’exécute deux fois de suite.
Il ne vous faut pas une QA exhaustive. Il vous faut les cinq situations qu’un vrai client rencontrera dans la première semaine. Si le brief n’a pas précisé de comportement pour elles, c’est un défaut du brief, et la correction va dans le brief, pas seulement dans le code.
Le contrôle des permissions compte davantage avec du code généré par IA. Veracode a testé plus de 100 modèles de langage en 2025 et constaté que 45 % des échantillons de code générés échouaient aux tests de sécurité, Java affichant un taux d’échec de 72 % et 86 % des échantillons concernés ne se défendant pas contre le cross-site scripting (Veracode, 2025). Un PM ne peut pas auditer cela, mais il peut exiger que « un utilisateur sans accès essaie de voir ceci » soit un critère écrit et testé, et que des outils de sécurité s’exécutent sur chaque changement d’agent.
Condition de validation : les cinq situations se comportent d’une façon que vous défendriez devant un client.
Échelon 4 : Preuve du résultat. Comment saurons-nous que cela a fonctionné ?
Un changement peut passer les trois premiers échelons et rester inutile. Le dernier échelon demande ce que vous allez mesurer et quand vous regarderez.
Écrivez le contrôle avant la mise en production : la métrique ou le signal, le sens attendu et une date. « On verra bien comment ça se passe » n’est pas un contrôle. C’est aussi ici que l’on filtre le battage : une fonctionnalité livrée vite mais sans contrôle de résultat est un pari avec une date de déploiement.
Condition de validation : un signal nommé, un sens attendu et une date au calendrier pour le lire.
Checklist d’acceptation du code généré par IA à copier
Collez ceci dans le modèle de pull request ou dans le ticket. Un bloc par changement produit par un agent.
CHECKLIST D’ACCEPTATION : [changement / lien PR]
Relecteur : [nom]   Date : [date]

ÉCHELON 1 TRAÇABILITÉ
[ ] Décision ou insight mis en œuvre : [lien]
[ ] La preuve est accessible en deux clics et dit ce que le brief affirme

ÉCHELON 2 CONTRAT
Couverture (une ligne par critère d’acceptation) :
  [critère 1]  satisfait / partiel / manquant
  [critère 2]  satisfait / partiel / manquant
Surplus (comportement qu’aucun critère n’a demandé) :
  [élément]  conserver (critère ajouté) / retirer (ticket séparé)

ÉCHELON 3 CAS LIMITES
[ ] État vide        [ ] État d’erreur      [ ] Entrée limite
[ ] Permission       [ ] Action répétée
Défauts du brief trouvés (à ajouter au brief, pas seulement au code) : [liste]

ÉCHELON 4 RÉSULTAT
Signal : [métrique]   Sens attendu : [hausse/baisse]   Lecture le : [date]

INGÉNIERIE (pas la décision du PM, mais vérifiez que c’est fait)
[ ] Revue de code faite   [ ] Tests ajoutés/mis à jour   [ ] Contrôles de sécurité exécutés

RÉSULTAT : accepter / renvoyer avec modifications du brief
À quoi ressemble la checklist sur un vrai changement ?
Supposons que votre équipe ait demandé à un agent d’ajouter une action « archiver en masse » à une boîte de réception de retours.
Échelon 1. Le brief renvoie vers un insight : le support passe du temps à nettoyer des éléments périmés, et trois conversations clients le mentionnent. La preuve est accessible. Validé.
Échelon 2. La passe de couverture trouve les quatre critères satisfaits. La passe de surplus constate que l’agent a aussi ajouté une notification « annuler » et un nouvel onglet de filtre « archivés ». L’annulation vaut la peine d’être gardée et reçoit un critère rétroactivement. L’onglet de filtre modifie la navigation et n’était pas demandé : il est donc retiré et consigné comme opportunité distincte. Validé après une modification.
Échelon 3. L’état vide affiche un panneau blanc sans explication. Échec. La correction va dans le brief comme critère manquant, puis retourne à l’agent.
Échelon 4. Le signal est le temps médian pour vider la boîte, attendu à la baisse, lu dans deux semaines.
La revue a produit un échec et deux modifications, repérés avant la mise en production. Une revue « ça a l’air bien » aurait livré ensemble le panneau blanc et l’onglet de navigation non demandé.
Une fois remplie dans la checklist, la ligne de résultat se lit : 4 critères sur 4 satisfaits, 2 éléments en surplus (1 conservé, 1 retiré), 1 cas limite sur 5 en échec, lecture du résultat programmée au jour 14. Renvoyer avec une modification du brief.
Comment rédiger des critères d’acceptation qu’un agent ne peut pas mal interpréter ?
La Ladder ne vaut que ce que valent les critères de l’échelon deux. Atlassian définit les critères d’acceptation comme les conditions qu’un travail doit remplir pour être terminé, et énumère les qualités des bons critères : clairs, testables, centrés sur le résultat plutôt que sur la méthode, mesurables quand c’est possible et indépendants les uns des autres (Atlassian). Pour les agents, « testable » compte le plus : un critère qu’un agent ne peut pas vérifier est un critère qu’il va interpréter.
Given-When-Then, élaboré par Daniel Terhorst-North et Chris Matts dans le cadre du behaviour-driven development, est une bonne forme pour cela (Fowler, 2013). Given est l’état initial, When l’action, Then le changement attendu.
Vague (l’agent devinera)
Testable (l’agent peut vérifier)
L’archivage fonctionne bien
Given 3 éléments sélectionnés, when l’utilisateur clique sur Archiver, then les 3 disparaissent de la liste de la boîte de réception en moins d’1 seconde
Gérer les états vides
Given aucun élément dans la boîte de réception, when la page se charge, then afficher « Rien à examiner » et un lien vers les paramètres
Seuls les admins peuvent archiver
Given un utilisateur au rôle Viewer, when il ouvre la boîte de réception, then le bouton Archiver n’est pas affiché et l’API renvoie 403
Rends-le rapide
Given 500 éléments, when l’utilisateur tout sélectionne et archive, then l’action se termine en moins de 3 secondes
Ne casse rien
Given un élément archivé, when l’utilisateur ouvre son lien direct, then il s’ouvre en lecture seule avec une étiquette « Archivé »
La Ladder fonctionne mieux quand une partie n’est pas manuelle. Deux mesures pratiques :
Validez le plan avant que l’agent n’écrive du code. Specky l’expose via son serveur MCP pour agents de code : un agent appelle validate_agent_plan par rapport à vos standards d’ingénierie avant de commencer, et validate_agent_change avant de signaler un succès. Cela avance l’échelon deux, de sorte que le plan est vérifié par rapport aux règles tant qu’il est encore peu coûteux à modifier.
Gardez les preuves attachées. Quand la décision, le brief, l’exécution de l’agent et le contrôle du résultat sont tous des nœuds d’un même graphe, l’échelon un cesse d’être une chasse. Le relecteur ouvre le changement et la raison est déjà à côté.
Appliquer la Ladder dans une petite équipe
Vous n’avez pas besoin d’un comité de revue. Pour un fondateur solo ou une équipe de trois à dix personnes, la Ladder est une habitude de cinq minutes par changement, et l’ordre compte plus que le cérémonial.
Commencez par écrire les critères d’acceptation comme de courtes phrases vérifiables dans le brief lui-même, par exemple « les éléments archivés disparaissent de la liste de la boîte de réception » plutôt que « l’archivage fonctionne bien ». Ce sont ces phrases qui rendent la passe de couverture mécanique plutôt qu’une affaire de goût. Ensuite, tenez à jour une liste permanente de vos cinq situations limites pour ne pas réinventer l’échelon trois à chaque fois. Enfin, faites du contrôle du résultat une partie de la definition of done : si le changement n’a ni signal ni date, il n’est pas prêt à être fusionné.
Quand un changement échoue à un échelon, résistez à l’envie de le rafistoler dans le fil de revue. Renvoyez-le avec le critère manquant ajouté au brief. Le brief est l’artefact durable ; le fil disparaît. Au bout d’un mois, vos briefs gagnent en précision et votre taux d’échec aux échelons deux et trois baisse, ce qui est le vrai bénéfice.
Que mesurer sur votre propre processus de revue
Traitez la Ladder comme un processus que vous pouvez inspecter :
Répartition des échecs par échelon. Si la plupart des échecs tombent à l’échelon deux, vos briefs sont le problème. S’ils tombent à l’échelon trois, vos prompts sautent les cas limites.
Taux de surplus. À quelle fréquence un agent ajoute-t-il un périmètre non demandé ? Un taux en hausse signifie que vos briefs laissent trop de marge.
Taux de réalisation du contrôle de résultat. Combien de changements livrés ont eu leur lecture d’échelon quatre à la date fixée ? C’est le chiffre qui montre si vous apprenez ou si vous ne faites que livrer.
Il n’est pas nécessaire d’avoir un tableau de bord pour cela. Un tableau avec une ligne par changement examiné suffit le premier mois.
Quand cette checklist ne fonctionne-t-elle pas ?
Ce n’est pas une revue de code ni de sécurité. La Ladder vérifie l’intention et le comportement. Comme 39 % des développeurs déclarent peu ou pas de confiance dans le code généré par IA dans l’enquête DORA 2024, la revue d’ingénierie et les contrôles automatisés restent obligatoires (DORA, 2024).
C’est excessif pour les changements triviaux. Une correction de texte ou un changement de couleur demande l’échelon deux au plus. Gardez la Ladder complète pour tout ce qu’un client utilisera ou qui touche aux données ou aux permissions.
Elle ne peut pas sauver une mauvaise décision. L’échelon un vérifie qu’une décision existe, pas qu’elle était juste. Si le problème sous-jacent est flou, revenez à un énoncé de problème avant de relire davantage de code.
Elle dépend de la lecture effective du résultat. Pour les fonctionnalités d’IA en particulier, dont la sortie varie elle-même, associez l’échelon quatre à un cadre d’évaluation de l’IA plutôt qu’à une seule métrique.
Questions fréquentes
Qu’est-ce qu’une checklist d’acceptation du code généré par IA ?
C’est une courte liste de contrôles produit effectués avant qu’un changement produit par un agent soit considéré comme terminé : quelle décision il met en œuvre, s’il correspond au brief et rien de plus, comment il se comporte dans cinq situations limites et comment vous saurez qu’il a fonctionné. Elle s’ajoute à la revue de code, elle ne la remplace pas.
Les product managers doivent-ils relire le code écrit par des agents d’IA ?
Les PM doivent examiner le comportement, pas le style du code. Lisez le brief face à ce que fait le changement, exécutez les cas limites dans une prévisualisation et vérifiez le plan de résultat. Laissez la conception, les tests et la sécurité aux ingénieurs et aux outils. Dans une équipe solo, faites les deux, mais en passes séparées.
Combien de temps dure une revue d’acceptation ?
Pour un changement typique de la taille d’une fonctionnalité, environ cinq minutes dès lors que vos briefs contiennent des critères testables et que vous tenez une liste permanente de cas limites. Les premières revues prennent plus de temps parce qu’elles révèlent des critères manquants. Ce temps se déplace vers la rédaction de meilleurs briefs au lieu de disparaître.
Quelle est la différence entre critères d’acceptation et definition of done ?
Les critères d’acceptation sont propres à un changement : ce que cette fonctionnalité doit faire. Une definition of done s’applique à chaque changement : code relu, tests réussis, contrôles de sécurité exécutés, contrôle du résultat planifié. Atlassian note que les deux termes sont parfois employés indifféremment, mais les distinguer facilite les revues d’agents.
Pourquoi les agents d’IA ajoutent-ils des fonctionnalités que personne n’a demandées ?
Les agents comblent les lacunes du brief par un comportement plausible, et des extras comme des boutons d’annulation, des filtres ou des paramètres sont plausibles. Certains sont utiles. Le problème est que chacun est un périmètre non relu. La passe de surplus de l’échelon deux vous oblige à garder ou retirer chaque extra en connaissance de cause, et à ajouter un critère pour tout ce que vous gardez.
Un agent d’IA peut-il vérifier son propre travail par rapport aux critères d’acceptation ?
En partie. Les agents peuvent exécuter des tests et comparer le comportement aux critères écrits, et les outils qui valident un plan avant le codage repèrent les erreurs tôt. Mais les agents décrivent leur propre travail avec aisance, et l’aisance n’est pas une preuve. Une personne exécute toujours l’échelon un (est-ce la bonne décision ?) et l’échelon quatre (cela a-t-il aidé les utilisateurs ?).
GDPR-aligned. EU workspace data is stored in Frankfurt, Germany. GDPR and EU data Built in Vienna, Austria. A product of influence solutions fm GmbH (FN 675374y). Imprint 14-day trial. Card required, and nothing is charged until day 14. 30-day refund after subscribing. See pricing