9 novembre 2026Mis à jour le Fathy Shalaby12 min de lecture
Modèle de plan de test A/B : tester un seul changement, nommer la métrique
La plupart des tests A/B échouent avant même de commencer. Changez une seule chose, nommez d'abord la métrique, calculez la taille d'échantillon et ne regardez pas les résultats en cours de route.
Un modèle de plan de test A/B est un plan d'une page que vous remplissez avant un test A/B : le changement unique, la métrique principale, une métrique garde-fou, la taille d'échantillon et la date de fin. Un test A/B montre ensuite ce changement à une part aléatoire du trafic réel et compare la métrique que vous avez nommée avant son démarrage. Rédigez le plan d'abord, car la plupart des tests A/B échouent avant le lancement.
L'essentiel
La plupart des idées perdent. Le taux de réussite des idées chez Bing était d'environ 10 à 20 %, et les gagnantes faisaient bouger les métriques clés de 0,1 % à 1,0 % (Kohavi et al., KDD 2014).
Calculez la taille d'échantillon avant de commencer. Avec un taux de conversion de 12 %, détecter une hausse relative de 10 % demande environ 11 700 utilisateurs par version, avec 95 % de confiance et 80 % de puissance (calculateur d'Evan Miller).
Ne jetez pas de coups d'œil. Tester après chaque visiteur et s'arrêter au premier résultat « significatif » fait passer le taux de faux positifs de 5 % à 26,1 % (Evan Miller, 2010).
Nommez un garde-fou, une métrique qui ne doit pas se dégrader.
Qu'est-ce qu'un test A/B ?
Un test A/B change une seule chose pour une part de votre trafic réel et compare une métrique que vous avez nommée avant le début du test.
C'est la même chose qu'un split test : la version A est l'original (le groupe de contrôle), la version B comporte le changement, et les personnes sont assignées au hasard. Comme le changement est la seule différence systématique, un écart net sur la métrique renvoie au changement.
Dans Testing Business Ideas de David J. Bland et Alex Osterwalder, le test A/B est une expérience de validation de type « appel à l'action », au même titre que le test de landing page et la prévente. L'affiche de Strategyzer le note 2 sur 5 pour le coût, 3 sur 5 pour la durée d'exécution et 3 sur 5 pour la force de la preuve (bibliothèque d'expériences Strategyzer).
Utilisez-le quand vous avez assez de trafic et que vous voulez savoir si un changement précis a causé un résultat. C'est la façon la plus fiable d'y répondre. Il peut aussi vous surprendre. Dans leur article de 2017 dans la Harvard Business Review, Ron Kohavi et Stefan Thomke racontent l'histoire d'un petit changement dans l'affichage des titres d'annonces chez Bing, qui a produit des résultats si forts qu'ils ont déclenché une alerte interne pour être trop beaux pour être vrais. L'idée dormait dans le backlog depuis plus de six mois. Elle a augmenté le chiffre d'affaires de 12 %, soit plus de 100 millions de dollars par an rien qu'aux États-Unis.
Cette histoire est l'exception. Dans un article de 2014, Kohavi et ses collègues écrivaient que la plupart des expériences de Bing échouent, et que des résultats exceptionnellement forts appellent la loi de Twyman : « Any figure that looks interesting or different is usually wrong! »
Ne l'utilisez pas avec peu de trafic. Si vous aviez besoin de plusieurs mois pour toucher assez de monde, préférez un test d'utilisabilité ou des entretiens. Ne l'utilisez pas pour explorer. Il compare seulement des options que vous avez déjà. Pour aller plus loin, lisez notre guide plus complet du test A/B pour les product managers.
Quel risque teste-t-il, et quelle est la force de la preuve ?
Il teste la désirabilité : cette version pousse-t-elle les gens à faire davantage ce que vous voulez ? La preuve est un comportement, celui de vraies personnes qui ne savent pas qu'elles participent à un test. Il mesure ce qui se passe pendant la durée du test, et peut donc passer à côté d'effets à long terme. Voyez notre guide pour choisir une expérience produit.
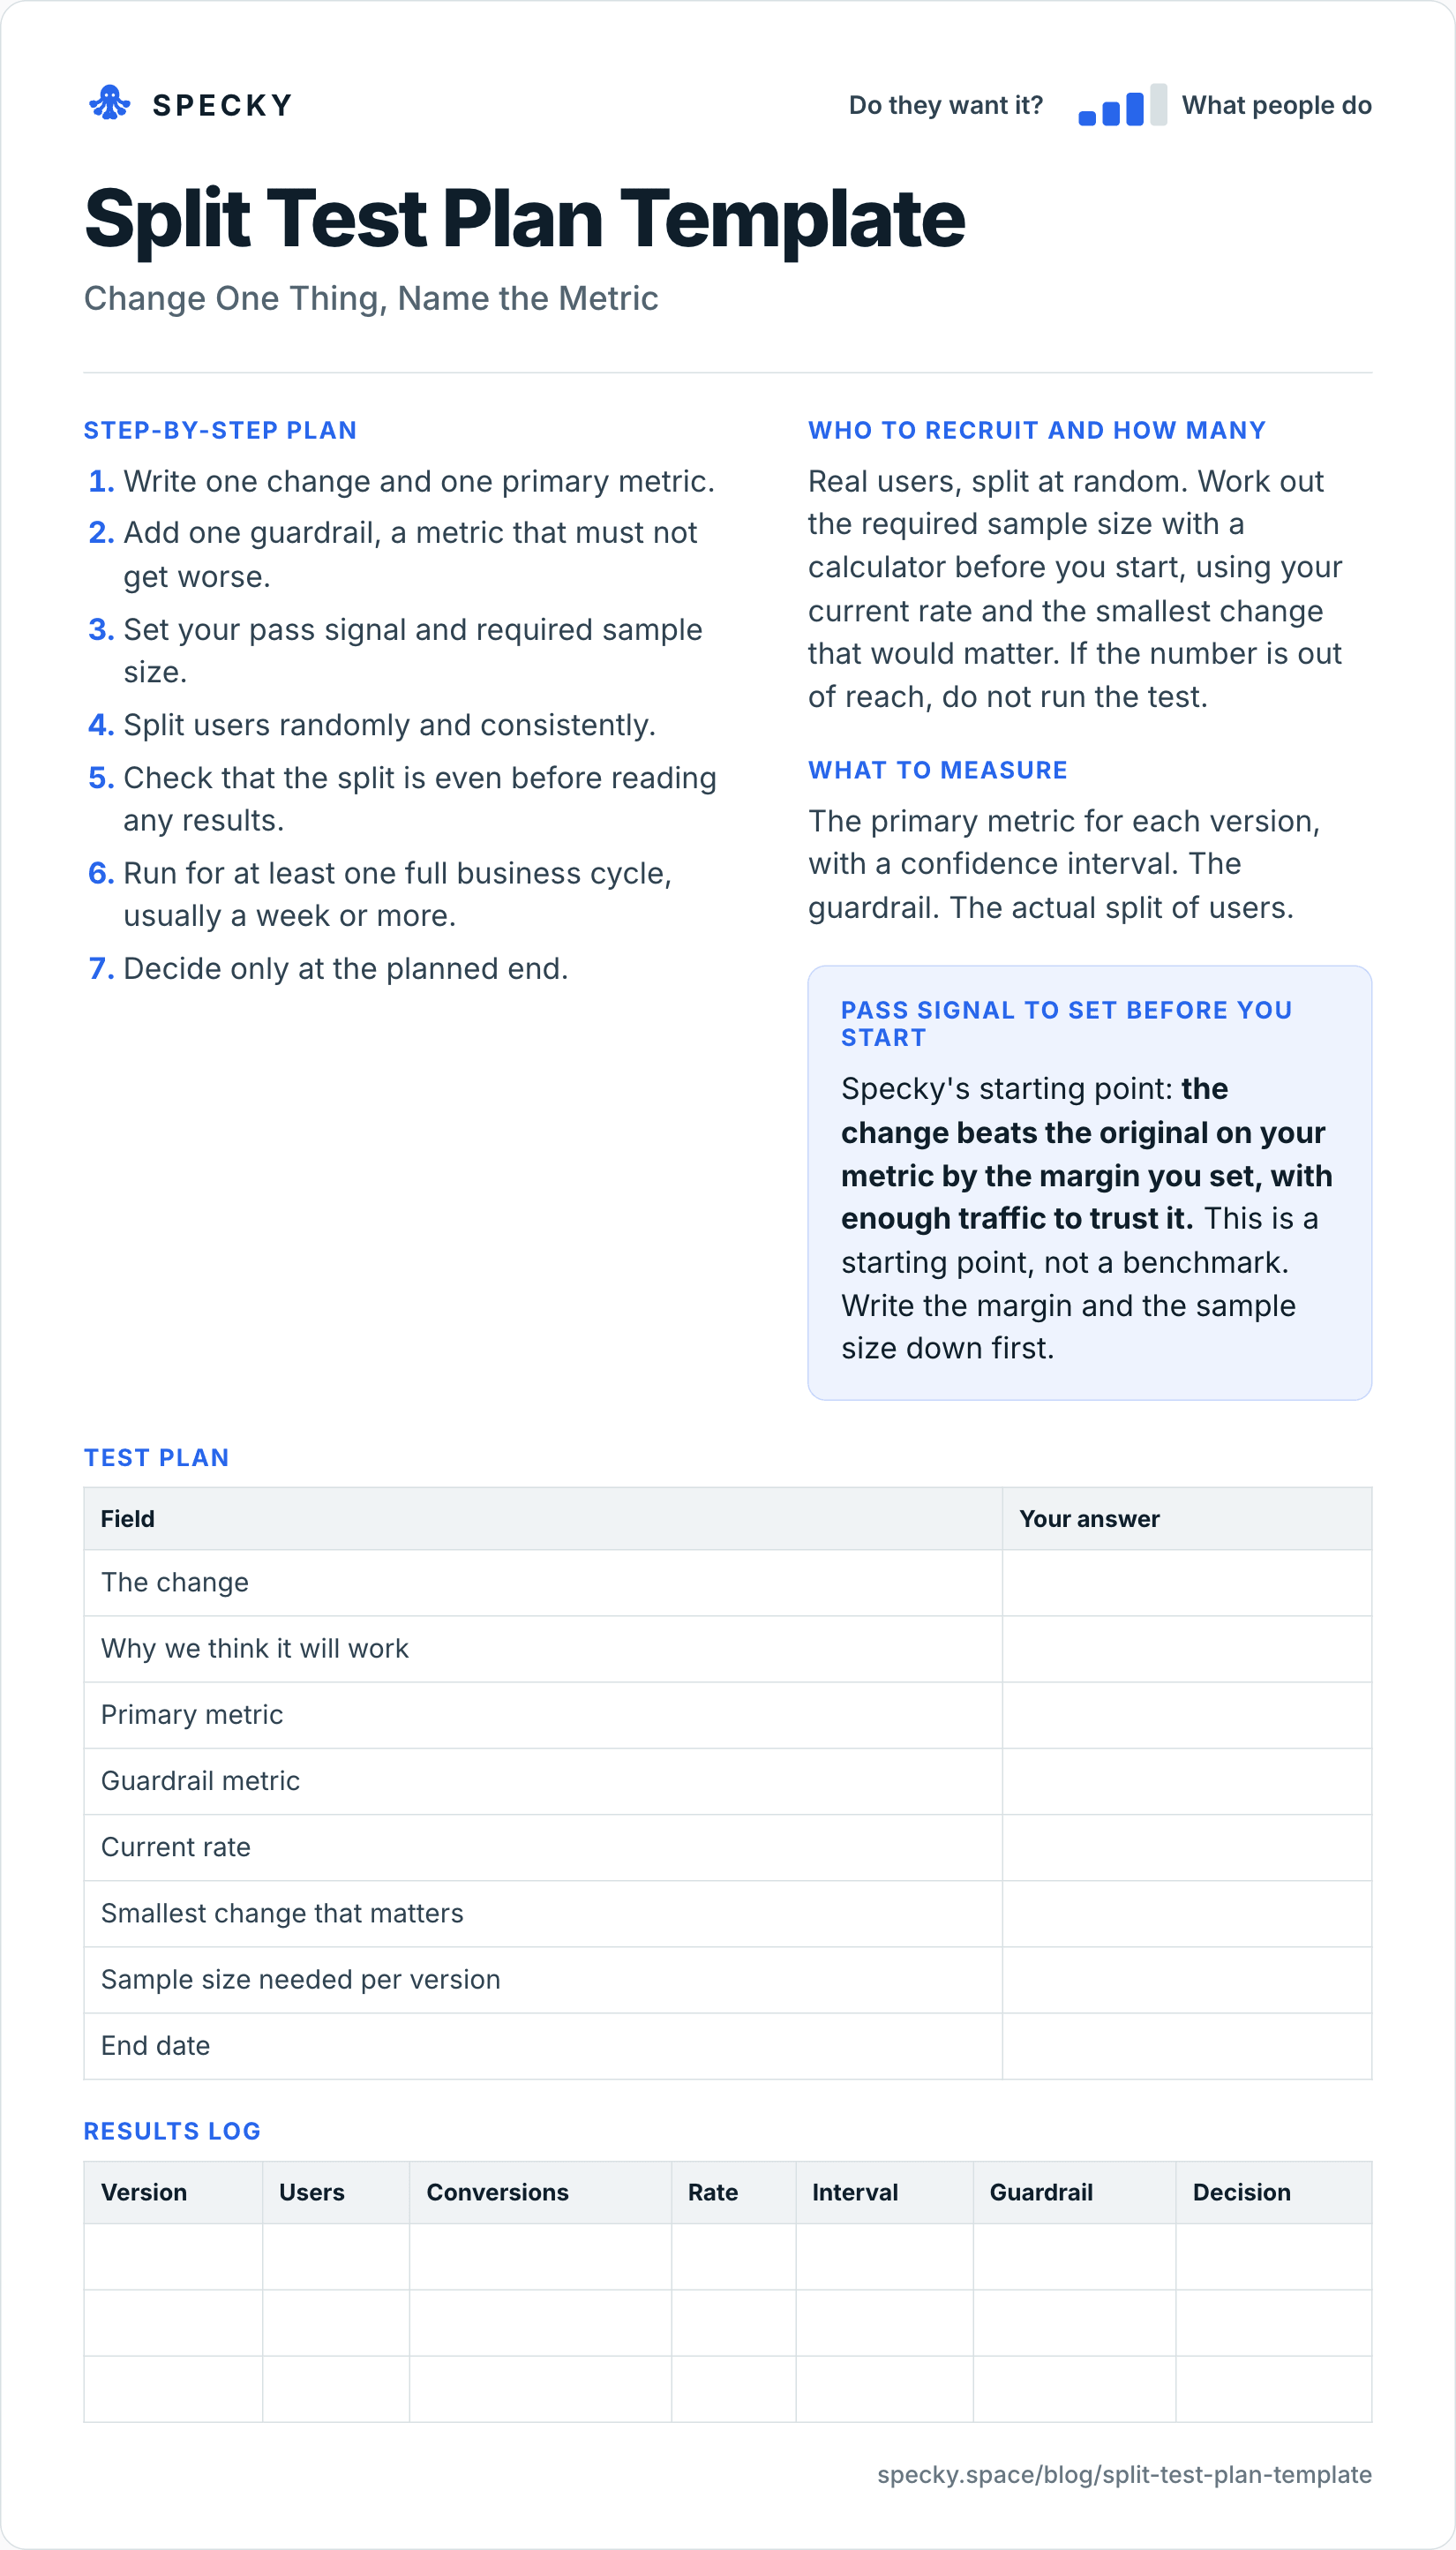
Modèle de plan de test A/B (à copier et utiliser)
Ouvrez l'image en taille réelle, ou copiez la version texte ci-dessous.
Qui recruter et combien
De vrais utilisateurs, répartis au hasard. Calculez la taille d'échantillon requise avec un calculateur avant de commencer, à partir de votre taux actuel et du plus petit changement qui compterait. Si le nombre est hors de portée, ne lancez pas le test.
Plan étape par étape
Écrivez un seul changement et une seule métrique principale.
Ajoutez un garde-fou, une métrique qui ne doit pas se dégrader.
Fixez votre signal de réussite et la taille d'échantillon requise.
Répartissez les utilisateurs au hasard et de façon cohérente.
Vérifiez que la répartition est équilibrée avant de lire le moindre résultat.
Laissez tourner au moins un cycle d'activité complet, en général une semaine ou plus.
Ne décidez qu'à la fin prévue.
Plan de test
Champ
Votre réponse
Le changement
Pourquoi nous pensons que cela marchera
Métrique principale
Métrique garde-fou
Taux actuel
Plus petit changement qui compte
Taille d'échantillon nécessaire par version
Date de fin
Quoi mesurer
La métrique principale de chaque version, avec un intervalle de confiance. Le garde-fou. La répartition réelle des utilisateurs.
Signal de réussite à fixer avant de commencer
Point de départ de Specky : le changement bat l'original sur votre métrique de la marge que vous avez fixée, avec assez de trafic pour s'y fier. C'est un point de départ, pas un benchmark. Écrivez d'abord la marge et la taille d'échantillon.
Journal des résultats
Version
Utilisateurs
Conversions
Taux
Intervalle
Garde-fou
Décision
De combien d'utilisateurs avez-vous besoin pour un test A/B ?
Cela dépend de votre taux de conversion actuel et du plus petit changement qui vaut la peine d'être détecté, l'effet minimal détectable. Plus l'un ou l'autre est petit, plus il faut de trafic. Avec la formule bilatérale du calculateur gratuit d'Evan Miller, à son niveau standard de 5 % de signification et 80 % de puissance, voici l'échantillon nécessaire par version :
Taux de conversion actuel
Pour détecter une hausse relative de 5 %
Hausse relative de 10 %
Hausse relative de 20 %
2 %
environ 310 000
environ 78 000
environ 19 800
5 %
environ 120 000
environ 30 200
environ 7 700
12 %
environ 46 300
environ 11 700
environ 2 900
20 %
environ 25 300
environ 6 300
environ 1 600
Diviser par deux l'effet à détecter multiplie à peu près par quatre le trafic nécessaire, et les taux de base faibles exigent bien plus de monde que les taux élevés.
Pour vérifier sans calculateur, utilisez la règle empirique d'Evan Miller : n = 16σ² / δ², où δ est l'effet minimal et, pour un taux de conversion p, σ² = p(1 − p). À 12 % et pour une hausse à 13,2 % : 16 × 0,12 × 0,88 ÷ 0,012² ≈ 11 700 par version.
Exemple détaillé : de la taille d'échantillon à la date de fin
Cet exemple est illustratif ; il correspond à l'exemple détaillé plus bas.
Taux actuel : 12 % des visiteurs s'inscrivent.
Plus petit changement qui compte : une hausse relative de 10 %, de 12 % à 13,2 %.
Taille d'échantillon : environ 11 700 par version, donc environ 23 400 visiteurs au total.
Trafic : environ 860 visiteurs par jour atteignent la page d'inscription.
Durée : 23 400 ÷ 860 ≈ 27 jours. Arrondi à des semaines entières : 4 semaines.
Si la réponse avait été six mois, ne lancez pas un test plus petit en espérant. Testez un changement plus important, choisissez une métrique au taux de base plus élevé, ou utilisez une méthode qui demande moins de trafic.
Combien de temps faut-il laisser tourner un test A/B ?
Jusqu'à atteindre la taille d'échantillon prévue, et pendant au moins un cycle d'activité complet, en général une semaine ou plus, car les utilisateurs de la semaine et ceux du week-end se comportent différemment.
Pourquoi ne faut-il pas jeter de coups d'œil aux résultats ?
Les tableaux de bord affichent une valeur p qui suppose que vous ne regardez qu'une fois, à la fin. Chaque regard supplémentaire est une chance de plus pour que le bruit franchisse la ligne. Evan Miller a montré que tester après chaque observation et s'arrêter au premier p < 0,05 donne un taux de faux positifs de 26,1 %, plus de cinq fois les 5 % que vous croyez avoir (Evan Miller, 2010).
Si vous devez absolument regarder plus tôt, relevez la barre : en regardant 10 fois, il vous faut une signification affichée de 1,0 % pour conserver un vrai taux de 5 %.
Pourquoi un résultat « significatif » demande-t-il encore une vérification ?
Kohavi et ses collègues détaillent le calcul. Si une idée sur trois est réellement gagnante, la moyenne qu'ils ont rapportée sur les expériences de Microsoft, un résultat significatif est un vrai positif environ 89 % du temps. Si les vraies percées sont de une sur 500, on tombe à 3,1 %. Les résultats surprenants méritent d'être rejoués.
Que faut-il mesurer dans un test A/B ?
La métrique principale de chaque version, avec un intervalle de confiance, pas seulement un pourcentage.
Une métrique garde-fou qui ne doit pas se dégrader, comme la conversion payante, les remboursements ou le temps de chargement des pages.
La répartition réelle des utilisateurs. Si vous aviez prévu 50/50 et obtenez 52/48 sur de grands nombres, quelque chose cloche. C'est un déséquilibre de ratio d'échantillon (sample ratio mismatch). Le vérifier ne demande que les proportions attendues et les effectifs observés, et cela détecte une grande variété de problèmes de données (vérificateur SRM de Lukas Vermeer et ses collègues). Ne lisez pas les résultats avant qu'il soit passé.
Les garde-fous sur des événements rares demandent beaucoup de trafic : détecter une baisse de 10 % d'une conversion payante de 1,2 % exige environ 130 000 utilisateurs par version. Si vous ne pouvez pas l'atteindre, écrivez à l'avance ce qui constitue une violation, par exemple « toute baisse du nombre de clients payants bloque le lancement ».
Test A/B, test de landing page ou test de fausse porte
Ce changement provoque-t-il plus du comportement que nous voulons ?
Quelqu'un fait-il l'étape suivante pour cette offre ?
Les utilisateurs existants essaient-ils d'utiliser une fonctionnalité qui n'est pas encore développée ?
Comparaison
Contrôle contre variante, au hasard
En général une page contre une cible
Un bouton contre une cible
Preuve
Causale, comportementale
Intérêt comportemental
Intérêt comportemental
Utilisez un test de landing page ou de fausse porte pour savoir s'il y a un intérêt, quel qu'il soit ; utilisez un test A/B pour savoir laquelle de deux versions fait mieux.
À quoi ressemble un test A/B en pratique ?
Cet exemple est inventé pour montrer la méthode. Une équipe qui exploite un outil de déclaration d'impôts veut raccourcir son formulaire d'inscription de six champs à trois. Elle prédit que les inscriptions augmenteront d'au moins 10 % et retient la conversion payante comme garde-fou.
Après quatre semaines et 12 000 visiteurs dans chaque groupe, le formulaire plus court augmente les inscriptions de 14 %. Mais la conversion payante baisse, et le garde-fou est franchi : les inscriptions supplémentaires viennent de personnes à l'intention plus faible, qui ne vont jamais au bout.
L'objectif d'inscription est atteint et le garde-fou échoue, donc l'équipe ne le déploie pas tel quel. Elle essaie un formulaire plus court avec une question supplémentaire sur le type de déclaration du client.
Voici à quoi le journal pourrait ressembler :
Version
Utilisateurs
Inscriptions
Taux
Clients payants
Décision
Six champs (contrôle)
12 000
1 440
12,0 %
144
Trois champs
12 000
1 642
13,7 %
131
Ne pas déployer
La hausse des inscriptions est réelle : +1,7 point de pourcentage, avec un intervalle à 95 % d'environ +0,8 à +2,5. La baisse des payants, de 144 à 131 clients, est trop faible pour être prouvée avec ce trafic, mais la règle de garde-fou rédigée d'avance par l'équipe disait que moins de clients payants bloquait la mise en production.
Quelles sont les erreurs les plus courantes en test A/B ?
Jeter des coups d'œil. Vérifier tôt et s'arrêter quand ça a l'air bon produit de fausses victoires.
Changer plusieurs choses. Vous ne saurez pas laquelle a fonctionné.
Aucun garde-fou. On peut gagner une métrique et perdre l'entreprise.
Trop peu de trafic. Un test sous-dimensionné n'est que du bruit coûteux.
Ignorer l'effet de nouveauté. Les gens cliquent sur ce qui est nouveau simplement parce que c'est nouveau.
Quand cela ne marche pas : avec peu de trafic, pour les gros paris qui ne peuvent pas être divisés, pour les effets qui prennent des mois, et quand les utilisateurs se parlent entre eux, de sorte que les groupes ne sont pas indépendants.
Est-il éthique de mener un test A/B sans prévenir les utilisateurs ?
Les changements ordinaires, comme un formulaire plus court ou un nouveau titre, sont couramment testés sans prévenir chaque utilisateur. La limite, c'est le préjudice. Ne testez rien que vous ne seriez pas à l'aise de déployer pour tout le monde, n'affichez pas des prix différents à des clients similaires sans politique claire, et ne comptez que les personnes que votre bandeau de consentement vous autorise à suivre.
Comment le réaliser dans Specky
Sur la page Assumptions, cliquez sur la note et choisissez Pick a test, puis Split test. Specky remplit les étapes, le signal de réussite et un calendrier de deux semaines.
Pour un changement dans votre produit, faites la répartition avec votre propre outil de feature flags ou d'expérimentation. Specky ne modifie pas votre produit. Il lit les chiffres depuis les outils d'analytics connectés, et vous joignez le résultat comme preuve.
Si vous testez une page de validation Specky, la répartition peut s'y faire. Configurez un contrôle et jusqu'à cinq variantes dans Experiment analytics, et Specky affiche la conversion par version, les intervalles à 95 %, si vous avez assez de monde et, en option, un garde-fou. Le verdict reste prudent tant que l'échantillon est petit.
Cliquez sur Start running, puis consignez le résultat à la fin prévue.
Une réussite s'affiche sur le tableau comme Supported, car une comparaison contrôlée de ce que les gens ont fait relève du comportement.
Que faire de chaque résultat ?
Supported : déployez le changement. Notez l'ampleur du gain et revérifiez les analytics dans un mois pour voir si l'effet dure.
Unclear : le résultat est dans la marge d'erreur. Gardez la version la plus simple, ou allez comprendre pourquoi avec quelques entretiens.
Contradicted : le changement n'a eu aucun effet, ou a empiré les choses. Ne le déployez pas. Tout pari reposant sur cette note s'affiche désormais comme Contradicted.
Questions fréquentes
De combien de trafic avez-vous besoin pour un test A/B ?
Cela dépend de votre taux de conversion actuel et du plus petit changement qui compterait. Avec un taux de conversion de 12 %, détecter une hausse relative de 10 % demande environ 11 700 utilisateurs par version avec les réglages standard ; à 2 %, environ 78 000. Si vous ne pouvez pas atteindre ce nombre dans un délai raisonnable, utilisez une autre méthode.
Pourquoi ne faut-il pas arrêter un test A/B trop tôt ?
S'arrêter quand les résultats ont l'air bons rend les fausses victoires bien plus probables, car les résultats oscillent beaucoup au début. Dans le pire cas décrit par Evan Miller, tester après chaque visiteur donne un taux de faux positifs de 26,1 % au lieu de 5 %. Décidez à l'avance de la date de fin et de la taille d'échantillon.
Qu'est-ce qu'une métrique garde-fou ?
Une métrique garde-fou est un chiffre qui ne doit pas se dégrader pendant un test, même si votre métrique principale s'améliore, comme la conversion payante, les remboursements ou la vitesse des pages. Elle vous évite de gagner sur une métrique tout en nuisant à l'entreprise. Écrivez la règle de ce qui constitue une violation avant le début du test.
Quelle est la différence entre un split test et un test A/B ?
Aucune en pratique. Les deux montrent un changement à une part aléatoire d'utilisateurs et comparent une métrique à un groupe de contrôle ; les chercheurs parlent d'expérience contrôlée en ligne. Tester plusieurs changements combinés s'appelle un test multivarié, qui exige beaucoup plus de trafic.
GDPR-aligned. EU workspace data is stored in Frankfurt, Germany. GDPR and EU data Built in Vienna, Austria. A product of influence solutions fm GmbH (FN 675374y). Imprint 14-day trial. Card required, and nothing is charged until day 14. 30-day refund after subscribing. See pricing