10 ottobre 2026Aggiornato il Fathy Shalaby15 min di lettura
Checklist di accettazione per il codice generato dall'IA: la guida di revisione per i PM
Costruire è diventato economico; accettare il risultato no. L'Acceptance Ladder a quattro gradini aiuta i PM a rivedere le modifiche realizzate dagli agenti rispetto a decisione, brief, casi limite e risultato.
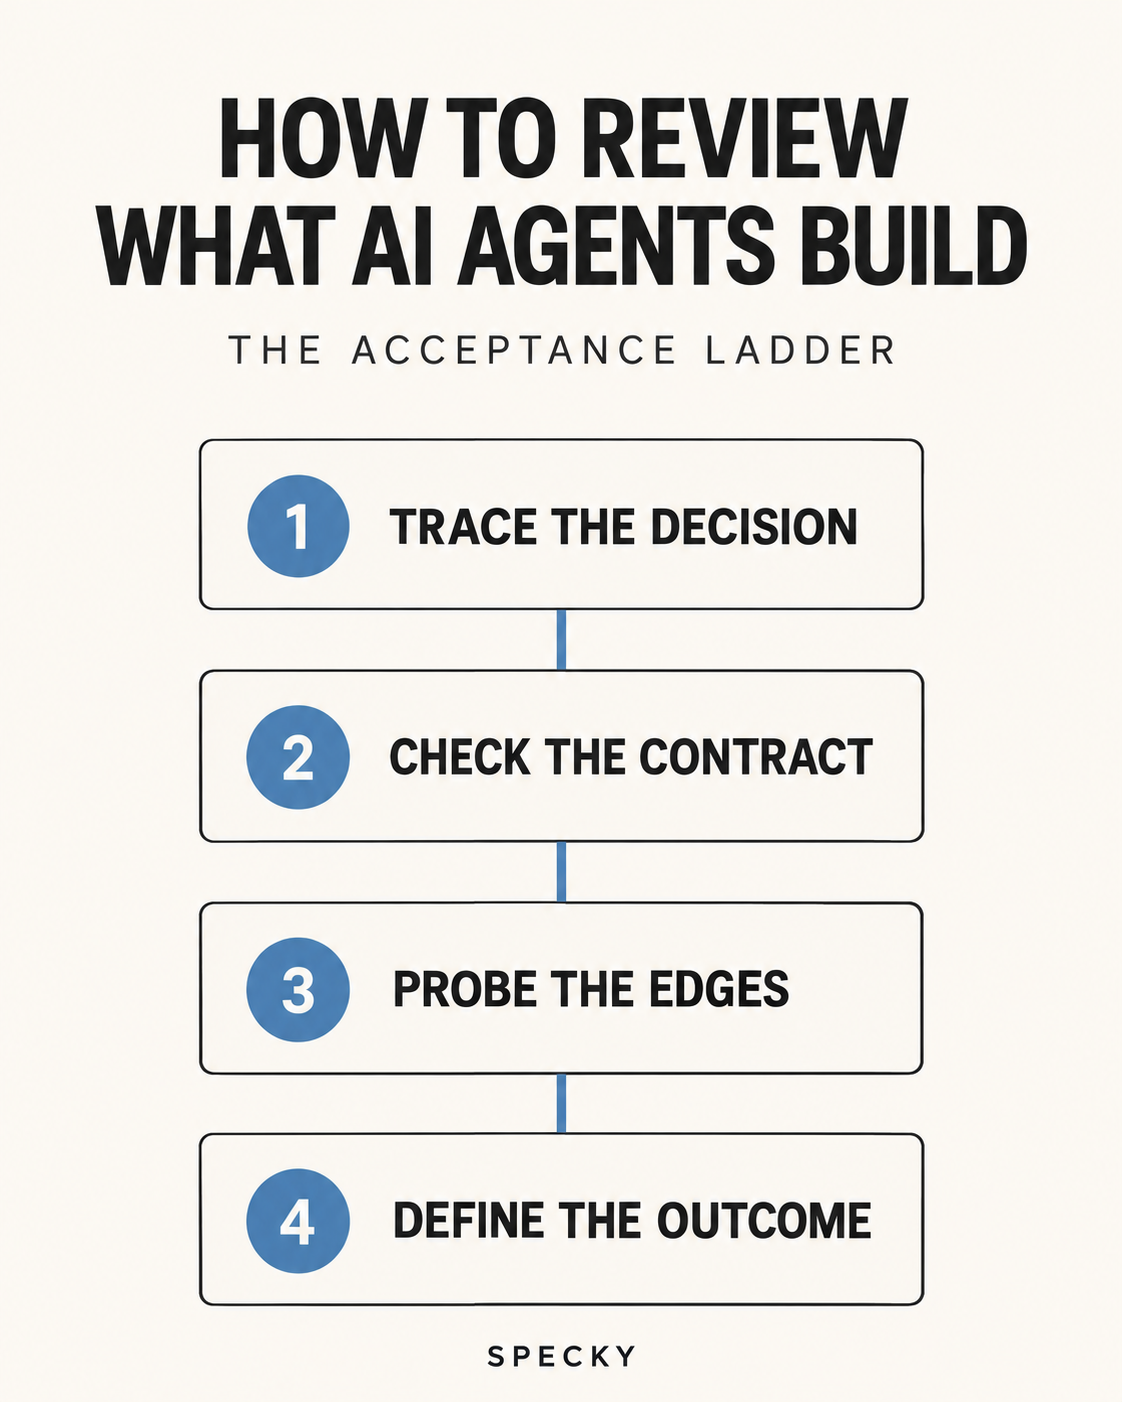
Una checklist di accettazione per il codice generato dall'IA è il breve elenco di controlli che un product manager esegue prima che una modifica realizzata da un agente conti come completata. Gli ingegneri rivedono come è scritto il codice; il PM verifica se è la modifica giusta. Usiamo quattro gradini, in ordine: ricondurla a una decisione, confrontarla con il brief, mettere alla prova i casi limite e definire come saprai che ha funzionato.
Punti chiave
Anthropic descrive lo sviluppo software come uno spostamento «dallo scrivere codice all'orchestrare agenti che scrivono codice» (Anthropic, 2026). La competenza scarsa si sposta al posto del revisore.
Il 66% degli sviluppatori dice che la frustrazione maggiore con gli strumenti di IA sono soluzioni quasi giuste, ma non del tutto (Stack Overflow, 2025). Le modifiche quasi giuste superano una revisione da «sembra a posto».
Un output scorrevole distorce il giudizio: in uno studio randomizzato, gli sviluppatori credevano che l'IA li avesse resi più veloci del 20% quando li aveva resi più lenti del 19% (METR, 2025).
Gli agenti tendono a costruire troppo. Il passaggio sul surplus (elencare i comportamenti che nessuno ha chiesto) è il controllo che la maggior parte dei team salta.
La checklist non sostituisce la revisione del codice né quella di sicurezza: il 45% degli esempi di codice generati dall'IA in un test del 2025 introduceva vulnerabilità note (Veracode, 2025).
Perché «sembra a posto» è il parametro sbagliato per il codice generato dall'IA?
La maggior parte dei team rivede l'output di un agente come rivedeva una pull request umana: scorrere il diff, cliccare nell'anteprima, approvare. Funziona quando un collega porta con sé il contesto della riunione di pianificazione e delle chiamate con i clienti. Fallisce quando un agente porta solo ciò che il brief ha codificato.
Se il brief era vago, l'agente colma il vuoto con il comportamento statisticamente più plausibile, e plausibile non è la stessa cosa di corretto. La modifica compila, l'anteprima viene visualizzata, il percorso felice funziona e il PM approva. Due settimane dopo qualcuno nota che ha scartato in silenzio un vincolo che nessuno aveva scritto, o che ha risolto un problema adiacente invece di quello del brief. Il codice non aveva nulla di sbagliato. Il passaggio di accettazione semplicemente non ha mai posto le domande giuste.
Tre cose rendono l'output di un agente più difficile da giudicare di quello umano:
Volume. Generare costa poco, quindi ci sono più modifiche candidate a settimana e il tempo di revisione diventa il collo di bottiglia.
Sicurezza di sé. Gli agenti descrivono il proprio lavoro con disinvoltura. Un riepilogo ordinato non è un'evidenza. Lo studio METR del 2025 con 16 sviluppatori esperti e 246 issue reali ha rilevato che gli sviluppatori si aspettavano che l'IA li accelerasse del 24% e, dopo il lavoro, credevano ancora che li avesse accelerati del 20%, mentre il risultato misurato era un rallentamento del 19% (METR, 2025). METR dice ora che quei risultati dei primi mesi del 2025 sono superati, e il suo seguito di febbraio 2026 ha trovato piccoli aumenti di velocità stimati che definisce un segnale inaffidabile (METR, 2026). La lezione che resta è il divario di percezione, non il numero sulla velocità.
Traccia dell'intento mancante. Senza un collegamento dalla modifica alla decisione che implementa, non puoi distinguere «costruito come specificato» da «costruito come dedotto».
I dati sulla consegna vanno nella stessa direzione. La ricerca DORA 2024 di Google ha rilevato che un aumento del 25% nell'adozione dell'IA era associato a una qualità della documentazione migliore del 7,5%, una qualità del codice migliore del 3,4% e una revisione del codice più rapida del 3,1%. Eppure, con l'aumento dell'adozione, i ricercatori hanno stimato anche un calo dell'1,5% nel throughput di consegna e del 7,2% nella stabilità della consegna (DORA, 2024). Il rapporto 2025 lo riassume: l'IA amplifica i punti di forza e di debolezza esistenti di un'organizzazione (DORA, 2025). Un passaggio di accettazione debole è una delle debolezze che amplifica.
Cosa deve controllare un PM e cosa un ingegnere?
Dividi la revisione. Le pratiche di ingegneria di Google elencano cosa cerca un revisore di codice: progettazione, funzionalità, complessità, test, nomi, commenti, stile, coerenza, documentazione e contesto (Google). Gran parte è lavoro di ingegneria. Una domanda dell'elenco appartiene al prodotto: «Is what the developer intended good for the users of this code?»
Domanda
Di chi è
Dove si risponde
Il codice è ben progettato, leggibile e testato?
Ingegnere
Revisione del codice
È sicuro e gestisce correttamente i permessi?
Ingegnere (con strumenti di sicurezza)
Revisione del codice, scanner
Quale decisione o evidenza implementa questa modifica?
PM
Acceptance Ladder, gradino 1
Ha costruito ciò che diceva il brief, e solo quello?
PM
Gradino 2
Si comporta in modo difendibile nei casi vuoto, errore, limite, permessi e ripetizione?
PM e ingegnere insieme
Gradino 3
Come e quando sapremo che ha funzionato per gli utenti?
PM
Gradino 4
In un team con un fondatore solitario, una persona porta entrambi i cappelli. Fai comunque le due revisioni in passaggi separati: leggere il codice per la correttezza e leggere il comportamento per l'intento richiedono attenzioni diverse.
L'Acceptance Ladder: quattro controlli prima che una modifica fatta da un agente sia completata
Ogni gradino pone una domanda. Sali al gradino successivo solo quando quello attuale è superato. Se una modifica si blocca al gradino uno, non perdi tempo sul gradino quattro.
Gradino 1: Tracciabilità. Quale decisione sta implementando?
Prima di leggere qualsiasi codice, rispondi a una domanda: a quale decisione o evidenza risale questa modifica?
Una modifica dovrebbe puntare a un elemento specifico: un record di decisione, un insight dei clienti, un'opportunità, un esperimento. Se non riesci a nominarlo in una frase, fermati. O il lavoro non è mai stato giustificato, o la giustificazione vive nella testa di qualcuno e l'agente non l'ha mai vista.
In Specky, a questo serve il Product Graph. Decisioni, insight e ticket sono nodi collegati, così un'esecuzione dell'agente può recuperare il contesto circostante prima di pianificare qualunque cosa. Il primo controllo del revisore è semplicemente se quel collegamento esiste e se l'evidenza citata dice ciò che la modifica sostiene.
Se il brief stesso proviene da una bozza dell'IA, controlla le sue evidenze prima di verificare il codice rispetto a esso. Il nostro Claim Trace per le spec scritte dall'IA richiede circa 15 minuti.
Condizione di superamento: una decisione o un insight, nominato, con l'evidenza raggiungibile in due clic.
Gradino 2: Contratto. Ha costruito ciò che diceva il brief, e solo quello?
Ora confronta la modifica con il brief scritto, riga per riga. Non «mi sembra giusto», ma un diff letterale tra i criteri di accettazione e il comportamento osservato.
Fai due passaggi:
Passaggio di copertura. Per ogni criterio di accettazione del brief, trova il comportamento che lo soddisfa. Segna ciascuno come soddisfatto, parzialmente soddisfatto o mancante.
Passaggio sul surplus. Elenca i comportamenti che la modifica introduce e che nessun criterio ha chiesto. Gli agenti spesso aggiungono extra utili: un'impostazione nuova, una colonna in più, un percorso di ripiego. Ognuno è un ambito non rivisto. Tienilo o taglialo deliberatamente.
Il passaggio sul surplus è quello che i team saltano, ed è qui che il lavoro di un agente differisce di più da quello di una persona. Nella nostra esperienza, una persona tende a costruire meno di quanto dice il brief, e un agente a costruire di più.
Condizione di superamento: ogni criterio segnato come soddisfatto, ogni elemento in surplus esplicitamente tenuto o rimosso.
Gradino 3: Casi limite. Cosa succede quando l'input è sbagliato, vuoto od ostile?
Gli agenti sono forti sul percorso felice perché è ciò che descrivono i prompt. Il gradino tre va dove i prompt raramente arrivano. Scrivi cinque situazioni e prova ciascuna:
Stato vuoto: ancora nessun dato.
Stato di errore: la chiamata a monte fallisce.
Limite: l'input realistico più grande e più piccolo.
Permessi: un utente che non dovrebbe vederlo ci prova.
Ripetizione: l'azione viene eseguita due volte di fila.
Non ti serve una QA esaustiva. Ti servono le cinque situazioni in cui un cliente reale si imbatterà nella prima settimana. Se il brief non specificava il comportamento per queste, è un difetto del brief, e la correzione va nel brief, non solo nel codice.
Il controllo dei permessi conta di più con il codice generato dall'IA. Veracode ha testato più di 100 modelli linguistici nel 2025 e ha rilevato che il 45% degli esempi di codice generati falliva i test di sicurezza, con Java a un tasso di fallimento del 72% e l'86% degli esempi pertinenti incapace di difendersi dal cross-site scripting (Veracode, 2025). Un PM non può fare l'audit, ma può pretendere che «un utente senza accesso prova a vederlo» sia un criterio scritto e testato e che gli strumenti di sicurezza girino su ogni modifica dell'agente.
Condizione di superamento: tutte e cinque le situazioni si comportano in un modo che difenderesti davanti a un cliente.
Gradino 4: Evidenza del risultato. Come sapremo che ha funzionato?
Una modifica può superare i primi tre gradini ed essere comunque inutile. L'ultimo gradino chiede cosa misurerai e quando guarderai.
Scrivi il controllo prima del rilascio: la metrica o il segnale, la direzione attesa e una data. «Vediamo come va» non è un controllo. È anche qui che si filtra l'entusiasmo: una funzionalità che esce in fretta ma senza controllo del risultato è una scommessa con una data di deploy.
Condizione di superamento: un segnale con nome, una direzione attesa e una data in calendario per leggerlo.
Checklist di accettazione per il codice generato dall'IA, da copiare
Incollala nel modello di pull request o nel ticket. Un blocco per ogni modifica fatta da un agente.
CHECKLIST DI ACCETTAZIONE: [modifica / link alla PR]
Revisore: [nome]   Data: [data]

GRADINO 1 TRACCIABILITÀ
[ ] Decisione o insight che implementa: [link]
[ ] L'evidenza è raggiungibile in due clic e dice ciò che afferma il brief

GRADINO 2 CONTRATTO
Copertura (una riga per criterio di accettazione):
  [criterio 1]  soddisfatto / parziale / mancante
  [criterio 2]  soddisfatto / parziale / mancante
Surplus (comportamento che nessun criterio ha chiesto):
  [elemento]  tenere (criterio aggiunto) / tagliare (aperto a parte)

GRADINO 3 CASI LIMITE
[ ] Stato vuoto      [ ] Stato di errore    [ ] Input limite
[ ] Permessi         [ ] Azione ripetuta
Difetti del brief trovati (aggiungere al brief, non solo al codice): [elenco]

GRADINO 4 RISULTATO
Segnale: [metrica]   Direzione attesa: [su/giù]   Lettura il: [data]

INGEGNERIA (non decide il PM, ma conferma che sia avvenuto)
[ ] Revisione del codice fatta   [ ] Test aggiunti/aggiornati   [ ] Controlli di sicurezza eseguiti

ESITO: accettare / rimandare indietro con modifiche al brief
Che aspetto ha la checklist su una modifica reale?
Supponi che il tuo team abbia chiesto a un agente di aggiungere un'azione «archivia in blocco» a una inbox di feedback.
Gradino 1. Il brief rimanda a un insight: il supporto perde tempo a ripulire elementi obsoleti, e tre conversazioni con i clienti lo citano. L'evidenza è raggiungibile. Superato.
Gradino 2. Il passaggio di copertura trova tutti e quattro i criteri soddisfatti. Il passaggio sul surplus trova che l'agente ha aggiunto anche un toast «annulla» e una nuova scheda di filtro «archiviati». L'annulla merita di restare e riceve un criterio retroattivamente. La scheda di filtro cambia la navigazione e non era stata chiesta, quindi viene tagliata e aperta come opportunità separata. Superato dopo una modifica.
Gradino 3. Lo stato vuoto mostra un pannello bianco senza spiegazioni. Fallito. La correzione va nel brief come criterio mancante, poi torna all'agente.
Gradino 4. Il segnale è il tempo mediano per svuotare la inbox, atteso in calo, letto tra due settimane.
La revisione ha richiesto un fallimento e due modifiche, individuati prima del rilascio. Una revisione da «sembra a posto» avrebbe fatto uscire insieme il pannello bianco e la scheda di navigazione non richiesta.
Compilata nella checklist, la riga dell'esito dice: 4 criteri su 4 soddisfatti, 2 elementi in surplus (1 tenuto, 1 tagliato), 1 caso limite su 5 fallito, lettura del risultato programmata al giorno 14. Rimandare indietro con una modifica al brief.
Come si scrivono criteri di accettazione che un agente non può fraintendere?
La Ladder vale quanto i criteri del gradino due. Atlassian definisce i criteri di accettazione come le condizioni che un lavoro deve soddisfare per essere completo, ed elenca i tratti di quelli buoni: chiari, testabili, focalizzati sul risultato più che sul metodo, misurabili dove possibile e indipendenti l'uno dall'altro (Atlassian). Per gli agenti, la testabilità conta di più: un criterio che un agente non può verificare è un criterio che interpreterà.
Given-When-Then, sviluppato da Daniel Terhorst-North e Chris Matts nell'ambito del behaviour-driven development, è una buona forma per questo (Fowler, 2013). Given è lo stato iniziale, When è l'azione, Then è il cambiamento atteso.
Vago (l'agente tirerà a indovinare)
Testabile (l'agente può verificare)
L'archiviazione funziona bene
Given 3 elementi selezionati, when l'utente clicca Archivia, then tutti e 3 scompaiono dall'elenco della inbox entro 1 secondo
Gestire gli stati vuoti
Given nessun elemento nella inbox, when la pagina si carica, then mostra «Niente da rivedere» e un link alle impostazioni
Solo gli admin possono archiviare
Given un utente con ruolo Viewer, when apre la inbox, then il pulsante Archivia non viene mostrato e l'API restituisce 403
Rendilo veloce
Given 500 elementi, when l'utente seleziona tutto e archivia, then l'azione si completa in meno di 3 secondi
Non rompere nulla
Given un elemento archiviato, when l'utente apre il suo link diretto, then si apre in sola lettura con l'etichetta «Archiviato»
La Ladder funziona meglio quando una parte non è manuale. Due mosse pratiche:
Valida il piano prima che l'agente scriva codice. Specky lo offre tramite il suo server MCP per agenti di codice: un agente chiama validate_agent_plan rispetto ai tuoi standard di ingegneria prima di cominciare, e validate_agent_change prima di dichiarare il successo. Questo anticipa il gradino due, così il piano viene verificato rispetto alle regole quando è ancora economico modificarlo.
Tieni le evidenze allegate. Quando la decisione, il brief, l'esecuzione dell'agente e il controllo del risultato sono tutti nodi di un unico grafo, il gradino uno smette di essere una caccia. Il revisore apre la modifica e il motivo è già accanto.
Usare la Ladder in un piccolo team
Non ti serve un comitato di revisione. Per un fondatore solitario o un team da tre a dieci persone, la Ladder è un'abitudine di cinque minuti per modifica, e l'ordine conta più della cerimonia.
Comincia scrivendo i criteri di accettazione come frasi brevi e verificabili nel brief stesso, come «gli elementi archiviati scompaiono dall'elenco della inbox» invece di «l'archiviazione funziona bene». Frasi così rendono il passaggio di copertura meccanico invece che una questione di gusto. Poi tieni un elenco fisso delle tue cinque situazioni limite, così il gradino tre non viene reinventato ogni volta. Infine, rendi il controllo del risultato parte della definition of done: se la modifica non ha segnale né data, non è pronta per il merge.
Quando una modifica fallisce un gradino, resisti alla tentazione di rattopparla nel thread di revisione. Rimandala indietro con il criterio mancante aggiunto al brief. Il brief è l'artefatto duraturo; il thread sparisce. In un mese i tuoi brief diventano più precisi e il tasso di fallimento ai gradini due e tre scende, ed è questo il vero guadagno.
Cosa misurare sul tuo processo di revisione
Tratta la Ladder come un processo che puoi ispezionare:
Distribuzione dei fallimenti per gradino. Se la maggior parte dei fallimenti cade al gradino due, il problema sono i tuoi brief. Se cade al gradino tre, i tuoi prompt saltano i casi limite.
Tasso di surplus. Con che frequenza un agente aggiunge ambito non richiesto? Un tasso in crescita significa che i tuoi brief lasciano troppo margine.
Completamento del controllo del risultato. Per quante modifiche rilasciate la lettura del gradino quattro è avvenuta nella data stabilita? È il numero che mostra se stai imparando o stai solo rilasciando.
Non ti serve una dashboard per questo. Una tabella con una riga per ogni modifica rivista basta per il primo mese.
Quando questa checklist non funziona?
Non è una revisione del codice o di sicurezza. La Ladder verifica intento e comportamento. Con il 39% degli sviluppatori che nel sondaggio DORA 2024 dichiara poca o nessuna fiducia nel codice generato dall'IA, la revisione di ingegneria e i controlli automatici restano obbligatori (DORA, 2024).
È eccessiva per modifiche banali. Una correzione di testo o un cambio di colore richiede al massimo il gradino due. Riserva la Ladder completa a tutto ciò che un cliente userà o che tocca dati o permessi.
Non può salvare una decisione sbagliata. Il gradino uno verifica che una decisione esista, non che fosse giusta. Se il problema di fondo non è chiaro, torna a un problem statement prima di rivedere altro codice.
Dipende dal fatto che la lettura del risultato avvenga davvero. Per le funzionalità di IA in particolare, il cui output varia di per sé, abbina il gradino quattro a un framework di valutazione dell'IA invece che a una singola metrica.
Domande frequenti
Cos'è una checklist di accettazione per il codice generato dall'IA?
È un breve elenco di controlli di prodotto eseguiti prima che una modifica fatta da un agente conti come completata: quale decisione implementa, se corrisponde al brief e nient'altro, come si comporta in cinque situazioni limite e come saprai che ha funzionato. Affianca la revisione del codice, non la sostituisce.
I product manager devono rivedere il codice scritto dagli agenti di IA?
I PM devono rivedere il comportamento, non lo stile del codice. Leggi il brief rispetto a ciò che fa la modifica, esegui i casi limite in un'anteprima e controlla il piano del risultato. Lascia progettazione, test e sicurezza agli ingegneri e agli strumenti. In un team solitario fai entrambe le cose, ma in passaggi separati.
Quanto dura una revisione di accettazione?
Per una tipica modifica della dimensione di una funzionalità, circa cinque minuti, una volta che i tuoi brief contengono criteri testabili e tieni un elenco fisso di casi limite. Le prime revisioni richiedono più tempo perché portano alla luce criteri mancanti. Quel tempo si sposta sulla scrittura di brief migliori invece di sparire.
Qual è la differenza tra criteri di accettazione e definition of done?
I criteri di accettazione sono specifici di una modifica: cosa deve fare questa funzionalità. Una definition of done vale per ogni modifica: codice rivisto, test superati, controlli di sicurezza eseguiti, controllo del risultato programmato. Atlassian nota che i due termini a volte si usano come sinonimi, ma tenerli separati rende più facili le revisioni degli agenti.
Perché gli agenti di IA aggiungono funzionalità che nessuno ha chiesto?
Gli agenti colmano le lacune del brief con comportamenti plausibili, e extra come pulsanti di annullamento, filtri o impostazioni sono plausibili. Alcuni sono utili. Il problema è che ognuno è un ambito non rivisto. Il passaggio sul surplus al gradino due ti costringe a tenere o tagliare ogni extra di proposito, e ad aggiungere un criterio per tutto ciò che tieni.
Un agente di IA può verificare il proprio lavoro rispetto ai criteri di accettazione?
In parte. Gli agenti possono eseguire test e confrontare il comportamento con i criteri scritti, e gli strumenti che validano un piano prima di programmare intercettano gli errori presto. Ma gli agenti descrivono il proprio lavoro con disinvoltura, e la disinvoltura non è un'evidenza. Una persona esegue ancora il gradino uno (è la decisione giusta?) e il gradino quattro (ha aiutato gli utenti?).
GDPR-aligned. EU workspace data is stored in Frankfurt, Germany. GDPR and EU data Built in Vienna, Austria. A product of influence solutions fm GmbH (FN 675374y). Imprint 14-day trial. Card required, and nothing is charged until day 14. 30-day refund after subscribing. See pricing