4 november 2026Bijgewerkt op Fathy Shalaby16 min leestijd
AI-productdiscovery voor startups: een praktische workflow van twee weken
AI maakt prototypes goedkoop, dus discovery is nu het werk dat kleine teams behoedt voor het bouwen van het verkeerde. Gebruik deze lus van twee weken om een echt probleem te testen voordat je een build opschaalt.
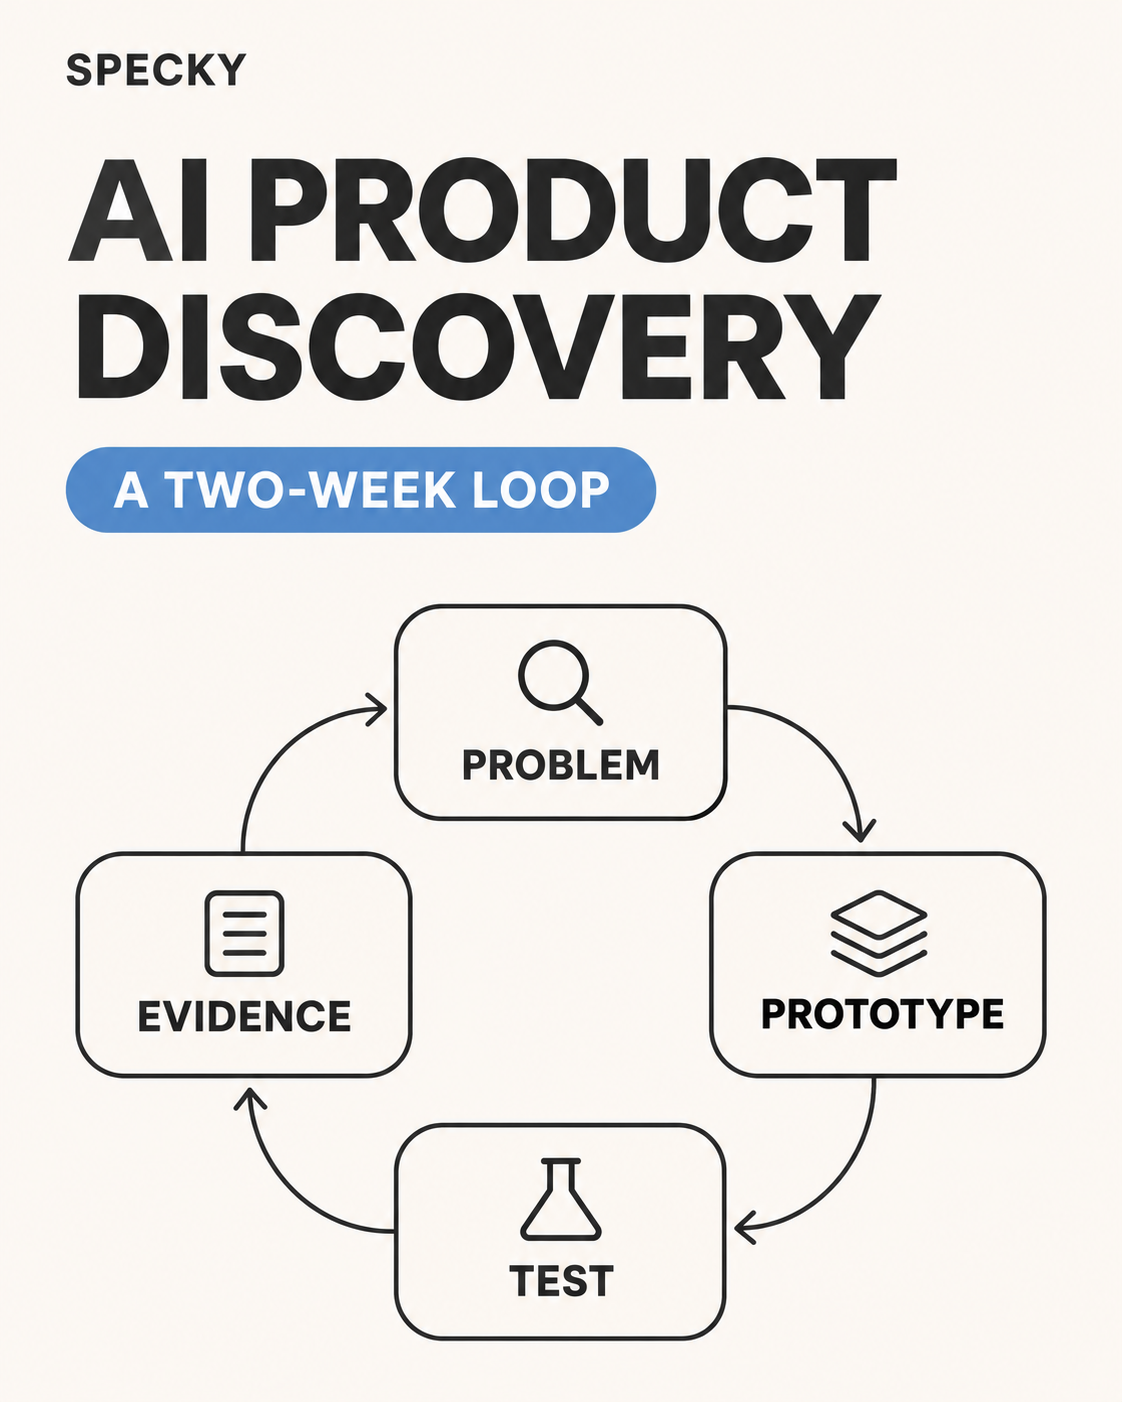
AI-productdiscovery is het werk om te bepalen wat je bouwt, en of AI daar een rol in hoort te spelen, op basis van klantbewijs en niet op basis van hoe snel er een prototype staat. Voor een startup past een praktische versie in twee weken: één beslissing afbakenen, direct bewijs verzamelen, de riskantste aanname kiezen, die testen met het kleinst mogelijke prototype en dan vastleggen of je doorgaat, bijstuurt, pauzeert of stopt.
Belangrijkste inzichten
Bouwen is goedkoper geworden; weten wat je moet bouwen niet. 84% van de developers gebruikt AI-tools of is van plan dat te doen, maar 66% noemt als grootste frustratie output die "bijna goed, maar net niet" is (Stack Overflow, 2025).
Snelheid voelt echt, ook als dat niet zo is. In het onderzoek van METR uit 2025 deden ervaren developers er met AI 19% langer over, terwijl ze dachten 20% sneller te zijn (METR, 2025).
Het meeste opgeleverde werk wordt niet gebruikt: 80% van de features in een gemiddeld product wordt zelden of nooit gebruikt (Pendo, 2019).
43% van de door durfkapitaal gefinancierde startups die sinds 2023 zijn gestopt, noemde een slechte product-market fit als reden (CB Insights, 2026).
AI kan bewijs ordenen en testinstrumenten bouwen. Het kan niet zelf het bewijs zijn: gesimuleerde gebruikers zijn te positief en te oppervlakkig (Nielsen Norman Group, 2024).
Waarom wordt productdiscovery belangrijker als AI bouwen goedkoop maakt?
AI-codeertools maken van een idee in een middag een werkend prototype. In de Stack Overflow Developer Survey van 2025 zei 84% van de respondenten AI-tools bij het ontwikkelen te gebruiken of van plan te zijn te gebruiken, en 47,1% gebruikt ze dagelijks (Stack Overflow, 2025). Dat zegt niets over de vraag of het probleem voor iemand telt.
Twee cijfers laten zien wat het kost om discovery over te slaan. Uit Pendo's analyse van 615 productabonnementen bleek dat 12% van de features 80% van het dagelijks gebruik genereert en dat 80% zelden of nooit wordt gebruikt (). En toen CB Insights 431 door durfkapitaal gefinancierde bedrijven onderzocht die sinds 2023 zijn gestopt, vond het redenen voor 385 ervan; 43% noemde een slechte product-market fit ().
Er is ook een waarnemingsval. METR deed een gerandomiseerde proef met 16 ervaren open-sourcedevelopers op 246 echte taken. De developers verwachtten dat AI hen 24% sneller zou maken; met AI toegestaan duurden de taken 19% langer, en toch schatten ze achteraf dat ze 20% sneller waren geweest (METR, 2025). METR heeft inmiddels aangegeven dat dit resultaten van begin 2025 zijn en heeft een vervolgstudie over nieuwere tools gepubliceerd, maar de les geldt voor discovery: als een team niet kan zeggen of AI het programmeren sneller heeft gemaakt, kan het ook moeilijk beoordelen of een strakke demo vraag heeft aangetoond.
Het knelpunt verschuift dus. Als implementeren goedkoop is, is discovery het werk dat een klein team ervan weerhoudt sneller nog meer van het verkeerde te bouwen.
Wat is AI-gestuurde productdiscovery?
De term omvat twee taken. De eerste is AI gebruiken binnen het discoveryproces: outreach opstellen, interviews transcriberen en taggen, feedback clusteren, verborgen aannames op een rij zetten en testprototypes bouwen. De tweede is uitzoeken of een AI-feature de moeite van het bouwen waard is. Deze workflow dekt beide, en in beide gevallen blijven de mensen in het team eigenaar van het bewijs en de beslissing.
Discoverytaak
Waar AI helpt
Wat menselijk blijft
Werven
Outreach opstellen, antwoorden op screeningsvragen sorteren
Bepalen wie als doelgebruiker telt
Interviews
Transcriptie; door AI geleide interviews voor gestructureerde vragen
Diepgaande verkennende interviews waarvan het verloop onbekend is
Synthese
Clusteren, taggen, eerste samenvattingen gekoppeld aan bronnen
Beoordelen wat een patroon betekent
Aannames
Verborgen aannames opsommen, het tegenovergestelde standpunt verdedigen
Ze rangschikken op risico voor de beslissing
Prototypes
In uren een klikbare mock of dunne doorsnede bouwen
Kiezen wat de test moet laten zien
Beslissing
Het beslissingsverslag opstellen
De knoop doorhakken en daar verantwoordelijk voor zijn
Professionals trekken die lijn al. In een enquête van Nielsen Norman Group uit 2026 onder 521 UX-professionals zei 67% van wie onderzoeksdata analyseert daar vaak of altijd AI voor te gebruiken, maar had slechts 11% AI-interviewers gebruikt en had 61% nog nooit AI gebruikt om gebruikers te interviewen (Nielsen Norman Group, 2026). Voor analyse wordt AI veel meer vertrouwd dan voor het gesprek zelf. (Als je AI-interviewers goed wilt afwegen, lees dan onze gids over door AI geleide klantinterviews.)
Wat moet discovery beantwoorden voordat je een coding agent opent?
Krijg eerst vijf vragen helder:
Wie is de gebruiker, en welke recente taak probeert die af te ronden?
Welk bewijs laat zien dat de taak pijnlijk of belangrijk is?
Wat is nog steeds een aanname?
Waarom zou AI meer kunnen helpen dan een eenvoudigere workflow of een deterministische regel?
Welk resultaat zou de volgende productbeslissing veranderen?
Die sluiten aan op de vier grote risico's van Marty Cagan: waarde (gaan ze het gebruiken of kopen), bruikbaarheid (kunnen ze het uitvogelen), haalbaarheid (kunnen wij het bouwen) en bedrijfsmatige haalbaarheid (werkt het voor het bedrijf) (SVPG, 2017). AI-features voegen nog een check toe: verslaat het model een eenvoudigere baseline? Onze vierstappentest om te bepalen of een feature AI moet gebruiken behandelt die vergelijking.
Als je de vijf vragen nog niet kunt beantwoorden, is de volgende stap een klantgesprek, een review van supporttickets of een handmatige test, geen groter prototype.
Hoe draai je een AI-productdiscoverylus van twee weken?
Zie de timing als planningshulp, niet als belofte. Een solo-oprichter kan het inkorten; een gereguleerd of risicovol product kan meer review nodig hebben. Houd de volgorde aan: leren, een risico kiezen, testen, beslissen.
Dagen
Werk
Resultaat
1–2
De beslissing afbakenen
Eén gebruiker, één job, één beslissing die het bewijs kan veranderen
3–4
Direct bewijs verzamelen
Notities gekoppeld aan echte gesprekken, waargenomen gedrag, tickets of gebruiksdata
5–6
De riskantste aanname kiezen
Een test met een successignaal en een faalcriterium, opgeschreven
7–8
De kleinste bruikbare test bouwen
Een mock, een conciergeservice, een prototype of een stukje workflow
9–10
Observeren en beslissen
Een beslissingsverslag: doorgaan, bijsturen, pauzeren of stoppen
Dag 1–2: Baken één beslissing af
Schrijf één zin:
Moeten we [specifieke gebruiker] helpen [specifieke taak] af te ronden door [voorgestelde verandering]?
Som daaronder de aannames op, gescheiden naar type:
Probleemaanname: een solo product engineer besteedt echt tijd aan het omzetten van verspreide gebruikersverzoeken in een beslissing over wat er gebouwd wordt.
Oplossingsaanname: een AI-ondersteunde workflow kan dat bewijs ordenen zonder de bron kwijt te raken of te overdrijven wat het aantoont.
Risicoaanname: de gebruiker kan het resultaat controleren en corrigeren voordat het een buildbeslissing beïnvloedt.
Dit zijn illustratieve voorbeelden, geen klantuitspraken. Het punt is om elke aanname zichtbaar te maken zodat je ze één voor één kunt testen; de gratis assumption map doet dat in een paar minuten.
Kies een smalle groep op basis van rol, workflow of beperking. "Startups" is te breed. "Technische oprichters van B2B-tools die supportgesprekken lezen voordat ze prioriteiten stellen" geeft de test een startpunt.
Dag 3–4: Verzamel direct bewijs
Begin met materiaal dat je team kan inspecteren:
Notities van gesprekken over een recente, specifieke taak
Supportverzoeken en onboardingvragen
Productgebruik dat laat zien waar mensen blijven hangen of werk herhalen
Een schermdeling of observatie van een taak
Sales- of customer-successgesprekken, gelabeld met hun context
Houd observaties en interpretaties uit elkaar. "De gebruiker kopieerde dezelfde accountgegevens naar drie schermen" is een observatie. "Die heeft een AI-agent nodig" is een hypothese.
Hoeveel gesprekken? Nielsen Norman Group raadt aan te beginnen met vijf of zes, tijdens het werk te analyseren en te stoppen wanneer nieuwe interviews niets meer toevoegen. In het onderzoek van Guest, Bunce en Johnson waren 34 van de 36 veelvoorkomende codes na zes interviews al verschenen; het werk van Griffin en Hauser over klantbehoeften schatte dat 20–30 interviews 90–95% van de behoeften in een brede categorie blootleggen (Nielsen Norman Group, 2021). Voor een lus van twee weken rond één smalle job zijn vijf tot acht gesprekken meestal genoeg om taalgebruik en aannemelijke oorzaken te vinden. Het is nooit genoeg om in te schatten hoe vaak een probleem voorkomt; daarvoor heb je kwantitatief onderzoek nodig.
Gebruik vragen op basis van verhalen ("Vertel eens over de laatste keer dat…"), niet "Zou je … gebruiken?". Ons klantinterviewtemplate bevat een script dat je kunt kopiëren. Laat AI transcriberen, taggen en elke notitie aan de bron koppelen; laat het geen gaten opvullen.
Dag 5–6: Kies de aanname met het hoogste beslissingsrisico
Test niet elke onbekende. Geef elke aanname een score van 1 tot 5 op twee vragen en vermenigvuldig:
Impact: als dit niet klopt, hoeveel herwerk of schade voor de gebruiker volgt er dan?
Onzekerheid: hoe weinig direct bewijs hebben we?
Test het hoogste product als eerste. Bij een AI-feature is de riskante aanname vaak niet "willen ze het" maar "kan het systeem omgaan met de variatie in echte invoer" of "kunnen mensen een fout zien voordat het ertoe doet".
Zet altijd een eenvoudigere baseline naast de AI-versie. Een model verdient zijn plek wanneer de invoer variabel of ongestructureerd is en de gebruiker iets wint wat een regel, een zoekvak of een sjabloon niet kan bieden.
Dag 7–8: Bouw alleen wat de test nodig heeft
Een prototype is een instrument om van te leren, geen bewijs op zich. Bouw net genoeg om de riskante aanname aan de juiste persoon voor te leggen:
Een klikbare mock voor een workflowvraag
Een conciergeversie, waarbij een persoon het resultaat met de hand maakt
Een smal prototype dat draait op een kleine, representatieve set echte invoer
Een dunne implementatie achter een beperkte uitrol
Een baseline zonder AI om mee te vergelijken
Schrijf op wat je gaat observeren voordat je bouwt. Als de vraag is of gebruikers een AI-samenvatting kunnen nakijken en corrigeren, moet de test het corrigeren bevatten. Als een AI-coding agent de test bouwt, geef die dan een afgebakende opdracht: gebruiker, taak, bewijs, scope, verwacht gedrag, faalgevallen en hoe je het resultaat controleert. Het PRD-template voor AI-coding agents is een startpunt.
Voor bruikbaarheidsvragen zijn vijf deelnemers een solide standaard. Het model van Jakob Nielsen laat zien dat vijf gebruikers ongeveer 85% van de bruikbaarheidsproblemen vinden, en hij raadt drie rondes van vijf aan, met verbeteringen ertussen, boven één ronde van 15 (Nielsen Norman Group, 2000).
Dag 9–10: Observeer een echte taak en beslis
Vraag mensen uit de doelgroep een realistische taak uit te voeren. Kijk eerst, voordat je vraagt wat ze ervan vinden. Noteer waar ze aarzelen, de output corrigeren, een omweg nemen of afhaken.
Kies een of twee successignalen die bij de taak passen: afronding, tijd tot afronding, correctiepercentage, geslaagde overdracht, of of ze terugkomen. Log bij AI-features ook de belangrijke faalgevallen, de latency en de kosten per run, voor zover die de ervaring bepalen. Een betere offline-evaluatiescore is geen bewijs dat de gebruikerservaring is verbeterd.
Beslissing
Gebruik die als
Doorgaan
Het probleem wordt ondersteund en de test haalde zijn vooraf opgeschreven successignaal
Bijsturen
Het probleem lijkt echt, maar workflow, doelgroep of gedrag pasten niet
Pauzeren
Een onbekende met hoog risico heeft nog bewijs of review nodig
Stoppen
Het bewijs verzwakt het probleem, of de oplossing voegt weinig toe boven een eenvoudigere optie
Dit is geen statistisch bewijs van product-market fit. Het maakt de volgende beslissing wel traceerbaar, in plaats van afhankelijk van wie de meest zelfverzekerde prompt schreef.
Hoe ziet de lus er in de praktijk uit?
Wat volgt is een illustratief voorbeeld, geen echt bedrijf.
Stel dat een B2B-team van vier mensen denkt dat supportleads elke week uren kwijt zijn aan het omzetten van tickets in een bugrapport voor engineering, en een AI-samenvatter wil bouwen.
Dag 1–2. Beslissing: moeten we supportleads bij SaaS-bedrijven van 20–100 mensen helpen hun wekelijkse bugrapport te maken door het uit tickets op te stellen?
Dag 3–4. Zes interviews. Vijf van de zes maken zo'n rapport; vier besteden er elke week 60–90 minuten aan; twee plakken tickets al in een chatbot en corrigeren de output met de hand.
Dag 5–6. "Ze schrijven het rapport wekelijks" scoort impact 5 × onzekerheid 1 = 5. "Ze vertrouwen een AI-concept genoeg om het na een korte review te versturen" scoort 5 × 4 = 20. De tweede wordt getest. Successignaal, vóór de test vastgelegd: ten minste 3 van de 5 leads versturen het concept na hooguit 15 minuten bewerken.
Dag 7–8. Een concierge-test: de oprichter stelt elk rapport op met een taalmodel, op basis van de echte geëxporteerde tickets van de lead, naast een eenvoudige tabel met ticketaantallen als baseline zonder AI.
Dag 9–10. Vier van de vijf verstuurden het concept; de mediane bewerktijd was 12 minuten. Maar drie van de vijf gaven voor het onderdeel met de aantallen de voorkeur aan de eenvoudige tabel en vertrouwden de AI alleen voor het verhalende deel.
Het successignaal werd gehaald, maar de beslissing is Bijsturen, niet Doorgaan: bouw de aantallen als deterministische tabel en gebruik AI alleen voor de samenvattende alinea. Dat is een kleinere, goedkopere en betrouwbaardere eerste versie dan waarmee het team begon.
Een herbruikbare AI-prompt voor discovery op basis van bewijs
Gebruik AI om materiaal te ordenen dat jij aanlevert, niet om marktbewijs te verzinnen. Houd de bronnotities bij de hand zodat een mens elke bewering kan controleren.
Je helpt een klein productteam bij het voorbereiden van één discoverybeslissing. Gebruik alleen het bewijs dat ik aanlever.
Scheid directe observaties, uitspraken van gebruikers, interpretaties van het team en onbeantwoorde vragen. Koppel elke observatie aan haar bronlabel. Markeer tegenstrijdigheden en ontbrekende context. Verzin geen citaten, gebruikers, marktomvang, frequenties of percentages.
Bepaal op basis van dit bewijs de ene aanname die de beslissing het sterkst kan veranderen. Stel de kleinste test voor die die onzekerheid kan verkleinen. Neem de doelgebruiker, taak, verwacht gedrag, waarschijnlijke faalgevallen, een of twee waarneembare successignalen en het resultaat dat de beslissing zou veranderen mee. Vergelijk de AI-aanpak met een eenvoudigere baseline. Markeer alle aanbevelingen als hypothesen totdat ze getest zijn.
Controleer de output aan de hand van de oorspronkelijke notities. Als het model voor een bewering geen bron kan aanwijzen, schrap de bewering dan of ga het bewijs ophalen.
Hoe beoordeel je een tool voor AI-gestuurde productdiscovery?
Voordat je de aanbevelingen van een tool vertrouwt, laat je hem draaien op één eerdere beslissing waarvan je de uitkomst al kent, en controleer je zeven dingen:
Bronvermeldingen. Verwijst elk thema of elke bewering terug naar een citaat, ticket of gesprek dat je kunt openen?
Observatie versus interpretatie. Houdt het uit elkaar wat mensen zeiden en wat het model concludeerde?
Aantallen, geen bijvoeglijke naamwoorden. Vertelt het je hoeveel bronnen een thema ondersteunen ("6 van 14 gesprekken") in plaats van het "een sterk signaal" te noemen?
Menselijke review. Kan een mens de output corrigeren of afwijzen voordat die in een spec of ticket terechtkomt?
Toestemming en gegevensverwerking. Waar worden gegevens opgeslagen, en wordt aan deelnemers aan interviews om toestemming gevraagd en verteld dat ze met een AI praten?
Eerlijke grenzen. Zegt het wanneer het bewijs dun is, of klinkt elk idee goed? Meegaandheid is precies de fout die Nielsen Norman Group vond bij gesimuleerde gebruikers (2024).
Geschiktheid van het gratis abonnement. Kun je één volledige lus draaien op het gratis of proefabonnement voordat je betaalt? Zo niet, test het dan toch op de beslissing hierboven, met een tijdslimiet.
Een tool die de eerste drie punten niet haalt, maakt je alleen sneller in ongelijk hebben.
Welke fouten maken teams als ze AI gebruiken om sneller te gaan?
Een gegenereerd prototype als validatie behandelen. Het bewijst dat iets te bouwen is, niet dat de doelgebruiker het nodig heeft.
Synthetische gebruikers als klantbewijs gebruiken. AI kan helpen een interviewgids te oefenen of randgevallen te vinden. Gesimuleerde antwoorden vervangen geen gesprekken of waargenomen gedrag.
Vragen of iemand het idee leuk vindt. Vraag naar een recente taak en kijk hoe de persoon een realistische workflow probeert.
De output meten in plaats van de job. Uitgevoerde prompts, gemergede code en opgeleverde features zijn leveringssignalen, geen bewijs dat de klant een taak beter heeft afgerond.
Een metric een afweging laten verbergen. Een AI-resultaat kan goed scoren in een evaluatie en toch traag, verwarrend of lastig te corrigeren aanvoelen. Combineer technische checks met een gebruikerstaak.
Bewijs in losse tools bewaren. Leg bron, beslissing, test en uitkomst bij elkaar vast zodat je later kunt zien wat je van mening deed veranderen.
Wanneer deze lus het verkeerde gereedschap is: als je wilt weten hoeveel mensen een probleem hebben, doe dan een enquête of analyseer gebruiksdata. Als het product veiligheidskritisch of gereguleerd is, zijn twee weken te kort voor review. En als je kiest tussen twee goede ideeën die allebei discovery hebben doorstaan, heb je prioritering nodig, niet meer interviews. Voor een korter format rond één vraag, zie de AI-discoverysprint; om het bewijs vers te houden nadat de lus is afgelopen, maak je er een wekelijkse continuous-discoverygewoonte van.
Waar Specky past
Specky is een AI-native productsysteem dat om dit soort lus heen is gebouwd. Het leest klantgesprekken, feedback, Slack, Jira en analytics in een Product Graph, zodat het bewijs van dag 3–4 aan zijn bron gekoppeld blijft. Alex, Speckys researchagent, voert klantinterviews uit via een deelbare link, zodat de bewijsstap niet op agenda's hoeft te wachten. Wanneer je bij een beslissing komt, stelt de PRD Editor de spec op met inline citaten die naar dat bewijs terugverwijzen, en legt het Decision Log vast waarom je doorging, bijstuurde, pauzeerde of stopte. Voor het bredere proces van probleem tot release, zie de gids over het productdiscoveryproces.
Veelgestelde vragen
Wat is AI-productdiscovery?
AI-productdiscovery is het gebruik van klant- en productbewijs om te bepalen welk probleem je oplost, of AI een nuttig onderdeel van de oplossing is en welke kleine test er moet draaien voor een grotere build. AI-tools helpen bij synthese, interviews en prototypes, maar het team blijft verantwoordelijk voor het controleren van bronnen en het nemen van de beslissing. Zonder echt klantbewijs is het gewoon sneller gokken.
Kan AI een startupidee valideren?
Nee. AI kan bewijs ordenen, testvarianten genereren en snel een prototype bouwen, maar het kan niet aantonen dat echte klanten het probleem hebben of de oplossing gaan gebruiken. Nielsen Norman Group vond gesimuleerde gebruikers te positief en oppervlakkig vergeleken met echte. Gebruik gesprekken, waargenomen taken en productgedrag als bewijs, en behandel door AI gegenereerde analyse als hypothese totdat een mens die tegen de bronnen heeft gecheckt.
Hoe lang moet productdiscovery duren voor een startup?
Voor één smalle beslissing ongeveer twee weken: twee dagen om af te bakenen, twee om bewijs te verzamelen, twee om de riskantste aanname te kiezen, twee om een test te bouwen en twee om te observeren en te beslissen. Solo-oprichters kunnen dit tot een paar dagen inkorten. Brede strategische vragen, gereguleerde producten en alles wat prevalentiedata nodig heeft, duren langer, en discovery moet na de lus wekelijks doorgaan.
Wat zijn de beste tools voor AI-productdiscovery?
De beste tool hangt af van de stap. Transcriptie- en synthesetools helpen het meest in de bewijsfase, AI-interviewers passen bij korte gestructureerde vragen, coding agents bouwen testprototypes en analytics-tools laten echt gedrag zien. Wat je ook kiest, check dat elke bewering naar een bron verwijst, dat het aantallen rapporteert in plaats van bijvoeglijke naamwoorden en dat een mens de output kan corrigeren voordat die een beslissing vormt.
Hoe verschilt productdiscovery van productontwikkeling?
Productdiscovery vermindert onzekerheid over de gebruiker, het probleem en de oplossing. Productontwikkeling bouwt en draait het product. Ze overlappen: een prototype kan deel uitmaken van een discoverytest, en gebruik na release hoort de volgende leerronde te voeden. De nuttige vraag is of het team nu een aanname test of een verandering oplevert die het al heeft gevalideerd.
GDPR-aligned. EU workspace data is stored in Frankfurt, Germany. GDPR and EU data Built in Vienna, Austria. A product of influence solutions fm GmbH (FN 675374y). Imprint 14-day trial. Card required, and nothing is charged until day 14. 30-day refund after subscribing. See pricing