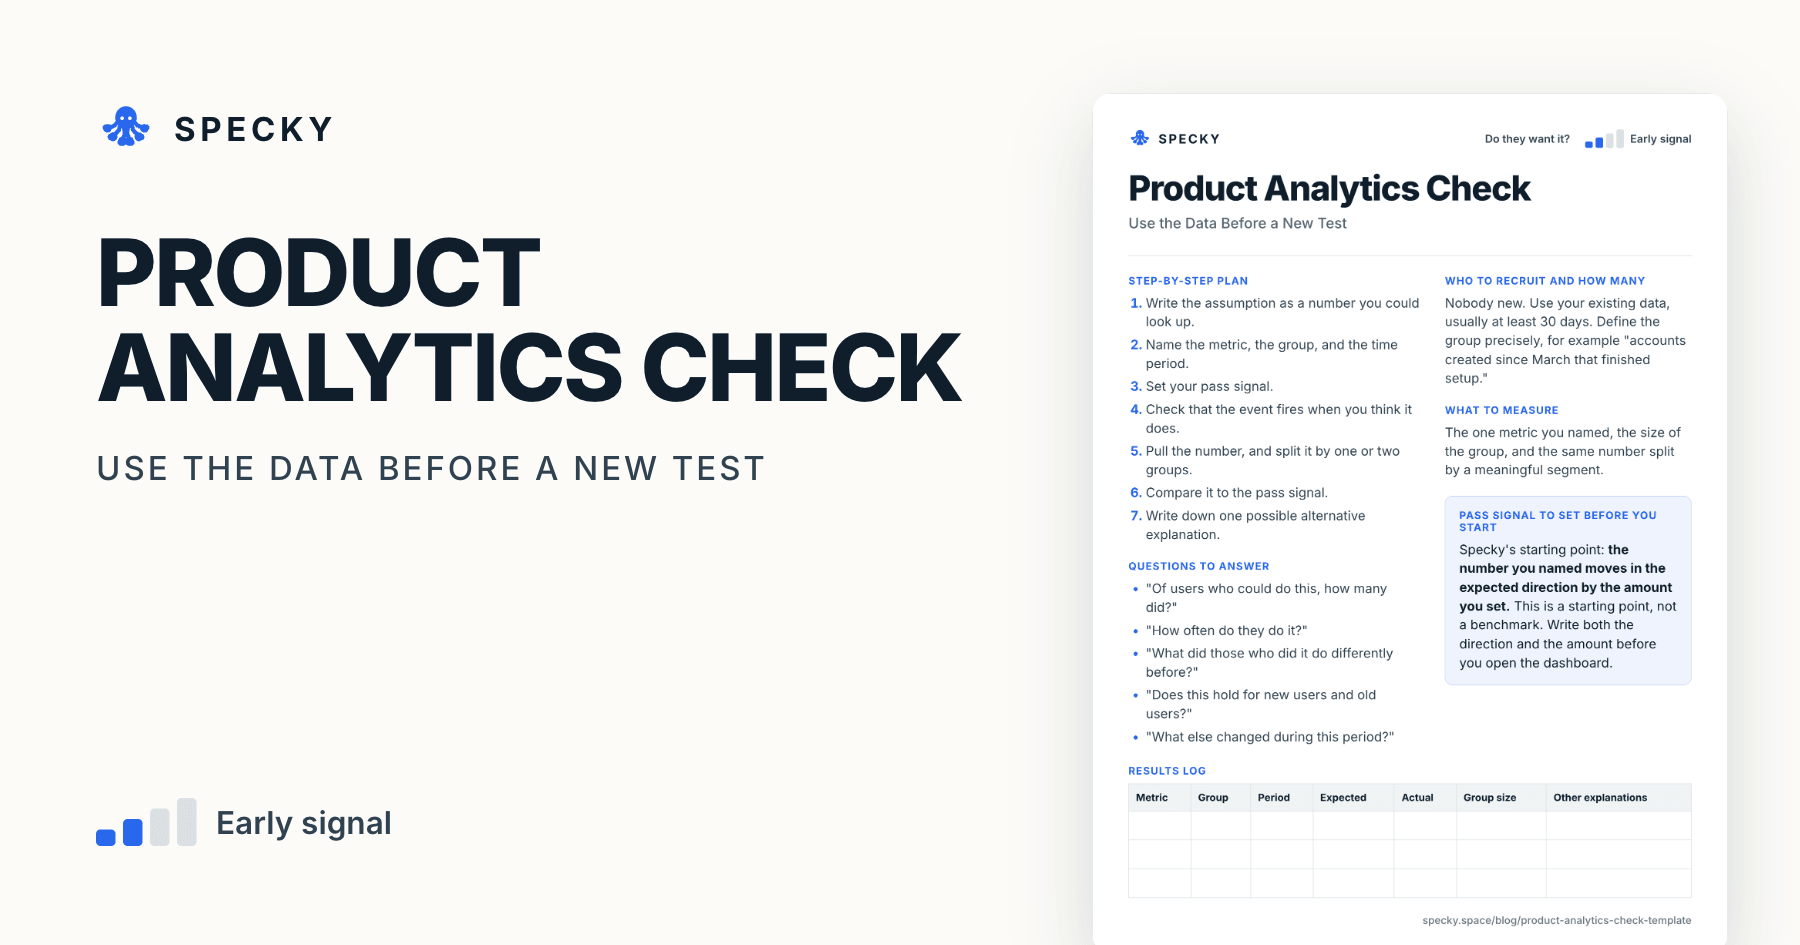
Een product analytics check gebruikt gedrag dat je product al vastlegt om één aanname te bevestigen of te bevragen voordat je een nieuwe test laat uitvoeren. Je schrijft het getal op dat je verwacht, haalt het echte getal op uit een tool als Amplitude, PostHog of Mixpanel en vergelijkt ze. Het kost ongeveer een dag, het is gratis en je krijgt richtinggevend bewijs: wat er gebeurde, niet waarom.
Belangrijkste punten
Schrijf de metric, de groep, de periode en het slaagsignaal op voordat je een dashboard opent.
Data uit het verleden laat zien dat dingen samen voorkomen, niet wat de oorzaak is. Het experimenteerteam van Microsoft noemde post-hocanalyse "grotendeels beperkt tot het identificeren van correlaties" (Kohavi et al., 2009).
"Day 30 retention" kan twee getallen betekenen. Amplitude en Mixpanel maken allebei onderscheid tussen terugkeren op dag 30 en terugkeren op of na dag 30.
Bekijk je 20 segmenten bij een percentage valse positieven van 5%, dan is de kans dat er minstens één door puur toeval als winnaar lijkt ongeveer 64%.
Bij 100 gebruikers per groep moet het verschil tussen twee retentiepercentages ongeveer 14 procentpunt zijn voordat je het van ruis kunt onderscheiden.
Wat is een product analytics check?
Het is de goedkoopste test uit de reeks: geen werving, geen bouwwerk. Je pakt een aanname onder een productweddenschap, zoals "mensen die in week één een teamgenoot uitnodigen, blijven langer", schrijft die om naar een getal en zoekt het op.
De experimentbibliotheek van Strategyzer bij Testing Business Ideas plaatst dit soort werk onder "data analysis"-discoveryexperimenten. Een kaart die product analytics check heet, bestaat er niet. Het dichtstbijzijnde familielid, webverkeeranalyse, scoort 2 van 5 voor kosten en 2 van 5 voor bewijskracht (Strategyzer-poster). Goedkoop en snel, maar zwakker dan iets bewust veranderen.
Hij beantwoordt vragen over adoptie, frequentie, volgorde, retentie en segmenten. Wordt het gedrag niet vastgelegd, begin dan met een webverkeeranalyse of voeg het event toe en wacht af.
Wanneer gebruik je een product analytics check, en wanneer niet?
Gebruik hem als eerste, telkens wanneer de aanname gaat over iets wat je product al vastlegt. Het kost een dag, het is gratis en vaak beantwoordt het de vraag of laat het je zien welke vraag je eigenlijk moet stellen.
Gebruik hem niet bij producten met heel weinig gebruikers, waar kleine aantallen wild schommelen. Gebruik hem niet voor dingen die je niet bijhoudt, en ga er niet van uit dat een event betekent wat de naam zegt voordat je dat hebt gecontroleerd. En als je moet aantonen dat een verandering een resultaat veroorzaakte, heb je een splittest nodig, want data uit het verleden kan alleen laten zien dat twee dingen samen gebeurden.
Welk risico test hij, en hoe sterk is het bewijs?
Hij test desirability: gedragen bestaande gebruikers zich zoals je aannam? Het bewijs is richtinggevend. Het is echt gedrag, maar je kijkt terug, er was niets gecontroleerd en je ziet alleen wat is vastgelegd.
Dat is nog altijd beter dan een onderbuikgevoel. Kohavi en collega's meldden dat, objectief gemeten, de meeste ideeën de metrics waarvoor ze bedoeld waren niet verbeteren (Kohavi et al., 2009). Een check van één dag die een zwakke overtuiging schrapt vóór een maand bouwen is een goede ruil, zeker als de metric je north star metric is. In onze gids voor het kiezen van een productexperiment leggen we uit waarom het vaak de beste eerste stap is.
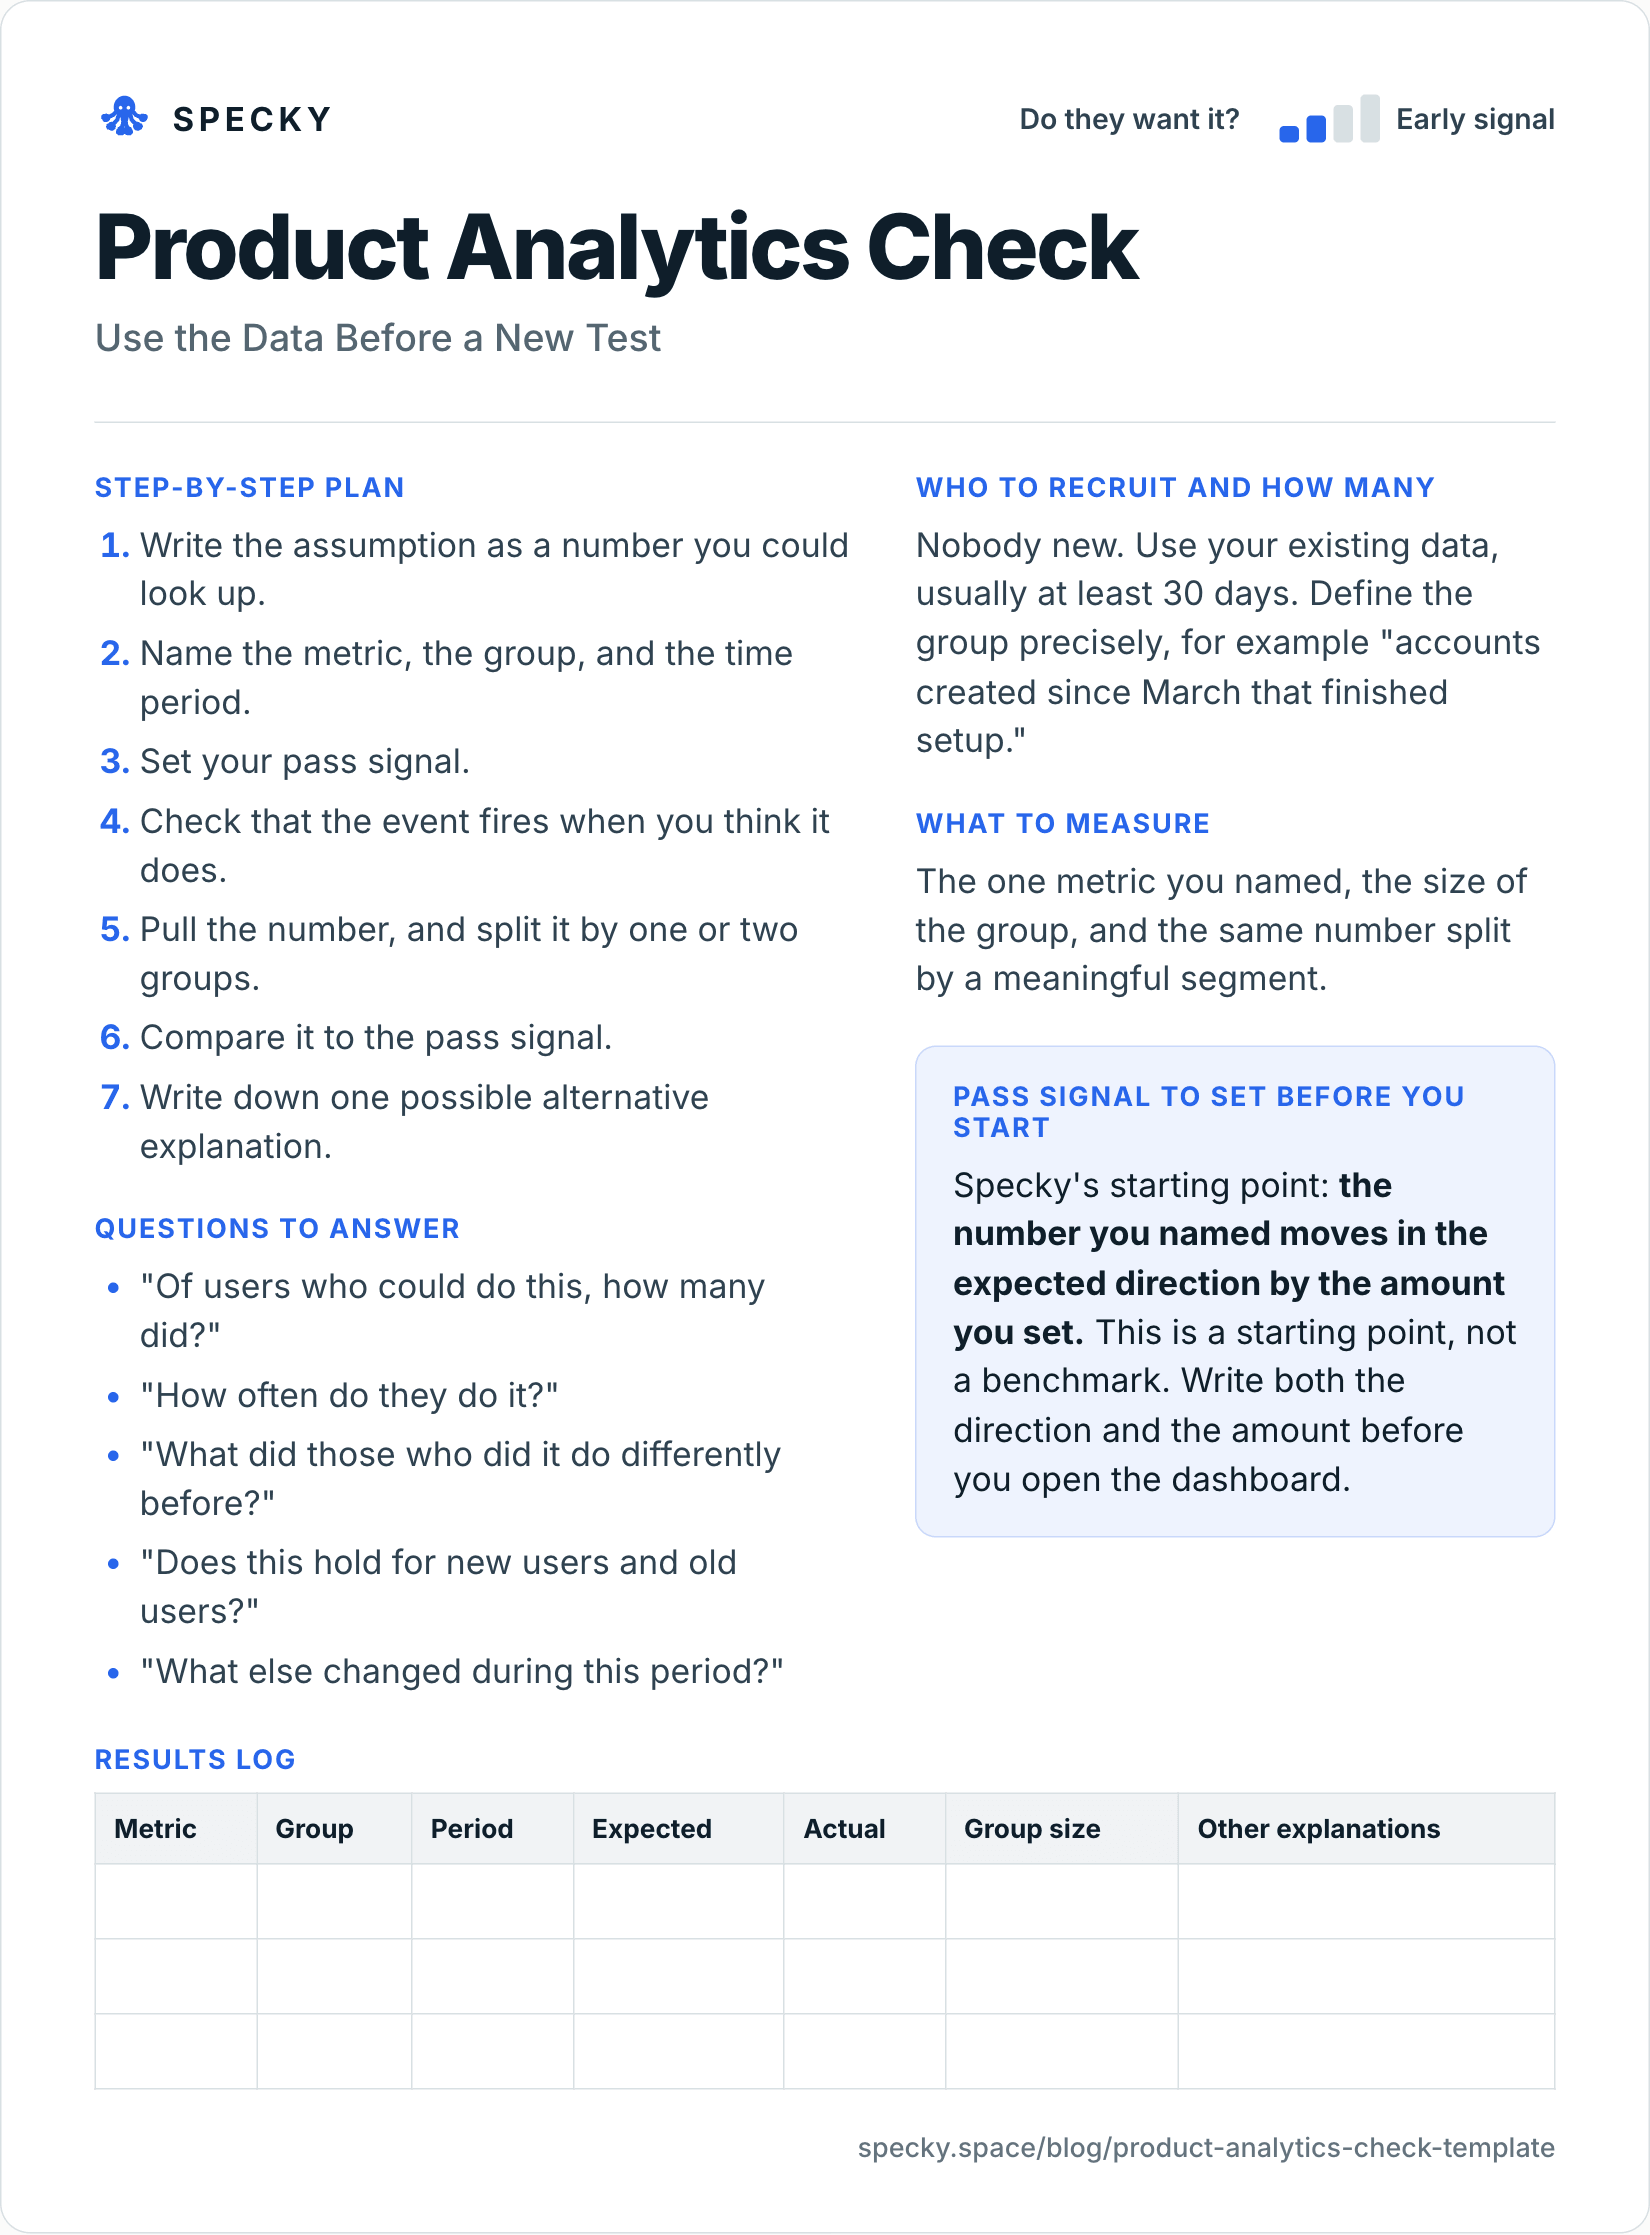
Template voor een product analytics check (kopieer en gebruik)
Open de afbeelding op volledige grootte, of kopieer de tekstversie hieronder.
Wie je werft en hoeveel
Niemand nieuw. Gebruik je bestaande data, meestal minstens 30 dagen. Definieer de groep nauwkeurig, bijvoorbeeld "accounts aangemaakt sinds maart die de setup hebben afgerond".
Stappenplan
Schrijf de aanname op als een getal dat je kunt opzoeken.
Benoem de metric, de groep en de periode.
Stel je slaagsignaal vast.
Controleer of het event afgaat wanneer je denkt dat het afgaat.
Haal het getal op en splits het op naar een of twee groepen.
Vergelijk het met het slaagsignaal.
Schrijf één mogelijke alternatieve verklaring op.
Vragen om te beantwoorden
"Van de gebruikers die dit konden doen, hoeveel deden het?"
"Hoe vaak doen ze het?"
"Wat deden degenen die het deden eerder anders?"
"Geldt dit voor nieuwe en voor oude gebruikers?"
"Wat is er in deze periode nog meer veranderd?"
Wat je meet
De ene metric die je hebt benoemd, de grootte van de groep en hetzelfde getal gesplitst naar een zinvol segment.
Slaagsignaal dat je vóór de start vaststelt
Het uitgangspunt van Specky: het getal dat je hebt benoemd beweegt in de verwachte richting met het bedrag dat je hebt vastgesteld. Dit is een uitgangspunt, geen benchmark. Schrijf zowel de richting als het bedrag op voordat je het dashboard opent.
Resultatenlogboek
Metric
Groep
Periode
Verwacht
Werkelijk
Groepsgrootte
Andere verklaringen
Hoe definieer je de metric zodat het getal iets betekent?
Stap 2 is waar de meeste checks misgaan. "Retentie" klinkt als één getal, maar analytics-tools bieden er meerdere:
Jouw vraag
Amplitude
Mixpanel
Kwamen ze precies op dag 30 terug?
Return On (voorheen N-Day)
"On"
Op dag 30 of op een later moment?
Return On or After (voorheen Unbounded)
"On or After"
Binnen een bereik, zoals dag 28-35?
Eigen brackets, tot 100 per grafiek
Eigen brackets
Wat start de klok?
Het startevent (instroomdatum van de cohort)
Het eerste "A event" van de gebruiker
Bronnen: Amplitude, Mixpanel. PostHog bouwt dezelfde grafiek op uit een startevent en een terugkeerevent (PostHog).
Drie details veranderen het antwoord:
"On or after" is altijd minstens zo hoog als "on". Het telt iedereen mee die later terugkomt. Vergelijk nooit het "on" van het ene team met het "on or after" van het andere.
Rollende dagen versus kalenderdagen. In de rolling-modus van Mixpanel betekent dag 1: 24 tot 48 uur na het eerste event. In de kalendermodus betekent het de volgende kalenderdag. Een aanmelding om 23:50 kan in de ene modus op dag 1 behouden zijn en in de andere niet.
Eerste keer versus terugkerend. De first-time-retentie van PostHog telt een gebruiker alleen de eerste keer dat die het startevent deed mee in een cohort; recurring telt elke periode waarin die het deed. Gebruik voor "blijven nieuwe gebruikers hangen?" first-time.
Mixpanel laat onvoltooide periodes weg uit de gemiddelde retentie. Ziet de laatste week eruit als een instorting, controleer dan of die al is afgelopen.
Hoe controleer je dat een event betekent wat de naam zegt?
Stap 4 kost ongeveer 30 minuten en bespaart dagen:
Voer de actie uit in een testaccount en kijk hoe het event binnenkomt. Doe daarna iets wat er dichtbij zit en het event niet hoort te laten afgaan.
Vergelijk een week aan eventtellingen met je eigen database. Een verschil van meer dan een paar procent vraagt om uitleg.
Zoek de dag waarop het event voor het eerst is verstuurd. Eerdere gebruikers lijken het nooit te hebben gedaan.
Filter je team, testaccounts en bots eruit.
Hoeveel gebruikers heb je nodig voor een product analytics check?
Er hoeft niemand geworven te worden, maar de groepsgrootte bepaalt nog steeds of het getal iets betekent. De tabel gebruikt de gebruikelijke 95%-benadering voor een percentage rond 50%, het slechtste geval:
Gebruikers per groep
Marge op één percentage
Marge op het verschil tussen twee groepen
30
± 18 punten
± 25 punten
100
± 10 punten
± 14 punten
400
± 5 punten
± 7 punten
1.000
± 3 punten
± 4 punten
Zet het slaagsignaal dus boven de marge: bij 100 gebruikers per groep is "5 punten beter" niet van ruis te onderscheiden. Onder ongeveer 100 per groep behandel je de check als een schets die je vertelt wat je in een klantinterview moet vragen, niet als een oordeel.
Hoe voorkom je dat je jezelf voor de gek houdt met analytics?
Waarom kan een verschil kleiner worden of omslaan als je de data splitst?
Omdat een derde factor beide getallen kan aandrijven. In het extreme geval, de paradox van Simpson, verschijnt een verband, verdwijnt het of keert het om zodra je een populatie in groepen splitst (Stanford Encyclopedia of Philosophy). Het klassieke voorbeeld zijn de toelatingen tot de graduate-opleidingen in Berkeley, onderzocht door Bickel, Hammel en O'Connell in 1975. Mannen werden over het geheel genomen vaker toegelaten, maar geen enkele afdeling benadeelde vrouwen: vrouwen hadden zich vaker aangemeld bij afdelingen die minder mensen toelieten.
In productdata is de gebruikelijke derde factor het type abonnement, de bedrijfsgrootte, het aanmeldkanaal of de gebruiksduur. Daarom zegt stap 5 dat je moet splitsen naar een of twee groepen.
Hoeveel splitsingen zijn te veel?
Elke splitsing is nog een lot. Behandel je elke toevalstreffer van 5% als een bevinding, dan is de kans dat minstens één segment door toeval "wint" 23% bij 5 segmenten, 40% bij 10 en 64% bij 20. Benoem je een of twee splitsingen vooraf, en leg elk onverwacht spannend segment vast als nieuwe aanname, niet als resultaat. Som daarna de releases, prijswijzigingen en campagnes in het venster op: een piek die samenvalt met een lanceringsmail komt door de mail.
Hoe ziet een product analytics check er in de praktijk uit?
Dit voorbeeld is verzonnen om de methode te laten zien. Een team dat een designreviewtool bouwt, gelooft dat gebruikers die in hun eerste week een teamgenoot uitnodigen veel groter kans hebben om te blijven. Ze stellen: "Uitgenodigde gebruikers zouden op dag 30 minstens 20 punten beter moeten behouden zijn."
Ze halen de getallen op. Gebruikers die in week één iemand uitnodigden, hadden op dag 30 een retentie van 61%, tegenover 33% voor degenen die dat niet deden, een verschil van 28 punten. Maar de groep die uitnodigde zat ook grotendeels op betaalde abonnementen. Alleen onder de betaalde accounts zakt het verschil naar 9 punten.
De eerste lezing slaagt, de tweede niet. Ze leggen het vast als niet doorslaggevend en noteren dat het type abonnement erachter kan zitten. De volgende stap is een gecontroleerde test van een duwtje om teamgenoten uit te nodigen.
Hier is hetzelfde voorbeeld met groepsgroottes:
Groep
Accounts
Op betaalde abonnementen
Day-30-retentie
Uitgenodigd in week één
420
80%
61%
Niet uitgenodigd
1.580
Ongeveer 33%
33%
Alleen betaald: uitgenodigd
336
100%
69%
Alleen betaald: niet uitgenodigd
514
100%
60%
Het verschil van 28 punten ligt ver buiten de ruis (ongeveer ± 5 punten), maar vermengt uitnodigen met betalen. Het verschil van 9 punten bij alleen betaalde accounts (marge ongeveer ± 6,5) is echt, maar blijft onder de helft van de vereiste 20 punten.
Product analytics check versus webverkeeranalyse versus splittest
Bezoeken en paden van overwegend anonieme bezoekers
Nieuwe data uit een verandering die je doorvoert
Beantwoordt
Gedragen gebruikers zich zoals we aannamen?
Waar komen bezoekers vandaan en waar haken ze af?
Veroorzaakt deze verandering een beter resultaat?
Bewijs
Alleen verband
Alleen verband
Oorzaak, als gerandomiseerd en groot genoeg
Strategyzer-score
Geen kaart
Discovery; kosten 2/5, bewijs 2/5
Validation; kosten 2/5, bewijs 3/5
Voer ze in die volgorde uit: de analytics check vertelt je of een overtuiging een splittest verdient.
Wat zijn de meest gemaakte fouten in productanalytics?
Eerst het dashboard openen. Bepaal het getal voordat je de data ziet.
Eventnamen geloven. Controleer of "project_created" betekent wat jij denkt.
Correlatie verwarren met oorzaak. Mensen die X doen, zijn misschien gewoon van meet af aan toegewijder.
Splitsen tot er iets werkt. Als je 20 segmenten bekijkt, ziet er één er door toeval geweldig uit.
Het gemiddelde rapporteren. Gemiddelden verbergen wie wat deed.
Wanneer het niet werkt: bij minder dan ongeveer 100 gebruikers per groep, bij gedrag dat je niet vastlegt en bij elke vraag die bewijs van oorzaak vereist.
Is het eerlijk tegenover gebruikers om hun gedrag zo te analyseren?
Meestal wel, zolang je binnen blijft wat gebruikers hebben goedgekeurd. Controleer of je privacyverklaring productanalytics dekt en of toestemmingskeuzes zijn gerespecteerd. Werk met groepen, niet met mensen bij naam: een cohortgrafiek is prima, een dia met daarop welke klant wat deed niet.
Zo voer je het uit in Specky
Klik op de Assumptions-pagina op de notitie en kies Pick a test, daarna Analytics. Specky vult de stappen, het slaagsignaal en een planning van een dag in.
Specky leest de getallen uit gekoppelde analytics-tools, zoals PostHog, Mixpanel, Amplitude of Pendo. Voor deze test is er geen run met één klik: vraag in de chat om het getal, of haal het zelf op, en voeg het dan toe als bewijs.
Is er niets gekoppeld, plak dan de getallen met bron en datum.
Klik op Start running en leg daarna het resultaat vast.
Een geslaagde check verschijnt op het bord als Early signal, niet als Supported, omdat het lezen van data uit het verleden richtinggevend is.
Wat doe je met elke uitkomst?
Supported (verschijnt als Early signal): De data stemt overeen. Moet je de oorzaak bewijzen, voer dan een splittest uit. Wil je weten waarom, doe dan een paar interviews.
Unclear: Het resultaat hangt af van de groep. Noteer de groepen en bepaal dan welke ertoe doet.
Contradicted: Gebruikers gedragen zich niet zoals je aannam. Stop met ontwerpen voor die overtuiging. Elke weddenschap die op deze notitie rust, verschijnt nu als Contradicted.
Veelgestelde vragen
Wat is een product analytics check?
Een product analytics check gebruikt data die je al verzamelt om een productaanname te bevestigen of te bevragen. Je schrijft eerst het verwachte getal, de groep en de periode op, zoekt het dan op in je analytics-tool en vergelijkt. Het is meestal de snelste eerste stap wanneer het gedrag al wordt bijgehouden.
Kan analytics bewijzen dat een feature een resultaat veroorzaakte?
Nee. Analytics uit het verleden kunnen alleen laten zien dat twee dingen samen gebeurden. Mensen die een feature gebruiken, zijn misschien gewoon van meet af aan toegewijder. Om te laten zien dat een verandering een resultaat veroorzaakte, heb je een gecontroleerd experiment nodig, zoals een splittest, waarbij gebruikers willekeurig worden toegewezen.
Hoe voorkom ik dat ik mezelf voor de gek houd met analytics?
Schrijf de metric, de groep en de verwachte verandering op voordat je een dashboard opent. Controleer dan of het event betekent wat je denkt en beperk op hoeveel manieren je de data splitst. Benoem vooraf een of twee splitsingen en behandel elk verrassend segment als een nieuwe aanname om te testen.
Wat is het verschil tussen N-day- en unbounded-retentie?
N-day-retentie, die Amplitude nu Return On noemt, telt gebruikers die op één specifieke dag terugkwamen, zoals dag 30. Unbounded-retentie, nu Return On or After, telt gebruikers die op die dag of later terugkwamen en is dus altijd gelijk of hoger. Mixpanel hanteert dezelfde indeling.
Hoeveel data heb je nodig voor een product analytics check?
Gebruik minstens 30 dagen en mik op een paar honderd gebruikers in elke groep die je vergelijkt. Bij 100 gebruikers per groep heeft het verschil tussen twee percentages een marge van ongeveer 14 punten, dus alleen grote verschillen betekenen iets. Bij 1.000 per groep zakt de marge naar ongeveer 4 punten.
GDPR-aligned. EU workspace data is stored in Frankfurt, Germany. GDPR and EU data Built in Vienna, Austria. A product of influence solutions fm GmbH (FN 675374y). Imprint 14-day trial. Card required, and nothing is charged until day 14. 30-day refund after subscribing. See pricing