Een A/B-testplan template is een plan van één pagina dat je invult vóór een splittest: de ene verandering, de primaire metric, een guardrail-metric, de steekproefgrootte en de einddatum. Een splittest laat die verandering vervolgens aan een willekeurig deel van het echte verkeer zien en vergelijkt de metric die je voor de start hebt benoemd. Schrijf eerst het plan, want de meeste splittests gaan mis vóór de lancering.
Belangrijkste punten
De meeste ideeën verliezen. Het succespercentage van ideeën bij Bing lag rond 10-20%, en winnaars bewogen belangrijke metrics met 0,1% tot 1,0% (Kohavi et al., KDD 2014).
Bereken de steekproefgrootte voordat je begint. Bij een conversiepercentage van 12% heb je voor het aantonen van een relatieve stijging van 10% ongeveer 11.700 gebruikers per versie nodig, bij 95% betrouwbaarheid en 80% power (rekenmachine van Evan Miller).
Kijk niet tussentijds. Na elke bezoeker testen en stoppen bij het eerste "significante" resultaat verhoogt het percentage valse positieven van 5% naar 26,1% (Evan Miller, 2010).
Benoem één guardrail, een metric die niet slechter mag worden.
Wat is een splittest?
Een splittest verandert één ding voor een deel van je echte verkeer en vergelijkt een metric die je benoemd hebt voordat de test begon.
Het is hetzelfde als een A/B-test: versie A is het origineel (de controlegroep), versie B heeft de verandering, en mensen worden willekeurig toegewezen. Omdat de verandering het enige systematische verschil is, wijst een duidelijk verschil in de metric op de verandering.
In Testing Business Ideas van David J. Bland en Alex Osterwalder is de splittest een validatie-experiment van het type "call to action", naast de landingspaginatest en de presale. De poster van Strategyzer geeft hem 2 van 5 voor kosten, 3 van 5 voor looptijd en 3 van 5 voor bewijskracht (Strategyzer-experimentbibliotheek).
Wanneer voer je een splittest uit, en wanneer niet?
Gebruik hem als je genoeg verkeer hebt en wilt weten of een specifieke verandering een resultaat veroorzaakte. Het is de betrouwbaarste manier om dat te beantwoorden. Hij kan je ook verrassen. In hun artikel in Harvard Business Review uit 2017 vertellen Ron Kohavi en Stefan Thomke het verhaal van een kleine verandering in hoe advertentiekoppen bij Bing werden getoond, die zulke sterke resultaten opleverde dat ze intern een alarm afgingen omdat ze te mooi leken om waar te zijn. Het idee lag al meer dan zes maanden in de backlog. Het verhoogde de omzet met 12%, goed voor meer dan 100 miljoen dollar per jaar alleen al in de VS.
Dat verhaal is de uitzondering. In een paper uit 2014 schreven Kohavi en collega's dat de meeste Bing-experimenten mislukken, en dat uitzonderlijk sterke resultaten om de wet van Twyman vragen: "Any figure that looks interesting or different is usually wrong!"
Gebruik hem niet bij weinig verkeer. Als je vele maanden nodig hebt om genoeg mensen te bereiken, kies dan een usabilitytest of interviews. Gebruik hem niet om te verkennen. Hij vergelijkt alleen opties die je al hebt. Lees voor meer diepgang onze uitgebreidere gids over A/B-testen voor product managers.
Welk risico test hij, en hoe sterk is het bewijs?
Hij test desirability: zorgt deze versie ervoor dat mensen meer doen van wat je wilt? Het bewijs is gedrag, van echte mensen die niet weten dat ze in een test zitten. Hij meet wat er gebeurt gedurende de testperiode en kan dus effecten op de lange termijn missen. Zie onze gids voor het kiezen van een productexperiment.
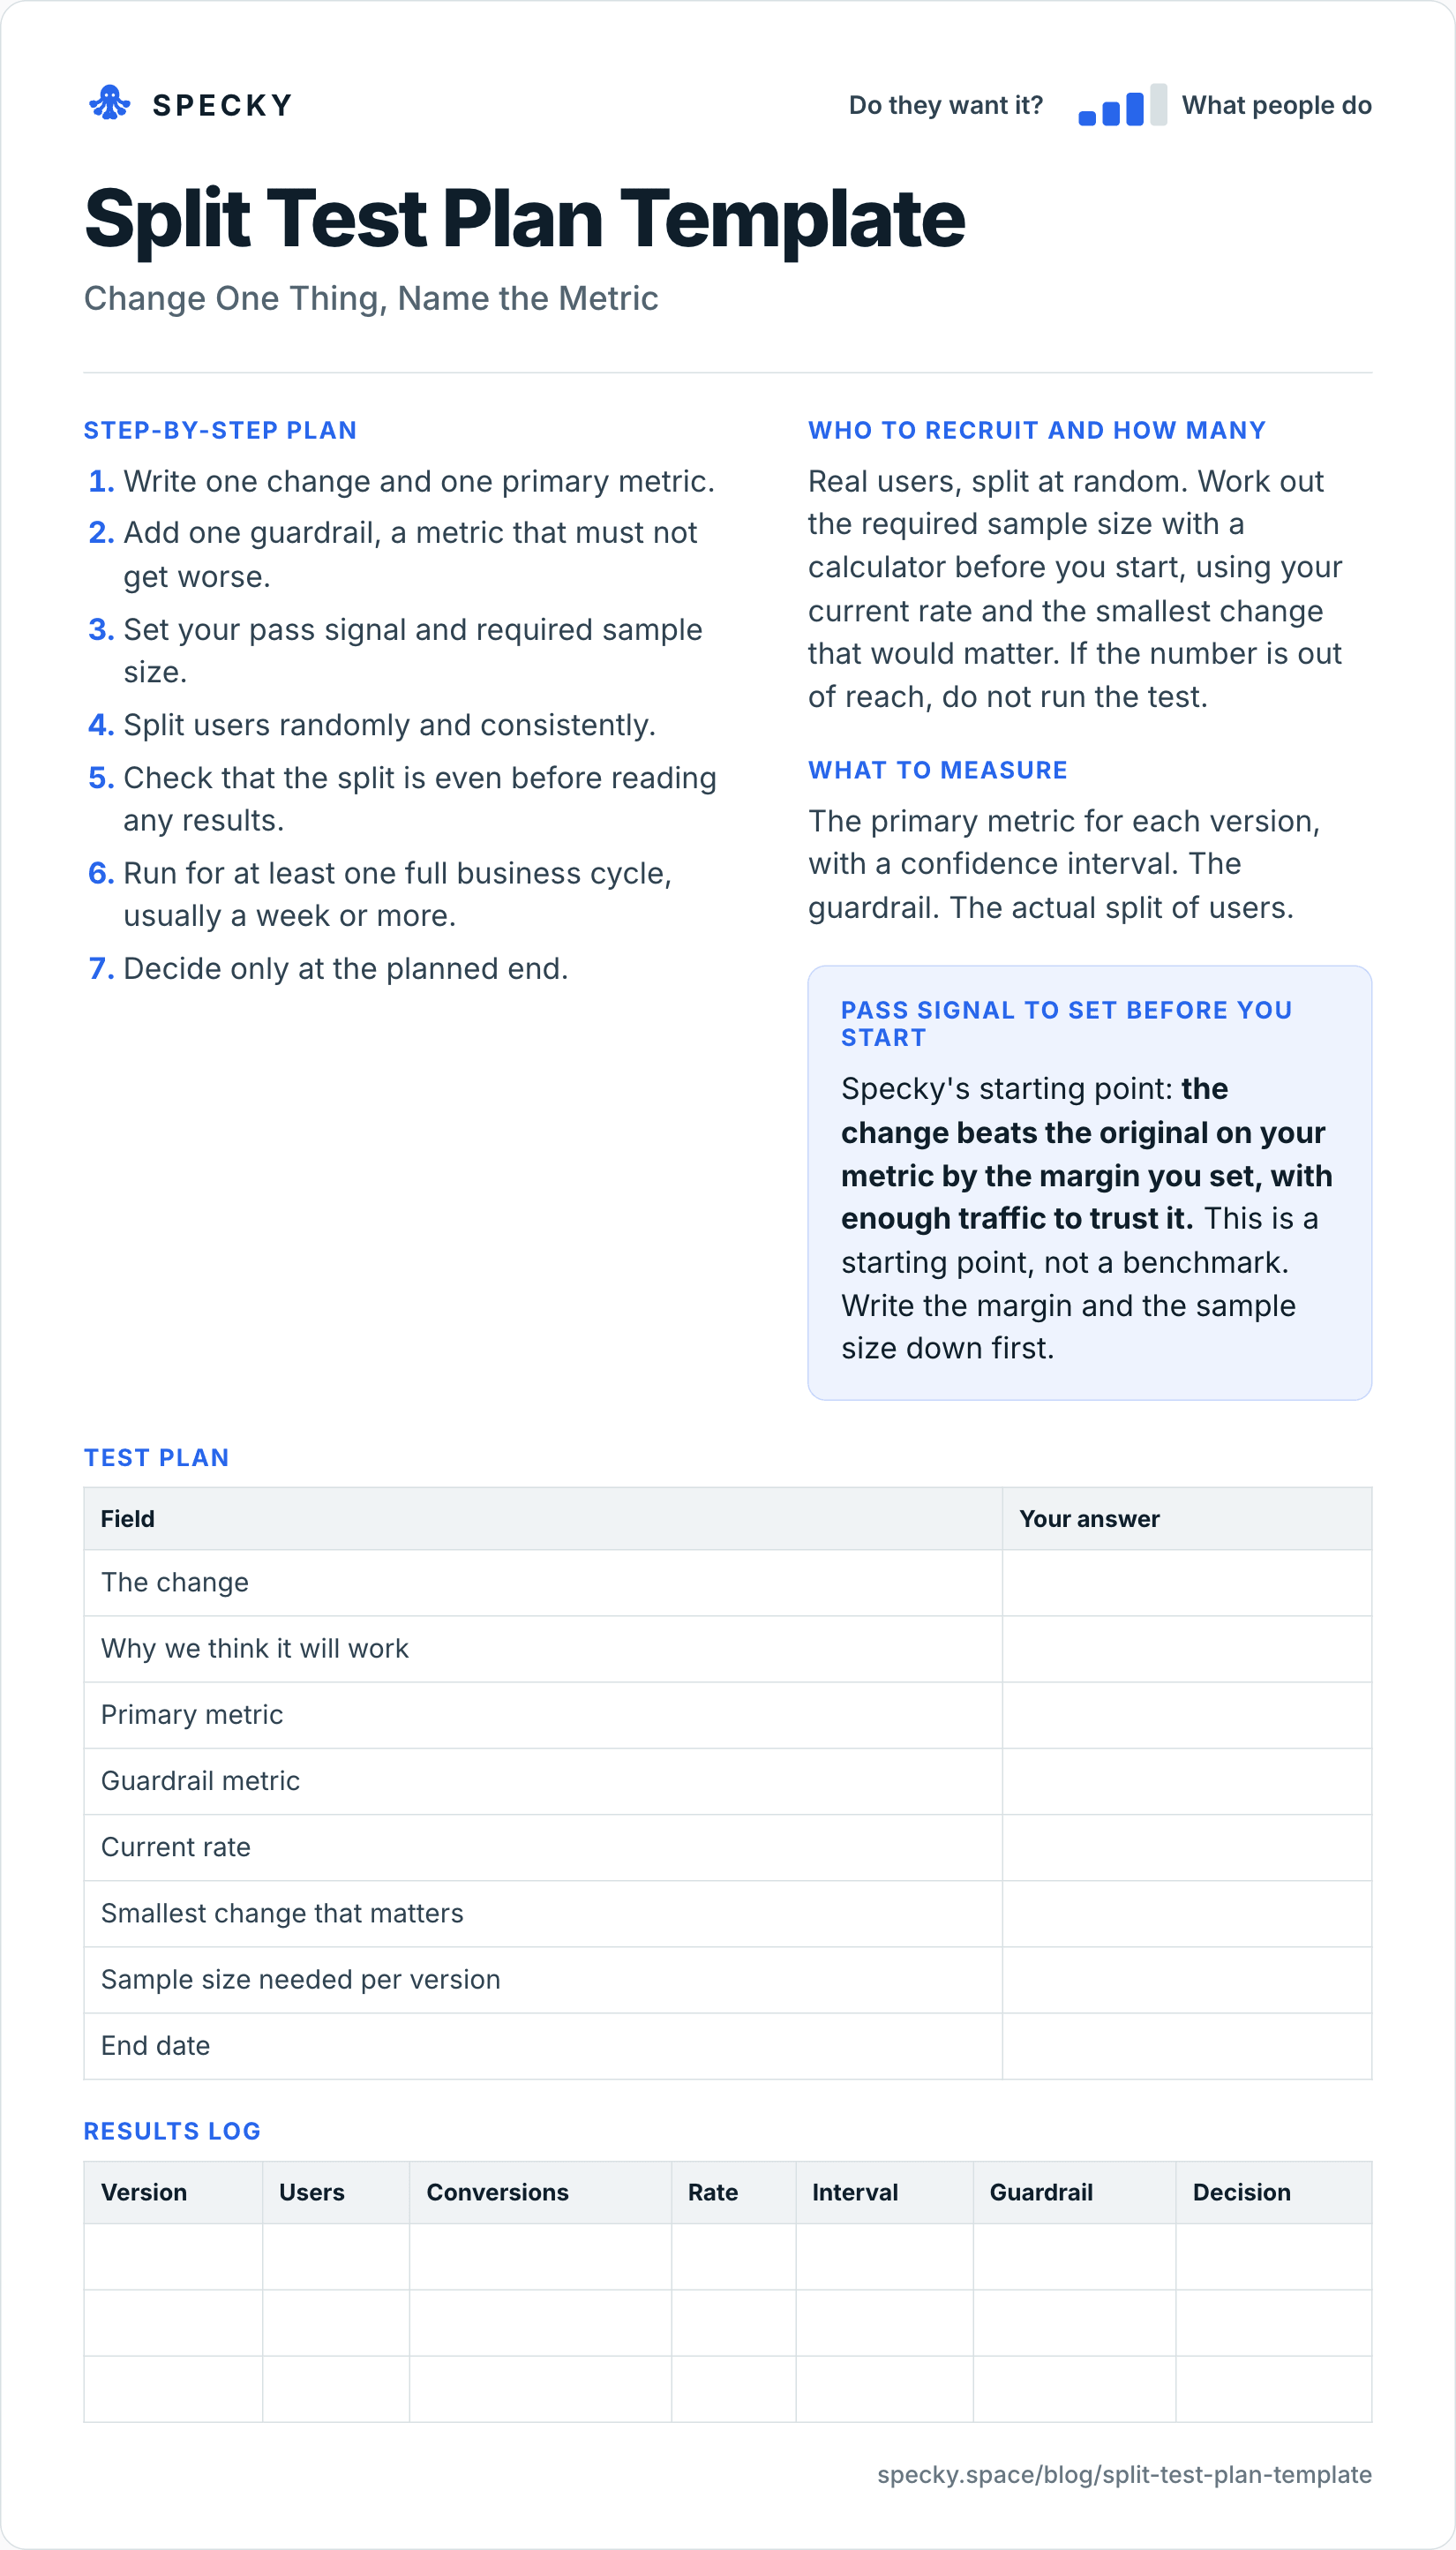
A/B-testplan template (kopieer en gebruik)
Open de afbeelding op volledige grootte, of kopieer de tekstversie hieronder.
Wie je werft en hoeveel
Echte gebruikers, willekeurig verdeeld. Bereken de vereiste steekproefgrootte met een rekenmachine voordat je begint, met je huidige percentage en de kleinste verandering die zou tellen. Is het getal buiten bereik, voer de test dan niet uit.
Stappenplan
Schrijf één verandering en één primaire metric op.
Voeg één guardrail toe, een metric die niet slechter mag worden.
Stel je slaagsignaal en de vereiste steekproefgrootte vast.
Verdeel gebruikers willekeurig en consistent.
Controleer of de verdeling gelijk is voordat je resultaten leest.
Laat de test minstens één volledige bedrijfscyclus lopen, meestal een week of langer.
Beslis pas aan het geplande einde.
Testplan
Veld
Jouw antwoord
De verandering
Waarom we denken dat het werkt
Primaire metric
Guardrail-metric
Huidig percentage
Kleinste verandering die telt
Benodigde steekproefgrootte per versie
Einddatum
Wat je meet
De primaire metric voor elke versie, met een betrouwbaarheidsinterval. De guardrail. De werkelijke verdeling van gebruikers.
Slaagsignaal dat je vóór de start vaststelt
Het uitgangspunt van Specky: de verandering verslaat het origineel op jouw metric met de marge die je hebt vastgesteld, met genoeg verkeer om erop te vertrouwen. Dit is een uitgangspunt, geen benchmark. Schrijf eerst de marge en de steekproefgrootte op.
Resultatenlogboek
Versie
Gebruikers
Conversies
Percentage
Interval
Guardrail
Beslissing
Hoeveel gebruikers heb je nodig voor een A/B-test?
Het hangt af van je huidige conversiepercentage en de kleinste verandering die het waard is om te detecteren, het minimaal detecteerbare effect. Hoe kleiner een van beide, hoe meer verkeer je nodig hebt. Met de tweezijdige formule in de gratis rekenmachine van Evan Miller, op zijn standaard 5% significantie en 80% power, is dit de benodigde steekproef per versie:
Huidig conversiepercentage
Om een relatieve stijging van 5% te detecteren
10% relatieve stijging
20% relatieve stijging
2%
ongeveer 310.000
ongeveer 78.000
ongeveer 19.800
5%
ongeveer 120.000
ongeveer 30.200
ongeveer 7.700
12%
ongeveer 46.300
ongeveer 11.700
ongeveer 2.900
20%
ongeveer 25.300
ongeveer 6.300
ongeveer 1.600
Het effect dat je wilt detecteren halveren, vergt ruwweg viermaal zoveel verkeer, en lage basispercentages hebben veel meer mensen nodig dan hoge.
Om zonder rekenmachine te checken, gebruik je de vuistregel van Evan Miller: n = 16σ² / δ², waarbij δ het minimale effect is en, voor een conversiepercentage p, σ² = p(1 − p). Bij 12% en een stijging naar 13,2%: 16 × 0,12 × 0,88 ÷ 0,012² ≈ 11.700 per versie.
Uitgewerkt voorbeeld: van steekproefgrootte naar einddatum
Dit voorbeeld is illustratief; het komt overeen met het uitgewerkte voorbeeld hieronder.
Huidig percentage: 12% van de bezoekers meldt zich aan.
Kleinste verandering die telt: een relatieve stijging van 10%, van 12% naar 13,2%.
Steekproefgrootte: ongeveer 11.700 per versie, dus ongeveer 23.400 bezoekers in totaal.
Verkeer: ongeveer 860 bezoekers per dag bereiken de aanmeldpagina.
Duur: 23.400 ÷ 860 ≈ 27 dagen. Afgerond naar hele weken: 4 weken.
Als het antwoord zes maanden was geweest, voer dan niet een kleinere test uit in de hoop dat het goed komt. Test een grotere verandering, kies een metric met een hoger basispercentage, of gebruik een methode die minder verkeer nodig heeft.
Hoe lang moet je een splittest laten lopen?
Tot je de geplande steekproefgrootte bereikt, en minstens één volledige bedrijfscyclus, meestal een week of langer, omdat gebruikers doordeweeks en in het weekend zich anders gedragen.
Waarom kijk je niet tussentijds naar de resultaten?
Dashboards tonen een p-waarde die ervan uitgaat dat je één keer kijkt, aan het eind. Elke extra blik is een nieuwe kans dat ruis de grens overschrijdt. Evan Miller liet zien dat testen na elke waarneming en stoppen bij de eerste p < 0,05 een percentage valse positieven van 26,1% geeft, meer dan vijf keer de 5% die je denkt te hebben (Evan Miller, 2010).
Moet je toch eerder kijken, leg de lat dan hoger: kijk je 10 keer, dan heb je een gerapporteerde significantie van 1,0% nodig om een echt percentage van 5% te behouden.
Waarom moet een "significant" resultaat toch gecontroleerd worden?
Kohavi en collega's rekenen het voor. Als één op de drie ideeën echt een winnaar is, het gemiddelde dat ze over Microsoft-experimenten rapporteerden, is een significant resultaat in ongeveer 89% van de gevallen een echte positieve uitkomst. Als echte doorbraken één op 500 zijn, zakt dat naar 3,1%. Verrassende resultaten moeten opnieuw worden uitgevoerd.
Wat moet je meten in een splittest?
De primaire metric voor elke versie, met een betrouwbaarheidsinterval, niet alleen een percentage.
Eén guardrail-metric die niet slechter mag worden, zoals betaalde conversie, terugbetalingen of laadtijd van de pagina.
De werkelijke verdeling van gebruikers. Als je 50/50 had gepland en bij grote aantallen 52/48 krijgt, is er iets stuk. Dat is een sample ratio mismatch. Het controleren ervan vergt alleen de verwachte verhoudingen en de waargenomen aantallen en vangt een grote verscheidenheid aan dataproblemen op (SRM-checker van Lukas Vermeer en collega's). Lees geen resultaten voordat hij is geslaagd.
Guardrails op zeldzame gebeurtenissen vragen veel verkeer: het detecteren van een daling van 10% in een betaalde conversie van 1,2% kost grofweg 130.000 gebruikers per versie. Kun je dat niet halen, schrijf dan vooraf op wat als overschrijding telt, zoals "elke daling in betalende klanten blokkeert de lancering".
Splittest versus landingspaginatest versus fake-doortest
Veroorzaakt deze verandering meer van het gedrag dat we willen?
Zet iemand de volgende stap voor dit aanbod?
Proberen bestaande gebruikers een feature te gebruiken die nog niet is gebouwd?
Vergelijking
Controle versus variant, willekeurig
Meestal één pagina tegenover een doel
Eén knop tegenover een doel
Bewijs
Causaal, gedragsmatig
Gedragsmatige interesse
Gedragsmatige interesse
Gebruik een landingspagina- of fake-doortest om te leren of er überhaupt interesse is; gebruik een splittest om te leren welke van twee versies het beter doet.
Hoe ziet een splittest er in de praktijk uit?
Dit voorbeeld is verzonnen om de methode te laten zien. Een team dat een tool voor belastingaangifte draait, wil zijn aanmeldformulier inkorten van zes velden naar drie. Ze voorspellen dat aanmeldingen minstens 10% stijgen en stellen betaalde conversie in als guardrail.
Na vier weken en 12.000 bezoekers in elke groep verhoogt het kortere formulier de aanmeldingen met 14%. Maar de betaalde conversie daalt en de guardrail wordt overschreden: de extra aanmeldingen zijn mensen met een lagere intentie die nooit afronden.
Het aanmelddoel slaagt en de guardrail faalt, dus ze lanceren het niet zoals het is. Ze proberen een kort formulier met één extra vraag over het type aangifte van de klant.
Zo zou het logboek eruit kunnen zien:
Versie
Gebruikers
Aanmeldingen
Percentage
Betalende klanten
Beslissing
Zes velden (controle)
12.000
1.440
12,0%
144
Drie velden
12.000
1.642
13,7%
131
Niet lanceren
De stijging in aanmeldingen is echt: +1,7 procentpunt, met een 95%-interval van ongeveer +0,8 tot +2,5. De daling in betalenden, van 144 naar 131 klanten, is bij dit verkeer te klein om te bewijzen, maar de vooraf geschreven guardrail-regel van het team zei dat minder betalende klanten de release blokkeerde.
Wat zijn de meest gemaakte fouten bij splittesten?
Tussentijds kijken. Vroeg checken en stoppen als het goed lijkt, levert valse winsten op.
Meerdere dingen veranderen. Je weet niet welke werkte.
Geen guardrail. Je kunt een metric winnen en het bedrijf verliezen.
Te weinig verkeer. Een test zonder voldoende power is gewoon dure ruis.
Nieuwigheid negeren. Mensen klikken op nieuwe dingen alleen omdat ze nieuw zijn.
Wanneer het niet werkt: bij weinig verkeer, bij grote weddenschappen die niet te splitsen zijn, bij effecten die maanden duren, en waar gebruikers met elkaar praten, zodat de groepen niet onafhankelijk zijn.
Is het ethisch om een splittest uit te voeren zonder het gebruikers te vertellen?
Gewone veranderingen, zoals een korter formulier of een nieuwe kop, worden routinematig getest zonder het elke gebruiker te vertellen. De grens is schade. Test niets wat je niet voor iedereen zou willen lanceren, toon geen verschillende prijzen aan vergelijkbare klanten zonder duidelijk beleid, en tel alleen mensen mee die je toestemmingsbanner je laat volgen.
Zo voer je het uit in Specky
Klik op de Assumptions-pagina op de notitie en kies Pick a test, daarna Split test. Specky vult de stappen, het slaagsignaal en een planning van twee weken in.
Voor een verandering binnen je product voer je de splitsing uit met je eigen feature-flag- of experimenttool. Specky verandert je product niet. Het leest de getallen uit gekoppelde analytics en jij voegt het resultaat toe als bewijs.
Test je een Specky-validatiepagina, dan kan de splitsing daar plaatsvinden. Stel in Experiment analytics één controle en tot vijf varianten in, en Specky toont de conversie per versie, 95%-intervallen, of je genoeg mensen hebt en een optionele guardrail. Het oordeel blijft voorzichtig zolang de steekproef klein is.
Klik op Start running en leg het resultaat vast aan het geplande einde.
Een geslaagde test verschijnt op het bord als Supported, omdat een gecontroleerde vergelijking van wat mensen deden gedrag is.
Wat doe je met elke uitkomst?
Supported: Lanceer de verandering. Noteer de grootte van de winst en controleer de analytics over een maand opnieuw om te zien of het effect blijft.
Unclear: Het resultaat valt binnen de foutmarge. Houd de eenvoudigere versie, of ontdek waarom met een paar interviews.
Contradicted: De verandering had geen effect of maakte het erger. Lanceer haar niet. Elke weddenschap die op deze notitie rust, verschijnt nu als Contradicted.
Veelgestelde vragen
Hoeveel verkeer heb je nodig voor een splittest?
Het hangt af van je huidige conversiepercentage en de kleinste verandering die zou tellen. Bij een conversiepercentage van 12% vergt het detecteren van een relatieve stijging van 10% ongeveer 11.700 gebruikers per versie bij standaardinstellingen; bij 2% ongeveer 78.000. Als je het getal niet binnen redelijke tijd haalt, gebruik dan een andere methode.
Waarom stop je een splittest niet vroegtijdig?
Stoppen als de resultaten goed lijken, maakt valse winsten veel waarschijnlijker, omdat resultaten in het begin sterk schommelen. In het slechtste geval van Evan Miller geeft testen na elke bezoeker een percentage valse positieven van 26,1% in plaats van 5%. Bepaal vooraf je einddatum en steekproefgrootte.
Wat is een guardrail-metric?
Een guardrail-metric is een getal dat tijdens een test niet slechter mag worden, ook al verbetert je hoofdmetric, zoals betaalde conversie, terugbetalingen of paginasnelheid. Het voorkomt dat je een metric wint en het bedrijf schaadt. Schrijf de regel voor wat als overschrijding telt op voordat de test begint.
Wat is het verschil tussen een splittest en een A/B-test?
In de praktijk geen. Beide tonen een verandering aan een willekeurig deel van de gebruikers en vergelijken één metric met een controlegroep; onderzoekers noemen het een online gecontroleerd experiment. Meerdere veranderingen in combinatie testen is een multivariate test, die veel meer verkeer vraagt.
GDPR-aligned. EU workspace data is stored in Frankfurt, Germany. GDPR and EU data Built in Vienna, Austria. A product of influence solutions fm GmbH (FN 675374y). Imprint 14-day trial. Card required, and nothing is charged until day 14. 30-day refund after subscribing. See pricing