10 oktober 2026Bijgewerkt op Fathy Shalaby15 min leestijd
Acceptatiechecklist voor AI-gegenereerde code: de reviewgids voor PM's
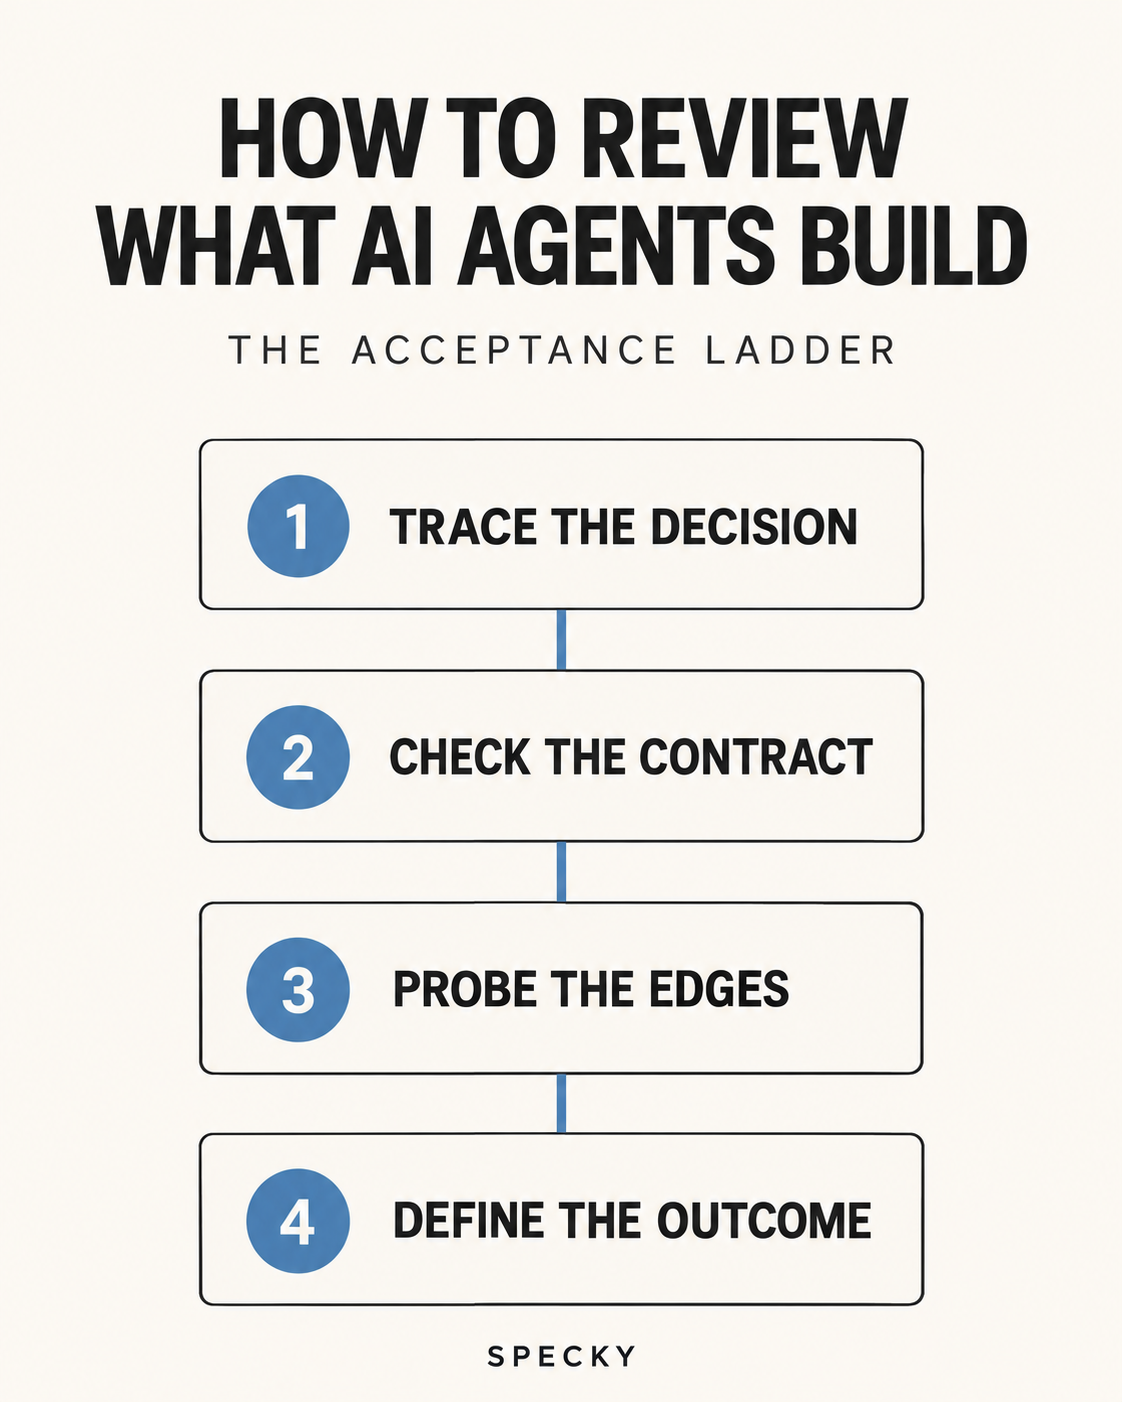
Bouwen werd goedkoop; het resultaat accepteren niet. De Acceptance Ladder met vier sporten helpt PM's om door agents gebouwde wijzigingen te toetsen aan de beslissing, de brief, de randgevallen en de uitkomst.
Een acceptatiechecklist voor AI-gegenereerde code is de korte lijst met controles die een product manager uitvoert voordat een door een agent gebouwde wijziging als klaar geldt. Engineers beoordelen hoe de code is geschreven; de PM controleert of het de juiste wijziging is. Wij gebruiken vier sporten, in volgorde: herleid het naar een beslissing, vergelijk het met de brief, test de randgevallen en bepaal hoe je weet dat het gewerkt heeft.
De belangrijkste punten
Anthropic beschrijft softwareontwikkeling als een verschuiving "van code schrijven naar het orkestreren van agents die code schrijven" (Anthropic, 2026). De schaarse vaardigheid verschuift naar de reviewstoel.
66% van de ontwikkelaars zegt dat hun grootste frustratie met AI-tools oplossingen zijn die bijna goed zijn, maar net niet (Stack Overflow, 2025). Bijna goede wijzigingen komen door een "ziet er goed uit"-review.
Vloeiende uitvoer vertekent het oordeel: in één gerandomiseerde studie geloofden ontwikkelaars dat AI hen 20% sneller had gemaakt, terwijl het hen 19% trager had gemaakt (METR, 2025).
Agents hebben de neiging te veel te bouwen. De surplusronde (gedrag opsommen waar niemand om vroeg) is de controle die de meeste teams overslaan.
De checklist vervangt geen code- of securityreview: 45% van de AI-gegenereerde codevoorbeelden in een test uit 2025 bevatte bekende kwetsbaarheden (Veracode, 2025).
Waarom is "ziet er goed uit" de verkeerde lat voor AI-gegenereerde code?
De meeste teams beoordelen agentuitvoer zoals ze vroeger een pull request van een mens beoordeelden: de diff doorbladeren, door de preview klikken, goedkeuren. Dat werkt als een teamgenoot de context uit het planningsoverleg en de klantgesprekken met zich meedraagt. Het faalt als een agent alleen meeneemt wat de brief heeft vastgelegd.
Als de brief vaag was, vult de agent het gat met het statistisch meest plausibele gedrag, en plausibel is niet hetzelfde als correct. De wijziging compileert, de preview rendert, het happy path werkt en de PM keurt goed. Twee weken later merkt iemand dat er stilletjes een randvoorwaarde is weggevallen die niemand had opgeschreven, of dat een aangrenzend probleem is opgelost in plaats van het probleem uit de brief. Er was niets mis met de code. De acceptatiestap stelde simpelweg nooit de juiste vragen.
Drie dingen maken agentuitvoer moeilijker te beoordelen dan menselijk werk:
Volume. Goedkope generatie betekent meer kandidaatwijzigingen per week, dus reviewtijd wordt de bottleneck.
Zelfvertrouwen. Agents beschrijven hun eigen werk vloeiend. Een nette samenvatting is geen bewijs. METR's studie uit 2025 met 16 ervaren ontwikkelaars en 246 echte issues vond dat ontwikkelaars verwachtten dat AI hen 24% sneller zou maken en na het werk nog steeds geloofden dat het hen 20% sneller had gemaakt, terwijl het gemeten resultaat 19% trager was (METR, 2025). METR zegt nu dat die resultaten van begin 2025 verouderd zijn, en zijn vervolg van februari 2026 vond kleine geschatte versnellingen die het een onbetrouwbaar signaal noemt (METR, 2026). De blijvende les is de waarnemingskloof, niet het snelheidsgetal.
Ontbrekend intentiespoor. Zonder link van de wijziging terug naar de beslissing die ze uitvoert, kun je "gebouwd zoals gespecificeerd" niet onderscheiden van "gebouwd zoals afgeleid".
De deliverydata wijzen dezelfde kant op. Googles DORA-onderzoek van 2024 vond dat een toename van 25% in AI-gebruik samenging met 7,5% betere documentatiekwaliteit, 3,4% betere codekwaliteit en 3,1% snellere codereview. Toch schatten de onderzoekers bij toenemend gebruik ook een daling van 1,5% in deliverydoorvoer en van 7,2% in deliverystabiliteit (DORA, 2024). Het rapport van 2025 vat het samen: AI versterkt de bestaande sterke en zwakke punten van een organisatie (DORA, 2025). Een zwakke acceptatiestap is een van de zwaktes die het versterkt.
Wat moet een PM controleren en wat een engineer?
Splits de review. Googles engineeringpraktijken sommen op waar een codereviewer op let: ontwerp, functionaliteit, complexiteit, tests, naamgeving, commentaar, stijl, consistentie, documentatie en context (Google). Het meeste daarvan is engineeringwerk. Eén vraag op de lijst hoort bij product: "Is what the developer intended good for the users of this code?"
Vraag
Van wie
Waar wordt ze beantwoord
Is de code goed ontworpen, leesbaar en getest?
Engineer
Codereview
Is ze veilig en gaat ze goed om met rechten?
Engineer (met securitytooling)
Codereview, scanners
Welke beslissing of welk bewijs voert deze wijziging uit?
PM
Acceptance Ladder, sport 1
Heeft ze gebouwd wat de brief zei, en alleen dat?
PM
Sport 2
Gedraagt ze zich verdedigbaar bij leeg, fout, grens, rechten en herhaling?
PM en engineer samen
Sport 3
Hoe en wanneer weten we dat het voor gebruikers werkte?
PM
Sport 4
In een solo-foundersteam draagt één persoon beide petten. Doe de twee reviews toch in aparte rondes: code lezen op juistheid en gedrag lezen op intentie vragen verschillende aandacht.
De Acceptance Ladder: vier controles voordat een door een agent gebouwde wijziging klaar is
Elke sport stelt één vraag. Je klimt alleen naar de volgende sport als de huidige slaagt. Blijft een wijziging op sport één steken, dan besteed je geen tijd aan sport vier.
Sport 1: Herleidbaarheid. Welke beslissing wordt hier uitgevoerd?
Beantwoord voordat je code leest één vraag: naar welke beslissing of welk bewijs herleidt deze wijziging?
Een wijziging moet naar een specifiek item wijzen: een beslissingsrecord, een klantinzicht, een opportunity, een experiment. Kun je het niet in één zin noemen, stop dan. Of het werk is nooit onderbouwd, of de onderbouwing zit in iemands hoofd en de agent heeft haar nooit gezien.
In Specky dient de Product Graph hiervoor. Beslissingen, inzichten en tickets zijn gekoppelde nodes, zodat een agentrun de omringende context kan ophalen voordat hij iets plant. De eerste controle van de reviewer is eenvoudig of die link bestaat en of het aangehaalde bewijs zegt wat de wijziging beweert.
Als de brief zelf uit een AI-concept komt, controleer dan eerst het bewijs ervan voordat je de code ertegen toetst. Onze Claim Trace voor door AI geschreven specs kost ongeveer 15 minuten.
Slaagvoorwaarde: één beslissing of inzicht, benoemd, met bewijs dat in twee klikken bereikbaar is.
Sport 2: Contract. Heeft ze gebouwd wat de brief zei, en alleen dat?
Vergelijk de wijziging nu regel voor regel met de schriftelijke brief. Niet "voelt het goed", maar een letterlijke diff tussen acceptatiecriteria en waargenomen gedrag.
Doe twee rondes:
Dekkingsronde. Zoek voor elk acceptatiecriterium in de brief het gedrag dat eraan voldoet. Markeer elk als voldaan, deels voldaan of ontbrekend.
Surplusronde. Som gedrag op dat de wijziging introduceert en waar geen criterium om vroeg. Agents voegen vaak behulpzame extra's toe: een nieuwe instelling, een extra kolom, een terugvalpad. Elk daarvan is niet-beoordeelde scope. Houd het of schrap het bewust.
De surplusronde is die welke teams overslaan, en daar verschilt agentwerk het meest van menselijk werk. In onze ervaring bouwt een mens ten opzichte van een brief eerder te weinig, en een agent eerder te veel.
Slaagvoorwaarde: elk criterium als voldaan gemarkeerd, elk surplus-item uitdrukkelijk behouden of verwijderd.
Sport 3: Randen. Wat gebeurt er als de invoer fout, leeg of vijandig is?
Agents zijn sterk op het happy path omdat prompts dat beschrijven. Sport drie gaat naar plekken waar prompts zelden komen. Schrijf vijf situaties op en probeer ze stuk voor stuk:
Lege toestand: nog geen data.
Foutstatus: de upstream-aanroep faalt.
Grens: de grootste en de kleinste realistische invoer.
Rechten: een gebruiker die dit niet hoort te zien, probeert het toch.
Herhaling: de actie wordt twee keer achter elkaar uitgevoerd.
Je hebt geen uitputtende QA nodig. Je hebt de vijf situaties nodig die een echte klant in de eerste week tegenkomt. Als de brief daarvoor geen gedrag specificeerde, is dat een gebrek in de brief, en de oplossing hoort in de brief, niet alleen in de code.
De rechtencontrole is belangrijker bij AI-gegenereerde code. Veracode testte in 2025 meer dan 100 taalmodellen en vond dat 45% van de gegenereerde codevoorbeelden securitytests niet doorstond, met Java op een faalpercentage van 72% en 86% van de relevante voorbeelden die zich niet verdedigden tegen cross-site scripting (Veracode, 2025). Een PM kan dat niet auditen, maar kan er wel op aandringen dat "een gebruiker zonder toegang probeert dit te zien" een geschreven, getest criterium is en dat securitytooling bij elke agentwijziging draait.
Slaagvoorwaarde: alle vijf situaties gedragen zich op een manier die je tegenover een klant zou verdedigen.
Sport 4: Bewijs van uitkomst. Hoe weten we dat het gewerkt heeft?
Een wijziging kan de eerste drie sporten halen en toch nutteloos zijn. De laatste sport vraagt wat je gaat meten en wanneer je gaat kijken.
Schrijf de controle op vóór de release: de metric of het signaal, de verwachte richting en een datum. "We zien wel hoe het gaat" is geen controle. Hier wordt ook de hype weggefilterd: een feature die snel live gaat maar geen uitkomstcontrole heeft, is een gok met een deploydatum.
Slaagvoorwaarde: een benoemd signaal, een verwachte richting en een kalenderdatum om het af te lezen.
Kopieerbare acceptatiechecklist voor AI-gegenereerde code
Plak dit in het pull-requestsjabloon of het ticket. Eén blok per door een agent gebouwde wijziging.
ACCEPTATIECHECKLIST: [wijziging / PR-link]
Reviewer: [naam]   Datum: [datum]

SPORT 1 HERLEIDBAARHEID
[ ] Beslissing of inzicht dat dit uitvoert: [link]
[ ] Bewijs erachter is in twee klikken bereikbaar en zegt wat de brief beweert

SPORT 2 CONTRACT
Dekking (één regel per acceptatiecriterium):
  [criterium 1]  voldaan / deels / ontbreekt
  [criterium 2]  voldaan / deels / ontbreekt
Surplus (gedrag waar geen criterium om vroeg):
  [item]  behouden (criterium toegevoegd) / schrappen (apart aangemaakt)

SPORT 3 RANDEN
[ ] Lege toestand    [ ] Foutstatus         [ ] Grensinvoer
[ ] Rechten          [ ] Herhaalde actie
Gevonden gebreken in de brief (toevoegen aan brief, niet alleen aan code): [lijst]

SPORT 4 UITKOMST
Signaal: [metric]   Verwachte richting: [omhoog/omlaag]   Aflezen op: [datum]

ENGINEERING (niet de beslissing van de PM, maar bevestig dat het gebeurd is)
[ ] Codereview gedaan   [ ] Tests toegevoegd/bijgewerkt   [ ] Securitychecks gedraaid

RESULTAAT: accepteren / terugsturen met briefwijzigingen
Hoe ziet de checklist eruit bij een echte wijziging?
Stel dat je team een agent vroeg om een actie "bulk archiveren" toe te voegen aan een feedbackinbox.
Sport 1. De brief linkt naar een inzicht: support besteedt tijd aan het opruimen van verouderde items, en drie klantgesprekken noemen het. Het bewijs is bereikbaar. Geslaagd.
Sport 2. De dekkingsronde vindt alle vier de criteria voldaan. De surplusronde vindt dat de agent ook een "ongedaan maken"-toast en een nieuw filtertabblad "gearchiveerd" heeft toegevoegd. Het ongedaan maken is het behouden waard en krijgt achteraf een criterium. Het filtertabblad verandert de navigatie en was niet gevraagd, dus het wordt geschrapt en als aparte opportunity vastgelegd. Na één aanpassing geslaagd.
Sport 3. De lege toestand toont een leeg paneel zonder uitleg. Gezakt. De oplossing gaat als ontbrekend criterium in de brief en dan terug naar de agent.
Sport 4. Het signaal is de mediane tijd om de inbox leeg te maken, verwacht dalend, af te lezen over twee weken.
De review leverde één afkeuring en twee aanpassingen op, ontdekt vóór de release. Een "ziet er goed uit"-review had het lege paneel en het ongevraagde navigatietabblad samen live gezet.
Ingevuld in de checklist luidt de resultaatregel: 4 van 4 criteria voldaan, 2 surplus-items (1 behouden, 1 geschrapt), 1 van 5 randgevallen gefaald, uitkomstmeting gepland op dag 14. Terugsturen met één briefwijziging.
Hoe schrijf je acceptatiecriteria die een agent niet verkeerd kan lezen?
De Ladder is maar zo goed als de criteria in sport twee. Atlassian definieert acceptatiecriteria als de voorwaarden waaraan een stuk werk moet voldoen om af te zijn, en somt de kenmerken van goede criteria op: helder, testbaar, gericht op de uitkomst in plaats van de methode, waar mogelijk meetbaar en onafhankelijk van elkaar (Atlassian). Voor agents is testbaar het belangrijkst: een criterium dat een agent niet kan verifiëren, is een criterium dat hij gaat interpreteren.
Given-When-Then, ontwikkeld door Daniel Terhorst-North en Chris Matts als onderdeel van behaviour-driven development, is hiervoor een goede vorm (Fowler, 2013). Given is de toestand vooraf, When de actie, Then de verwachte verandering.
Vaag (agent gaat gokken)
Testbaar (agent kan controleren)
Archiveren werkt goed
Given 3 geselecteerde items, when de gebruiker op Archiveren klikt, then verdwijnen alle 3 binnen 1 seconde uit de inboxlijst
Lege toestanden afhandelen
Given geen items in de inbox, when de pagina laadt, then toon "Niets te beoordelen" en een link naar instellingen
Alleen admins mogen archiveren
Given een gebruiker met de rol Viewer, when die de inbox opent, then wordt de knop Archiveren niet getoond en geeft de API 403 terug
Maak het snel
Given 500 items, when de gebruiker alles selecteert en archiveert, then is de actie in minder dan 3 seconden klaar
Maak niets kapot
Given een gearchiveerd item, when de gebruiker de directe link opent, then opent het alleen-lezen met een label "Gearchiveerd"
De Ladder werkt het best als een deel ervan niet handmatig is. Twee praktische zetten:
Valideer het plan voordat de agent code schrijft. Specky biedt dit via zijn MCP-server voor codeeragents: een agent roept validate_agent_plan aan tegen je engineeringstandaarden voordat hij begint, en validate_agent_change voordat hij succes meldt. Dat trekt sport twee naar voren, zodat het plan aan de regels wordt getoetst zolang het nog goedkoop is om te wijzigen.
Houd het bewijs eraan vast. Als de beslissing, de brief, de agentrun en de uitkomstcontrole allemaal nodes in één graph zijn, is sport één geen zoektocht meer. De reviewer opent de wijziging en de reden staat er al naast.
De Ladder draaien in een klein team
Je hebt geen reviewcommissie nodig. Voor een solo founder of een team van drie tot tien mensen is de Ladder een gewoonte van vijf minuten per wijziging, en de volgorde telt zwaarder dan het ceremonieel.
Begin met het schrijven van acceptatiecriteria als korte, controleerbare zinnen in de brief zelf, zoals "gearchiveerde items verdwijnen uit de inboxlijst" in plaats van "archiveren werkt goed". Zulke zinnen maken de dekkingsronde mechanisch in plaats van een kwestie van smaak. Houd daarna een vaste lijst van je vijf randsituaties bij, zodat sport drie niet elke keer opnieuw wordt uitgevonden. Maak tot slot de uitkomstcontrole onderdeel van de definition of done: als de wijziging geen signaal en geen datum heeft, is ze niet klaar om te mergen.
Als een wijziging op een sport faalt, weersta dan de neiging om haar in de reviewthread te lappen. Stuur haar terug met het ontbrekende criterium toegevoegd aan de brief. De brief is het blijvende artefact; de thread verdwijnt. Over een maand worden je briefs scherper en daalt je faalpercentage op sport twee en drie, en dat is de echte winst.
Wat je kunt meten aan je eigen reviewproces
Behandel de Ladder als een proces dat je kunt inspecteren:
Verdeling van sportfalen. Als de meeste fouten op sport twee vallen, zijn je briefs het probleem. Vallen ze op sport drie, dan slaan je prompts randgevallen over.
Surplusratio. Hoe vaak voegt een agent ongevraagde scope toe? Een stijgende ratio betekent dat je briefs te veel ruimte laten.
Voltooiing van uitkomstcontrole. Bij hoeveel opgeleverde wijzigingen vond de sport-vier-meting plaats op de afgesproken datum? Dit getal toont of je leert of alleen oplevert.
Je hebt hiervoor geen dashboard nodig. Een tabel met één rij per beoordeelde wijziging is genoeg voor de eerste maand.
Wanneer werkt deze checklist niet?
Het is geen code- of securityreview. De Ladder controleert intentie en gedrag. Doordat 39% van de ontwikkelaars in DORA's enquête van 2024 weinig of geen vertrouwen meldt in AI-gegenereerde code, blijven engineeringreview en geautomatiseerde controles verplicht (DORA, 2024).
Het is overdreven voor triviale wijzigingen. Een tekstcorrectie of kleurwijziging heeft hooguit sport twee nodig. Bewaar de volledige Ladder voor alles wat een klant gebruikt of wat data of rechten raakt.
Het kan een slechte beslissing niet redden. Sport één controleert dat er een beslissing is, niet dat ze juist was. Is het onderliggende probleem onduidelijk, ga dan terug naar een probleemstelling voordat je meer code beoordeelt.
Het hangt ervan af dat de uitkomstmeting echt gebeurt. Combineer sport vier bij AI-features, waarvan de uitvoer zelf varieert, met een AI-evaluatieframework in plaats van één enkele metric.
Veelgestelde vragen
Wat is een acceptatiechecklist voor AI-gegenereerde code?
Het is een korte lijst met productcontroles die worden uitgevoerd voordat een door een agent gebouwde wijziging als klaar geldt: welke beslissing ze uitvoert, of ze overeenkomt met de brief en niets meer, hoe ze zich gedraagt in vijf randsituaties en hoe je weet dat ze gewerkt heeft. Ze staat naast codereview, niet in plaats ervan.
Moeten product managers code beoordelen die door AI-agents is geschreven?
PM's moeten gedrag beoordelen, niet codestijl. Lees de brief naast wat de wijziging doet, doorloop de randgevallen in een preview en controleer het uitkomstplan. Laat ontwerp, tests en security aan engineers en tooling. In een solo team doe je beide, maar in aparte rondes.
Hoe lang duurt een acceptatiereview?
Voor een typische wijziging ter grootte van een feature ongeveer vijf minuten, zodra je briefs testbare criteria bevatten en je een vaste lijst randgevallen bijhoudt. De eerste reviews duren langer omdat ze ontbrekende criteria blootleggen. Die tijd verschuift naar het schrijven van betere briefs in plaats van te verdwijnen.
Wat is het verschil tussen acceptatiecriteria en een definition of done?
Acceptatiecriteria zijn specifiek voor één wijziging: wat deze feature moet doen. Een definition of done geldt voor elke wijziging: code beoordeeld, tests geslaagd, securitychecks gedraaid, uitkomstcontrole ingepland. Atlassian merkt op dat de twee termen soms door elkaar worden gebruikt, maar ze gescheiden houden maakt agentreviews makkelijker.
Waarom voegen AI-agents features toe waar niemand om vroeg?
Agents vullen gaten in de brief met plausibel gedrag, en extra's zoals ongedaanmaakknoppen, filters of instellingen zijn plausibel. Sommige zijn nuttig. Het probleem is dat elk ervan niet-beoordeelde scope is. De surplusronde in sport twee dwingt je elk extra bewust te behouden of te schrappen, en een criterium toe te voegen voor alles wat je behoudt.
Kan een AI-agent zijn eigen werk toetsen aan acceptatiecriteria?
Gedeeltelijk. Agents kunnen tests draaien en gedrag vergelijken met geschreven criteria, en tools die een plan valideren voordat er gecodeerd wordt, vangen fouten vroeg af. Maar agents beschrijven hun eigen werk vloeiend, en vloeiendheid is geen bewijs. Een mens voert nog steeds sport één (is dit de juiste beslissing?) en sport vier (heeft het gebruikers geholpen?) uit.
GDPR-aligned. EU workspace data is stored in Frankfurt, Germany. GDPR and EU data Built in Vienna, Austria. A product of influence solutions fm GmbH (FN 675374y). Imprint 14-day trial. Card required, and nothing is charged until day 14. 30-day refund after subscribing. See pricing