5 listopada 2026Zaktualizowano Fathy Shalaby16 min czytania
Synteza badań z AI: oddziel dowody od interpretacji
AI porządkuje folder z wywiadami w kilka minut, ale badania pokazują, że pomija tematy interpretacyjne. Pięciostopniowy workflow, prompt i lista kontrolna przeglądu utrzymują każde twierdzenie powiązane ze źródłem.
Udostępnij
Ten artykuł został przetłumaczony z języka angielskiego. Przeczytaj oryginał
Synteza badań z AI to użycie modelu językowego do uporządkowania notatek z wywiadów, zgłoszeń do supportu i obserwacji sesji w kandydackie tematy, podczas gdy ludzie sprawdzają każdy temat z oryginalnymi dowodami i biorą odpowiedzialność za interpretację. Skraca pierwszy przebieg z godzin do minut. Zawodzi, gdy wygenerowane tematy traktuje się jak ustalenia: w opublikowanych porównaniach modele zgadzają się z badaczami-ludźmi znacznie częściej w tematach opisowych niż interpretacyjnych.
AI potrafi w kilka sekund zamienić folder notatek z wywiadów w uporządkowane podsumowanie. To przydatne do znajdowania materiału wartego sprawdzenia. To też łatwy sposób, by niepewną interpretację zamienić w pewnie brzmiącą decyzję produktową. Ten przewodnik jest dla founderów, pierwszych PM-ów i product engineerów, którzy mają garść rozmów, zgłoszeń i notatek o użytkowaniu, a nie dział badań z czasem na ponowne przeczytanie wszystkiego.
Najważniejsze wnioski
W badaniu z 2024 roku ChatGPT i Bard znalazły po 5 z 7 tematów, które znaleźli ludzcy koderzy (71%), ale zgadzały się z ludźmi tylko w 36–47% pojedynczych kodów (Prescott et al., 2024).
Ta sama analiza AI trwała około 20 minut, wobec średnio 567 minut u ludzkich koderów. Szybkość jest realna, precyzja nie.
W 30 japońskich wywiadach klinicznych ChatGPT-4 zgadzał się z badaczami w ponad 80% tematów opisowych, ale tylko w około 30% tematów wymagających interpretacji kulturowej lub emocjonalnej (Sakaguchi et al., 2025).
67% praktyków UX, którzy analizują własne dane badawcze, często lub zawsze używa do tego AI, a jednak jakość wyników jest główną barierą we wdrożeniu, wskazaną przez 54% (NN/g, 2026).
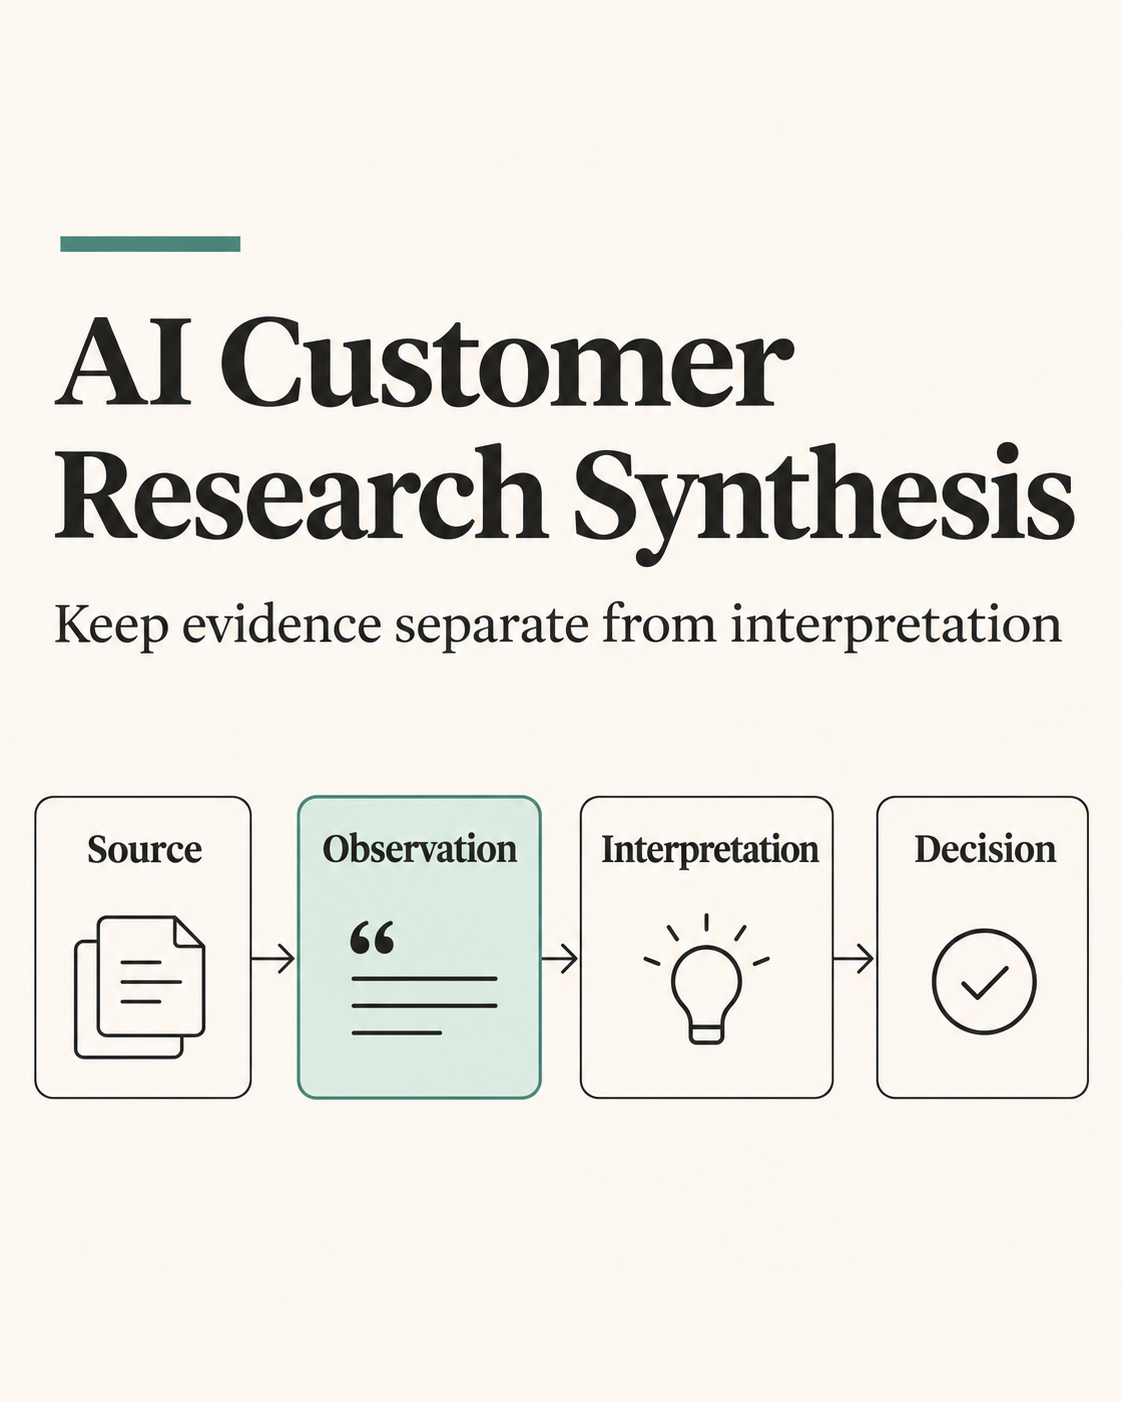
Trzymaj cztery warstwy osobno: źródło, obserwacja, interpretacja, decyzja. Przy pierwszych dwóch AI może pomagać. Dwie ostatnie należą do ludzi.
Czym jest synteza badań z AI i czego nie powinna robić?
Synteza to krok po wywiadach: znalezienie wzorców i istotnych różnic między rozmowami, a potem ustalenie, co oznaczają dla decyzji produktowej. Nasz przewodnik o tym, jak analizować wywiady z klientami, opisuje metodę ręczną. Synteza badań z AI przekazuje modelowi część tej pracy: transkrypcję, wyciąganie obserwacji, grupowanie podobnych wypowiedzi i szkicowanie etykiet tematów.
Nie powinna natomiast wyciągać wniosków. Model nie zna Twojej strategii, historii konta klienta ani tego, który uczestnik słabo pasował do badania. Gdy Nielsen Norman Group przeanalizowała w 2023 roku generatory insightów oparte na AI, narzędzia nie potrafiły uwzględnić celów badania, wcześniejszych ustaleń ani kontekstu każdego uczestnika, przez co ich tematy wychodziły bez priorytetów (NN/g, 2023).
Dlaczego dowody i opowieść to dwie różne rzeczy?
Wyobraź sobie trzech rozmówców opisujących mylący krok konfiguracji. Jeden mówi, że nie wiedział, które źródło połączyć. Drugi połączył niewłaściwe konto. Trzeci prosi o checklistę konfiguracji.
Obserwacje są konkretne. „Użytkownicy potrzebują checklisty onboardingu” to już interpretacja. „Problemem jest wybór integracji” to kolejna. Żadnej z nich nie należy zapisywać tak, jakby była dosłownym cytatem.
Użyteczna synteza utrzymuje widoczne cztery warstwy:
Źródło: oryginalny wywiad, wiadomość do supportu lub obserwowana sesja.
Obserwacja: to, co osoba powiedziała lub zrobiła, z kontekstem wystarczającym do interpretacji.
Interpretacja: możliwa potrzeba, przyczyna lub wzorzec, który wnioskujesz.
Decyzja: co zespół zrobi, przetestuje, odłoży lub czego dowie się dalej.
Gdy te warstwy zlewają się w jedno podsumowanie, zespół traci możliwość zakwestionowania interpretacji bez podważania, czy samo źródło jest prawdziwe. NN/g mówi o tej zasadzie badań wprost: trzeba „odróżniać nasze interpretacje lub założenia od tego, co uczestnicy powiedzieli lub zrobili” („differentiate between our interpretations or assumptions and what the participants said or did”, NN/g, 2023). Podsumowania AI to płynna proza, a w płynnej prozie ta granica znika najłatwiej.
Jak dokładna jest AI w analizie badań jakościowych?
Dość dokładna, by znaleźć oczywiste tematy; za mało, by ufać jej przy subtelnych. Opublikowane porównania wskazują ten sam kierunek:
4 narzędzia badawcze AI (3 generatory insightów, 1 współpracownik)
Transkrypcja i zgrubne grupowanie
Mgliste podsumowania, brak kontekstu, cytaty bez źródła
Nie mierzono
Prescott i współpracownicy stwierdzili, że ludzcy koderzy lepiej radzili sobie z niuansowymi, interpretacyjnymi tematami, i uznali, że podejścia hybrydowe są konieczne. Sakaguchi i współpracownicy nazwali ChatGPT-4 narzędziem pomocniczym i podkreślili dalszą potrzebę ludzkiej wiedzy eksperckiej.
To badania z zakresu ochrony zdrowia i UX, a nie startupowego discovery, więc nie przenoś procentów na własne wywiady. Wspierają one jednak jedną regułę roboczą: im bardziej temat zależy od kontekstu, emocji lub tego, czego ktoś nie powiedział, tym mniej wolno ufać wygenerowanej etykiecie bez przeczytania źródła.
Co mówią praktycy?
Ankieta NN/g z października 2026 roku wśród 521 praktyków UX pokazuje, jak zwyczajna stała się analiza z AI (NN/g, 2026):
67% osób, które analizują własne dane badawcze, często lub zawsze używa do tego AI.
Około 9 na 10 osób używających AI do analizy, desk researchu lub kodowania stwierdziło, że przyspieszyło to pracę.
54% wskazało obawy o jakość wyników jako barierę, najczęstszą.
Wśród 149 negatywnych komentarzy najczęściej pojawiały się niewiarygodne wyniki i ciężar ich weryfikacji, w 40.
61% nigdy nie użyło AI do przeprowadzania wywiadów z użytkownikami.
NN/g opisuje to jako próbę dogodną, więc czytaj to jako kierunek, a nie oszacowanie rynku. Kierunek jest jasny: praktycy używają AI do analizy, bo jest szybsza, a zaoszczędzony czas wydają na jej sprawdzanie.
Jak krok po kroku przeprowadzić syntezę badań z AI?
Pięć kroków. Pierwsze dwa robisz, zanim otworzysz narzędzie AI; w ostatnich dwóch ludzie zarabiają na swoje miejsce.
1. Określ decyzję, zanim zaczniesz podsumowywać
Zapisz decyzję produktową, którą badanie ma poprzeć. Na przykład:
Czy uprościć przepływ łączenia przy pierwszym uruchomieniu, czy najpierw wyjaśnić, które źródło użytkownik powinien połączyć?
To powstrzymuje szeroki prompt w rodzaju „przeanalizuj te wywiady” przed generowaniem atrakcyjnych tematów, które nie pomagają w bieżącej decyzji. Łatwiej też zauważyć, że materiał nie odpowiada na pytanie. Jeśli nie umiesz nazwać decyzji, nie jesteś gotowy na syntezę; możesz być jeszcze na etapie procesu product discovery, w którym ustala się, czego się uczyć.
2. Odpowiedzialnie przygotuj materiał źródłowy
Używaj tylko materiału, który Twój zespół może przetwarzać w wybranym narzędziu AI, zgodnie ze zgodą udzieloną przez uczestników. Usuń dane osobowe lub wrażliwe, chyba że masz jasny, zatwierdzony powód, by je zachować; NN/g zauważa, że niektóre narzędzia badawcze automatycznie usuwają teraz imiona, adresy e-mail i podobne identyfikatory (NN/g, 2024). Zachowaj ID źródła i datę, by recenzent mógł odnaleźć oryginalny zapis, a jednocześnie kontroluj dostęp do samej transkrypcji.
Nie łącz notatek z różnych grup klientów ani pytań badawczych bez oznaczeń. Wywiad z founderem, zgłoszenie do supportu i obserwowana sesja użyteczności mogą być przydatne; nie są wymiennymi dowodami. Oznacz każdy zapis typem i segmentem uczestnika, zanim zobaczy go model.
3. Każ AI porządkować, a nie wnioskować
Daj modelowi ograniczone zadanie. Poproś go, by:
wyciągnął obserwacje istotne dla decyzji;
do każdej obserwacji dołączył ID źródła i dokładny fragment, który ją potwierdza;
oddzielił wypowiedzi bezpośrednie od wywnioskowanych potrzeb;
wymienił kontrprzykłady i sprzeczne dowody;
zaznaczył brakujący kontekst i pytania, na które nie umie odpowiedzieć;
nie liczył powtarzających się wzmianek jako niezależnych użytkowników, chyba że zestaw źródeł uzasadnia takie liczenie.
Nie proś o ostateczną personę, wniosek dotyczący całego rynku ani uszeregowaną roadmapę na podstawie kilku rozmów. Model potrafi tak sformatować niepewność, że zniknie z pola widzenia, o ile wprost nie poprosisz o jej zachowanie. NN/g stwierdziła, że klastrowanie AI często grupuje elementy według wspólnych słów kluczowych, a nie wspólnego znaczenia, więc traktuj pierwsze klastry jako pomoc w sortowaniu (NN/g, 2024).
4. Zweryfikuj każde twierdzenie, które może zmienić roadmapę
PM lub founder powinien otworzyć oryginalne źródło każdego proponowanego tematu o dużym wpływie. Sprawdź, czy cytat potwierdza twierdzenie, czy otaczający kontekst zmienia jego znaczenie i czy model nie scalił doświadczeń różnych osób.
Potem poszukaj dowodów, które nie pasują. Jeśli dwóch użytkowników opisuje ten sam objaw z różnych powodów, zachowaj oba wyjaśnienia. Jeśli jedyną podstawą pomysłu jest jedna sugestywna historia, oznacz ją jako sygnał do zbadania, a nie jako udowodniony wzorzec.
Praktyczna tabela przeglądu wygląda tak:
Proponowany temat
Źródło potwierdzające
Co zaobserwowano bezpośrednio?
Interpretacja
Kontrdowód lub luka
Następny krok
Źródło w konfiguracji jest niejasne
Wywiad 04, notatka z sesji
Osoba połączyła inne konto niż zamierzała
Etykiety wyboru mogą być niejednoznaczne
Jedna obserwacja; brak jeszcze odtworzenia zadania
Obejrzeć nagranie i przetestować zrozumienie etykiet
Użytkownicy chcą checklisty
Wywiad 07, transkrypcja
Osoba poprosiła o checklistę po tym, jak utknęła
Mogą potrzebować wskazówek w punkcie decyzji
Prośba może odzwierciedlać preferencję tej osoby
Porównać ze zgłoszeniami do supportu i obserwować pierwsze użycie
Tabela jest celowo skromna. Nie zamienia dwóch rozmów w procent ani nie twierdzi, że „użytkownicy” zachowują się tak samo.
5. Zapisz decyzję i jej wyzwalacz uczenia się
Gdy zespół przejrzy dowody, zapisz, co zdecydował i dlaczego. Uwzględnij właściciela decyzji, źródła potwierdzające, najważniejszą niepewność i to, jakie przyszłe dowody zmieniłyby wybór. Dziennik decyzji produktowych daje temu stałe miejsce.
Na przykład:
Decyzja: Przetestować jaśniejsze opisy źródeł, zanim zbudujemy pełną checklistę konfiguracji.
Dlaczego: Dwa niezależne źródła wskazują niepewność przy wyborze połączenia, ale nie zaobserwowaliśmy dość sesji pierwszego użycia, by wiedzieć, czy problemem są etykiety, kolejność czy brak wskazówek.
Wyzwalacz przeglądu: Wrócić po przejrzeniu kilku reprezentatywnych sesji konfiguracji lub jeśli zgłoszenia do supportu wskażą inny punkt awarii.
Potrzebna próba zależy od decyzji, ryzyka i tego, jak zróżnicowani są Twoi użytkownicy. Nie traktuj stałej liczby wywiadów jako dowodu nasycenia ani reprezentatywności. Jeśli dowody pozostają niejednoznaczne, następnym przydatnym krokiem może być kolejna obserwacja, a nie gładsze podsumowanie.
Jakiego promptu użyć do syntezy badań z AI?
Użyj dwóch przebiegów: jednego do uporządkowania, drugiego do ustalenia priorytetów kontroli. Ten pierwszy prompt możesz dostosować do dozwolonego, odpowiednio zabezpieczonego zestawu źródeł:
Pomóż mi uporządkować te notatki z badań pod kątem decyzji: [pytanie decyzyjne]. Do każdej proponowanej obserwacji dołącz ID źródła i dokładny fragment, który ją potwierdza. Oddziel bezpośrednie dowody od interpretacji. Wymień sprzeczne przykłady, brakujący kontekst i alternatywne wyjaśnienia. Nie wnioskuj o częstości ponad dostarczone zapisy. Nie rekomenduj decyzji dotyczącej roadmapy. Jeśli twierdzenia nie da się poprzeć fragmentem, oznacz je jako niepoparte. Zwróć tabelę z kolumnami: obserwacja, cytat, źródło, interpretacja, powód pewności, kontrdowody i pytanie uzupełniające.
Potem uruchom drugi prompt na wyniku:
Dla każdego tematu powyżej wypisz odrębnych uczestników (nie wzmianki), którzy go potwierdzają, według ID źródła. Oznacz każdy temat poparty przez jednego uczestnika, każdy cytat, którego nie możesz znaleźć słowo w słowo w źródłach, i każdy temat łączący uczestników z różnych segmentów.
Drugi przebieg nie jest weryfikacją. Model sprawdzający własną pracę może powtórzyć własne błędy. To sposób na posortowanie tematów, tak aby ludzka kontrola zaczynała od najsłabszych. Żaden z promptów sam nie czyni wyniku wiarygodnym; razem sprawiają, że łatwiej go sprawdzić.
Jak sprawdzić syntezę AI, zanim trafi na roadmapę?
Skopiuj tę listę kontrolną do dokumentu syntezy i odhacz ją, zanim jakikolwiek temat stanie się ticketem lub linią w PRD:
Decyzja, którą ta synteza wspiera, jest zapisana na górze.
Każdy cytat jest dosłowny: przeszukałeś transkrypcję i go znalazłeś.
Każdy temat podaje, ile różnych osób go potwierdza, a nie ile jest wzmianek.
Każdy temat wskazuje segment, rolę lub sytuację tych osób.
Kontrdowody są wymienione pod tematem, który kwestionują.
Twierdzenia o tym, dlaczego ludzie działają lub co czują, są oznaczone jako interpretacja.
Tematy oparte na jednej osobie są oznaczone jako sygnały do zbadania.
Brakujące głosy są odnotowane: z kim nie rozmawiałeś.
Przykład krok po kroku: sprawdzenie syntezy w godzinę
Ten przykład jest ilustracyjny. Załóżmy pięcioosobowy zespół z 8 wywiadami onboardingowymi, około 6 godzinami nagrań i 40 zgłoszeniami do supportu. GOV.UK sugeruje około 1 godziny analizy na każde 2 godziny badań (GOV.UK), więc ręczny przebieg samych rozmów to z grubsza 3 godziny. NN/g radzi zaplanować na analizę co najmniej tyle czasu, ile na zbieranie danych, czyli więcej (NN/g, 2022).
Przebieg z AI trwa 10 minut i proponuje 7 tematów popartych 31 cytatami. PM sprawdza tylko 3 tematy, które mogą zmienić następny sprint: 14 cytatów, około 45 minut czytania. Znajduje 2 cytaty sparafrazowane zamiast dosłownych. Jeden temat, „użytkownicy chcą checklisty”, opiera się na 2 osobach, które prosiły o różne rzeczy. Inny, „źródło w konfiguracji jest niejasne”, utrzymuje się w 5 z 8 wywiadów i 9 zgłoszeniach.
Tylko ten ostatni temat trafia do rejestru decyzji, a 2 prośby o checklistę zostają jako otwarte pytanie. Łączny czas to około godziny, a każde twierdzenie, które trafia na roadmapę, zostało przez człowieka przeczytane w swoim źródle. Tę samą dyscyplinę stosowaną do specyfikacji pisanych przez AI znajdziesz w śledzeniu twierdzeń przeciw halucynacjom w specyfikacjach.
Które zadania syntezy oddać AI, a które zatrzymać?
Zadanie
Oddać AI?
Dlaczego
Ludzka kontrola
Transkrypcja
Tak
Dojrzała i szybka
Wyrywkowo sprawdzić imiona, żargon i przekrzykiwanie się
Usuwanie danych osobowych
Tak, z przeglądem
Oszczędza żmudny krok
Potwierdzić, że nic identyfikującego nie zostało
Wyciąganie obserwacji z cytatami
Tak
Dobra w znajdowaniu fragmentów
Cytaty muszą być dosłowne i ze źródłem
Pierwsze klastrowanie
Tak
Szybka pomoc w sortowaniu
Pogrupować na nowo według sytuacji, nie słów kluczowych
Do oceny rozpowszechnienia użyć analityki lub ankiety
Analiza sesji użyteczności na podstawie transkrypcji
Nie
Transkrypcje pomijają to, co użytkownicy zrobili (NN/g, 2023)
Obejrzeć nagranie
Rekomendowanie, co zbudować
Nie
Modelowi brakuje strategii i kompromisów
Decyduje zespół
Przeszukiwanie dawnych badań
Tak
Dobra do pytań „co klienci mówili o X?”
Otworzyć źródło, zanim zacytujesz
Jakie są typowe błędy w syntezie badań z AI?
Traktowanie płynnego podsumowania jak ustalenia. Wygładzenie nie jest dowodem. Temat jest ustaleniem dopiero wtedy, gdy ktoś przeczytał jego źródła.
Liczenie wzmianek jako osób. Jeden sfrustrowany klient, który porusza problem pięć razy, to jeden punkt danych, a nie pięć.
Mieszanie segmentów. Solo founder i 50-osobowy zespół mogą opisywać ten sam objaw z różnych powodów. Uśrednienie wymyśla użytkownika, który nie istnieje.
Porzucanie kontrprzykładów. Modele mają skłonność do rozwiązywania napięć w gładką historię. Poproś wprost o sprzeczności i trzymaj je na widoku.
Pozwalanie, by podsumowanie zastąpiło źródło. Trzymaj transkrypcję lub ticket o jedno kliknięcie od każdego twierdzenia, inaczej nikt nie zakwestionuje później interpretacji.
Zbyt późna synteza. Insighty tracą świeżość. Zespoły, które prowadzą continuous discovery, syntetyzują po kilka wywiadów naraz, gdy kontekst jest jeszcze świeży.
AI nie naprawi też skąpej ani obciążonej próby. Jeśli rozmawiałeś tylko z najbardziej zadowolonymi klientami, doskonała synteza tych rozmów nadal jest syntezą Twoich najbardziej zadowolonych klientów. Lepsze pytania pomagają; nasz szablon wywiadu z klientem koncentruje się na niedawnych zachowaniach, a nie na opiniach.
Gdzie pasuje Specky
Specky wczytuje rozmowy z klientami, feedback, Slacka, Jirę i analitykę do Product Graph, a potem pisze specyfikacje i tickety z cytatami w tekście odsyłającymi do dowodów, tak by recenzent mógł otworzyć źródło każdego twierdzenia. Alex, agent badawczy Specky, prowadzi wywiady z klientami z linku do udostępnienia, więc badania nie czekają na kalendarze. Reguła z tego przewodnika nadal obowiązuje: cytat sprawia, że twierdzenie da się sprawdzić, a nie że jest prawdziwe. Ktoś z zespołu nadal czyta źródło, zanim twierdzenie trafi na roadmapę.
Najczęściej zadawane pytania
Czy AI potrafi samodzielnie syntetyzować badania klientów?
Nie. AI potrafi transkrybować, wyciągać cytaty i proponować tematy znacznie szybciej niż człowiek, ale opublikowane porównania pokazują, że zgadza się z ludzkimi koderami tylko w 36–47% pojedynczych kodów i w około 30% tematów interpretacyjnych. Użyj jej do pierwszego przebiegu, a potem poproś kogoś, kto zna produkt i klientów, o sprawdzenie każdego tematu, który może zmienić decyzję.
Jak dokładna jest analiza tematyczna AI w porównaniu z ludźmi?
To zależy od rodzaju tematu. W badaniu z 2025 roku ChatGPT-4 zgadzał się z badaczami-ludźmi w ponad 80% tematów opisowych, ale tylko w około 30% tematów wymagających interpretacji kulturowej lub emocjonalnej. Badanie z 2024 roku wykazało, że AI trafiła 71% ludzkich tematów indukcyjnych. Spodziewaj się dobrej czułości w oczywistych tematach i słabego osądu w kwestii znaczenia.
Jak powstrzymać AI przed zmyślaniem cytatów?
Wymagaj ID źródła i dokładnego fragmentu dla każdej obserwacji i każ modelowi oznaczać jako niepoparte wszystko, czego nie potrafi uzasadnić. Potem przeszukaj transkrypcję pod kątem każdego cytatu, który wspiera temat o dużym wpływie. NN/g stwierdziła, że niektóre narzędzia badawcze AI przypisywały cytaty bez podania sesji ani znacznika czasu, co uniemożliwia taką kontrolę, więc wybieraj narzędzia, które podają swoje źródła.
Czy bezpiecznie jest wgrywać wywiady z klientami do narzędzia AI?
Tylko jeśli uczestnicy zgodzili się na takie przetwarzanie, a Twoja organizacja zatwierdziła narzędzie dla tego rodzaju danych. Usuń imiona, adresy e-mail i inne identyfikatory, których nie potrzebujesz, sprawdź, gdzie narzędzie przechowuje i przetwarza dane, i ogranicz krąg osób widzących surowe transkrypcje. Zgodnie z RODO nagrania i transkrypcje wywiadów są danymi osobowymi, gdy uczestnika można zidentyfikować.
Ile wywiadów potrzeba, zanim synteza z AI będzie użyteczna?
AI pomaga już od pierwszego wywiadu, przy transkrypcji i wyciąganiu obserwacji. Tematy łączące wiele wywiadów wymagają kilku rozmów o tej samej decyzji, zanim wzorzec warto sprawdzać. Właściwa liczba zależy od tego, jak zróżnicowani są Twoi użytkownicy i jak ryzykowna jest decyzja. Wywiady wyjaśniają, dlaczego coś się dzieje; jak często, sprawdzisz w analityce lub ankiecie.
GDPR-aligned. EU workspace data is stored in Frankfurt, Germany. GDPR and EU data Built in Vienna, Austria. A product of influence solutions fm GmbH (FN 675374y). Imprint 14-day trial. Card required, and nothing is charged until day 14. 30-day refund after subscribing. See pricing