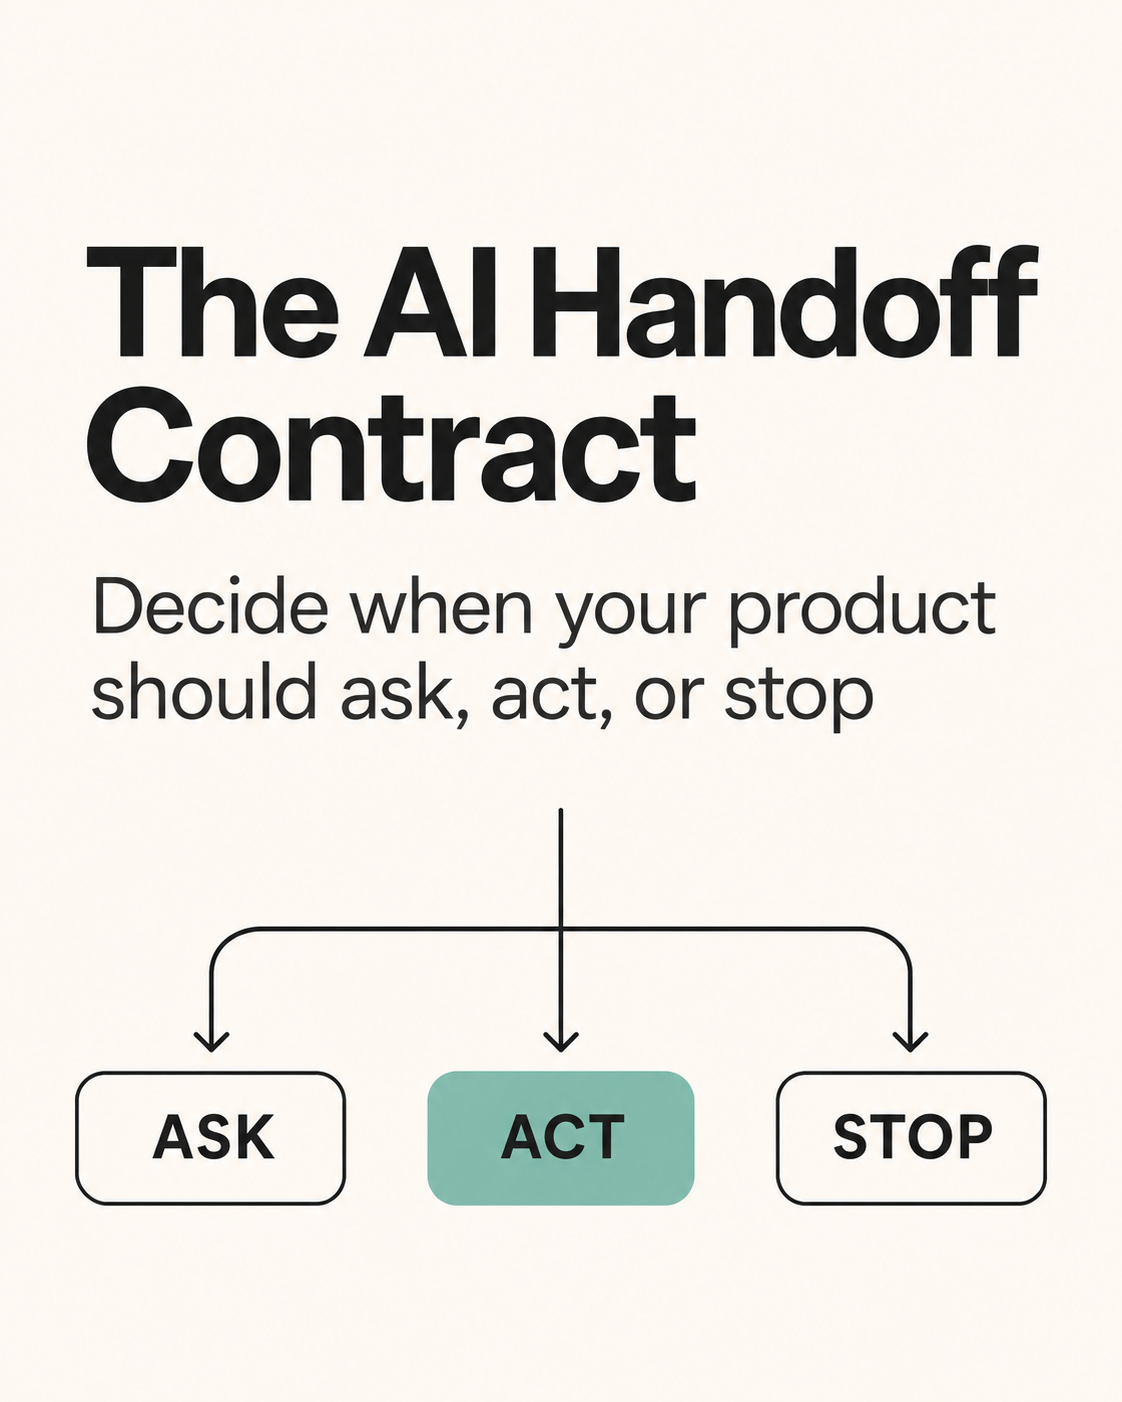
Handoff agenta AI: kiedy Twój produkt powinien pytać, działać lub się zatrzymać
Zdecyduj, kiedy agent AI powinien dopytać użytkownika, działać w określonych granicach, a kiedy oddać kontrolę człowiekowi. Poznaj twarde dane i gotowy szablon kontraktu.
Udostępnij
Ten artykuł został przetłumaczony z języka angielskiego. Przeczytaj oryginał
Handoff agenta AI (przekazanie kontroli) to moment, w którym funkcja AI oddaje stery człowiekowi: by dopytać o brakujące informacje, uzyskać zgodę przed ryzykownym działaniem lub po prostu przerwać pracę i pozwolić komuś przejąć zadanie. Kontrakt handoffu (handoff contract) ustala jeszcze przed wdrożeniem, kiedy produkt powinien zapytać, kiedy może działać na własną rękę, kiedy musi się zatrzymać oraz co w każdym z tych przypadków widzi użytkownik.
Najważniejsze wnioski
Agenci już teraz zatrzymują się sami z siebie częściej, niż przerywają im ludzie. W badaniu Anthropic obejmującym około 500 000 sesji Claude Code agent prosił o doprecyzowanie ponad dwa razy częściej przy najtrudniejszych zadaniach niż przy prostych – i częściej, niż to ludzie wchodzili mu w słowo (Anthropic, 2026).
Głównym powodem zatrzymania się agenta była chęć przedstawienia wyboru między różnymi podejściami (35%). Z kolei ludzie najczęściej przerywali agentowi, aby dostarczyć brakujący kontekst lub poprawki (32%). W obu przypadkach problem leży w kontekście produktowym, a nie w samym modelu.
Przewodnik po agentach od OpenAI wskazuje dwa powody interwencji człowieka: przekroczenie limitu błędów oraz działania wysokiego ryzyka – wrażliwe, nieodwracalne lub o wysoką stawkę (OpenAI).
Pewność modelu to nie uprawnienie. „90% pewności” nie daje prawa do wysłania e-maila ani zmiany rekordu klienta w bazie.
Człowiek weryfikujący nie jest automatycznie siatką bezpieczeństwa. Z metaanalizy wynika, że błędna podpowiedź ze strony systemu wspomagania decyzji zwiększa ryzyko podjęcia złej decyzji przez człowieka o 26% (Goddard et al., 2012).
Czym jest handoff agenta AI?
To pojęcie ma dwa znaczenia i warto je wyraźnie rozróżnić.
Handoff agent-agent. W bibliotece OpenAI Agents SDK handoff pozwala jednemu agentowi oddelegować zadanie innemu – na przykład agent kwalifikujący przekazuje wniosek o zwrot środków do wyspecjalizowanego agenta ds. zwrotów. Model traktuje każde takie przekazanie jak narzędzie (tool), np. transfer_to_refund_agent (OpenAI Agents SDK). Przewodnik OpenAI opisuje to jako transfer w jedną stronę, przenoszący ze sobą stan całej konwersacji.
Handoff agent-człowiek. Agent przekazuje kontrolę człowiekowi, ponieważ nie może lub nie powinien kontynuować pracy. Przewodnik OpenAI podaje dwa przykłady: eskalację do żywego konsultanta w obsłudze klienta oraz oddanie kontroli użytkownikowi przez agenta programistycznego.
Ten artykuł dotyczy drugiego przypadku – decyzji czysto produktowej, a nie technicznego detalu orkiestracji. Agent w produkcie może zarekomendować kolejny krok, przygotować go do wdrożenia albo wykonać go samodzielnie. To trzy zupełnie różne zachowania, nawet jeśli na ekranie widać tylko jeden zachęcający przycisk „Kontynuuj”. Pytanie, na które odpowiada kontrakt handoffu, brzmi: o czym ten produkt może zadecydować w imieniu użytkownika, na podstawie jakich informacji i co robimy, gdy odpowiedź nie jest w pełni pewna?
Użytkownicy bardzo zwracają na to uwagę. W badaniu Stack Overflow z 2025 roku aż 86,9% programistów obawiało się o dokładność informacji generowanych przez agentów AI, a 81,4% miało wątpliwości dotyczące bezpieczeństwa i prywatności swoich danych (Stack Overflow, 2025). Przejrzyste zasady handoffu rozwiązują oba problemy: agent robi mniej, gdy ma słabe dowody, i nie dotyka niczego bez wyraźnej zgody.
To zadanie typowo produktowe. PM wnosi tu wyczucie domenowe: co jest racjonalnym działaniem, jakie kompromisy są do przyjęcia i które błędy bezwzględnie wymagają przejęcia sterów przez użytkownika. Z kolei inżynierowie przekładają te zasady na działający, niezawodny kod produkcyjny. PM nie przejmuje tutaj roli programisty.
Dlaczego „human in the loop” to zbyt mgliste pojęcie dla agenta AI?
Krótki zapis w wymaganiach w stylu „człowiek w pętli” (human in the loop) pozostawia kluczowe pytania bez odpowiedzi:
Jaka konkretnie osoba weryfikuje wynik i czy ma kontekst, by go rzetelnie ocenić?
Czy weryfikuje sugestię, wersję roboczą, czy działanie już wykonane w tle?
Czy może to działanie zmodyfikować, czy tylko bezrefleksyjnie zatwierdzić?
Co się stanie, jeśli nikt nie odpowie?
Jakich błędów pod żadnym pozorem nie wolno delegować na maszynę?
Standardy branżowe wymagają odpowiedzi na te pytania, ale nie dają gotowych rozwiązań. Ramy NIST AI Risk Management Framework 1.0 nakazują organizacjom zdefiniowanie ról dla układów człowiek-AI (GOVERN 3.2), udokumentowanie procesów nadzoru ludzkiego (MAP 3.5) oraz wdrożenie mechanizmów pozwalających na zastąpienie, odłączenie lub dezaktywację systemu AI działającego niezgodnie z przeznaczeniem (MANAGE 2.4) (NIST).
Akt o sztucznej inteligencji (EU AI Act) idzie jeszcze dalej w przypadku systemów wysokiego ryzyka. Artykuł 14 wymaga, aby osoby nadzorujące były świadome zjawiska ulegania automatyzacji (automation bias), mogły zignorować, zmienić lub cofnąć wynik działania systemu, a także przerwać jego pracę za pomocą przycisku „stop” lub podobnej procedury (EUR-Lex). Po wejściu w życie pakietu Digital Omnibus obowiązki te mają zastosowanie do systemów wysokiego ryzyka z załącznika III od 2 grudnia 2027 roku (EUR-Lex, Rozporządzenie 2026/1744). Większość agentów w produktach nie kwalifikuje się jako systemy wysokiego ryzyka, ale schemat: zapytaj, nadpisz i zatrzymaj (ask, override, stop) to świetny standard minimum dla każdego z nich.
Sam proces weryfikacji również wymaga przemyślanego projektu. Goddard wraz ze współpracownikami przeanalizował 74 badania dotyczące automation bias i odkrył, że gdy system wspomagania decyzji podawał błędną odpowiedź, ryzyko podjęcia złej decyzji przez człowieka rosło o 26%. Użytkownik widzący pewną siebie rekomendację i wielki przycisk „Zatwierdź” nie stanowi żadnej niezależnej weryfikacji – chyba że produkt jasno pokazuje dowody i ułatwia zgłoszenie sprzeciwu.
Kiedy agent AI powinien pytać, działać lub się zatrzymać?
Wdróż trzy ścieżki i wybieraj między nimi na podstawie konsekwencji oraz uprawnień, a nie wskaźnika pewności modelu.
Zapytaj (Ask), gdy systemowi brakuje informacji lub uprawnień, które mogłyby zmienić decyzję. Zadaj jedno konkretne pytanie, wyjaśnij, dlaczego odpowiedź ma znaczenie, i daj użytkownikowi wybór. Jeśli brakujący szczegół jest opcjonalny, zaproponuj czytelną wartość domyślną.
Działaj (Act), gdy zadanie jest precyzyjnie określone, mieści się w granicach intencji użytkownika, a ewentualne konsekwencje pomyłki są w pełni akceptowalne. Zadbaj o to, by skutki działania były widoczne, łatwe do sprawdzenia i proste do cofnięcia.
Zatrzymaj się (Stop), gdy system nie może odpowiedzialnie kontynuować pracy: żądanie wykracza poza dozwolony zakres produktu, dowody są zbyt słabe w stosunku do wagi konsekwencji, wymagane źródło danych jest niedostępne, przekroczono limit błędów lub kolejny krok przekroczyłby granice autoryzacji. Wyjaśnij powód i zaproponuj dalsze kroki – na przykład edycję zapytania lub przekazanie sprawy człowiekowi.
Ścieżka
Stosuj, gdy
Co widzi użytkownik
Przykład
Zapytaj
Brakujące lub sprzeczne informacje zmieniłyby wynik
Jedno pytanie, powód i 2–4 opcje do wyboru
„Priorytetyzować według dopasowania firmy czy świeżego sygnału zakupowego?”
Działaj
Zapytanie jest jasne, akcja mieści się w zakresie i jest odwracalna
Wynik, podsumowanie zmian i opcję cofnięcia (undo)
Szkic odpowiedzi zapisany w wersjach roboczych
Działaj po potwierdzeniu
Działanie mieści się w zakresie, ale niesie poważne konsekwencje
Podgląd zmian i wymóg jednoznacznego potwierdzenia
Wysłanie odpowiedzi bezpośrednio do klienta
Zatrzymaj się
Poza zakresem, za mało danych, limit błędów lub brak uprawnień
Powód zatrzymania i kolejny krok lub kontakt do człowieka
„Nie mogę zmienić danych rozliczeniowych. Zgłoś się do działu płatności.”
Pewność to nie uprawnienie. Komunikat modelu, że jest czegoś pewien w 90%, nie daje mu prawa do wysłania wiadomości, modyfikacji danych klienta ani przypieczętowania decyzji produktowej. Dobór ścieżki zależy od zadania, materiału dowodowego, uprawnień użytkownika i kosztu pomyłki. W przypadku decyzji zwracających stałą odpowiedź (klasyfikacja, routing, scoring) nasz framework podejmowania decyzji przez AI wyjaśnia, jak ustalać progi na podstawie kosztu błędów. Ocenę odwracalności działań opisuje z kolei artykuł o jedno- i dwukierunkowych decyzjach produktowych.
Jak agenci AI i ludzie dzielą dziś kontrolę w praktyce?
Opublikowane w lutym 2026 roku badanie Anthropic dostarcza najlepszych publicznych danych na ten temat. Przeanalizowano w nim około 500 000 interaktywnych sesji Claude Code oraz 998 481 wywołań narzędzi (tool calls) z publicznego API (Anthropic, 2026).
Dlaczego agent zatrzymywał się sam:
Powód wstrzymania pracy przez Claude Code
Udział
Przedstawienie wyboru między różnymi podejściami
35%
Zebranie danych diagnostycznych lub wyników testów
21%
Doprecyzowanie niejasnego polecenia
13%
Prośba o dane uwierzytelniające lub dostęp
12%
Uzyskanie zgody przed wykonaniem akcji
11%
Dlaczego przerywali ludzie: aby dostarczyć brakujący kontekst lub nanieść poprawki (32%), ponieważ agent działał wolno, zawiesił się lub robił za dużo naraz (17%), albo żeby samodzielnie wykonać kolejny krok (7%).
Jak zaufanie rosło wraz z doświadczeniem: nowi użytkownicy (poniżej 50 sesji) korzystali z pełnego automatycznego zatwierdzania (auto-approve) w około 20% sesji; przy ponad 750 sesjach odsetek ten wzrastał do ponad 40%. Doświadczeni użytkownicy częściej jednak przerywali pracę agenta – w około 9% interakcji, w porównaniu do około 5% u osób z historią rzędu 10 sesji. Anthropic interpretuje to jako aktywny nadzór, a nie porzucenie kontroli.
Jak wyglądał profil ryzyka w API: 80% wywołań narzędzi pochodziło od agentów z co najmniej jednym zabezpieczeniem (np. restrykcje uprawnień, wymóg zgody); maksymalnie 73% miało w pętli człowieka (autorzy zaznaczają, że to górna granica); a tylko 0,8% operacji uznano za nieodwracalne.
Dla zespołów produktowych płyną z tego trzy lekcje:
Projektuj stan „zapytaj” pod kątem wyborów, a nie tylko braków. Najczęstszym powodem pauzy agenta była chęć zaprezentowania różnych podejść do wyboru. Zaprojektuj to jako pełnoprawny widok z przejrzystymi opcjami.
Większość interwencji wynika z braku kontekstu. Co trzecia przerwa wywołana przez człowieka służyła podaniu kontekstu lub poprawek, których agent nie znał. Lepszy kontekst produktowy na starcie redukuje liczbę pytań i przerw. Nasz szablon PRD dla agentów kodujących AI pokazuje, jak taki kontekst skutecznie dostarczyć.
Projektuj pod kątem interwencji, a nie klepania każdego kroku. Anthropic zaleca zapewnienie użytkownikom wglądu w proces i prostych metod korygowania kursu agenta, zamiast zmuszania ich do zatwierdzania każdej drobnostki. Nawet użytkownicy mający duże zaufanie do narzędzia potrzebują szybkiego sposobu, by wkroczyć do akcji.
Jak realne produkty wdrażają stany ask, act i stop?
Tryby uprawnień w Claude Code to świetny, rynkowy przykład – każdy z nich reprezentuje inną politykę handoffu (dokumentacja Claude Code):
Tryb Claude Code
Co robi bez pytania
Odpowiadająca ścieżka handoffu
Manual (default)
Tylko odczyt; pyta przed edycją, poleceniami powłoki i dostępem do sieci
Pytaj przed każdym zapisem (Ask)
acceptEdits
Odczyt, edycja i podstawowe polecenia na plikach w katalogu roboczym
Działaj przy niskim ryzyku i odwracalności (Act); pytaj o resztę
plan
Odczyt i eksploracja; edycje zablokowane do momentu zatwierdzenia planu
Zapytaj raz, z góry, prezentując plan
auto
Wszystko, ale klasyfikator weryfikuje każdą akcję w tle
Działaj (Act) pod okiem modelu weryfikującego, który może przerwać
dontAsk
Tylko wstępnie zatwierdzone narzędzia; cała reszta jest odrzucana
Działaj w ścisłych granicach (Act); zatrzymaj się poza nimi (Stop)
Warto skopiować z tego dwa rozwiązania. Po pierwsze, tryb automatyczny domyślnie blokuje listę akcji o wysokich konsekwencjach, w tym wdrożenia produkcyjne, migracje, force push, masowe usuwanie plików w chmurze czy łączenie pull requestów bez zatwierdzenia przez człowieka. To klasyczna lista zatrzymania (stop list). Po drugie, jeśli klasyfikator zablokuje akcję 3 razy z rzędu lub 20 razy w całej sesji, tryb auto wstrzymuje pracę i Claude Code wraca do zadawania pytań. To próg błędów (failure threshold) – dokładnie ten sam mechanizm, o którym pisze OpenAI. Reguły odmowy obowiązują w każdym trybie i wyznaczają sztywną granicę działania.
Przewodnik OpenAI podpowiada, jak przypisać akcje do odpowiednich ścieżek: nadaj każdemu narzędziu poziom ryzyka (niski, średni, wysoki) na podstawie tego, czy wymaga zapisu, czy tylko odczytu, czy jest odwracalne, jakich uprawnień potrzebuje i jakie pociąga skutki finansowe. Następnie wprowadź pauzę na weryfikację lub eskaluj do człowieka przed wywołaniami o wysokim ryzyku. Przykłady działań bezwzględnie wymagających nadzoru to anulowanie zamówień, autoryzacja dużych zwrotów i zlecanie płatności.
Oficjalne wskazówki Anthropic dotyczące agentów zwracają uwagę na to samo od strony inżynieryjnej: agenci mogą zatrzymywać się po feedback od człowieka w punktach kontrolnych (checkpoints) lub po napotkaniu przeszkód, na każdym etapie powinni weryfikować stan faktyczny w środowisku i bezwzględnie potrzebują warunków stopu, takich jak maksymalna liczba iteracji (Anthropic, 2024).
Jak napisać kontrakt handoffu dla agenta AI?
Dla każdego procesu wspieranego przez AI stwórz ramy dopuszczalnych działań. Zapisz je prostym językiem – tak zwięźle, by mogli je zrecenzować product manager, projektant, inżynier i dział wsparcia.
Pole kontraktu
Pytanie, na które odpowiada
Użytkownik i zadanie (job)
Kto i jaki cel próbuje zrealizować?
Dozwolone działania
Co produkt może przygotować lub wykonać i z jakim poziomem ryzyka?
Wymagany kontekst
Jakie fakty, uprawnienia lub źródła muszą być bezwzględnie dostępne?
Warunek zapytania (Ask)
Jaki brakujący lub sprzeczny szczegół wymaga powrotu do użytkownika?
Warunek zatrzymania (Stop)
Co sprawia, że kontynuowanie pracy staje się niedopuszczalne?
Próg błędów
Po ilu nieudanych próbach następuje oddanie kontroli człowiekowi?
Potwierdzenie
Które działania wymagają wyraźnej weryfikacji lub zgody?
Powrót do kontroli (Recovery)
W jaki sposób użytkownik może poprawić, cofnąć lub przekazać wynik?
Warunek rewizji
Jaki sygnał, incydent lub data wymusza ponowne otwarcie kontraktu?
Ramy te definiują zachowanie, a nie samą implementację. Nie narzucają konkretnego modelu, promptu, API ani architektury – tym zajmie się plan inżynieryjny, gdy zespół ustali już, jak produkt ma się zachowywać.
Skopiuj poniższy wzorzec do swojego dokumentu:
## Kontrakt handoffu: [proces/workflow]
Dla [użytkownik] próbującego zrealizować [zadanie], produkt może [dozwolone działanie],
gdy dostępny jest [wymagany kontekst].

Zapytaj, gdy: [kluczowe dla decyzji informacje są niepełne lub sprzeczne]
Zatrzymaj się, gdy: [przekroczono granice, brak dowodów, niedostępne źródło lub brak autoryzacji]
Próg błędów: przekaż człowiekowi po [n] nieudanych próbach na etapie [krok]
Potwierdź przed: [działanie niosące konsekwencje] (ryzyko: niskie / średnie / wysokie)
Powrót do kontroli: użytkownik może [cofnąć / edytować / przypisać] poprzez [mechanizm]
Właściciel: [PM] za politykę i reguły, [inżynier] za implementację
Rewizja, gdy: [sygnał, incydent lub konkretna data]
Następnie przetestujcie go na realnych przykładach w zespole złożonym z PM-a, programisty, designera i osoby pracującej blisko operacji. Poprawiajcie kontrakt tak długo, aż każdy przypadek trafi na zrozumiałą ścieżkę, a użytkownik zawsze będzie wiedział, co się właściwie stało.
Prowadź rejestr decyzji (decision log)
Gdy zespół zatwierdzi kontrakt, odnotujcie, co jest dozwolone, jakich użytkowników lub sytuacji to dotyczy, jakie dowody za tym stoją, kto jest właścicielem, jakie przypadki testowe to weryfikują i co wymusi rewizję ustaleń. Jeśli produkt zacznie później pytać zbyt często, działać na podstawie wątpliwych przesłanek lub zatrzymywać się bez wskazania alternatywy, zespół bez trudu powiąże ten problem z konkretną polityką. Do tego celu wystarczy prosty rejestr decyzji produktowych (decision log). Zapobiega on też rozmywaniu odpowiedzialności: PM-owie odpowiadają za zamierzone zachowanie i kompromisy biznesowe, a inżynierowie za wdrożenie, uprawnienia, niezawodność i bezpieczeństwo operacyjne.
Oto poglądowy scenariusz. Wyobraź sobie funkcję AI pomagającą zespołowi sprzedaży w segregowaniu potencjalnych klientów (prospects). Duża korporacja ze świetnym finansowaniem wygląda obiecująco. Z kolei mniejsza firma, z której w zeszłym tygodniu napłynął wyraźny sygnał zakupowy, może być znacznie pilniejszym tematem. Oba fakty są prawdziwe – produkt potrzebuje jednak jasnych wytycznych, który z nich ma pierwszeństwo.
Kontrakt może wyglądać następująco:
Dozwolone działanie: zasugerowanie poziomu priorytetu (ryzyko: niskie, ponieważ to tylko sugestia) wraz z uzasadnieniem.
Wymagany kontekst: kryteria dopasowania konta (fit) przyjęte przez zespół oraz data i źródło każdego sygnału zakupowego.
Zapytaj: poproś o regułę priorytetyzacji, jeśli pojęcie „najlepszy lead” nie zostało wcześniej zdefiniowane.
Zatrzymaj się: nie wnioskuj o intencji zakupu wyłącznie na podstawie wielkości firmy i nie twierdź, że konto jest gotowe do zakupu, bez podania źródła.
Próg błędów: jeśli wzbogacanie danych (enrichment) dla danej firmy nie powiedzie się dwukrotnie, oznacz ją jako „wymaga ręcznej weryfikacji”, zamiast zgadywać.
Potwierdzenie: handlowiec weryfikuje priorytet, zanim trafi on do wspólnego pipeline’u (ryzyko: średnie, ponieważ rzutuje na pracę innych).
Powrót do kontroli: weryfikujący może zmienić priorytet i zapisać powód modyfikacji.
Kontrakt naświetla dylemat, którego model nie rozwiąże sam: czy ten zespół stawia na dopasowanie firmy, wyczucie czasu, czy na precyzyjnie wyważony kompromis? PM wnosi ekspertyzę domenową (lub gromadzi ekspertów) i czyni ten wybór w pełni transparentnym. Zadaniem modelu jest zastosowanie przyjętej reguły, a nie wymyślanie jej od zera.
Jak przetestować kontrakt handoffu przed wdrożeniem?
Przygotuj zestaw reprezentatywnych przypadków testowych i sprawdź, czy produkt wybiera właściwą ścieżkę oraz czy potrafi ją logicznie uzasadnić. Uwzględnij sytuacje, w których:
Zapytanie jest kompletne, a działanie w pełni odwracalne (oczekiwane: działaj).
Brakuje kluczowego faktu, a różne odpowiedzi zmieniłyby rezultat (oczekiwane: zapytaj).
Dwa źródła podają sprzeczne dane (oczekiwane: zapytaj, pokazując oba źródła).
Użytkownik żąda czegoś wykraczającego poza uprawnienia (oczekiwane: zatrzymaj się).
Materiał dowodowy jest zbyt skąpy w stosunku do wagi działania (oczekiwane: zatrzymaj się lub zapytaj).
Wewnętrzna usługa nie działa lub brakuje łączności ze źródłem (oczekiwane: ponawiaj do osiągnięcia progu błędów, po czym przekaż człowiekowi).
Dla każdego przypadku opisz oczekiwaną ścieżkę, jej powód oraz to, co powinien zobaczyć użytkownik, np.: „Zapytaj, ponieważ brakuje daty sygnału zakupowego; pokaż źródło i pozwól handlowcowi dodać informację lub pominąć krok”. To jest weryfikowalne. Ogólnik w stylu „zachowaj ostrożność” – nie jest.
Weryfikuj rzeczywiste odpowiedzi z ekspertami domenowymi. Jeśli oceniający nie są zgodni, nie wyciągaj średniej z ich ocen, byle przejść dalej – znajdź ukrytą różnicę zdań w polityce produktowej. Jeden weryfikator może optymalizować pod kątem profilu firmy, a drugi pod kątem presji czasu. Rozstrzygnij tę kwestię, wpisz regułę do kontraktu i stwórz przypadek testowy sprawdzający tę różnicę. Pętla wygląda tak: zbadaj przypadek, zidentyfikuj decyzję, uzgodnij zasadę, zaktualizuj testy i ponownie oceń zachowanie. Nasz framework ewaluacji AI dla zespołów produktowych wyjaśnia, jak rozbudować te przypadki w pełny zestaw ewaluacyjny (eval set).
Takie testy nie zastępują monitoringu na produkcji ani technicznych zabezpieczeń w kodzie. Dają jednak pewność, że cały zespół ma spójną wizję tego, jak produkt powinien działać.
Jak sprawić, by stan „zapytaj” był wartościowy dla użytkownika?
Zadawanie pytań nie staje się automatycznie bezpieczniejsze. Nadmiar przerw zrzuca pracę z powrotem na użytkownika, sprawiając, że funkcjonalność wydaje się niedopracowana. Pytanie powinno paść wyłącznie wtedy, gdy odpowiedź rzeczywiście rzutuje na wynik. Stworzone przez Microsoft zestawienie 18 zasad interakcji człowiek-AI, podsumowujące ponad 20 lat badań, traktuje zachowanie systemu w obliczu błędu jako odrębny etap projektowy, niezależny od standardowej interakcji (Microsoft Research, 2019).
Dobrze zaprojektowany ekran handoffu pokazuje:
co system ustalił do tej pory,
jakich informacji brakuje lub jakie dane są ze sobą sprzeczne,
dlaczego ma to wpływ na kolejny krok,
od dwóch do czterech czytelnych wariantów wyboru – w tym opcję „zdecyduj później”, o ile jest bezpieczna.
Jeśli użytkownik może bezpiecznie skorygować wynik po obejrzeniu podglądu, zwykły krok potwierdzenia sprawdzi się lepiej niż seria pytań. Z kolei w sytuacji, gdy produkt może wykonać w pełni odwracalną akcję i zaoferować wyraźną opcję cofnięcia (undo), przerywanie pracy może w ogóle nie być potrzebne.
Najczęstsze błędy przy handoffie agenta AI
Traktowanie pewności modelu jako zgody na działanie. Prawdopodobieństwo mówi tylko o tym, jak pewny jest model, a nie o tym, czy użytkownik upoważnił go do wykonania akcji.
Pytanie o każdą drobnostkę. Ciągłe prośby o zatwierdzenie uczą użytkowników klikania „Zgoda” bez czytania – to prosta droga do zjawiska automation bias na własne życzenie.
Zatrzymanie bez wskazania alternatywy. Komunikat „Nie mogę w tym pomóc” bez podania przyczyny ani kontaktu do człowieka to ślepy zaułek.
Brak progu błędów. Bez limitu ponawiania prób agent może wpaść w nieskończoną pętlę na jednym nieudanym kroku. Zdefiniuj limit i przekaż zadanie po jego przekroczeniu.
Jeden kontrakt dla wszystkich rodzajów akcji. Zwykły odczyt danych i zlecenie płatności wymagają skrajnie różnych ścieżek. Oceń ryzyko każdej akcji z osobna.
Niejasne zasady w zespole. Jeśli oceniający spierają się o poprawny wynik, oznacza to lukę w regułach kontraktu, a nie wadę modelu.
Brak warunku rewizji. Zachowanie agentów i potrzeby użytkowników ewoluują. Wyznacz sygnał lub konkretną datę, kiedy wrócicie do weryfikacji kontraktu.
Rola platformy Specky
Serwer MCP wbudowany w Specky wdraża ten schemat dla agentów działających w przestrzeni produktowej: agenci tworzą PRD, wnioski badawcze, decyzje i zadania w stanie roboczym lub jako propozycje, skrzynka odbiorcza PM Inbox pełni funkcję kolejki weryfikacji, a automatyczna publikacja następuje wyłącznie na wyraźne życzenie użytkownika w tej samej sesji. Każdy kontrakt handoffu możesz zapisać w module Decision Log tuż obok dowodów, które posłużyły do jego stworzenia. Zobacz, jak wygląda szerszy proces w Specky dla technicznych PM-ów.
Najczęściej zadawane pytania (FAQ)
Czym jest handoff agenta AI?
Handoff agenta AI to moment przekazania kontroli – innemu agentowi lub człowiekowi. W projektowaniu produktów pojęcie to odnosi się najczęściej do relacji agent-człowiek: agent prosi o brakujące informacje, wymaga zatwierdzenia przed ważną akcją lub zatrzymuje się, pozwalając człowiekowi przejąć stery. Kontrakt handoffu precyzuje te warunki brzegowe jeszcze przed wdrożeniem funkcji.
Kiedy agent AI powinien prosić o potwierdzenie?
Przed działaniami, które niosą poważne konsekwencje, ale wciąż mieszczą się w zakresie zadania: przed wysłaniem wiadomości do klientów, edycją współdzielonych baz danych, wydawaniem pieniędzy czy każdą operacją trudną do cofnięcia. Przypisz każdemu działaniu poziom ryzyka (niski, średni, wysoki) na podstawie wymogu zapisu, odwracalności, uprawnień i wpływu finansowego – i wymagaj potwierdzenia przy średnim i wysokim ryzyku. Działania odwracalne i o niskim ryzyku mogą być wykonywane od razu, z widoczną opcją cofnięcia (undo).
Czym różni się handoff agent-agent od handoffu agent-człowiek?
Handoff agent-agent polega na delegowaniu zadań wewnątrz systemu: w OpenAI Agents SDK agent kwalifikujący przekazuje sprawę zwrotu agentowi ds. rozliczeń poprzez wywołanie narzędzia. Handoff agent-człowiek oddaje z kolei kontrolę użytkownikowi, gdy agent nie może lub nie powinien kontynuować pracy. Pierwszy to decyzja architektoniczna; drugi to strategiczny wybór produktowy dotyczący uprawnień i zarządzania ryzykiem.
Czy obecność człowieka w pętli (human in the loop) gwarantuje bezpieczeństwo agenta AI?
Nie. Weryfikacja przez człowieka działa tylko wtedy, gdy ma on dostęp do dowodów, odpowiednio dużo czasu i prosty sposób na zakwestionowanie sugestii AI. Z metaanalizy 74 badań wynika, że błędna podpowiedź systemu wspomagania decyzji zwiększa ryzyko ludzkiego błędu o 26%. Należy precyzyjnie określić, kto i co weryfikuje, co widzi na ekranie, co może zmienić i co dzieje się w przypadku braku odpowiedzi.
Jak często agent AI powinien przerywać pracę użytkownikowi?
Wyłącznie wtedy, gdy odpowiedź może realnie zmienić wynik lub gdy działanie wymaga uprawnień, których agentowi brakuje. W danych Anthropic z 2026 roku Claude Code dopytywał o szczegóły znacznie częściej przy zadaniach złożonych niż prostych, a doświadczeni użytkownicy przerywali jego pracę w około 9% interakcji. Monitoruj własny wskaźnik zapytań (ask rate) oraz odsetek pytań, na które użytkownicy udzielają rzeczowych odpowiedzi.
Czy Akt o sztucznej inteligencji (EU AI Act) wymaga ludzkiego handoffu w agentach AI?
W przypadku systemów wysokiego ryzyka Artykuł 14 wymaga, aby osoby nadzorujące rozumiały ograniczenia systemu, unikały ulegania automatyzacji (automation bias), mogły modyfikować lub cofać wyniki oraz zatrzymać system w dowolnej chwili. Po przyjęciu pakietu Digital Omnibus obowiązki te obejmują systemy wysokiego ryzyka z załącznika III od 2 grudnia 2027 roku. Większość agentów w produktach nie zalicza się do tej kategorii, jednak wzorzec: zapytaj, nadpisz i zatrzymaj (ask, override, stop) to doskonała praktyka projektowa dla każdego z nich.
GDPR-aligned. EU workspace data is stored in Frankfurt, Germany. GDPR and EU data Built in Vienna, Austria. A product of influence solutions fm GmbH (FN 675374y). Imprint 14-day trial. Card required, and nothing is charged until day 14. 30-day refund after subscribing. See pricing