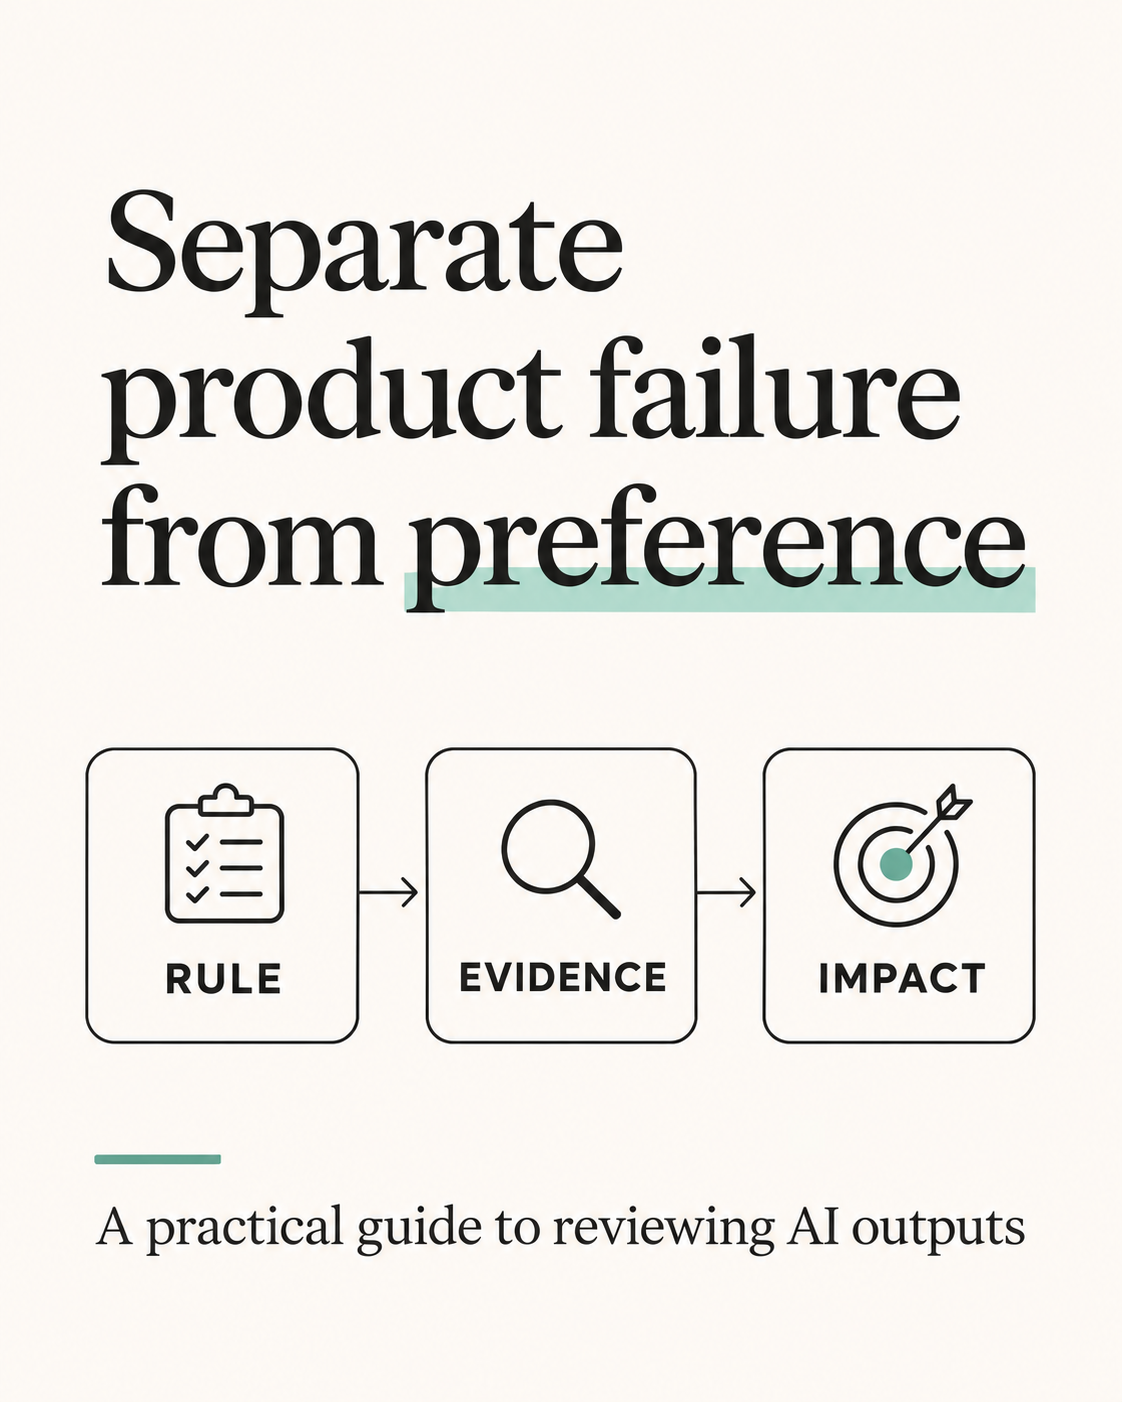
Jak PM-owie powinni anotować wyniki AI: oddziel błędy produktu od preferencji
Praktyczna metoda ewaluacji produktów AI: oddziel naruszenia zasad, brakujący kontekst i osobiste preferencje, aby feedback do wygenerowanych odpowiedzi realnie poprawiał zachowanie produktu.
Udostępnij
Ten artykuł został przetłumaczony z języka angielskiego. Przeczytaj oryginał
Ocena punktowa to nie wyjaśnienie
Osoba weryfikująca ocenia odpowiedź AI na cztery gwiazdki. Co zespół produktowy powinien zmienić?
Może odpowiedź minęła się z pytaniem użytkownika. Może zawierała twierdzenie bez żadnego źródła. Może fakty się zgadzały, ale ton wydał się zbyt sztywny. A może recenzent woli inną strukturę tekstu, mimo że wygenerowana odpowiedź w pełni zrealizowała zadanie.
Wszystkie te reakcje są przydatne, ale opisują zupełnie inne kwestie. Jeśli każda z nich zleje się w prostą ocenę „jakość: 4/5”, zespół traci informacje niezbędne do ulepszenia produktu.
Praktyczny proces anotacji zaczyna się od rozdzielenia trzech rzeczy: co faktycznie zrobił model, jaką regułę produktu spełnił lub naruszył oraz jakie były osobiste preferencje recenzenta. Dzięki temu weryfikacja staje się narzędziem do precyzowania zachowania produktu, a nie konkursem popularności wygenerowanego tekstu.
Zdecyduj, jaki rodzaj oceny zbierasz
Zanim poprosisz kogokolwiek o oznaczanie wyników etykietami, ustal, co te etykiety mają reprezentować.
Czasami produkt wymaga bezwzględnie spójnych zasad (tzw. policy). Na przykład generowany przez AI brief produktowy nie może przedstawiać niepopartej źródłem opinii klienta jako faktu. Recenzenci powinni egzekwować tę regułę bez wyjątku. To jest ocena zgodności z zasadami (policy judgment): zespół definiuje jedno, ściśle określone zachowanie produktu.
Kiedy indziej produkt powinien uwzględniać różnice w potrzebach użytkowników. Jeden product manager woli zwięzłe podsumowanie, inny potrzebuje więcej szczegółów na spotkanie z interesariuszami. Jeśli oba formaty sprawdzają się w ich pracy, odnotowanie tej preferencji uczy model działania w różnych kontekstach. To jest ocena preferencji (preference judgment), a nie automatycznie błąd produktu.
Badania nad anotacją w subiektywnych zadaniach przetwarzania języka naturalnego (NLP) opisują podobne rozróżnienie: między zbieraniem różnych perspektyw a instruowaniem weryfikatorów, by stosowali jedną, odgórnie zdefiniowaną zasadę. Wybór zależy od tego, czemu ma służyć dany zbiór danych. Dokładnie ten sam dylemat staje przed zespołem produktowym oceniającym wyniki AI: uczycie się preferencji użytkowników czy ustalacie, co produkt bezwzględnie musi robić?
Wpisz cel bezpośrednio nad formularzem weryfikacji:
Zbieramy te oznaczenia, aby ocenić, czy wynik AI jest zgodny z ustalonym zachowaniem produktu dla tego zadania.
Albo:
Zbieramy te reakcje, aby dowiedzieć się, które z poprawnych stylów odpowiedzi sprawdzają się lepiej u różnych użytkowników i w różnych sytuacjach.
Zespół może zbierać oba rodzaje informacji, ale etykiety muszą je wyraźnie rozdzielać.
Oznacz zachowanie, zanim ocenisz styl tekstu
Dla każdego wyniku odnotuj trzy rzeczy:
Zaobserwowane zachowanie: Co system faktycznie zrobił?
Kryterium: Jaka ustalona reguła produktu ma tu zastosowanie?
Wpływ: Co mogłoby się stać z perspektywy użytkownika, jeśli to zachowanie pozostanie bez zmian?
W przypadku funkcji syntezy badań przykładowy, zwięzły zestaw etykiet zachowań może wyglądać następująco:
Etykieta
Kiedy stosować
Niezrealizowane zadanie (Task miss)
Wynik nie odpowiada na zadanie (job), o które prosił użytkownik
Niepoparte twierdzenie (Unsupported claim)
Stwierdzenia faktu nie da się wywieść z dostarczonych materiałów
Istotne pominięcie (Important omission)
Brakuje kluczowego dowodu lub istotnej sprzeczności
Pomieszanie kontekstów (Context mix-up)
Wynik łączy źródła lub osoby, które powinny pozostać rozdzielone
Błędny kolejny krok (Wrong next step)
Rekomendacja nie wynika z dowodów ani ze wskazanego celu
Preferencja (Preference)
Wynik jest poprawny, ale recenzent wybrałby inny styl lub strukturę
Nie można ocenić (Cannot judge)
Brakuje źródła lub kontekstu zadania niezbędnego do weryfikacji
Te etykiety to tylko punkt wyjścia. Dostosuj je do rzeczywistych zadań użytkownika i ryzyk związanych z Twoim produktem. Etykieta taka jak „halucynacja” jest zazwyczaj zbyt ogólna, by pomóc w naprawie problemu. Z kolei uwaga: „Twierdzenie o powodzie odejścia klienta nie ma poparcia w żadnym fragmencie wywiadu” jasno mówi zespołowi, co poszło nie tak i jaki dowód pozwoliłby rozstrzygnąć sprawę.
Spraw, by każdy błąd dało się przeanalizować
Gdy weryfikator oznacza błąd produktu, poproś o krótką ścieżkę dowodową:
Zaznacz dokładną frazę lub sekcję w wygenerowanym tekście.
Podlinkuj źródło lub instrukcję zadania, z którą wynik powinien być zgodny.
Opisz oczekiwane zachowanie w jednym zdaniu.
Opisz wpływ błędu na użytkownika.
Oceń poziom krytyczności (severity) oddzielnie od pewności co do nadanej etykiety.
Przykład:
Pole
Przykład
Fragment wyniku
„Użytkownicy rezygnowali, ponieważ konfiguracja była zbyt skomplikowana”.
Źródło
Trzy wywiady wspominają o konfiguracji, ale żaden nie podaje jej jako powodu odejścia
Kryterium
Nie wskazuj przyczyny, jeśli nie potwierdza jej źródło
Oczekiwane zachowanie
Zaznacz, że wspomniano o konfiguracji; nie przesądzaj o powodzie
Wpływ
Zespół może nadać priorytet niewłaściwym usprawnieniom
Poziom krytyczności (Severity)
Wysoki dla tej decyzji
Pewność etykiety
Zdecydowana
Poziom krytyczności i stopień pewności odpowiadają na dwa różne pytania. Recenzent może nie mieć pewności, czy dane twierdzenie jest niepoparte źródłem, ale jednocześnie zdawać sobie sprawę, że jeśli tak jest – konsekwencje będą poważne. Rozdzielenie tych pól pomaga PM-owi zdecydować, które przypadki wymagają natychmiastowej analizy.
Nie proś recenzenta o stawianie diagnozy technicznej. Stwierdzenie „system retrievalu zawiódł” to tylko hipoteza na temat implementacji. W anotacji chodzi o udokumentowanie obserwowalnego błędu; inżynierowie zbadają, dlaczego do niego doszło.
Traktuj rozbieżności w ocenach jako sygnał
Gdy dwoje recenzentów wybierze różne etykiety, nie rozstrzygaj tego automatycznie zwykłą większością głosów. Najpierw sklasyfikuj przyczynę sporu:
Niejasna reguła: Recenzenci nie wiedzą, co właściwie obiecuje produkt. Przepisz kryterium i dodaj przykład.
Brakujący kontekst: Recenzentowi brakuje źródła, celu użytkownika lub uprawnień niezbędnych do oceny. Popraw przypadek testowy.
Nierozwiązany kompromis w zasadach (policy tradeoff): Obie oceny są racjonalne, ale implikują różne zachowania produktu. To PM powinien podjąć tę decyzję lub wypracować ją wspólnie z ekspertami dziedzinowymi.
Różnice w uzasadnionych preferencjach: Zachowaj preferencję i sprawdź, czy odzwierciedla ona konkretny segment użytkowników, zadanie lub kontekst.
Błąd w wykonaniu weryfikacji: Instrukcje mogą być jasne, ale ktoś mógł przeoczyć dowód lub źle zrozumieć zadanie. Doprecyzuj wytyczne i powtórz weryfikację tego przypadku.
Takie podejście zapobiega sprowadzaniu każdej rozbieżności do „błędu ludzkiego”. Rozbieżność może obnażyć lukę w regułach produktu albo rzeczywiste zróżnicowanie potrzeb użytkowników. Wspomniane badanie z 2022 roku dotyczące paradygmatów anotacji podkreśla kluczową myśl: czasami celem jest modelowanie różnych perspektyw, a kiedy indziej – egzekwowanie jednej, zdefiniowanej normy. Zdecyduj, który cel pasuje do Twojego produktu, zanim sprowadzisz wszystkie etykiety do pojedynczej wartości.
Przeprowadź krótką kalibrację przed skalowaniem weryfikacji
Zacznij od kilku reprezentatywnych wyników: prostego przypadku bazowego, przypadku z brakującym źródłem, sprzeczności, preferencji stylistycznej oraz przypadku granicznego. Poproś dwoje lub więcej weryfikatorów o niezależne oznaczenie próbek, a następnie wspólnie porównajcie zebrane dowody i tok rozumowania.
Celem kalibracji nie jest uzyskanie idealnego wskaźnika zgodności. Chodzi o wychwycenie miejsc, w których instrukcje nie pozwalają odróżnić:
błędu merytorycznego od niepopartej dedukcji,
brakującego szczegółu od szczegółu nieistotnego z perspektywy zadania użytkownika,
preferencji stylistycznej od problemu z użytecznością,
drobnej wady o niskim wpływie od błędu blokującego wdrożenie (release-blocker),
błędu modelu od brakującego lub słabej jakości kontekstu wejściowego.
Zaktualizuj wytyczne o wypracowane wnioski i zwięzły przykład. Zachowaj też pierwotne, niezależne oceny – pokazują one, czy źródłem rozbieżności był sam przypadek, przyjęta reguła, czy może treść instrukcji.
Standard NIST AI Risk Management Framework wzywa zespoły do precyzyjnego definiowania odpowiedzialności i nadzoru na styku człowieka i AI. Dla zespołu produktowego przewodnik weryfikacji jest praktycznym sposobem na uwidocznienie tych ról: kto odpowiada za wiedzę domenową, kto egzekwuje regułę, a kto monitoruje implementację techniczną i niezawodność.
Przełóż anotacje na decyzje produktowe
Sam zbiór anotacji nie oznacza jeszcze decyzji o wdrożeniu. Jest natomiast materiałem dowodowym przy rozstrzyganiu kwestii takich jak:
Czy zachowanie produktu jest zdefiniowane wystarczająco jasno, by przekazać je do developmentu?
Który błąd wymaga zmiany reguł produktu (product policy)?
Który problem wynika z implementacji technicznej lub stabilności systemu?
Czy zespół potrzebuje więcej reprezentatywnych przykładów?
Czy dana uwaga to uzasadniona preferencja, która wymaga personalizacji funkcji?
Co należy zweryfikować ponownie po zmianie promptu, modelu lub całego workflow?
Prowadź zwięzły rejestr każdej serii weryfikacji: zadanie i kontekst użytkownika, wersja reguł produktu, przykładowe materiały źródłowe, etykiety, nierozstrzygnięte spory, decyzje oraz osoba odpowiedzialna (owner). Gdy zmieniasz regułę, nadaj jej nowy numer wersji i przejrzyj powiązane z nią przykłady. Dzięki temu zespół z łatwością ustali, czy zmiana w odpowiedziach to efekt aktualizacji założeń produktu, czy też innego zachowania samego systemu.
PM-owie odpowiadają za wizję docelowego zachowania z perspektywy użytkownika, domenowe kompromisy i to, czego dane przykłady mają nauczyć system. Mogą pisać prompty, oceniać wygenerowane odpowiedzi i definiować kryteria akceptacji, ponieważ praca ta bezpośrednio precyzuje kształt produktu. Inżynierowie odpowiadają za wdrożenie produkcyjne, kontrolę dostępu, niezawodność oraz architekturę techniczną, która pozwala zrealizować założone zachowanie.
Karta anotacji do skopiowania
Skorzystaj z tego szablonu podczas najbliższej sesji weryfikacji:
Zadanie i użytkownik: Weryfikowana reguła produktu: Fragment wygenerowanego tekstu: Źródło lub kontekst: Zaobserwowane zachowanie: Oczekiwane zachowanie: Wpływ na użytkownika i poziom krytyczności (severity): Pewność etykiety: Błąd reguły produktu (policy failure), brakujący kontekst czy preferencja? Decyzja, owner i termin kolejnego przeglądu:
Jeśli zespół nie jest w stanie wypełnić pola z regułą produktu, wstrzymaj ocenianie i najpierw ustalcie, jak produkt powinien się zachować. Kryteria mają sens tylko wtedy, gdy odzwierciedlają decyzję produktową, za którą zespół jest gotów wziąć pełną odpowiedzialność.
GDPR-aligned. EU workspace data is stored in Frankfurt, Germany. GDPR and EU data Built in Vienna, Austria. A product of influence solutions fm GmbH (FN 675374y). Imprint 14-day trial. Card required, and nothing is charged until day 14. 30-day refund after subscribing. See pricing