4 listopada 2026Zaktualizowano Fathy Shalaby14 min czytania
Jak priorytetyzować zastosowania AI: scorecard dla zespołów produktowych
Porównuj pomysły na produkty z AI za pomocą ważonego scorecardu: dowody od użytkowników, wpływ, przewaga AI, możliwość oceny, kontrola błędów i czas nauki. Wybierz, co przetestować dalej, a nie co wdrożyć.
Udostępnij
Ten artykuł został przetłumaczony z języka angielskiego. Przeczytaj oryginał
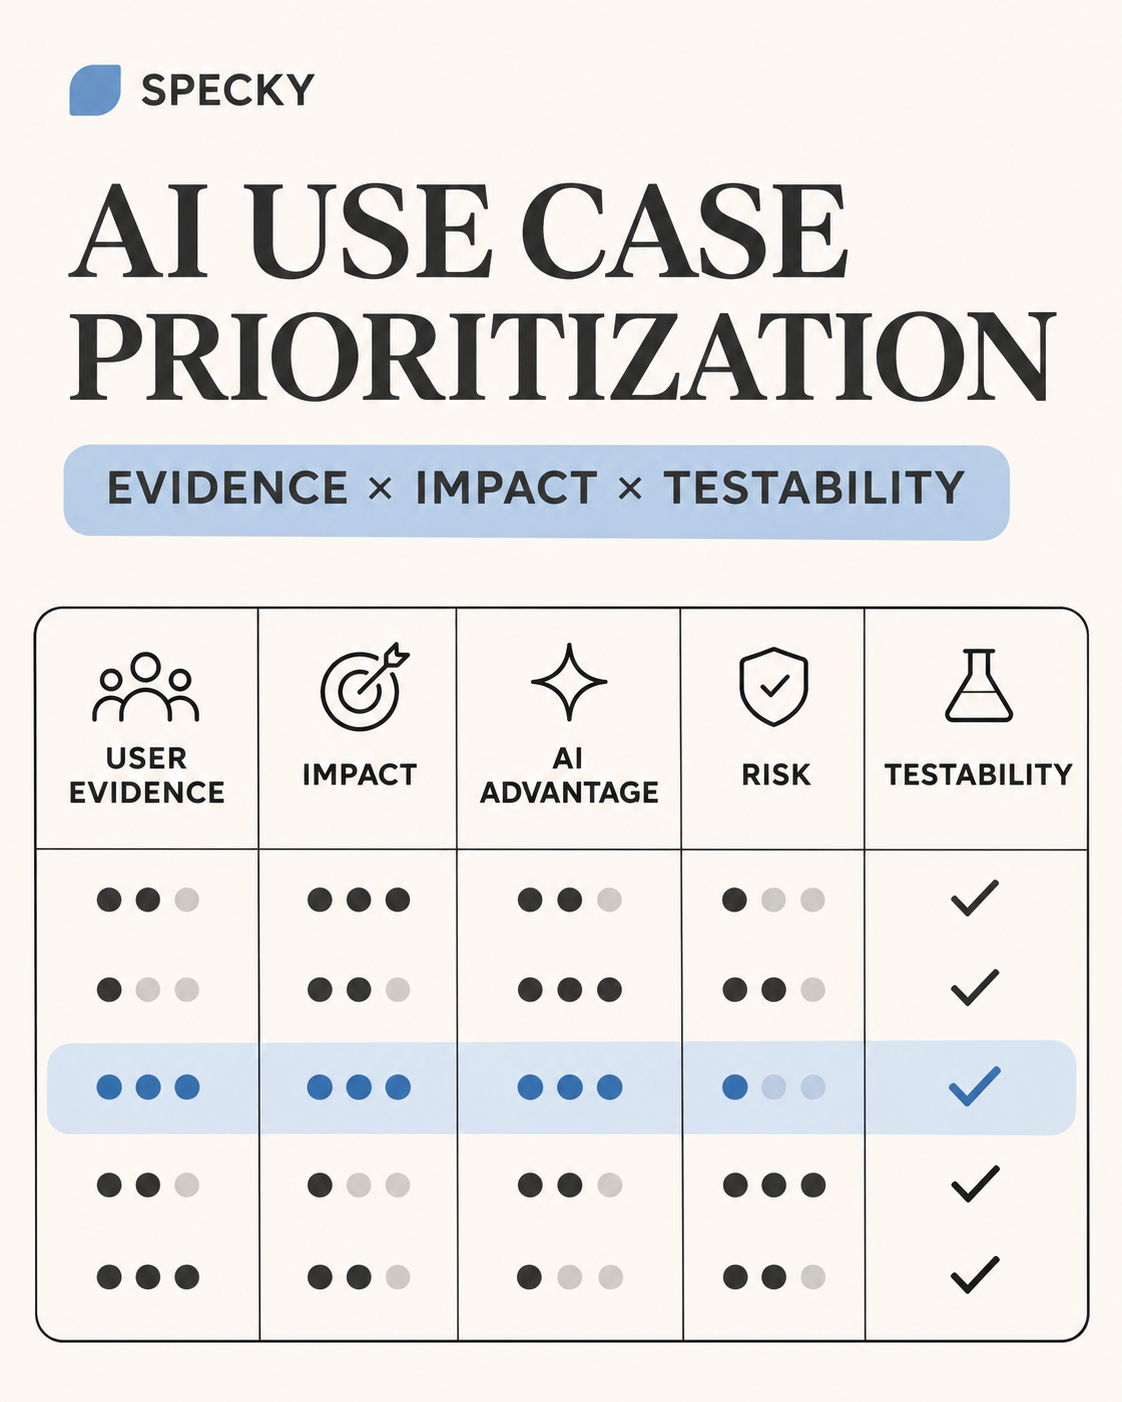
Aby priorytetyzować zastosowania AI, porównuj problemy użytkowników, a nie funkcje AI, a potem wybierz, który z nich przetestujesz jako pierwszy. Oceń każdego kandydata pod kątem siły dowodów na problem, oczekiwanego efektu dla użytkownika, przewagi AI nad prostszą opcją, możliwości oceny, kontroli błędów i czasu potrzebnego na naukę. Przed punktowaniem zastosuj trzy bramki gotowości, a wynik traktuj jako sposób na ujawnienie kompromisów, nie jako prognozę.
To inna decyzja niż pytanie, czy jedna funkcja powinna korzystać z AI. Czteropytaniowy test dopasowania AI pomaga ocenić pojedynczą funkcję. Ten scorecard pomaga założycielowi, pierwszej osobie na stanowisku product, PM-owi lub product engineerowi zdecydować, który z kilku kandydatów zasługuje na ograniczoną uwagę zespołu.
Najważniejsze wnioski
Większość inicjatyw AI grzęźnie, zanim zacznie się opłacać. Z badania BCG wśród 1000 menedżerów w 59 krajach wynika, że 74% firm nie wykazało jeszcze wymiernej wartości z AI, a tylko 26% potrafiło wyjść poza proof of concept (BCG, 2024).
Badanie MIT NANDA z 2025 roku, oparte na 150 wywiadach i 300 publicznych wdrożeniach, wykazało, że tylko około 5% pilotaży AI przyniosło szybki wzrost przychodów (Fortune, 2025).
Ograniczeniem rzadko jest model. Liderzy z badania BCG przeznaczali 10% zasobów na algorytmy, 20% na technologię i dane, a 70% na ludzi i procesy.
Przewodnik PAIR Guidebook Google'a wymienia przypadki, w których AI prawdopodobnie nie jest lepsza, w tym utrzymanie przewidywalności i minimalizowanie kosztownych błędów (Google PAIR).
Największą wagę nadaj dowodom na problem i efektowi dla użytkownika. W poniższym scorecardzie stanowią one razem 55% całości.
Dlaczego tyle zastosowań AI kończy się porażką?
Zespoły zwykle wybierają projekty AI tak, jak wybierają dema: według tego, co robi wrażenie w prototypie. Dane o porażkach wskazują coś innego.
Luka tkwi w wartości, a nie w możliwościach. BCG ustaliło, że tylko 4% firm miało najbardziej zaawansowane możliwości AI we wszystkich funkcjach, a liderzy większość wysiłku wkładali w ludzi i procesy, nie w algorytmy ().
O wynikach decydują procesy pracy. Raport MIT NANDA przypisał porażki „luce w uczeniu się” po stronie narzędzi i organizacji, a nie jakości modeli, i stwierdził, że narzędzia kupione od wyspecjalizowanych dostawców odnosiły sukces w około 67% przypadków, a rozwiązania budowane wewnętrznie około trzy razy rzadziej (Fortune, 2025). Zanim zacytujesz liczbę 95%, przeczytaj, co ona faktycznie mierzyła.
Użytkownicy sprawdzają wynik. W ankiecie Stack Overflow z 2025 roku 46% programistów nie ufało dokładności narzędzi AI, a 33% jej ufało, natomiast 66% jako największą frustrację wskazało odpowiedzi „prawie dobre, ale nie do końca” (Stack Overflow, 2025). Jeśli twoi użytkownicy nie mogą zweryfikować wyniku, albo go zignorują, albo zaufają mu wtedy, gdy nie powinni.
Wzorzec jest taki: wybierz wąski, udokumentowany problem użytkownika z widocznym sposobem sprawdzania jakości, a projekty AI zachowują się jak zwykłe zakłady produktowe. Pomiń te kroki, a prototyp stanie się strategią.
Zacznij od problemów-kandydatów, nie od funkcji AI
Lista pomysłów często miesza różne rzeczy: problemy użytkowników, zgłaszane funkcje, eksperymenty i możliwości techniczne. Ujednolić każdego kandydata, zanim zaczniesz go porównywać.
Dla każdego pomysłu zapisz:
Użytkownik i sytuacja: Kto napotyka problem i kiedy?
Job: Co ta osoba próbuje osiągnąć?
Obecne podejście: Co robi dziś, łącznie z obejściami?
Dowody: Co zaobserwowano bezpośrednio i gdzie zespół może to sprawdzić?
Pożądany rezultat: Co byłoby lepsze dla użytkownika?
Wkład AI: Która część zadania może skorzystać na języku, syntezie lub dopasowaniu?
Koszt błędu: Co może pójść nie tak i kto by to zauważył?
Pierwszy test: Jaki jest najmniejszy eksperyment, który odpowie na istotne pytanie?
„Dodaj asystenta roadmapy opartego na AI” nie nadaje się jeszcze do porównania. „Osoba, która jest pierwszym product hire, spędza piątek na łączeniu zgłoszeń z supportu i notatek z wywiadów, zanim zdecyduje, co zbadać” to lepszy kandydat: wskazuje użytkownika, zadanie i dowody, których zespół może szukać.
Nie traktuj prośby interesariusza, upvote'a ani przekonującego prototypu jako dowodu, że problem jest powszechny. Zachowaj powiązanie z oryginalnym źródłem i zapisz, czego ono nie dowodzi. Pętla discovery dla produktów z AI pokazuje dwutygodniowy sposób zbierania i przeglądania takich sygnałów.
Jakie bramki gotowości powinien najpierw przejść przypadek użycia AI?
Wysoki wynik nie powinien przykrywać podstawowego powodu, by poczekać. Zanim ułożysz pomysły w kolejności, sprawdź trzy bramki:
Problem użytkownika jest na tyle konkretny, że da się go zbadać. Potrafisz wskazać użytkownika, opisać niedawną sytuację i znaleźć co najmniej jedno źródło lub jasny krok discovery.
Użyteczny rezultat da się zaobserwować. Zespół potrafi powiedzieć, co ma się poprawić i jaki wskaźnik ochronny nie może się pogorszyć.
Kosztowny błąd ma widoczną kontrolę. Zespół może wykryć, sprawdzić, ograniczyć lub cofnąć dany błąd, zanim rozszerzy funkcję.
Jeśli pomysł nie przechodzi którejś bramki, zaznacz, jakich dowodów lub jakiej pracy projektowej brakuje. Może zostać na liście, ale nie powinien wygrywać tylko dlatego, że prototyp łatwo zbudować.
Jak punktować i porównywać zastosowania AI?
Dla każdego wymiaru użyj skali od 1 do 5. Poniższe wagi są punktem wyjścia do dyskusji, a nie formułą potwierdzoną badaniami. Zmień je, jeśli wymaga tego strategia lub profil ryzyka twojego zespołu. Obok każdej oceny zapisz uzasadnienie.
Wymiar
Waga
1 – słabe
3 – mieszane
5 – mocne
Dowody na problem
30%
Głównie założenie
Jeden wiarygodny sygnał, wzorzec niejasny
Powtarzalne, możliwe do sprawdzenia dowody od docelowych użytkowników
Efekt dla użytkownika
25%
Korzyść jest mglista lub wewnętrzna
Prawdopodobna korzyść dla użytkownika, z lukami
Konkretne zadanie lub rezultat powinny się poprawić
Przewaga AI
15%
Reguła lub zwykłe wyszukiwanie mogą działać równie dobrze
AI mogłaby pomóc w jednej części
AI radzi sobie ze znaczną zmiennością, językiem lub syntezą
Możliwość oceny
15%
Brak przykładów i kryteriów przeglądu
Trochę przykładów, ważne luki pozostają
Dostępne są reprezentatywne przypadki i obserwowalne kontrole jakości
Kontrola błędów
10%
Błędy mogą być niezauważone lub trudne do cofnięcia
Istnieje jakiś przegląd lub rozwiązanie awaryjne
Błędy są widoczne, ograniczone i możliwe do naprawienia na czas testu
Czas nauki
5%
Test wymaga szerokiej integracji lub długiego zobowiązania
Pilotaż jest możliwy, ale z zależnościami
Mały, odwracalny test może odpowiedzieć na następne pytanie
Wynik ważony obliczasz jako ocenę podzieloną przez 5 i pomnożoną przez wagę, a potem dodajesz sześć wyników. Maksimum to 100. Użyj tej liczby, by uporządkować rozmowę, a nie by sugerować, że pomysł z wynikiem 4,1 jest obiektywnie lepszy od pomysłu z wynikiem 3,9. Poważne ryzyko lub niezaliczona bramka gotowości nadal wymagają bezpośredniej decyzji.
Przykład: porównanie trzech możliwych procesów z AI
Poniższy przykład jest hipotetyczny. Pokazuje, jak mały zespół mógłby porównać pomysły; nie jest wynikiem klienta Specky ani badaniem rynku.
Kandydat
Dowody do sprawdzenia
Główna niepewność
Rozsądny pierwszy test
Grupowanie notatek z wywiadów z klientami w tematy
Niedawne wywiady i obecny czas poświęcany na syntezę
Czy sugerowane tematy zachowują rozbieżności i kontekst źródeł
Poprosić recenzentów o powiązanie każdego tematu z oryginalnymi fragmentami i oznaczenie brakujących kontrprzykładów
Przygotowanie szkicu briefu produktowego na podstawie dowodów od klientów
Przykłady briefów, dokumenty źródłowe i etapy przepisywania
Czy szkic oszczędza pracę przy przeglądzie, nie dodając twierdzeń bez pokrycia
Wymagać linków do źródeł przy twierdzeniach o faktach i oddać szkic do przeglądu PM-owi lub product engineerowi
Automatyczne rankingowanie próśb do roadmapy
Źródła próśb, historia decyzji i sposób, w jaki obecnie ustala się priorytety
Czy ranking ukrywa brakujący kontekst lub zostaje wzięty za decyzję
Najpierw pokazać dowody i kompromisy; decyzję o priorytetach zostawić człowiekowi
Teraz je oceńmy. Liczby znów mają charakter ilustracyjny:
Wymiar (waga)
Grupowanie notatek z wywiadów
Szkic briefu produktowego
Automatyczny ranking roadmapy
Dowody na problem (30%)
4 → 24
3 → 18
2 → 12
Efekt dla użytkownika (25%)
4 → 20
4 → 20
2 → 10
Przewaga AI (15%)
5 → 15
4 → 12
3 → 9
Możliwość oceny (15%)
3 → 9
3 → 9
1 → 3
Kontrola błędów (10%)
4 → 8
3 → 6
1 → 2
Czas nauki (5%)
5 → 5
4 → 4
2 → 2
Wynik ważony (ze 100)
81
69
38
Bramki gotowości
Zaliczone
Zaliczone
Nie przechodzi bramki 3
Pomysł z grupowaniem wywiadów prowadzi o 12 punktów i ma najtańszy test, więc idzie pierwszy. Szkicowanie briefów to rozsądny drugi pilotaż, gdy pierwszy wypracuje kryteria przeglądu, które zespół może ponownie wykorzystać. Pomysł automatycznego rankingu nie przechodzi bramki kontroli błędów: uszeregowana lista wygląda na miarodajną, a błędna mogłaby po cichu sterować roadmapą. Zostaje na liście z notatką, co musiałoby się zmienić.
Czym scorecard zastosowań AI różni się od RICE?
Scorecard zastosowań AI
RICE
Wartość a wysiłek
Porównywana jednostka
Problemy użytkowników z wątkiem AI
Funkcje lub projekty
Funkcje lub projekty
Ocena i ryzyko błędu
Punktowane wprost (łącznie 25%)
Wchłonięte przez Confidence
Nieuwzględnione
Pyta „czy wystarczyłoby prostsze narzędzie?”
Tak, przez przewagę AI
Nie
Nie
Wynik
Który test zrobić pierwszy
Kolejność budowy
Zgrubna siatka
Najlepsze do
Wyboru między pomysłami z AI
Ustalania kolejności w ocenionym backlogu
Szybkiego sortowania
RICE nadal ma swoje miejsce, gdy funkcja AI się sprawdzi i trafi do zwykłego backlogu. Na ten etap zobacz RICE scoring z AI.
Kiedy AI jest niewłaściwym narzędziem dla danego zastosowania?
„AI sprawi, że to będzie mądrzejsze” nie jest użytecznym uzasadnieniem oceny. Nazwij konkretną pracę, w której model może pomóc, i porównaj ją z najprostszym użytecznym punktem odniesienia:
Czy zadanie dotyczy zróżnicowanego języka lub nieustrukturyzowanych dowodów?
Czy ważna jest synteza z wielu źródeł?
Czy użytkownik może sprawdzić wynik względem tych źródeł?
Czy wyszukiwanie, reguła, filtr lub krótki proces rozwiązałyby ten sam problem?
Jakie koszty, opóźnienia, przeglądy i utrzymanie dodaje wersja z AI?
People + AI Guidebook Google'a to przydatne źródło do osadzania projektowania AI w potrzebach użytkowników. Wymienia przypadki, w których AI jest prawdopodobnie lepsza, takie jak personalizacja, przewidywanie i rozumienie języka naturalnego, oraz takie, w których prawdopodobnie nie jest, jak utrzymanie przewidywalności, minimalizowanie kosztownych błędów, zapewnienie pełnej przejrzystości i optymalizacja pod wysoką szybkość i niski koszt. Nie potwierdza wag z tego scorecardu. Aby zdecydować, czy pojedyncza proponowana funkcja w ogóle potrzebuje modelu, skorzystaj z testu dopasowania AI.
Jak zaprojektować pierwszy test zastosowania AI?
Nie pilotuj całego pomysłu z roadmapy, gdy wąski test może odpowiedzieć na następne pytanie. Wybierz test w zależności od tego, czego wiesz najmniej:
Niepewność co do problemu: Zaobserwuj obecny proces pracy lub porozmawiaj z ludźmi o niedawnym, konkretnym przypadku.
Niepewność co do dopasowania AI: Porównaj model z regułą, wyszukiwaniem lub obecnym procesem ręcznym na reprezentatywnych przykładach.
Niepewność co do jakości: Zdefiniuj kryteria przeglądu i uwzględnij trudne lub niejednoznaczne dane wejściowe. Pomaga w tym ramowy schemat ewaluacji funkcji AI.
Niepewność co do zaufania: Pozwól docelowym użytkownikom sprawdzić wynik, poprawić go, odrzucić lub cofnąć.
Niepewność co do rezultatu: Wybierz miarę powiązaną z zadaniem użytkownika, plus wskaźnik ochronny dla jakości, błędów, kosztu lub czasu.
Zapisz warunki kontynuacji i zatrzymania, zanim zobaczysz wyniki. Na przykład kontynuuj tylko wtedy, gdy ludzie mogą zweryfikować wynik, uzgodnione kontrole jakości są zaliczone, a test poprawia wykonanie zadania bez wywoływania nieakceptowalnego nakładu pracy na przegląd. Faktyczne progi ustal z zespołem na podstawie konsekwencji i stanu wyjściowego; nie ma uniwersalnego progu zaliczenia.
NIST AI Risk Management Framework, opublikowany 26 stycznia 2023 roku i przeznaczony do dobrowolnego stosowania, porządkuje pracę nad ryzykiem w obszary Govern, Map, Measure i Manage. 26 lipca 2024 roku NIST dodał profil dla generatywnej AI (NIST-AI-600-1). Traktuj je jako podpowiedzi do pytań specyficznych dla twojego produktu, a nie jako certyfikację ani zamiennik przeglądu przez ekspertów dziedzinowych.
Scorecard do priorytetyzacji zastosowań AI do skopiowania
Kandydat:
Użytkownik i sytuacja:
Job to be done:
Obecne podejście lub obejście:

Dowody i linki do źródeł:
Co pokazują dowody:
Czego nie pokazują:

Pożądany efekt dla użytkownika:
Wkład AI:
Najprostszy użyteczny punkt odniesienia:

Dowody na problem (1–5):        x 30% / 5 =
Efekt dla użytkownika (1–5):    x 25% / 5 =
Przewaga AI (1–5):              x 15% / 5 =
Możliwość oceny (1–5):          x 15% / 5 =
Kontrola błędów (1–5):          x 10% / 5 =
Czas nauki (1–5):               x  5% / 5 =
Wynik ważony (ze 100):
Powód każdej oceny:

Bramki gotowości:
[ ] Konkretny problem użytkownika i dowody
[ ] Obserwowalny rezultat i wskaźnik ochronny
[ ] Błąd da się wykryć, ograniczyć lub cofnąć

Zbudować, kupić czy skonfigurować istniejące narzędzie?:
Najmniejszy użyteczny test:
Właściciel:
Kontynuuj, jeśli:
Zatrzymaj lub przeprojektuj, jeśli:
Data przeglądu:
Trzymaj oryginalne linki do dowodów razem ze scorecardem. Jeśli ocena się zmienia, zapisz, jaka nowa informacja ją zmieniła. Lekki dziennik decyzji produktowych może zachować uzasadnienie i warunki ponownego rozważenia wyboru.
Typowe błędy przy priorytetyzacji zastosowań AI
Ranking według jakości dema. Prototyp, który działa na pięciu starannie dobranych danych wejściowych, mówi niewiele o setnym prawdziwym.
Pominięcie punktu odniesienia. Jeśli filtr lub zapisane wyszukiwanie rozwiązuje 80% problemu, wersja z AI musi to pobić, a nie pobić nic.
Pięć pilotaży naraz. Mały zespół nie oceni ich równolegle, a nakład pracy na przegląd zostanie przypisany niewłaściwemu procesowi.
Budowanie tego, co można kupić. Dane MIT NANDA sugerują, że kupione, wyspecjalizowane narzędzia odnoszą sukces częściej niż rozwiązania wewnętrzne. Dodaj opcję „kupić lub skonfigurować”, zanim zaczniesz punktować.
Brak spisanej polityki. W ankiecie Productboard z 2025 roku 65% z 379 specjalistów produktowych z dużych firm stwierdziło, że ich firma ma udokumentowaną politykę AI, czyli mniej więcej jedna trzecia jej nie miała (Productboard, 2025). Zdecyduj, jakich danych pilotaż może dotykać, zanim się zacznie.
Jak product engineerowie i buildery mogą korzystać ze scorecardu
Product engineerowie i techniczni założyciele często widzą drogę implementacji, zanim zespół porówna leżące u podstaw problemy. Wykorzystaj to tempo, by test był tańszy, a nie by pominąć dowody na problem. Inżynierowie mogą rozpoznać ograniczenia dostępu do danych i integracji, przygotować reprezentatywne przykłady i uczynić prototyp odwracalnym. Product builderzy mogą pomóc ujawnić założenia w specyfikacji i jasno opisać ścieżkę przeglądu.
Osąd produktowy zostaw zespołowi. AI może porządkować dowody dotyczące kandydatów lub szkicować opcje; nie powinna po cichu zamieniać wyniku w zobowiązanie wobec roadmapy. Pokrewny proces discovery prowadzony przez inżynierów opisuje customer discovery dla product engineerów. Aby przełożyć wybrany pomysł na szkic wymagań, użyj darmowego generatora PRD z AI i zachowaj powiązanie z dowodami źródłowymi.
Najczęstsze pytania
Czym jest priorytetyzacja zastosowań AI?
Priorytetyzacja zastosowań AI to porównywanie problemów użytkowników i procesów pracy, aby zdecydować, który zbadać lub przetestować jako pierwszy. Użyteczne porównanie obejmuje dowody od użytkowników, oczekiwany rezultat, konkretną przewagę AI, możliwość oceny i kontrole błędów. Kończy się wybranym testem i warunkami zatrzymania, a nie zobowiązaniem wobec roadmapy.
Jak priorytetyzować funkcje AI?
Zacznij od problemu użytkownika i obecnego obejścia. Zastosuj bramki gotowości, porównaj kandydatów według spójnych kryteriów i zrób mały test na pomyśle o najwyższym priorytecie, którego ryzyko da się kontrolować. Trzymaj wynik i uzasadnienie na widoku, aby nowe dowody mogły zmienić decyzję.
Czy mały zespół powinien budować kilka funkcji AI jednocześnie?
Zwykle lepiej testować mniej pomysłów naraz, gdy zespół nie jest w stanie ocenić ich równolegle. Wąski pilotaż ułatwia przypisanie nakładu pracy na przegląd, problemów z jakością i rezultatów dla użytkowników konkretnemu procesowi. Zakres dobierz do dostępnych dowodów i możliwości.
Co zrobić, gdy dwa zastosowania AI mają podobne wyniki?
Porównaj, jaką niepewność zmniejszyłby każdy test, jaka jest szkoda, jeśli proces zawiedzie, i czy pomysły zależą od tych samych danych lub tej samej integracji. Jeśli dowody nadal nie rozstrzygają, zrób krok discovery lub mały, odwracalny test zamiast zmyślać precyzję w punktacji.
Czy wynik zastosowania AI przewiduje sukces produktu?
Nie. Wynik to uporządkowane podsumowanie bieżących dowodów i założeń. Nie przewiduje adopcji, przychodów ani product-market fit. Zweryfikuj problem użytkownika i mierz, co dzieje się w prawdziwym procesie pracy.
Dlaczego dowody na problem mają większą wagę niż przewaga AI?
Ponieważ dane o porażkach wskazują na problemy i procesy pracy, a nie na modele. Liderzy z badania BCG przeznaczali 70% zasobów na AI na ludzi i procesy, a tylko 10% na algorytmy. Silny model zastosowany do nieudowodnionego problemu i tak zawiedzie, natomiast skromny model przy dobrze udokumentowanym, sprawdzalnym zadaniu może szybko dostarczyć wartość.
Wybierz test, a potem aktualizuj decyzję na podstawie dowodów
Przydatny proces priorytetyzacji zastosowań AI ułatwia dostrzeżenie wyboru i związanej z nim niepewności. Porównuj problemy-kandydatów, pokaż, dlaczego jeden test idzie pierwszy, i zapisz, co zmieniłoby decyzję. Celem jest poznanie, który proces pracy daje użytkownikom realną korzyść, a nie umieszczanie AI na roadmapie z automatu.
GDPR-aligned. EU workspace data is stored in Frankfurt, Germany. GDPR and EU data Built in Vienna, Austria. A product of influence solutions fm GmbH (FN 675374y). Imprint 14-day trial. Card required, and nothing is charged until day 14. 30-day refund after subscribing. See pricing