10 października 2026Zaktualizowano Fathy Shalaby15 min czytania
Checklista akceptacji kodu generowanego przez AI: przewodnik po przeglądzie dla PM-ów
Budowanie stało się tanie, akceptowanie wyniku nie. Czterostopniowa Acceptance Ladder pomaga PM-om sprawdzać zmiany zbudowane przez agentów pod kątem decyzji, briefu, przypadków brzegowych i rezultatu.
Udostępnij
Ten artykuł został przetłumaczony z języka angielskiego. Przeczytaj oryginał
Checklista akceptacji kodu generowanego przez AI to krótka lista kontroli, które product manager wykonuje, zanim zmiana zbudowana przez agenta zostanie uznana za gotową. Inżynierowie oceniają, jak napisano kod; PM sprawdza, czy to właściwa zmiana. Używamy czterech stopni, w tej kolejności: powiązać zmianę z decyzją, porównać ją z briefem, sprawdzić przypadki brzegowe i określić, jak poznasz, że zadziałała.
Najważniejsze wnioski
Anthropic opisuje rozwój oprogramowania jako przejście „od pisania kodu do orkiestrowania agentów, które piszą kod” (Anthropic, 2026). Deficytowa umiejętność przenosi się na miejsce recenzenta.
66% programistów mówi, że największą frustracją w narzędziach AI są rozwiązania prawie dobre, ale nie do końca (Stack Overflow, 2025). Zmiany prawie dobre przechodzą przegląd „wygląda dobrze”.
Płynny wynik zniekształca ocenę: w jednym badaniu z losowym doborem programiści wierzyli, że AI przyspieszyła ich o 20%, podczas gdy spowolniła ich o 19% (METR, 2025).
Agenci mają skłonność do budowania za dużo. Przegląd nadwyżek (wypisanie zachowań, o które nikt nie prosił) to kontrola, którą większość zespołów pomija.
Checklista nie zastępuje przeglądu kodu ani bezpieczeństwa: 45% próbek kodu wygenerowanego przez AI w teście z 2025 roku wprowadzało znane podatności (Veracode, 2025).
Dlaczego „wygląda dobrze” to zła poprzeczka dla kodu generowanego przez AI?
Większość zespołów recenzuje wynik pracy agenta tak, jak kiedyś pull requesty ludzi: przeglądają diff, klikają po podglądzie, zatwierdzają. To działa, gdy kolega niesie ze sobą kontekst ze spotkania planistycznego i rozmów z klientami. Zawodzi, gdy agent ma tylko to, co zakodował brief.
Jeśli brief był niejasny, agent wypełnia lukę najbardziej statystycznie prawdopodobnym zachowaniem, a prawdopodobne to nie to samo co poprawne. Zmiana się kompiluje, podgląd się renderuje, główna ścieżka działa i PM zatwierdza. Dwa tygodnie później ktoś zauważa, że po cichu pominęła ograniczenie, którego nikt nie zapisał, albo rozwiązała sąsiedni problem zamiast tego z briefu. Z kodem nic nie było nie tak. Etap akceptacji po prostu nigdy nie zadał właściwych pytań.
Trzy rzeczy sprawiają, że wynik pracy agenta trudniej ocenić niż wynik pracy człowieka:
Wolumen. Tania generacja oznacza więcej zmian kandydujących tygodniowo, więc czas przeglądu staje się wąskim gardłem.
Pewność siebie. Agenci płynnie opisują własną pracę. Schludne podsumowanie nie jest dowodem. Badanie METR z 2025 roku z udziałem 16 doświadczonych programistów i 246 prawdziwych zgłoszeń wykazało, że programiści spodziewali się przyspieszenia dzięki AI o 24%, a po pracy nadal wierzyli, że przyspieszyła ich o 20%, podczas gdy zmierzony wynik to spowolnienie o 19% (METR, 2025). METR mówi teraz, że te wyniki z początku 2025 są nieaktualne, a jego kontynuacja z lutego 2026 wykazała niewielkie szacowane przyspieszenia, które określa jako niewiarygodny sygnał (METR, 2026). Trwałą lekcją jest luka w percepcji, a nie liczba dotycząca szybkości.
Brak śladu intencji. Bez powiązania zmiany z decyzją, którą realizuje, nie odróżnisz „zbudowano zgodnie ze specyfikacją” od „zbudowano według domysłu”.
Dane o dostarczaniu wskazują ten sam kierunek. Badanie DORA Google z 2024 roku wykazało, że wzrost przyjęcia AI o 25% wiązał się z lepszą o 7,5% jakością dokumentacji, lepszą o 3,4% jakością kodu i szybszym o 3,1% przeglądem kodu. Jednak wraz ze wzrostem przyjęcia badacze oszacowali też spadek przepustowości dostarczania o 1,5% i stabilności dostarczania o 7,2% (DORA, 2024). Raport 2025 podsumowuje to tak: AI wzmacnia istniejące mocne i słabe strony organizacji (DORA, 2025). Słaby etap akceptacji jest jedną ze słabości, które wzmacnia.
Co powinien sprawdzać PM, a co inżynier?
Podziel przegląd. Praktyki inżynierskie Google wymieniają, na co patrzy recenzent kodu: projekt, funkcjonalność, złożoność, testy, nazewnictwo, komentarze, styl, spójność, dokumentacja i kontekst (Google). Większość to praca inżynierska. Jedno pytanie z listy należy do produktu: „Is what the developer intended good for the users of this code?”
Pytanie
Kto za nie odpowiada
Gdzie pada odpowiedź
Czy kod jest dobrze zaprojektowany, czytelny i przetestowany?
Inżynier
Przegląd kodu
Czy jest bezpieczny i poprawnie obsługuje uprawnienia?
Inżynier (z narzędziami bezpieczeństwa)
Przegląd kodu, skanery
Jaką decyzję lub dowód realizuje ta zmiana?
PM
Acceptance Ladder, stopień 1
Czy zbudowano to, co mówił brief, i tylko to?
PM
Stopień 2
Czy zachowuje się do obrony w przypadkach pustych, błędu, granicznych, uprawnień i powtórzeń?
PM i inżynier razem
Stopień 3
Jak i kiedy dowiemy się, że zadziałało dla użytkowników?
PM
Stopień 4
W zespole jednoosobowego założyciela jedna osoba nosi oba kapelusze. Mimo to rób te dwa przeglądy w osobnych przejściach: czytanie kodu pod kątem poprawności i czytanie zachowania pod kątem intencji wymagają innej uwagi.
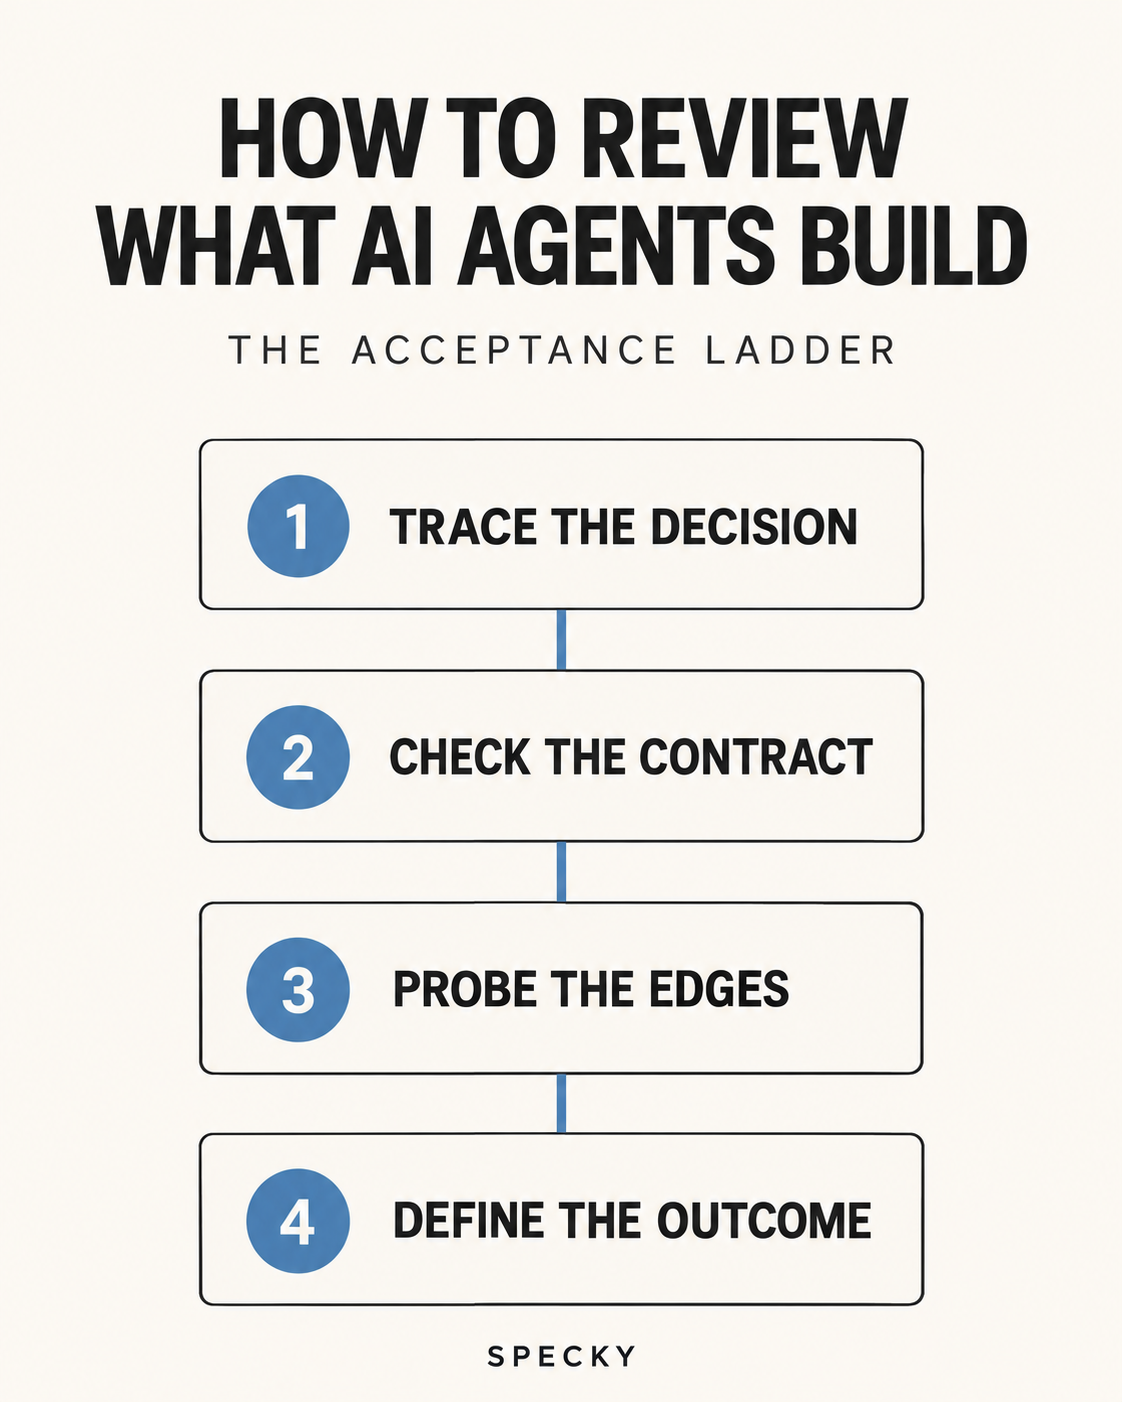
Acceptance Ladder: cztery kontrole, zanim zmiana zbudowana przez agenta będzie gotowa
Każdy stopień zadaje jedno pytanie. Na następny stopień wchodzisz tylko wtedy, gdy obecny zostanie zaliczony. Jeśli zmiana utknie na pierwszym stopniu, nie tracisz czasu na czwarty.
Stopień 1: Śledzalność. Jaką decyzję to realizuje?
Zanim przeczytasz jakikolwiek kod, odpowiedz na jedno pytanie: do jakiej decyzji lub jakiego dowodu sięga ta zmiana?
Zmiana powinna wskazywać konkretny element: zapis decyzji, wniosek z badań klientów, opportunity, eksperyment. Jeśli nie potrafisz go nazwać jednym zdaniem, zatrzymaj się. Albo praca nigdy nie była uzasadniona, albo uzasadnienie siedzi komuś w głowie, a agent nigdy go nie widział.
W Specky służy do tego Product Graph. Decyzje, wnioski i zgłoszenia to powiązane węzły, więc uruchomienie agenta może pobrać otaczający kontekst, zanim cokolwiek zaplanuje. Pierwsza kontrola recenzenta to po prostu to, czy to powiązanie istnieje i czy przywołany dowód mówi to, co twierdzi zmiana.
Warunek zaliczenia: jedna decyzja lub wniosek, nazwana, z dowodami osiągalnymi w dwóch kliknięciach.
Stopień 2: Kontrakt. Czy zbudowano to, co mówił brief, i tylko to?
Teraz porównaj zmianę z pisemnym briefem, wiersz po wierszu. Nie „czy to wydaje się dobre”, tylko dosłowny diff między kryteriami akceptacji a zaobserwowanym zachowaniem.
Zrób dwa przejścia:
Przejście pokrycia. Dla każdego kryterium akceptacji z briefu znajdź zachowanie, które je spełnia. Oznacz każde jako spełnione, częściowo spełnione lub brakujące.
Przejście nadwyżek. Wypisz zachowania, które zmiana wprowadza, a o które nie prosiło żadne kryterium. Agenci często dodają pomocne dodatki: nowe ustawienie, dodatkową kolumnę, ścieżkę awaryjną. Każdy z nich to niezrecenzowany zakres. Zachowaj go albo wytnij świadomie.
Przejście nadwyżek to to, które zespoły pomijają, i właśnie tu praca agenta najbardziej różni się od pracy człowieka. Z naszego doświadczenia człowiek ma skłonność do zbudowania mniej, niż mówi brief, a agent do zbudowania więcej.
Warunek zaliczenia: każde kryterium oznaczone jako spełnione, każdy element nadwyżki wyraźnie zachowany lub usunięty.
Stopień 3: Brzegi. Co się dzieje, gdy dane wejściowe są błędne, puste lub wrogie?
Agenci są mocni na głównej ścieżce, bo to opisują prompty. Stopień trzeci idzie tam, gdzie prompty rzadko sięgają. Zapisz pięć sytuacji i wypróbuj każdą:
Stan pusty: jeszcze brak danych.
Stan błędu: wywołanie nadrzędne się nie udaje.
Granica: największe i najmniejsze realistyczne dane wejściowe.
Uprawnienia: użytkownik, który nie powinien tego widzieć, próbuje.
Powtórzenie: akcja jest wykonywana dwa razy z rzędu.
Nie potrzebujesz wyczerpujących testów QA. Potrzebujesz pięciu sytuacji, na które prawdziwy klient natknie się w pierwszym tygodniu. Jeśli brief nie określał dla nich zachowania, to wada briefu, a poprawka trafia do briefu, nie tylko do kodu.
Kontrola uprawnień jest ważniejsza przy kodzie generowanym przez AI. Veracode przetestowało w 2025 roku ponad 100 modeli językowych i stwierdziło, że 45% wygenerowanych próbek kodu nie przechodziło testów bezpieczeństwa, przy czym Java miała wskaźnik niepowodzeń 72%, a 86% istotnych próbek nie broniło się przed cross-site scripting (Veracode, 2025). PM nie przeprowadzi takiego audytu, ale może nalegać, by „użytkownik bez dostępu próbuje to zobaczyć” było pisemnym, przetestowanym kryterium oraz by narzędzia bezpieczeństwa działały przy każdej zmianie agenta.
Warunek zaliczenia: wszystkie pięć sytuacji zachowuje się tak, że obroniłbyś to przed klientem.
Stopień 4: Dowód rezultatu. Jak poznamy, że zadziałało?
Zmiana może przejść trzy pierwsze stopnie i nadal być bezużyteczna. Ostatni stopień pyta, co zmierzysz i kiedy spojrzysz.
Zapisz kontrolę przed wdrożeniem: metrykę lub sygnał, oczekiwany kierunek i datę. „Zobaczymy, jak pójdzie” to nie kontrola. Tu też odfiltrowuje się szum: funkcja wdrożona szybko, ale bez kontroli rezultatu, to zgadywanka z datą wdrożenia.
Warunek zaliczenia: nazwany sygnał, oczekiwany kierunek i data w kalendarzu, kiedy go odczytasz.
Checklista akceptacji kodu generowanego przez AI do skopiowania
Wklej to do szablonu pull requesta lub do zgłoszenia. Jeden blok na każdą zmianę zbudowaną przez agenta.
CHECKLISTA AKCEPTACJI: [zmiana / link do PR]
Recenzent: [imię]   Data: [data]

STOPIEŃ 1 ŚLEDZALNOŚĆ
[ ] Decyzja lub wniosek, który to realizuje: [link]
[ ] Dowód jest osiągalny w dwóch kliknięciach i mówi to, co twierdzi brief

STOPIEŃ 2 KONTRAKT
Pokrycie (jeden wiersz na kryterium akceptacji):
  [kryterium 1]  spełnione / częściowo / brak
  [kryterium 2]  spełnione / częściowo / brak
Nadwyżka (zachowanie, o które nie prosiło żadne kryterium):
  [element]  zachować (dodano kryterium) / wyciąć (zgłoszone osobno)

STOPIEŃ 3 BRZEGI
[ ] Stan pusty      [ ] Stan błędu      [ ] Dane graniczne
[ ] Uprawnienia     [ ] Powtórzona akcja
Znalezione wady briefu (dodać do briefu, nie tylko do kodu): [lista]

STOPIEŃ 4 REZULTAT
Sygnał: [metryka]   Oczekiwany kierunek: [w górę/w dół]   Odczyt dnia: [data]

INŻYNIERIA (to nie decyzja PM-a, ale potwierdź, że się wydarzyło)
[ ] Przegląd kodu wykonany   [ ] Testy dodane/zaktualizowane   [ ] Kontrole bezpieczeństwa uruchomione

WYNIK: zaakceptować / odesłać ze zmianami w briefie
Jak wygląda checklista na prawdziwej zmianie?
Załóżmy, że twój zespół poprosił agenta o dodanie akcji „archiwizuj zbiorczo” do skrzynki z feedbackiem.
Stopień 1. Brief linkuje do wniosku: support traci czas na czyszczenie przestarzałych pozycji, a trzy rozmowy z klientami o tym wspominają. Dowód jest osiągalny. Zaliczone.
Stopień 2. Przejście pokrycia stwierdza spełnienie wszystkich czterech kryteriów. Przejście nadwyżek stwierdza, że agent dodał też toast „cofnij” i nową kartę filtra „zarchiwizowane”. Cofnięcie warto zachować i dostaje kryterium z mocą wsteczną. Karta filtra zmienia nawigację i nikt o nią nie prosił, więc zostaje wycięta i zgłoszona jako osobna opportunity. Zaliczone po jednej poprawce.
Stopień 3. Stan pusty pokazuje pusty panel bez wyjaśnienia. Niezaliczone. Poprawka trafia do briefu jako brakujące kryterium, a potem wraca do agenta.
Stopień 4. Sygnałem jest mediana czasu opróżnienia skrzynki, oczekiwany spadek, odczyt za dwa tygodnie.
Przegląd przyniósł jedno niezaliczenie i dwie poprawki, wychwycone przed wydaniem. Przegląd „wygląda dobrze” wypuściłby razem pusty panel i niezamówioną kartę nawigacji.
Po wpisaniu do checklisty wiersz wyniku brzmi: 4 z 4 kryteriów spełnione, 2 elementy nadwyżki (1 zachowany, 1 wycięty), 1 z 5 przypadków brzegowych niezaliczony, odczyt rezultatu zaplanowany na dzień 14. Odesłać z jedną zmianą w briefie.
Jak pisać kryteria akceptacji, których agent nie może źle zrozumieć?
Ladder jest tak dobra, jak kryteria na stopniu drugim. Atlassian definiuje kryteria akceptacji jako warunki, które praca musi spełnić, by uznać ją za ukończoną, i wymienia cechy dobrych: jasne, testowalne, skupione na rezultacie, a nie na metodzie, mierzalne tam, gdzie to możliwe, i niezależne od siebie (Atlassian). Dla agentów najważniejsza jest testowalność: kryterium, którego agent nie może zweryfikować, to kryterium, które zinterpretuje.
Given-When-Then, opracowane przez Daniela Terhorsta-Northa i Chrisa Mattsa w ramach behaviour-driven development, to dobra forma do tego (Fowler, 2013). Given to stan przed, When to akcja, Then to oczekiwana zmiana.
Niejasne (agent zgadnie)
Testowalne (agent może sprawdzić)
Archiwizacja działa dobrze
Given 3 zaznaczone pozycje, when użytkownik kliknie Archiwizuj, then wszystkie 3 znikną z listy skrzynki w ciągu 1 sekundy
Obsłuż stany puste
Given brak pozycji w skrzynce, when strona się załaduje, then pokaż „Nic do przejrzenia” i link do ustawień
Tylko administratorzy mogą archiwizować
Given użytkownik z rolą Viewer, when otworzy skrzynkę, then przycisk Archiwizuj nie jest pokazany, a API zwraca 403
Spraw, by było szybko
Given 500 pozycji, when użytkownik zaznaczy wszystkie i zarchiwizuje, then akcja kończy się w czasie poniżej 3 sekund
Niczego nie psuj
Given zarchiwizowana pozycja, when użytkownik otworzy jej bezpośredni link, then otworzy się tylko do odczytu z etykietą „Zarchiwizowane”
Ladder działa najlepiej, gdy jej część nie jest ręczna. Dwa praktyczne ruchy:
Zwaliduj plan, zanim agent napisze kod. Specky udostępnia to przez swój serwer MCP dla agentów kodujących: agent wywołuje validate_agent_plan względem twoich standardów inżynierskich, zanim zacznie, oraz validate_agent_change, zanim zgłosi sukces. To przesuwa stopień drugi na wcześniej, więc plan jest sprawdzany względem reguł, gdy zmiana jest jeszcze tania.
Trzymaj dowody przy sobie. Gdy decyzja, brief, uruchomienie agenta i kontrola rezultatu są węzłami w jednym grafie, stopień pierwszy przestaje być polowaniem. Recenzent otwiera zmianę, a powód już jest obok.
Stosowanie Ladder w małym zespole
Nie potrzebujesz komisji przeglądowej. Dla jednoosobowego założyciela lub zespołu trzech do dziesięciu osób Ladder to pięciominutowy nawyk na zmianę, a kolejność liczy się bardziej niż ceremoniał.
Zacznij od pisania kryteriów akceptacji jako krótkich, sprawdzalnych zdań w samym briefie, na przykład „zarchiwizowane pozycje znikają z listy skrzynki” zamiast „archiwizacja działa dobrze”. Takie zdania sprawiają, że przejście pokrycia jest mechaniczne, a nie kwestią gustu. Następnie prowadź stałą listę swoich pięciu sytuacji brzegowych, żeby stopnia trzeciego nie wymyślać za każdym razem od nowa. Na koniec uczyń kontrolę rezultatu częścią definition of done: jeśli zmiana nie ma sygnału ani daty, nie jest gotowa do scalenia.
Gdy zmiana nie przejdzie któregoś stopnia, oprzyj się pokusie łatania jej w wątku przeglądu. Odeślij ją z brakującym kryterium dodanym do briefu. Brief jest trwałym artefaktem; wątek znika. W ciągu miesiąca twoje briefy się wyostrzą, a odsetek niepowodzeń na stopniach drugim i trzecim spadnie, i to jest prawdziwa korzyść.
Co mierzyć w swoim procesie przeglądu
Traktuj Ladder jak proces, który możesz badać:
Rozkład niepowodzeń według stopni. Jeśli większość porażek wypada na stopniu drugim, problemem są twoje briefy. Jeśli na trzecim, twoje prompty pomijają przypadki brzegowe.
Odsetek nadwyżek. Jak często agent dodaje niezamówiony zakres? Rosnący odsetek oznacza, że briefy zostawiają zbyt wiele swobody.
Wykonanie kontroli rezultatu. Ile wdrożonych zmian dostało odczyt stopnia czwartego w ustalonym terminie? Ta liczba pokazuje, czy się uczysz, czy tylko wdrażasz.
Nie potrzebujesz do tego dashboardu. W pierwszym miesiącu wystarczy tabela z jednym wierszem na każdą przejrzaną zmianę.
Kiedy ta checklista nie działa?
To nie jest przegląd kodu ani bezpieczeństwa. Ladder sprawdza intencję i zachowanie. Skoro 39% programistów w badaniu DORA 2024 deklaruje niewielkie lub zerowe zaufanie do kodu generowanego przez AI, przegląd inżynierski i automatyczne kontrole pozostają obowiązkowe (DORA, 2024).
To przesada przy drobnych zmianach. Poprawka tekstu lub zmiana koloru wymaga co najwyżej stopnia drugiego. Pełną Ladder zachowaj dla wszystkiego, z czego skorzysta klient lub co dotyka danych albo uprawnień.
Nie uratuje złej decyzji. Stopień pierwszy sprawdza, czy decyzja istnieje, a nie czy była słuszna. Jeśli problem leżący u podstaw jest niejasny, wróć do opisu problemu, zanim przejrzysz więcej kodu.
Zależy od tego, czy odczyt rezultatu rzeczywiście nastąpi. W przypadku funkcji AI, których wynik sam się zmienia, połącz stopień czwarty z frameworkiem ewaluacji AI, a nie z jedną metryką.
Najczęściej zadawane pytania
Czym jest checklista akceptacji kodu generowanego przez AI?
To krótka lista kontroli produktowych wykonywanych, zanim zmiana zbudowana przez agenta zostanie uznana za gotową: jaką decyzję realizuje, czy odpowiada briefowi i niczemu więcej, jak zachowuje się w pięciu sytuacjach brzegowych i jak poznasz, że zadziałała. Stoi obok przeglądu kodu, a nie w jego miejsce.
Czy product managerowie powinni recenzować kod napisany przez agentów AI?
PM-owie powinni recenzować zachowanie, nie styl kodu. Przeczytaj brief w zestawieniu z tym, co robi zmiana, przejdź przypadki brzegowe w podglądzie i sprawdź plan rezultatu. Projekt, testy i bezpieczeństwo zostaw inżynierom i narzędziom. W zespole jednoosobowym rób jedno i drugie, ale w osobnych przejściach.
Ile trwa przegląd akceptacyjny?
Dla typowej zmiany wielkości funkcji około pięciu minut, gdy twoje briefy zawierają testowalne kryteria, a ty prowadzisz stałą listę przypadków brzegowych. Pierwsze przeglądy trwają dłużej, bo ujawniają brakujące kryteria. Ten czas przechodzi na pisanie lepszych briefów zamiast znikać.
Jaka jest różnica między kryteriami akceptacji a definition of done?
Kryteria akceptacji dotyczą jednej zmiany: co ma robić ta funkcja. Definition of done dotyczy każdej zmiany: kod przejrzany, testy przechodzą, kontrole bezpieczeństwa uruchomione, kontrola rezultatu zaplanowana. Atlassian zauważa, że oba terminy bywają używane zamiennie, ale ich rozdzielenie ułatwia przeglądy pracy agentów.
Dlaczego agenci AI dodają funkcje, o które nikt nie prosił?
Agenci wypełniają luki w briefie prawdopodobnym zachowaniem, a dodatki takie jak przyciski cofania, filtry czy ustawienia są prawdopodobne. Niektóre są przydatne. Problem w tym, że każdy z nich to niezrecenzowany zakres. Przejście nadwyżek na stopniu drugim zmusza cię, by każdy dodatek świadomie zachować lub wyciąć oraz dodać kryterium dla wszystkiego, co zostaje.
Czy agent AI może sprawdzić własną pracę względem kryteriów akceptacji?
Częściowo. Agenci mogą uruchamiać testy i porównywać zachowanie z pisemnymi kryteriami, a narzędzia walidujące plan przed kodowaniem wychwytują błędy wcześnie. Ale agenci płynnie opisują własną pracę, a płynność nie jest dowodem. Stopień pierwszy (czy to właściwa decyzja?) i stopień czwarty (czy pomogło użytkownikom?) nadal wykonuje człowiek.
GDPR-aligned. EU workspace data is stored in Frankfurt, Germany. GDPR and EU data Built in Vienna, Austria. A product of influence solutions fm GmbH (FN 675374y). Imprint 14-day trial. Card required, and nothing is charged until day 14. 30-day refund after subscribing. See pricing