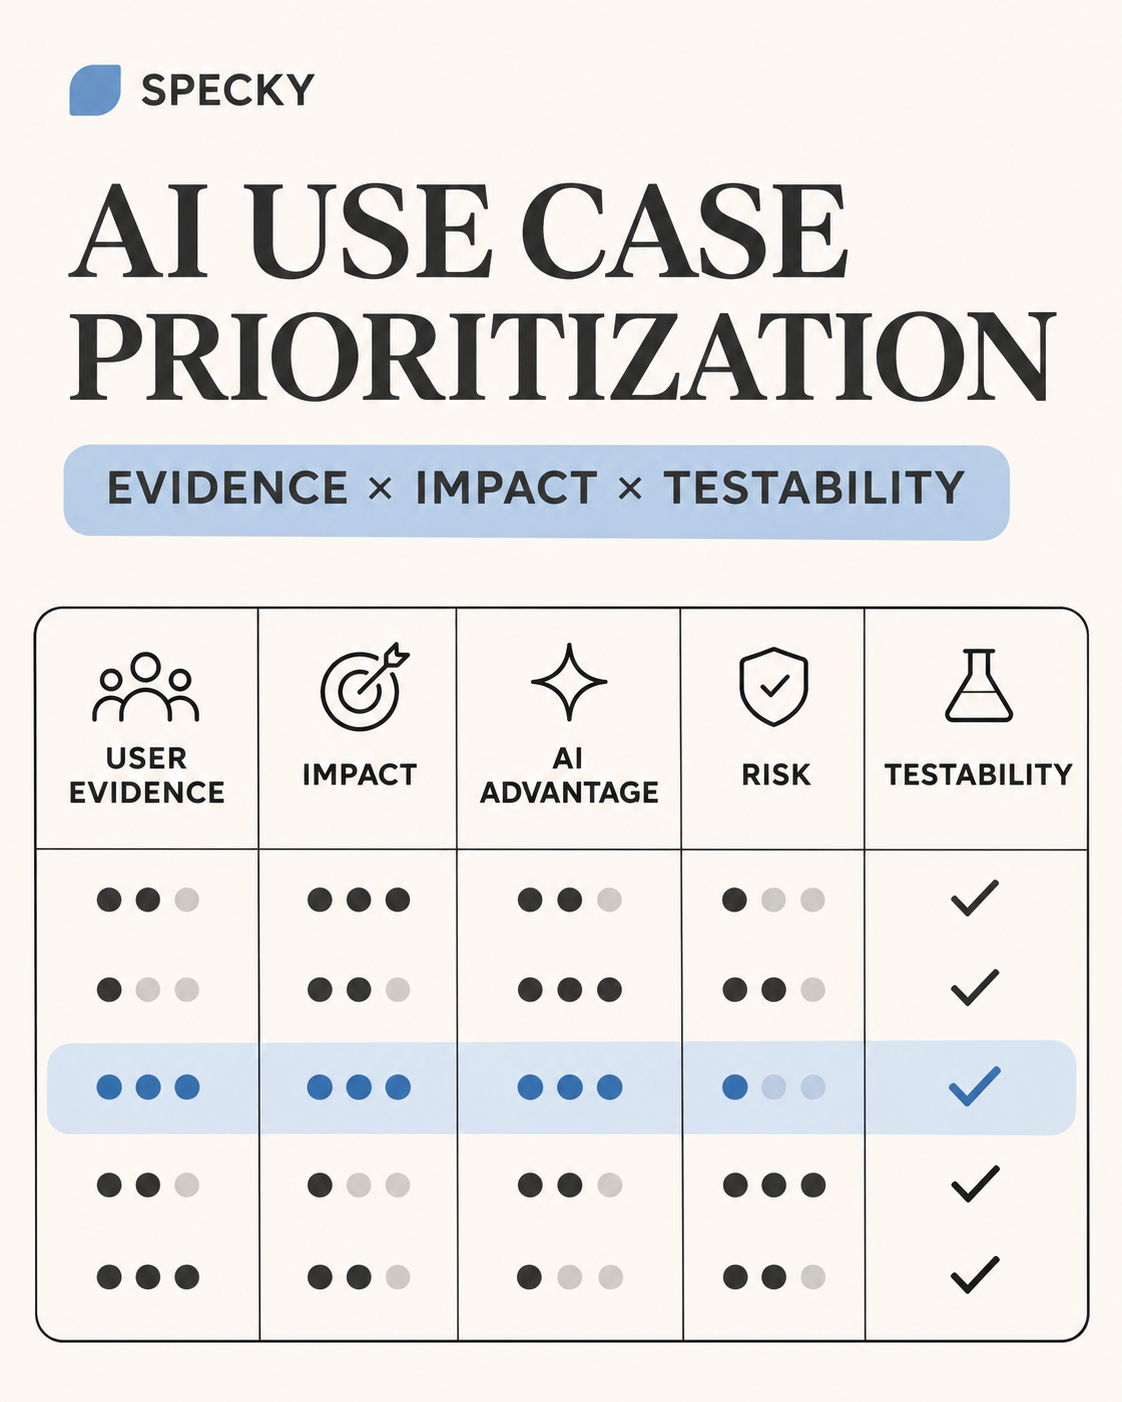
كيف تحدد أولويات حالات استخدام الذكاء الاصطناعي: بطاقة تقييم لفرق المنتج
قارن أفكار المنتجات المعتمدة على الذكاء الاصطناعي ببطاقة تقييم مرجّحة تشمل أدلة المستخدمين والأثر وميزة الذكاء الاصطناعي والقدرة على التقييم والتحكم في الأخطاء والوقت اللازم للتعلّم. اختر ما ستختبره بعد ذلك، لا ما ستطلقه.
لكي تحدد أولويات حالات استخدام الذكاء الاصطناعي، قارن بين مشكلات المستخدمين بدلًا من ميزات الذكاء الاصطناعي، ثم اختر أيّها ستختبره أولًا. قيّم كل مرشّح بحسب قوة الأدلة على المشكلة، والنتيجة المتوقعة للمستخدم، وميزة الذكاء الاصطناعي مقارنةً بخيار أبسط، وقابلية التقييم، والتحكم في الأخطاء، والوقت اللازم للتعلّم. طبّق ثلاث بوابات جاهزية قبل التقييم، وتعامل مع النتيجة بوصفها وسيلة لكشف المفاضلات، لا توقعًا للمستقبل.
هذا قرار مختلف عن السؤال عمّا إذا كان ينبغي لميزة واحدة أن تستخدم الذكاء الاصطناعي. يساعد اختبار الأسئلة الأربعة لملاءمة الذكاء الاصطناعي على تقييم ميزة واحدة. أما بطاقة التقييم هذه فتساعد المؤسس أو أول موظف منتج أو مدير المنتج (PM) أو مهندس المنتج (product engineer) على أن يقرر أيّ مرشّح من بين عدة مرشحين يستحق الاهتمام المحدود للفريق.
أهم النقاط
تتعثر معظم مبادرات الذكاء الاصطناعي قبل أن تؤتي ثمارها. فقد وجد استطلاع BCG الذي شمل 1,000 مسؤول تنفيذي في 59 دولة أن 74% من الشركات لم تُظهر بعدُ قيمة ملموسة من الذكاء الاصطناعي، وأن 26% فقط تمكنت من تجاوز مرحلة إثبات المفهوم (BCG، 2024).
وجدت دراسة MIT NANDA لعام 2025، المبنية على 150 مقابلة و300 عملية نشر علنية، أن نحو 5% فقط من التجارب التجريبية للذكاء الاصطناعي حققت تسارعًا سريعًا في الإيرادات (Fortune، 2025).
نادرًا ما يكون النموذج هو العائق. فقد خصّصت الشركات الرائدة في دراسة BCG 10% من مواردها للخوارزميات، و20% للتقنية والبيانات، و70% للأشخاص والعمليات.
يذكر دليل PAIR Guidebook من Google حالات لا يكون فيها الذكاء الاصطناعي أفضل على الأرجح، منها الحفاظ على إمكانية التنبؤ وتقليل الأخطاء المكلفة إلى الحد الأدنى (Google PAIR).
امنح أدلة المشكلة ونتيجة المستخدم أعلى وزن. في بطاقة التقييم أدناه يشكّلان معًا 55% من المجموع.
لماذا تفشل حالات استخدام كثيرة للذكاء الاصطناعي؟
تختار الفرق مشاريع الذكاء الاصطناعي عادةً كما تختار العروض التجريبية: بحسب ما يبدو مبهرًا في النموذج الأولي. أما بيانات الفشل فتشير إلى اتجاه آخر.
الفجوة في القيمة، لا في القدرة. وجدت BCG أن 4% فقط من الشركات امتلكت أكثر قدرات الذكاء الاصطناعي تقدمًا في جميع الوظائف، وأن الشركات الرائدة وجّهت معظم جهدها إلى الأشخاص والعمليات، لا إلى الخوارزميات ().
سير العمل هو الذي يحدد النتائج. أرجع تقرير MIT NANDA الفشل إلى «فجوة تعلّم» في الأدوات والمؤسسات لا إلى جودة النماذج، ووجد أن الأدوات المشتراة من موردين متخصصين نجحت في نحو 67% من الحالات، بينما نجحت التطويرات الداخلية بمعدل يقارب الثلث من ذلك (Fortune، 2025). اقرأ ما الذي قاسه رقم 95% فعلًا قبل أن تستشهد به.
المستخدمون يتحققون من المخرجات. في استطلاع Stack Overflow لعام 2025، لم يثق 46% من المطورين بدقة أدوات الذكاء الاصطناعي مقابل 33% وثقوا بها، وذكر 66% أن الإجابات «شبه صحيحة، لكن ليس تمامًا» هي أكبر مصدر لإحباطهم (Stack Overflow، 2025). إذا لم يستطع مستخدموك التحقق من مخرجات ما، فإما أن يتجاهلوها أو يثقوا بها حيث لا ينبغي لهم ذلك.
النمط هو هذا: اختر مشكلة مستخدم ضيقة وموثّقة بالأدلة مع طريقة مرئية لفحص الجودة، فتتصرف مشاريع الذكاء الاصطناعي كأي رهان منتج عادي. أما إذا تجاوزت هذه الخطوات فسيتحول النموذج الأولي إلى الاستراتيجية.
ابدأ بمشكلات مرشّحة، لا بميزات ذكاء اصطناعي
كثيرًا ما تخلط قائمة الأفكار بين أشياء مختلفة: مشكلات المستخدمين، والميزات المطلوبة، والتجارب، والإمكانات التقنية. وحّد شكل كل مرشّح قبل أن تقارن بينها.
لكل فكرة، دوّن ما يلي:
المستخدم والموقف: من يواجه المشكلة، ومتى؟
المهمة (job): ما الذي يحاول إنجازه؟
النهج الحالي: ماذا يفعل اليوم، بما في ذلك الحلول الالتفافية؟
الأدلة: ما الذي لوحظ مباشرة، وأين يستطيع الفريق الاطلاع عليه؟
النتيجة المرغوبة: ما الذي سيكون أفضل للمستخدم؟
مساهمة الذكاء الاصطناعي: أي جزء من المهمة قد يستفيد من اللغة أو التلخيص والتركيب أو التكيّف؟
كلفة الفشل: ما الذي قد يسوء، ومن سيلاحظ ذلك؟
الاختبار الأول: ما أصغر تجربة تستطيع الإجابة عن سؤال ذي معنى؟
«إضافة مساعد ذكاء اصطناعي لخارطة الطريق» ليست جاهزة للمقارنة. أما «أول موظف منتج يقضي يوم الجمعة في جمع طلبات الدعم وملاحظات المقابلات قبل أن يقرر ما سيبحثه» فهي مرشّحة أفضل: فهي تسمّي مستخدمًا ومهمة وأدلة يستطيع الفريق البحث عنها.
لا تعامل طلب أحد أصحاب المصلحة، أو تصويتًا بالإعجاب، أو نموذجًا أوليًا مقنعًا كدليل على أن المشكلة شائعة. أبقِ المصدر الأصلي مرفقًا ودوّن ما لا يثبته. يعرض حلقة اكتشاف المنتج بالذكاء الاصطناعي طريقة على مدى أسبوعين لجمع هذه الإشارات ومراجعتها.
ما بوابات الجاهزية التي ينبغي أن تجتازها حالة استخدام الذكاء الاصطناعي أولًا؟
لا ينبغي أن تخفي الدرجة المرتفعة سببًا جوهريًا للانتظار. قبل ترتيب الأفكار، تحقق من ثلاث بوابات:
مشكلة المستخدم محددة بما يكفي لتُبحث. تستطيع تسمية مستخدم ووصف موقف حديث وتحديد مصدر واحد على الأقل أو خطوة اكتشاف واضحة.
يمكن ملاحظة نتيجة مفيدة. يستطيع الفريق أن يقول ما الذي ينبغي أن يتحسن وأي حاجز وقائي يجب ألا يسوء.
للفشل المكلف ضابط مرئي. يستطيع الفريق اكتشاف الفشل المعني أو مراجعته أو الحد منه أو التراجع عنه قبل توسيع الميزة.
إذا أخفقت فكرة في إحدى البوابات، فدوّن الدليل أو عمل التصميم الناقص. يمكنها البقاء في القائمة، لكن لا ينبغي أن تفوز لمجرد أن النموذج الأولي سهل البناء.
كيف تقيّم حالات استخدام الذكاء الاصطناعي وتقارن بينها؟
استخدم درجة من 1 إلى 5 لكل بُعد. الأوزان أدناه نقطة انطلاق للنقاش، وليست معادلة أثبتتها الأبحاث. غيّرها إذا اقتضت استراتيجية فريقك أو ملف المخاطر لديه ذلك. احتفظ بالمبرر المكتوب بجانب كل درجة.
البُعد
الوزن
1 – ضعيف
3 – متفاوت
5 – قوي
أدلة المشكلة
30%
افتراض في الغالب
إشارة واحدة موثوقة، والنمط غير واضح
أدلة متكررة يمكن فحصها من المستخدمين المستهدفين
نتيجة المستخدم
25%
الفائدة غامضة أو داخلية
فائدة محتملة للمستخدم مع ثغرات
مهمة أو نتيجة محددة يُتوقع أن تتحسن
ميزة الذكاء الاصطناعي
15%
قاعدة أو بحث عادي قد يؤدي الغرض بالقدر نفسه
قد يساعد الذكاء الاصطناعي في جزء واحد
يعالج الذكاء الاصطناعي تباينًا حقيقيًا أو لغة أو تركيبًا بين المصادر
القدرة على التقييم
15%
لا أمثلة ولا معايير مراجعة
بعض الأمثلة وتبقى ثغرات مهمة
تتوافر حالات تمثيلية وفحوص جودة قابلة للملاحظة
التحكم في الأخطاء
10%
قد تمر الأخطاء بصمت أو يصعب التراجع عنها
توجد مراجعة أو بديل احتياطي ما
الأخطاء مرئية ومحصورة ويمكن تداركها أثناء الاختبار
الوقت اللازم للتعلّم
5%
يحتاج الاختبار إلى تكامل واسع أو التزام طويل
تجربة تجريبية ممكنة مع بعض الاعتمادات
اختبار صغير قابل للتراجع يستطيع الإجابة عن السؤال التالي
احسب الدرجة المرجّحة بقسمة الدرجة على 5 ثم ضربها في الوزن، ثم اجمع النتائج الست. الحد الأقصى 100. استخدم الرقم لتنظيم النقاش، لا للإيحاء بأن فكرة درجتها 4.1 أفضل موضوعيًا من فكرة درجتها 3.9. أما الخطر الجسيم أو بوابة الجاهزية التي لم تُجتز فما زالا يتطلبان قرارًا مباشرًا.
مثال: مقارنة ثلاثة مسارات عمل محتملة بالذكاء الاصطناعي
المثال أدناه افتراضي. إنه يوضح كيف يمكن لفريق صغير أن يقارن الأفكار؛ وليس نتيجة عميل من Specky ولا بحث سوق.
المرشّح
الأدلة التي ينبغي فحصها
أكبر عدم يقين
اختبار أول معقول
تجميع ملاحظات مقابلات العملاء في موضوعات
مقابلات حديثة والوقت الحالي المستغرق في التلخيص والتركيب
هل تحافظ الموضوعات المقترحة على الاختلافات وعلى سياق المصدر
اطلب من المراجعين ربط كل موضوع بالمقتطفات الأصلية والإشارة إلى الأمثلة المضادة الناقصة
صياغة موجز منتج من أدلة العملاء
أمثلة على الموجزات والمستندات المصدرية وخطوات إعادة الكتابة
هل توفّر المسودة جهد المراجعة دون أن تضيف ادعاءات غير مدعومة
اشترط روابط مصادر للادعاءات الواقعية واجعل PM أو مهندس منتج يراجع المسودة
ترتيب طلبات خارطة الطريق تلقائيًا
مصادر الطلبات وسجل القرارات وكيفية تحديد الأولويات حاليًا
هل يخفي الترتيب سياقًا ناقصًا أو يُظنّ أنه قرار
اعرض الأدلة والمفاضلات أولًا؛ وأبقِ قرار تحديد الأولويات بيد شخص
والآن لنقيّمها. الأرقام هنا أيضًا توضيحية فقط:
البُعد (الوزن)
تجميع ملاحظات المقابلات
صياغة موجز المنتج
ترتيب خارطة الطريق تلقائيًا
أدلة المشكلة (30%)
4 → 24
3 → 18
2 → 12
نتيجة المستخدم (25%)
4 → 20
4 → 20
2 → 10
ميزة الذكاء الاصطناعي (15%)
5 → 15
4 → 12
3 → 9
القدرة على التقييم (15%)
3 → 9
3 → 9
1 → 3
التحكم في الأخطاء (10%)
4 → 8
3 → 6
1 → 2
الوقت اللازم للتعلّم (5%)
5 → 5
4 → 4
2 → 2
الدرجة المرجّحة (من 100)
81
69
38
بوابات الجاهزية
اجتازت
اجتازت
أخفقت في البوابة 3
تتقدم فكرة تجميع المقابلات بفارق 12 نقطة ولها أرخص اختبار، لذا تأتي أولًا. وصياغة الموجزات تجربة تجريبية ثانية معقولة بعد أن تُنتج الأولى معايير مراجعة يمكن للفريق إعادة استخدامها. أما فكرة الترتيب التلقائي فتخفق في بوابة التحكم في الأخطاء: القائمة المرتبة تبدو موثوقة، وقد تقود قائمة خاطئة خارطة الطريق بصمت. تبقى في القائمة مع ملاحظة عمّا ينبغي أن يتغير.
كيف تختلف بطاقة تقييم حالات استخدام الذكاء الاصطناعي عن RICE؟
بطاقة تقييم حالات استخدام الذكاء الاصطناعي
RICE
القيمة مقابل الجهد
الوحدة المقارَنة
مشكلات المستخدمين التي لها بعد ذكاء اصطناعي
ميزات أو مشاريع
ميزات أو مشاريع
التقييم ومخاطر الفشل
تُقيَّم صراحةً (25% مجتمعة)
مدمجة في Confidence
غير مشمولة
تسأل «هل تكفي أداة أبسط؟»
نعم، عبر ميزة الذكاء الاصطناعي
لا
لا
المخرجات
أي اختبار يُجرى أولًا
ترتيب البناء
شبكة تقريبية
الأنسب لـ
الاختيار بين أفكار الذكاء الاصطناعي
ترتيب backlog مُقيَّم
فرز سريع
يبقى لـ RICE مكانه حين تثبت ميزة الذكاء الاصطناعي نفسها وتنضم إلى backlog المعتاد. لهذه المرحلة راجع RICE scoring مع الذكاء الاصطناعي.
متى يكون الذكاء الاصطناعي الأداة الخطأ لحالة استخدام؟
عبارة «الذكاء الاصطناعي يجعل هذا أذكى» ليست مبررًا مفيدًا للدرجة. سمِّ العمل المحدد الذي قد يساعد فيه النموذج، ثم قارنه بأبسط خط أساس مفيد:
هل تتضمن المهمة لغة متنوعة أو أدلة غير منظمة؟
هل يهمّ التلخيص والتركيب عبر مصادر متعددة؟
هل يستطيع المستخدم التحقق من المخرجات بمقارنتها بتلك المصادر؟
هل كان بحث أو قاعدة أو مرشّح أو مسار عمل قصير سيحل المشكلة نفسها؟
ما الكلفة والتأخير والمراجعة والصيانة التي تضيفها نسخة الذكاء الاصطناعي؟
يُعد People + AI Guidebook من Google مرجعًا مفيدًا لتأسيس تصميم الذكاء الاصطناعي على احتياجات المستخدمين. وهو يذكر حالات يكون فيها الذكاء الاصطناعي أفضل على الأرجح، مثل التخصيص والتنبؤ وفهم اللغة الطبيعية، وحالات لا يكون كذلك فيها على الأرجح، مثل الحفاظ على إمكانية التنبؤ، وتقليل الأخطاء المكلفة، وتوفير شفافية كاملة، والتحسين لسرعة عالية وكلفة منخفضة. لكنه لا يثبت صحة الأوزان في بطاقة التقييم هذه. ولتقرير ما إذا كانت ميزة مقترحة واحدة تحتاج إلى نموذج أصلًا، استخدم اختبار ملاءمة الذكاء الاصطناعي.
كيف تصمم الاختبار الأول لحالة استخدام الذكاء الاصطناعي؟
لا تجرِّب فكرة كاملة من خارطة الطريق حين يستطيع اختبار ضيق الإجابة عن السؤال التالي. اختر الاختبار بحسب أقل ما هو معروف:
عدم اليقين بشأن المشكلة: لاحظ مسار العمل الحالي أو أجرِ مقابلات مع أشخاص حول حالة حديثة وملموسة.
عدم اليقين بشأن ملاءمة الذكاء الاصطناعي: قارن النموذج بقاعدة أو بحث أو العملية اليدوية الحالية على أمثلة تمثيلية.
عدم اليقين بشأن الثقة: دع المستخدمين المستهدفين يفحصون النتيجة أو يصححونها أو يرفضونها أو يتراجعون عنها.
عدم اليقين بشأن النتيجة: اختر مقياسًا مرتبطًا بمهمة المستخدم، إضافة إلى حاجز وقائي للجودة أو الأخطاء أو الكلفة أو الوقت.
دوّن شروط المواصلة والتوقف قبل أن تنظر في النتائج. مثلًا، واصل فقط إذا استطاع الناس التحقق من المخرجات، واجتيزت فحوص الجودة المتفق عليها، وحسّن الاختبار المهمة دون أن يخلق عبء مراجعة غير مقبول. حدّد الحدود الفعلية مع الفريق بناءً على العواقب وخط الأساس؛ فلا توجد درجة نجاح عالمية.
يُنظّم NIST AI Risk Management Framework، الذي صدر في 26 يناير 2023 والمخصص للاستخدام الطوعي، عمل المخاطر في Govern وMap وMeasure وManage. وأضاف NIST ملفًا للذكاء الاصطناعي التوليدي (NIST-AI-600-1) في 26 يوليو 2024. استخدمهما كمحفزات لأسئلة خاصة بمنتجك، لا كشهادة اعتماد ولا كبديل عن مراجعة خبراء المجال.
بطاقة تقييم قابلة للنسخ لتحديد أولويات حالات استخدام الذكاء الاصطناعي
المرشّح:
المستخدم والموقف:
Job to be done:
النهج الحالي أو الحل الالتفافي:

الأدلة وروابط المصادر:
ما تُظهره الأدلة:
ما لا تُظهره:

نتيجة المستخدم المرغوبة:
مساهمة الذكاء الاصطناعي:
أبسط خط أساس مفيد:

أدلة المشكلة (1–5):             x 30% / 5 =
نتيجة المستخدم (1–5):           x 25% / 5 =
ميزة الذكاء الاصطناعي (1–5):    x 15% / 5 =
القدرة على التقييم (1–5):       x 15% / 5 =
التحكم في الأخطاء (1–5):        x 10% / 5 =
الوقت اللازم للتعلّم (1–5):     x  5% / 5 =
الدرجة المرجّحة (من 100):
سبب كل درجة:

بوابات الجاهزية:
[ ] مشكلة مستخدم محددة وأدلة
[ ] نتيجة قابلة للملاحظة وحاجز وقائي
[ ] الفشل قابل للاكتشاف أو محصور أو قابل للتراجع

هل نبني أم نشتري أم نضبط أداة موجودة؟:
أصغر اختبار مفيد:
المسؤول:
نواصل إذا:
نتوقف أو نعيد التصميم إذا:
تاريخ المراجعة:
أبقِ روابط الأدلة الأصلية مع بطاقة التقييم. وإذا تغيّرت درجة، فدوّن المعلومة الجديدة التي غيّرتها. يستطيع سجل قرارات المنتج الخفيف أن يحفظ المبرر والشروط اللازمة لإعادة النظر في الاختيار.
أخطاء شائعة عند تحديد أولويات حالات استخدام الذكاء الاصطناعي
الترتيب بحسب جودة العرض التجريبي. نموذج أولي يعمل على خمسة مدخلات مختارة يدويًا يخبرنا بالقليل عن المدخل المئة الحقيقي.
تجاوز خط الأساس. إذا كان مرشّح أو بحث محفوظ يحل 80% من المشكلة، فعلى نسخة الذكاء الاصطناعي أن تتفوق على ذلك، لا أن تتفوق على لا شيء.
تشغيل خمس تجارب تجريبية معًا. لا يستطيع فريق صغير تقييمها بالتوازي، ويُنسب جهد المراجعة إلى مسار العمل الخطأ.
بناء ما يمكنك شراؤه. تشير بيانات MIT NANDA إلى أن الأدوات المتخصصة المشتراة تنجح أكثر من التطويرات الداخلية. أضف «الشراء أو الضبط» كخيار قبل أن تقيّم.
غياب سياسة مكتوبة. في استطلاع Productboard لعام 2025، قال 65% من 379 من محترفي المنتج في المؤسسات الكبيرة إن شركاتهم لديها سياسة موثّقة للذكاء الاصطناعي، أي إن نحو الثلث لم يكن لديه (Productboard، 2025). قرّر ما البيانات التي يجوز للتجربة التجريبية لمسها قبل أن تبدأ.
كيف يستفيد مهندسو المنتج والبنّاؤون من بطاقة التقييم
كثيرًا ما يرى مهندسو المنتج والمؤسسون التقنيون طريقًا للتنفيذ قبل أن يقارن الفريق المشكلات الكامنة. استخدم هذه السرعة لجعل الاختبار أرخص، لا لتجاوز أدلة المشكلة. يستطيع المهندسون تحديد قيود الوصول إلى البيانات والتكامل، وإعداد أمثلة تمثيلية، وجعل النموذج الأولي قابلًا للتراجع. ويستطيع بنّاؤو المنتج (product builders) المساعدة في كشف الافتراضات في المواصفات وتوضيح مسار المراجعة.
أبقِ حكم المنتج بيد الفريق. يمكن للذكاء الاصطناعي تنظيم أدلة المرشّحين أو صياغة خيارات؛ لكن لا ينبغي له أن يحوّل الدرجة بصمت إلى التزام في خارطة الطريق. لمسار اكتشاف ذي صلة يقوده المهندسون، راجع اكتشاف العملاء لمهندسي المنتج. ولنقل فكرة مختارة إلى مسودة متطلبات، استخدم مولّد PRD المجاني بالذكاء الاصطناعي وأبقِ الأدلة المصدرية مرفقة.
الأسئلة الشائعة
ما المقصود بتحديد أولويات حالات استخدام الذكاء الاصطناعي؟
تحديد أولويات حالات استخدام الذكاء الاصطناعي يقارن بين مشكلات المستخدمين ومسارات العمل المرشّحة ليقرر أيّها يُبحث أو يُختبر أولًا. تشمل المقارنة المفيدة أدلة المستخدمين والنتيجة المتوقعة والميزة المحددة للذكاء الاصطناعي والقدرة على التقييم وضوابط الفشل. وتنتهي باختبار مختار وشروط توقف، لا بالتزام في خارطة الطريق.
كيف تحدد أولويات ميزات الذكاء الاصطناعي؟
ابدأ بمشكلة المستخدم والحل الالتفافي الحالي. طبّق بوابات الجاهزية، وقارن المرشّحين بمعايير متسقة، وأجرِ اختبارًا صغيرًا على الفكرة الأعلى أولوية التي يمكن التحكم في مخاطرها. أبقِ الدرجة والمبرر ظاهرين حتى تستطيع الأدلة الجديدة تغيير القرار.
هل ينبغي لفريق صغير بناء عدة ميزات ذكاء اصطناعي في وقت واحد؟
عادةً اختبر عددًا أقل من الأفكار في الوقت نفسه حين لا يستطيع الفريق تقييمها بالتوازي. تجعل التجربة الضيقة من الأسهل نسبة جهد المراجعة ومشكلات الجودة ونتائج المستخدمين إلى مسار عمل بعينه. اختر النطاق بحسب الأدلة المتاحة والقدرة.
ماذا لو كانت لحالتي استخدام درجات متقاربة؟
قارن عدم اليقين الذي سيقلّصه كل اختبار، والضرر إذا فشل مسار العمل، وما إذا كانت الفكرتان تعتمدان على البيانات نفسها أو التكامل نفسه. وإذا ظلت الأدلة متعادلة، فنفّذ خطوة اكتشاف أو اختبارًا صغيرًا قابلًا للتراجع بدلًا من اختلاق دقة في التقييم.
هل تتنبأ درجة حالة استخدام الذكاء الاصطناعي بنجاح المنتج؟
لا. الدرجة ملخص منظّم للأدلة والافتراضات الحالية. وهي لا تتنبأ بالتبنّي ولا بالإيرادات ولا بملاءمة المنتج للسوق (product-market fit). تحقق من مشكلة المستخدم وقِس ما يحدث في مسار عمل حقيقي.
لماذا نمنح أدلة المشكلة وزنًا أعلى من ميزة الذكاء الاصطناعي؟
لأن بيانات الفشل تشير إلى المشكلات ومسارات العمل لا إلى النماذج. فقد وجّهت الشركات الرائدة في دراسة BCG نسبة 70% من مواردها للذكاء الاصطناعي إلى الأشخاص والعمليات و10% فقط إلى الخوارزميات. والنموذج القوي المطبَّق على مشكلة غير مثبتة يفشل مع ذلك، في حين يستطيع نموذج متواضع على مهمة موثّقة جيدًا وقابلة للتحقق أن يقدم قيمة بسرعة.
اختر اختبارًا، ثم حدّث القرار بالأدلة
العملية المفيدة لتحديد أولويات حالات استخدام الذكاء الاصطناعي تجعل الاختيار وعدم اليقين فيه أسهل رؤية. قارن بين المشكلات المرشّحة، وبيّن لماذا يأتي اختبار واحد أولًا، ودوّن ما قد يغيّر القرار. الهدف أن تتعلم أي مسار عمل يصنع فائدة حقيقية للمستخدم، لا أن تضع الذكاء الاصطناعي في خارطة الطريق افتراضيًا.
GDPR-aligned. EU workspace data is stored in Frankfurt, Germany. GDPR and EU data Built in Vienna, Austria. A product of influence solutions fm GmbH (FN 675374y). Imprint 14-day trial. Card required, and nothing is charged until day 14. 30-day refund after subscribing. See pricing