10 de octubre de 2026Actualizado el Fathy Shalaby15 min de lectura
Checklist de aceptación para código generado por IA: guía de revisión para PMs
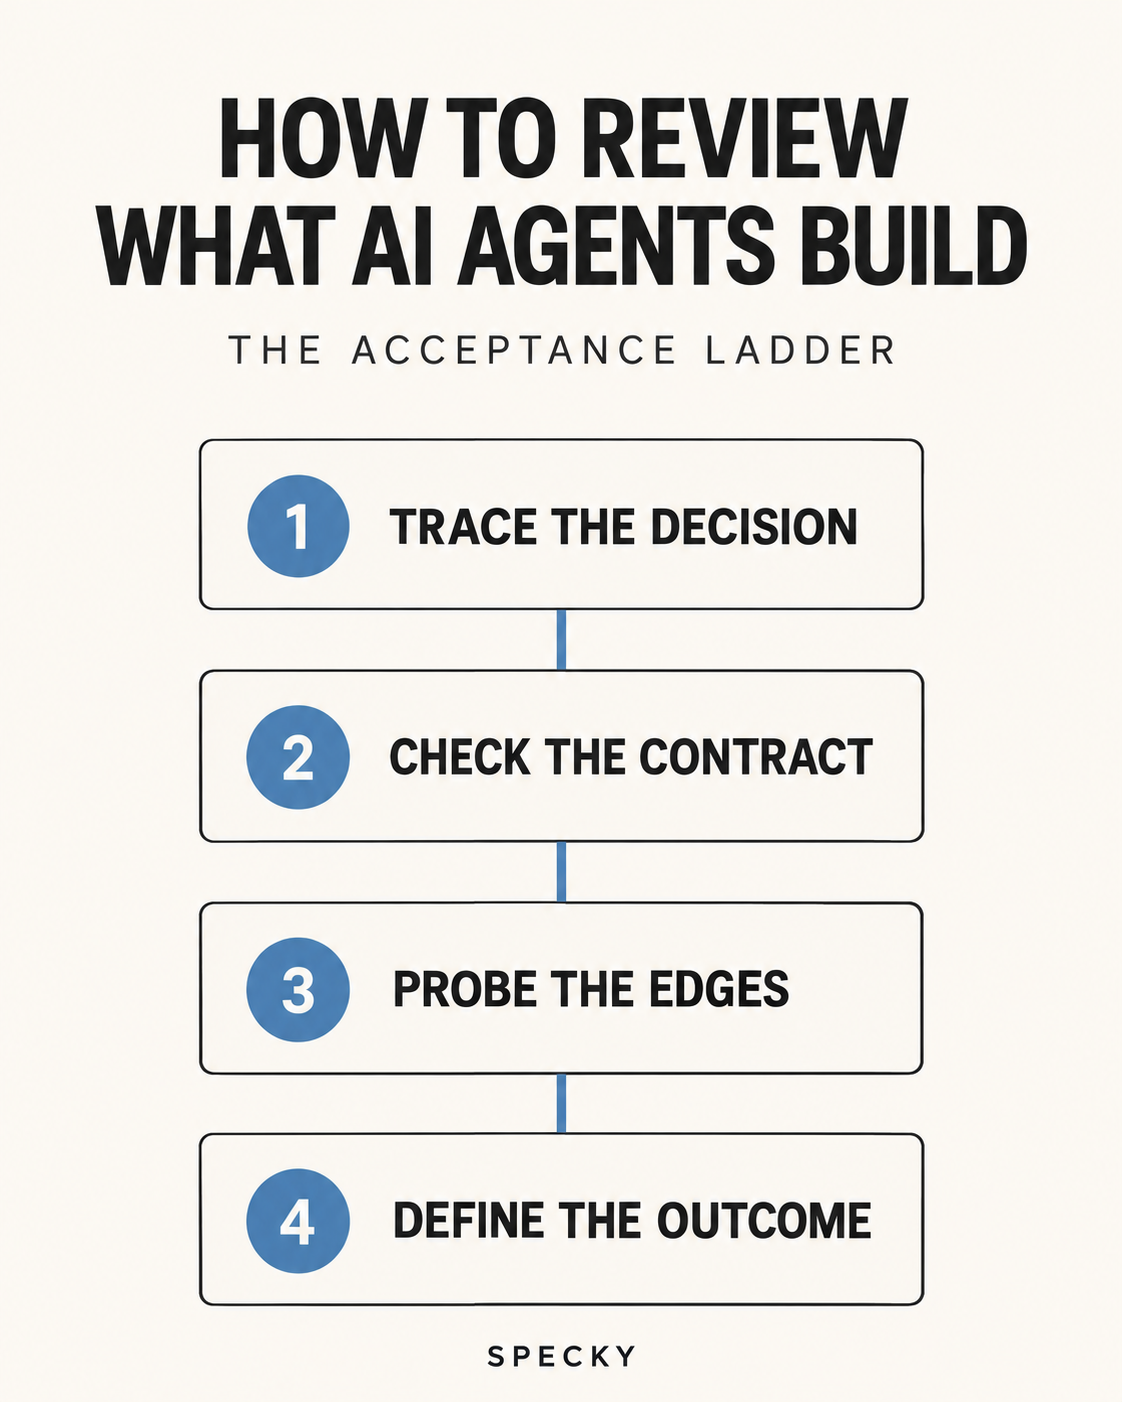
Construir se abarató; aceptar el resultado, no. La Acceptance Ladder, de cuatro peldaños, ayuda a los PM a revisar los cambios hechos por agentes frente a la decisión, el brief, los casos límite y el resultado.
Una checklist de aceptación para código generado por IA es la lista corta de comprobaciones que un product manager hace antes de que un cambio hecho por un agente se dé por terminado. Los ingenieros revisan cómo está escrito el código; el PM comprueba si es el cambio correcto. Usamos cuatro peldaños, en orden: rastrearlo hasta una decisión, compararlo con el brief, probar los casos límite y definir cómo sabrás que funcionó.
Ideas clave
Anthropic describe el desarrollo de software como un cambio «de escribir código a orquestar agentes que escriben código» (Anthropic, 2026). La habilidad escasa se traslada al asiento del revisor.
El 66 % de los desarrolladores dice que su mayor frustración con las herramientas de IA son las soluciones casi correctas, pero no del todo (Stack Overflow, 2025). Los cambios casi correctos pasan una revisión de «se ve bien».
Un resultado fluido distorsiona el criterio: en un ensayo aleatorizado, los desarrolladores creían que la IA los había hecho un 20 % más rápidos cuando los había hecho un 19 % más lentos (METR, 2025).
Los agentes tienden a construir de más. La pasada de excedente (listar el comportamiento que nadie pidió) es la comprobación que la mayoría de los equipos se salta.
La checklist no sustituye la revisión de código ni la de seguridad: el 45 % de las muestras de código generado por IA en una prueba de 2025 introdujo vulnerabilidades conocidas (Veracode, 2025).
¿Por qué «se ve bien» es el listón equivocado para el código generado por IA?
La mayoría de los equipos revisa lo que produce un agente como revisaba una pull request humana: ojear el diff, hacer clic por la vista previa, aprobar. Eso funciona cuando un compañero lleva el contexto de la reunión de planificación y de las llamadas con clientes. Falla cuando un agente solo lleva lo que el brief codificó.
Si el brief era vago, el agente rellena el hueco con el comportamiento estadísticamente más plausible, y plausible no es lo mismo que correcto. El cambio compila, la vista previa se renderiza, el camino feliz funciona y el PM aprueba. Dos semanas después alguien nota que descartó en silencio una restricción que nadie escribió, o que resolvió un problema cercano en lugar del que decía el brief. No había nada malo en el código. Simplemente, el paso de aceptación nunca hizo las preguntas correctas.
Tres cosas hacen que el resultado de un agente sea más difícil de juzgar que el de una persona:
Volumen. Generar es barato, así que hay más cambios candidatos por semana y el tiempo de revisión se convierte en el cuello de botella.
Confianza. Los agentes describen su propio trabajo con soltura. Un resumen ordenado no es evidencia. El ensayo de METR de 2025 con 16 desarrolladores experimentados y 246 issues reales encontró que los desarrolladores esperaban que la IA los acelerara un 24 % y, tras el trabajo, seguían creyendo que los había acelerado un 20 %, mientras que el resultado medido fue un 19 % más lento (METR, 2025). METR dice ahora que esos resultados de principios de 2025 están desactualizados, y su seguimiento de febrero de 2026 encontró pequeñas aceleraciones estimadas que califica de señal poco fiable (METR, 2026). La lección duradera es la brecha de percepción, no la cifra de velocidad.
Falta de rastro de la intención. Sin un enlace del cambio a la decisión que implementa, no puedes distinguir «construido como se especificó» de «construido como se infirió».
Los datos de entrega apuntan en la misma dirección. La investigación DORA 2024 de Google encontró que un aumento del 25 % en la adopción de IA se asociaba con una calidad de la documentación un 7,5 % mejor, una calidad del código un 3,4 % mejor y una revisión de código un 3,1 % más rápida. Sin embargo, a medida que subía la adopción, los investigadores también estimaron una caída del 1,5 % en el rendimiento de entrega y del 7,2 % en su estabilidad (DORA, 2024). El informe de 2025 lo resume: la IA amplifica las fortalezas y debilidades que una organización ya tiene (DORA, 2025). Un paso de aceptación débil es una de las debilidades que amplifica.
¿Qué debe comprobar un PM y qué debe comprobar un ingeniero?
Divide la revisión. Las prácticas de ingeniería de Google enumeran qué busca un revisor de código: diseño, funcionalidad, complejidad, tests, nombres, comentarios, estilo, consistencia, documentación y contexto (Google). Casi todo es trabajo de ingeniería. Una pregunta de la lista pertenece a producto: «Is what the developer intended good for the users of this code?»
Pregunta
Quién la responde
Dónde se responde
¿Está el código bien diseñado, es legible y está probado?
Ingeniero
Revisión de código
¿Es seguro y gestiona bien los permisos?
Ingeniero (con herramientas de seguridad)
Revisión de código, escáneres
¿Qué decisión o evidencia implementa este cambio?
PM
Acceptance Ladder, peldaño 1
¿Construyó lo que decía el brief, y solo eso?
PM
Peldaño 2
¿Se comporta de forma defendible en los casos vacío, error, límite, permiso y repetición?
PM e ingeniero juntos
Peldaño 3
¿Cómo y cuándo sabremos que funcionó para los usuarios?
PM
Peldaño 4
En un equipo de fundador en solitario, una persona lleva los dos sombreros. Haz las dos revisiones en pasadas separadas de todos modos: leer código para ver si es correcto y leer comportamiento para ver si responde a la intención exigen atenciones distintas.
La Acceptance Ladder: cuatro comprobaciones antes de dar por terminado un cambio hecho por un agente
Cada peldaño plantea una pregunta. Solo subes al siguiente cuando el actual se supera. Si un cambio se atasca en el primer peldaño, no pierdes tiempo con el cuarto.
Peldaño 1: Trazabilidad. ¿Qué decisión está implementando?
Antes de leer nada de código, responde una pregunta: ¿a qué decisión o evidencia se remonta este cambio?
Un cambio debería apuntar a un elemento concreto: un registro de decisión, un insight de cliente, una oportunidad, un experimento. Si no puedes nombrarlo en una frase, detente. O el trabajo nunca estuvo justificado, o la justificación vive en la cabeza de alguien y el agente nunca la vio.
En Specky, para esto sirve el Product Graph. Decisiones, insights y tickets son nodos enlazados, de modo que una ejecución del agente puede reunir el contexto circundante antes de planificar nada. La primera comprobación del revisor es simplemente si ese enlace existe y si la evidencia citada dice lo que el cambio afirma que dice.
Si el propio brief salió de un borrador de IA, comprueba su evidencia antes de comprobar el código frente a él. Nuestro Claim Trace para specs escritas por IA lleva unos 15 minutos.
Condición de superación: una decisión o insight, con nombre, y con su evidencia accesible en dos clics.
Peldaño 2: Contrato. ¿Construyó lo que decía el brief, y solo eso?
Ahora compara el cambio con el brief escrito, línea por línea. No «¿me parece bien?», sino un diff literal entre los criterios de aceptación y el comportamiento observado.
Haz dos pasadas:
Pasada de cobertura. Para cada criterio de aceptación del brief, encuentra el comportamiento que lo satisface. Marca cada uno como cumplido, cumplido en parte o ausente.
Pasada de excedente. Lista los comportamientos que introduce el cambio y que ningún criterio pidió. Los agentes suelen añadir extras útiles: un ajuste nuevo, una columna adicional, una ruta de respaldo. Cada uno es alcance sin revisar. Consérvalo o elimínalo a propósito.
La pasada de excedente es la que los equipos se saltan, y es donde el trabajo de un agente más se distingue del de una persona. Según nuestra experiencia, una persona tiende a construir de menos frente a un brief, y un agente tiende a construir de más.
Condición de superación: todos los criterios marcados como cumplidos, cada elemento excedente conservado o eliminado de forma explícita.
Peldaño 3: Casos límite. ¿Qué pasa cuando la entrada es incorrecta, está vacía o es hostil?
Los agentes son fuertes en el camino feliz porque eso es lo que describen los prompts. El peldaño tres va adonde los prompts rara vez llegan. Escribe cinco situaciones y prueba cada una:
Estado vacío: aún no hay datos.
Estado de error: falla la llamada ascendente.
Límite: la entrada realista más grande y la más pequeña.
Permiso: un usuario que no debería ver esto intenta verlo.
Repetición: la acción se ejecuta dos veces seguidas.
No necesitas un QA exhaustivo. Necesitas las cinco situaciones con las que se encontrará un cliente real en la primera semana. Si el brief no especificó el comportamiento para ellas, es un defecto del brief, y la corrección va al brief, no solo al código.
La comprobación de permisos importa más con el código generado por IA. Veracode probó más de 100 modelos de lenguaje en 2025 y encontró que el 45 % de las muestras de código generado no superó las pruebas de seguridad, con Java en una tasa de fallos del 72 % y el 86 % de las muestras relevantes sin defenderse del cross-site scripting (Veracode, 2025). Un PM no puede auditar eso, pero sí puede insistir en que «un usuario sin acceso intenta ver esto» sea un criterio escrito y probado, y en que las herramientas de seguridad se ejecuten en cada cambio del agente.
Condición de superación: las cinco situaciones se comportan de una forma que defenderías ante un cliente.
Peldaño 4: Evidencia del resultado. ¿Cómo sabremos que funcionó?
Un cambio puede superar los tres primeros peldaños y aun así ser inútil. El último peldaño pregunta qué vas a medir y cuándo vas a mirar.
Escribe la comprobación antes de lanzar: la métrica o señal, la dirección esperada y una fecha. «Ya veremos cómo va» no es una comprobación. Aquí también se filtra el humo: una función que sale rápido pero no tiene comprobación de resultado es una apuesta con fecha de despliegue.
Condición de superación: una señal con nombre, una dirección esperada y una fecha en el calendario para leerla.
Checklist de aceptación para código generado por IA, lista para copiar
Pégala en la plantilla de pull request o en el ticket. Un bloque por cada cambio hecho por un agente.
CHECKLIST DE ACEPTACIÓN: [cambio / enlace al PR]
Revisor: [nombre]   Fecha: [fecha]

PELDAÑO 1 TRAZABILIDAD
[ ] Decisión o insight que implementa: [enlace]
[ ] La evidencia es accesible en dos clics y dice lo que afirma el brief

PELDAÑO 2 CONTRATO
Cobertura (una línea por criterio de aceptación):
  [criterio 1]  cumplido / parcial / ausente
  [criterio 2]  cumplido / parcial / ausente
Excedente (comportamiento que ningún criterio pidió):
  [elemento]  conservar (criterio añadido) / eliminar (registrado aparte)

PELDAÑO 3 CASOS LÍMITE
[ ] Estado vacío     [ ] Estado de error    [ ] Entrada límite
[ ] Permiso          [ ] Acción repetida
Defectos del brief encontrados (añadir al brief, no solo al código): [lista]

PELDAÑO 4 RESULTADO
Señal: [métrica]   Dirección esperada: [sube/baja]   Lectura el: [fecha]

INGENIERÍA (no es decisión del PM, pero confirma que se hizo)
[ ] Revisión de código hecha   [ ] Tests añadidos/actualizados   [ ] Comprobaciones de seguridad ejecutadas

RESULTADO: aceptar / devolver con cambios en el brief
¿Cómo se ve la checklist en un cambio real?
Supón que tu equipo pidió a un agente que añadiera una acción de «archivar en bloque» a una bandeja de feedback.
Peldaño 1. El brief enlaza con un insight: el soporte pierde tiempo limpiando elementos obsoletos, y tres conversaciones con clientes lo mencionan. La evidencia es accesible. Superado.
Peldaño 2. La pasada de cobertura encuentra los cuatro criterios cumplidos. La pasada de excedente encuentra que el agente también añadió un aviso de «deshacer» y una nueva pestaña de filtro «archivados». El deshacer merece conservarse y recibe un criterio retroactivamente. La pestaña de filtro cambia la navegación y nadie la pidió, así que se elimina y se registra como una oportunidad aparte. Superado tras una edición.
Peldaño 3. El estado vacío muestra un panel en blanco sin explicación. Falla. La corrección va al brief como criterio ausente y luego vuelve al agente.
Peldaño 4. La señal es el tiempo mediano para vaciar la bandeja, que se espera que baje, y se lee en dos semanas.
La revisión supuso un fallo y dos ediciones, detectados antes del lanzamiento. Una revisión de «se ve bien» habría sacado juntos el panel en blanco y la pestaña de navegación que nadie pidió.
Rellenada en la checklist, la línea de resultado dice: 4 de 4 criterios cumplidos, 2 elementos excedentes (1 conservado, 1 eliminado), 1 de 5 casos límite fallido, lectura del resultado programada para el día 14. Devolver con un cambio en el brief.
¿Cómo escribes criterios de aceptación que un agente no pueda malinterpretar?
La Ladder solo es tan buena como los criterios del peldaño dos. Atlassian define los criterios de aceptación como las condiciones que un trabajo debe cumplir para considerarse completo, y enumera los rasgos de los buenos: claros, comprobables, centrados en el resultado y no en el método, medibles cuando sea posible e independientes entre sí (Atlassian). Para los agentes, lo más importante es que sean comprobables: un criterio que un agente no puede verificar es un criterio que va a interpretar.
Given-When-Then, desarrollado por Daniel Terhorst-North y Chris Matts como parte del behaviour-driven development, es una buena forma para esto (Fowler, 2013). Given es el estado previo, When la acción, Then el cambio esperado.
Vago (el agente adivinará)
Comprobable (el agente puede verificar)
Archivar funciona bien
Given 3 elementos seleccionados, when el usuario pulsa Archivar, then los 3 desaparecen de la lista de la bandeja en menos de 1 segundo
Gestionar los estados vacíos
Given ningún elemento en la bandeja, when carga la página, then mostrar «Nada que revisar» y un enlace a los ajustes
Solo los admins pueden archivar
Given un usuario con el rol Viewer, when abre la bandeja, then no se muestra el botón Archivar y la API devuelve 403
Hazlo rápido
Given 500 elementos, when el usuario selecciona todos y archiva, then la acción termina en menos de 3 segundos
No rompas nada
Given un elemento archivado, when el usuario abre su enlace directo, then se abre en solo lectura con una etiqueta «Archivado»
La Ladder funciona mejor cuando parte de ella no es manual. Dos movimientos prácticos:
Valida el plan antes de que el agente escriba código. Specky lo expone mediante su servidor MCP para agentes de código: un agente llama a validate_agent_plan contra tus estándares de ingeniería antes de empezar, y a validate_agent_change antes de reportar éxito. Eso adelanta el peldaño dos, de modo que el plan se comprueba frente a las reglas mientras aún es barato cambiarlo.
Mantén la evidencia adjunta. Cuando la decisión, el brief, la ejecución del agente y la comprobación del resultado son todos nodos de un mismo grafo, el peldaño uno deja de ser una búsqueda. El revisor abre el cambio y el motivo ya está a su lado.
Aplicar la Ladder en un equipo pequeño
No necesitas un comité de revisión. Para un fundador en solitario o un equipo de tres a diez personas, la Ladder es un hábito de cinco minutos por cambio, y el orden importa más que el ceremonial.
Empieza escribiendo los criterios de aceptación como frases cortas y comprobables en el propio brief, como «los elementos archivados desaparecen de la lista de la bandeja» en lugar de «archivar funciona bien». Esas frases son las que hacen que la pasada de cobertura sea mecánica y no cuestión de gustos. Después, mantén una lista fija de tus cinco situaciones límite para no reinventar el peldaño tres cada vez. Por último, haz que la comprobación del resultado forme parte de la definition of done: si el cambio no tiene señal ni fecha, no está listo para fusionarse.
Cuando un cambio falle en un peldaño, resiste la tentación de parchearlo en el hilo de la revisión. Devuélvelo con el criterio que faltaba añadido al brief. El brief es el artefacto duradero; el hilo desaparece. En un mes, tus briefs se afilan y tu tasa de fallos en los peldaños dos y tres baja, que es la recompensa real.
Qué medir de tu propio proceso de revisión
Trata la Ladder como un proceso que puedes inspeccionar:
Distribución de fallos por peldaño. Si la mayoría de los fallos caen en el peldaño dos, el problema son tus briefs. Si caen en el tres, tus prompts se saltan los casos límite.
Tasa de excedente. ¿Con qué frecuencia añade un agente alcance que nadie pidió? Una tasa creciente significa que tus briefs dejan demasiado margen.
Cumplimiento de la comprobación de resultado. ¿Cuántos cambios lanzados tuvieron su lectura del peldaño cuatro en la fecha fijada? Es el número que muestra si estás aprendiendo o solo lanzando.
No necesitas un dashboard para esto. Una tabla con una fila por cada cambio revisado basta durante el primer mes.
¿Cuándo no funciona esta checklist?
No es una revisión de código ni de seguridad. La Ladder comprueba intención y comportamiento. Con un 39 % de desarrolladores que dicen tener poca o ninguna confianza en el código generado por IA en la encuesta DORA 2024, la revisión de ingeniería y las comprobaciones automatizadas siguen siendo obligatorias (DORA, 2024).
Es excesiva para cambios triviales. Una corrección de texto o un cambio de color necesita como mucho el peldaño dos. Reserva la Ladder completa para lo que vaya a usar un cliente o toque datos o permisos.
No puede salvar una mala decisión. El peldaño uno comprueba que existe una decisión, no que fuera acertada. Si el problema de fondo no está claro, vuelve a un enunciado del problema antes de revisar más código.
Depende de que la lectura del resultado ocurra de verdad. Para las funciones de IA en particular, cuya salida varía por sí misma, combina el peldaño cuatro con un marco de evaluación de IA en lugar de una sola métrica.
Preguntas frecuentes
¿Qué es una checklist de aceptación para código generado por IA?
Es una lista corta de comprobaciones de producto que se hacen antes de dar por terminado un cambio hecho por un agente: qué decisión implementa, si coincide con el brief y nada más, cómo se comporta en cinco situaciones límite y cómo sabrás que funcionó. Va junto a la revisión de código, no en su lugar.
¿Deben los product managers revisar el código escrito por agentes de IA?
Los PM deben revisar el comportamiento, no el estilo del código. Lee el brief frente a lo que hace el cambio, ejecuta los casos límite en una vista previa y comprueba el plan de resultado. Deja el diseño, los tests y la seguridad a los ingenieros y a las herramientas. En un equipo en solitario, haz las dos cosas, pero en pasadas separadas.
¿Cuánto dura una revisión de aceptación?
Para un cambio típico del tamaño de una función, unos cinco minutos, una vez que tus briefs contienen criterios comprobables y mantienes una lista fija de casos límite. Las primeras revisiones llevan más tiempo porque dejan al descubierto criterios ausentes. Ese tiempo pasa a escribir mejores briefs en vez de desaparecer.
¿Cuál es la diferencia entre criterios de aceptación y definition of done?
Los criterios de aceptación son específicos de un cambio: lo que debe hacer esta función. La definition of done se aplica a todos los cambios: código revisado, tests superados, comprobaciones de seguridad ejecutadas, comprobación del resultado programada. Atlassian señala que a veces se usan los dos términos como sinónimos, pero mantenerlos separados facilita las revisiones de agentes.
¿Por qué los agentes de IA añaden funciones que nadie pidió?
Los agentes rellenan los huecos del brief con comportamiento plausible, y extras como botones de deshacer, filtros o ajustes son plausibles. Algunos son útiles. El problema es que cada uno es alcance sin revisar. La pasada de excedente del peldaño dos te obliga a conservar o eliminar cada extra a propósito, y a añadir un criterio para todo lo que conserves.
¿Puede un agente de IA comprobar su propio trabajo frente a los criterios de aceptación?
En parte. Los agentes pueden ejecutar tests y comparar el comportamiento con criterios escritos, y las herramientas que validan un plan antes de programar detectan errores pronto. Pero los agentes describen su propio trabajo con soltura, y la soltura no es evidencia. Una persona sigue ejecutando el peldaño uno (¿es esta la decisión correcta?) y el peldaño cuatro (¿ayudó a los usuarios?).
GDPR-aligned. EU workspace data is stored in Frankfurt, Germany. GDPR and EU data Built in Vienna, Austria. A product of influence solutions fm GmbH (FN 675374y). Imprint 14-day trial. Card required, and nothing is charged until day 14. 30-day refund after subscribing. See pricing