4 november 2026Bijgewerkt op Fathy Shalaby14 min leestijd
AI-use cases prioriteren: een scorekaart voor productteams
Vergelijk AI-productideeën met een gewogen scorekaart voor gebruikersbewijs, impact, AI-voordeel, evalueerbaarheid, foutbeheersing en tijd om te leren. Kies wat je als volgende test, niet wat je oplevert.
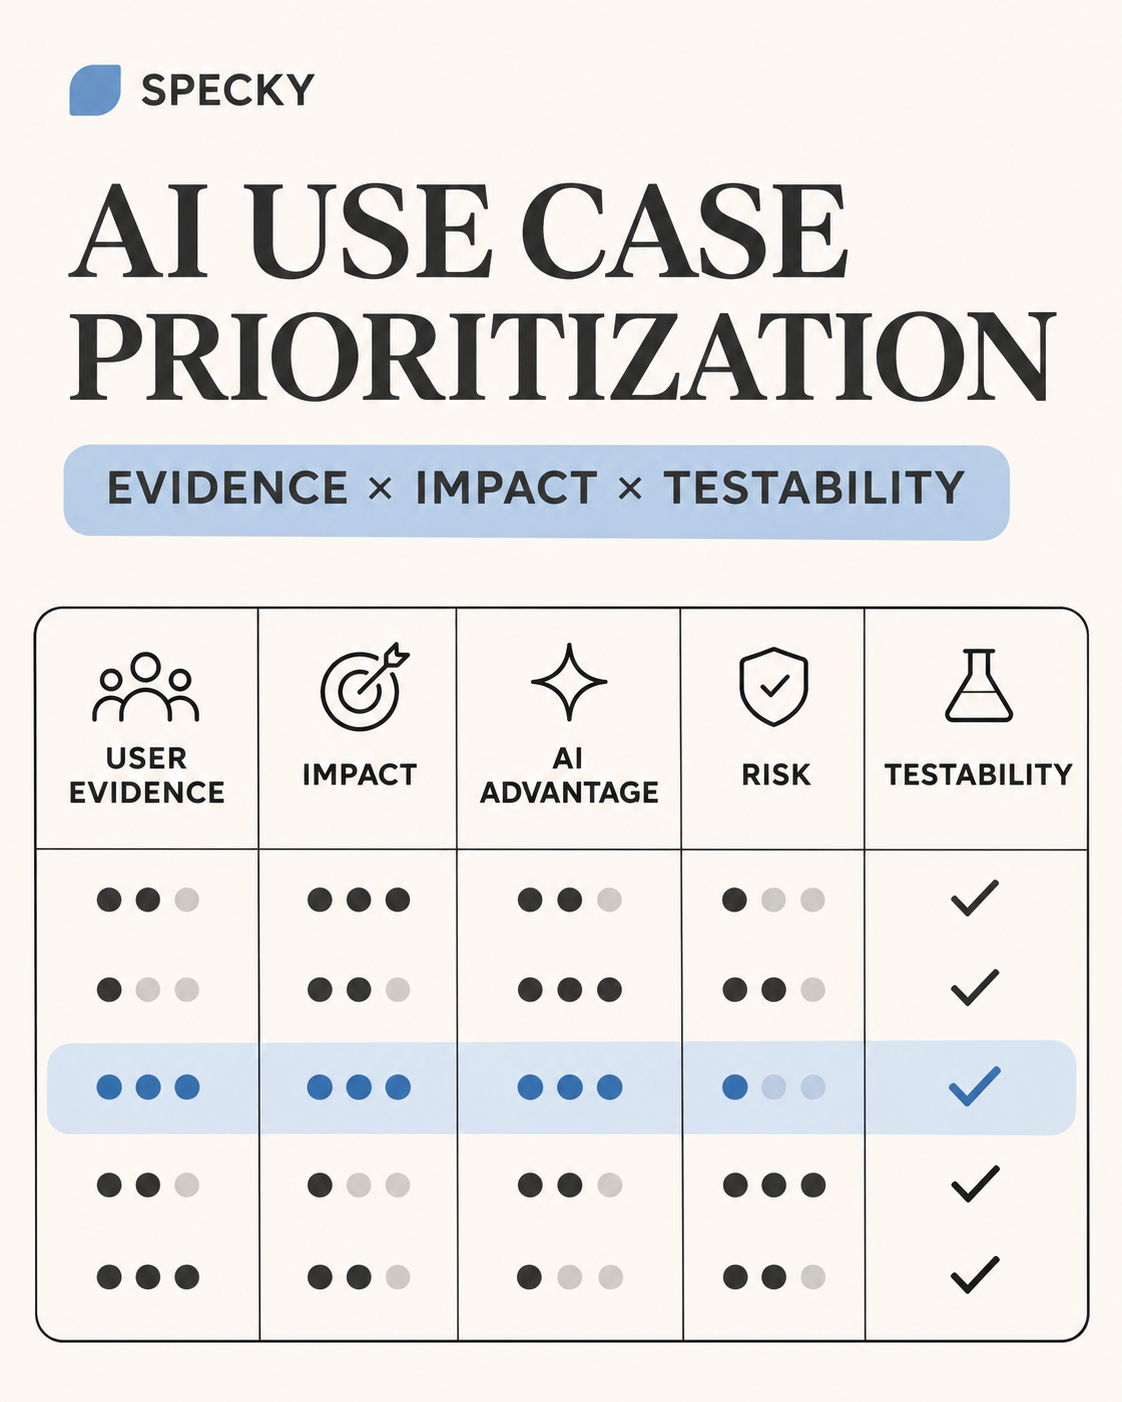
Om AI-use cases te prioriteren vergelijk je gebruikersproblemen in plaats van AI-features, en kies je daarna welke je als eerste test. Beoordeel elke kandidaat op de sterkte van het probleembewijs, het verwachte gebruikersresultaat, het voordeel van AI ten opzichte van een eenvoudigere optie, evalueerbaarheid, foutbeheersing en de tijd om te leren. Pas voor het scoren drie gereedheidspoorten toe en zie het resultaat als een manier om afwegingen zichtbaar te maken, niet als een voorspelling.
Dit is een andere beslissing dan de vraag of één feature AI zou moeten gebruiken. De vierstappentoets voor AI-geschiktheid helpt om één feature te beoordelen. Deze scorekaart helpt een oprichter, een eerste product hire, een PM of een product engineer te bepalen welke van meerdere kandidaten de beperkte aandacht van het team verdient.
Belangrijkste inzichten
De meeste AI-initiatieven lopen vast voordat ze iets opleveren. Uit het BCG-onderzoek onder 1.000 managers in 59 landen bleek dat 74% van de bedrijven nog geen tastbare waarde uit AI had laten zien en dat slechts 26% verder kwam dan proofs of concept (BCG, 2024).
Uit de studie van MIT NANDA uit 2025, op basis van 150 interviews en 300 openbare implementaties, bleek dat slechts ongeveer 5% van de AI-pilots snelle omzetgroei opleverde (Fortune, 2025).
Het model is zelden de beperking. De koplopers van BCG staken 10% van hun middelen in algoritmen, 20% in technologie en data, en 70% in mensen en processen.
De PAIR Guidebook van Google noemt gevallen waarin AI waarschijnlijk niet beter is, waaronder voorspelbaarheid behouden en dure fouten beperken (Google PAIR).
Geef probleembewijs en gebruikersresultaat het zwaarste gewicht. In de scorekaart hieronder vormen ze samen 55% van het totaal.
Waarom mislukken zoveel AI-use cases?
Teams kiezen AI-projecten meestal zoals ze demo's kiezen: op wat indrukwekkend lijkt in een prototype. De cijfers over mislukkingen wijzen een andere kant op.
De kloof zit in waarde, niet in vermogen. BCG ontdekte dat slechts 4% van de bedrijven over de meest geavanceerde AI-capaciteiten in alle functies beschikte, en dat de koplopers het grootste deel van hun inspanning in mensen en processen staken, niet in algoritmen ().
Werkprocessen bepalen de uitkomst. Het MIT NANDA-rapport wijt het mislukken aan een "leerkloof" in tools en organisaties in plaats van aan de kwaliteit van de modellen, en vond dat ingekochte tools van gespecialiseerde leveranciers in ongeveer 67% van de gevallen slaagden, terwijl interne ontwikkelingen ongeveer een derde zo vaak slaagden (Fortune, 2025). Lees wat het cijfer van 95% werkelijk mat voordat je het citeert.
Gebruikers controleren de output. In de Stack Overflow-enquête van 2025 wantrouwde 46% van de ontwikkelaars de nauwkeurigheid van AI-tools tegenover 33% die erop vertrouwde, en noemde 66% antwoorden die "bijna goed, maar net niet" zijn als grootste frustratie (Stack Overflow, 2025). Als je gebruikers een output niet kunnen controleren, negeren ze die of vertrouwen ze erop terwijl ze dat niet zouden moeten doen.
Het patroon: kies een smal, onderbouwd gebruikersprobleem met een zichtbare manier om de kwaliteit te controleren, en AI-projecten gedragen zich als gewone productweddenschappen. Sla je die stappen over, dan wordt het prototype de strategie.
Begin met probleemkandidaten, niet met AI-features
Een ideeënlijst bevat vaak uiteenlopende dingen: gebruikersproblemen, gevraagde features, experimenten en technische mogelijkheden. Breng elke kandidaat in dezelfde vorm voordat je hem vergelijkt.
Noteer voor elk idee:
Gebruiker en situatie: Wie loopt tegen het probleem aan, en wanneer?
Job: Wat probeert die persoon te bereiken?
Huidige aanpak: Wat doet de gebruiker nu, inclusief noodoplossingen?
Bewijs: Wat is direct waargenomen, en waar kan het team dat inzien?
Gewenst resultaat: Wat zou beter zijn voor de gebruiker?
Bijdrage van AI: Welk deel van de taak kan baat hebben bij taal, synthese of aanpassing?
Foutkosten: Wat kan er misgaan, en wie zou het merken?
Eerste test: Wat is het kleinste experiment dat een betekenisvolle vraag kan beantwoorden?
"Een AI-roadmapassistent toevoegen" is nog niet klaar om te vergelijken. "Een eerste product hire besteedt de vrijdag aan het samenvoegen van supportverzoeken en interviewnotities voordat hij beslist wat hij gaat onderzoeken" is een bruikbaarder kandidaat: hij noemt een gebruiker, een taak en bewijs waar het team naar kan zoeken.
Beschouw een verzoek van een stakeholder, een upvote of een overtuigend prototype niet als bewijs dat een probleem vaak voorkomt. Houd de oorspronkelijke bron erbij en noteer wat die niet aantoont. De AI-productdiscoverylus laat een werkwijze van twee weken zien om die signalen te verzamelen en te beoordelen.
Aan welke gereedheidspoorten moet een AI-use case eerst voldoen?
Een hoge score mag geen fundamentele reden om te wachten verbergen. Controleer voordat je ideeën rangschikt drie poorten:
Het gebruikersprobleem is specifiek genoeg om te onderzoeken. Je kunt een gebruiker noemen, een recente situatie beschrijven en minstens één bron of een duidelijke discoverystap aanwijzen.
Een nuttig resultaat is waarneembaar. Het team kan zeggen wat er beter moet worden en welke vangrail niet mag verslechteren.
Een kostbare fout heeft een zichtbare controle. Het team kan de betreffende fout opsporen, beoordelen, beperken of terugdraaien voordat de feature wordt uitgebreid.
Voldoet een idee niet aan een poort, noteer dan welk bewijs of ontwerpwerk ontbreekt. Het mag op de lijst blijven, maar het mag niet winnen alleen omdat een prototype makkelijk te bouwen is.
Hoe scoor en vergelijk je AI-use cases?
Gebruik voor elke dimensie een score van 1 tot 5. De onderstaande gewichten zijn een startpunt voor discussie, geen wetenschappelijk gevalideerde formule. Pas ze aan als de strategie of het risicoprofiel van je team daar aanleiding toe geeft. Zet de schriftelijke onderbouwing naast elke score.
Dimensie
Gewicht
1 – zwak
3 – gemengd
5 – sterk
Probleembewijs
30%
Vooral een aanname
Eén geloofwaardig signaal, patroon onduidelijk
Herhaald, controleerbaar bewijs van de beoogde gebruikers
Gebruikersresultaat
25%
Voordeel is vaag of intern
Een plausibel gebruikersvoordeel met hiaten
Een specifieke taak of uitkomst zou moeten verbeteren
AI-voordeel
15%
Een regel of gewone zoekfunctie werkt misschien even goed
AI kan een deel verbeteren
AI pakt echte variatie, taal of synthese aan
Evalueerbaarheid
15%
Geen voorbeelden of beoordelingscriteria
Enkele voorbeelden, belangrijke hiaten blijven
Representatieve gevallen en waarneembare kwaliteitscontroles zijn beschikbaar
Foutbeheersing
10%
Fouten kunnen onopgemerkt blijven of zijn moeilijk terug te draaien
Er is enige beoordeling of terugvaloptie
Fouten zijn zichtbaar, afgebakend en herstelbaar tijdens de test
Tijd om te leren
5%
De test vraagt brede integratie of een lange verplichting
Een pilot is mogelijk met afhankelijkheden
Een kleine, omkeerbare test kan de volgende vraag beantwoorden
Bereken een gewogen score als de score gedeeld door 5 en vermenigvuldigd met het gewicht, en tel dan de zes uitkomsten op. Het maximum is 100. Gebruik het getal om een gesprek te structureren, niet om te suggereren dat een idee met 4,1 objectief beter is dan een idee met 3,9. Een serieus risico of een niet gehaalde gereedheidspoort vraagt nog steeds om een directe beslissing.
Voorbeeld: vergelijk drie mogelijke AI-werkprocessen
Het voorbeeld hieronder is hypothetisch. Het laat zien hoe een klein team ideeën zou kunnen vergelijken; het is geen klantresultaat van Specky en geen marktonderzoek.
Kandidaat
Te onderzoeken bewijs
Grootste onzekerheid
Verstandige eerste test
Notities uit klantinterviews tot thema's groeperen
Recente interviews en de huidige tijd voor synthese
Of de voorgestelde thema's meningsverschillen en broncontext bewaren
Vraag beoordelaars elk thema terug te voeren op originele fragmenten en ontbrekende tegenvoorbeelden te markeren
Een productbrief opstellen op basis van klantbewijs
Voorbeelden van briefs, brondocumenten en herschrijfstappen
Of het concept beoordelingswerk bespaart zonder onderbouwde beweringen toe te voegen
Eis bronlinks bij feitelijke beweringen en laat een PM of product engineer het concept beoordelen
Roadmapverzoeken automatisch rangschikken
Bronnen van de verzoeken, beslishistorie en hoe prioriteiten nu worden bepaald
Of een rangschikking ontbrekende context verbergt of voor een beslissing wordt aangezien
Toon eerst het bewijs en de afwegingen; laat de prioriteringsbeslissing bij een persoon
Nu scoren we ze. Ook hier zijn de getallen slechts ter illustratie:
Dimensie (gewicht)
Interviewnotities groeperen
Productbrief opstellen
Roadmap automatisch rangschikken
Probleembewijs (30%)
4 → 24
3 → 18
2 → 12
Gebruikersresultaat (25%)
4 → 20
4 → 20
2 → 10
AI-voordeel (15%)
5 → 15
4 → 12
3 → 9
Evalueerbaarheid (15%)
3 → 9
3 → 9
1 → 3
Foutbeheersing (10%)
4 → 8
3 → 6
1 → 2
Tijd om te leren (5%)
5 → 5
4 → 4
2 → 2
Gewogen score (van 100)
81
69
38
Gereedheidspoorten
Gehaald
Gehaald
Faalt op poort 3
Het idee om interviews te groeperen staat 12 punten voor en heeft de goedkoopste test, dus gaat het eerst. Het opstellen van briefs is een redelijke tweede pilot zodra de eerste beoordelingscriteria heeft opgeleverd die het team kan hergebruiken. Het idee van automatisch rangschikken faalt op foutbeheersing: een gerangschikte lijst lijkt gezaghebbend, en een verkeerde lijst zou de roadmap ongemerkt kunnen sturen. Het blijft op de lijst staan met een notitie over wat er zou moeten veranderen.
Hoe verhoudt een scorekaart voor AI-use cases zich tot RICE?
Scorekaart voor AI-use cases
RICE
Waarde versus inspanning
Vergeleken eenheid
Gebruikersproblemen met een AI-invalshoek
Features of projecten
Features of projecten
Evaluatie en foutrisico
Expliciet gescoord (samen 25%)
Verwerkt in Confidence
Niet gedekt
Vraagt "zou een eenvoudiger hulpmiddel volstaan?"
Ja, via AI-voordeel
Nee
Nee
Uitkomst
Welke test je eerst doet
Bouwvolgorde
Grof raster
Het best voor
Kiezen tussen AI-ideeën
Volgorde van een gescoorde backlog
Snel sorteren
RICE blijft nuttig zodra een AI-feature zich heeft bewezen en in de gewone backlog terechtkomt. Zie voor die fase RICE-scoring met AI.
Wanneer is AI het verkeerde gereedschap voor een use case?
"AI maakt dit slimmer" is geen bruikbare onderbouwing van een score. Benoem het specifieke werk waarbij een model kan helpen en vergelijk dat met de eenvoudigste bruikbare basislijn:
Gaat de taak over gevarieerde taal of ongestructureerd bewijs?
Is synthese over meerdere bronnen belangrijk?
Kan een gebruiker de output aan die bronnen toetsen?
Zou zoeken, een regel, een filter of een korte workflow hetzelfde probleem oplossen?
Welke kosten, vertraging, beoordeling en onderhoud voegt de AI-versie toe?
De People + AI Guidebook van Google is een nuttige referentie om AI-ontwerp te verankeren in de behoeften van gebruikers. Het noemt gevallen waarin AI waarschijnlijk beter is, zoals personalisatie, voorspelling en begrip van natuurlijke taal, en gevallen waarin dat waarschijnlijk niet zo is, zoals voorspelbaarheid behouden, dure fouten beperken, volledige transparantie bieden en optimaliseren voor hoge snelheid en lage kosten. Het bevestigt de gewichten in deze scorekaart niet. Gebruik de AI-geschiktheidstoets om te bepalen of een voorgestelde feature überhaupt een model nodig heeft.
Hoe ontwerp je de eerste test voor een AI-use case?
Pilot niet een heel roadmapidee als een smalle test de volgende vraag kan beantwoorden. Kies de test op basis van wat het minst bekend is:
Onzekerheid over het probleem: Observeer het huidige werkproces of interview mensen over een recent, concreet voorbeeld.
Onzekerheid over AI-geschiktheid: Vergelijk het model op representatieve voorbeelden met een regel, zoekfunctie of het huidige handmatige proces.
Onzekerheid over kwaliteit: Bepaal beoordelingscriteria en neem lastige of dubbelzinnige invoer mee. Een evaluatiekader voor AI-features helpt daarbij.
Onzekerheid over vertrouwen: Laat de beoogde gebruikers het resultaat inspecteren, corrigeren, afwijzen of ongedaan maken.
Onzekerheid over het resultaat: Kies een maatstaf die aan de taak van de gebruiker is gekoppeld, plus een vangrail voor kwaliteit, fouten, kosten of tijd.
Leg de voorwaarden om door te gaan en om te stoppen vast voordat je de resultaten ziet. Ga bijvoorbeeld alleen door als mensen de output kunnen controleren, de afgesproken kwaliteitscontroles slagen en de test de taak verbetert zonder onaanvaardbaar beoordelingswerk te veroorzaken. Bepaal de werkelijke drempels samen met het team op basis van de gevolgen en de uitgangssituatie; er bestaat geen universeel slaagcijfer.
Het NIST AI Risk Management Framework, uitgebracht op 26 januari 2023 en bedoeld voor vrijwillig gebruik, ordent het risicowerk in Govern, Map, Measure en Manage. NIST voegde op 26 juli 2024 een Generative AI Profile toe (NIST-AI-600-1). Gebruik ze als aanzet voor productspecifieke vragen, niet als certificering en niet als vervanging van een beoordeling door domeinexperts.
Kopieerbare scorekaart voor het prioriteren van AI-use cases
Kandidaat:
Gebruiker en situatie:
Job to be done:
Huidige aanpak of noodoplossing:

Bewijs en bronlinks:
Wat het bewijs laat zien:
Wat het niet laat zien:

Gewenst gebruikersresultaat:
Bijdrage van AI:
Eenvoudigste bruikbare basislijn:

Probleembewijs (1–5):         x 30% / 5 =
Gebruikersresultaat (1–5):    x 25% / 5 =
AI-voordeel (1–5):            x 15% / 5 =
Evalueerbaarheid (1–5):       x 15% / 5 =
Foutbeheersing (1–5):         x 10% / 5 =
Tijd om te leren (1–5):       x  5% / 5 =
Gewogen score (van 100):
Reden voor elke score:

Gereedheidspoorten:
[ ] Specifiek gebruikersprobleem en bewijs
[ ] Waarneembaar resultaat en vangrail
[ ] Fout is op te sporen, afgebakend of terug te draaien

Zelf bouwen, kopen of een bestaande tool configureren?:
Kleinste bruikbare test:
Eigenaar:
Doorgaan als:
Stoppen of herontwerpen als:
Evaluatiedatum:
Houd de oorspronkelijke bewijslinks bij de scorekaart. Verandert een score, noteer dan welke nieuwe informatie dat veroorzaakte. Een lichtgewicht productbeslislogboek kan de onderbouwing en de voorwaarden om de keuze te heroverwegen bewaren.
Veelgemaakte fouten bij het prioriteren van AI-use cases
Rangschikken op demokwaliteit. Een prototype dat werkt op vijf handgekozen invoeren zegt weinig over de honderdste echte.
De basislijn overslaan. Als een filter of opgeslagen zoekopdracht 80% van het probleem oplost, moet de AI-versie dat overtreffen, niet niets.
Vijf pilots tegelijk draaien. Een klein team kan ze niet parallel evalueren, en de beoordelingsinspanning wordt aan het verkeerde werkproces toegeschreven.
Bouwen wat je kunt kopen. De data van MIT NANDA suggereren dat ingekochte, gespecialiseerde tools vaker slagen dan interne ontwikkelingen. Voeg "kopen of configureren" als optie toe voordat je scoort.
Geen schriftelijk beleid. In de enquête van Productboard uit 2025 zei 65% van 379 productprofessionals bij grote bedrijven dat hun bedrijf een gedocumenteerd AI-beleid had, dus ongeveer een derde niet (Productboard, 2025). Bepaal welke data een pilot mag aanraken voordat hij begint.
Hoe product engineers en builders de scorekaart kunnen gebruiken
Product engineers en technische oprichters zien vaak een implementatieroute voordat het team de onderliggende problemen heeft vergeleken. Gebruik die snelheid om een test goedkoper te maken, niet om het probleembewijs over te slaan. Engineers kunnen beperkingen in toegang tot data en integratie opsporen, representatieve voorbeelden voorbereiden en een prototype omkeerbaar maken. Product builders kunnen helpen aannames in de specificatie bloot te leggen en het beoordelingspad expliciet te maken.
Laat het productoordeel bij het team. AI kan bewijs van kandidaten ordenen of opties opstellen; het mag een score niet stilzwijgend omzetten in een roadmapbelofte. Zie voor een verwant, door engineering geleid discoveryproces customer discovery voor product engineers. Gebruik de gratis AI-PRD-generator om een gekozen idee om te zetten in een requirementsconcept, en houd het bronbewijs erbij.
Veelgestelde vragen
Wat is het prioriteren van AI-use cases?
Bij het prioriteren van AI-use cases vergelijk je kandidaat-gebruikersproblemen en werkprocessen om te beslissen welke je als eerste onderzoekt of test. Een bruikbare vergelijking omvat gebruikersbewijs, verwacht resultaat, het specifieke voordeel van AI, evalueerbaarheid en foutbeheersing. Ze eindigt met een gekozen test en stopvoorwaarden, niet met een roadmapbelofte.
Hoe prioriteer je AI-features?
Begin met het gebruikersprobleem en de huidige noodoplossing. Pas gereedheidspoorten toe, vergelijk kandidaten met consistente criteria en doe een kleine test met het idee met de hoogste prioriteit waarvan de risico's beheersbaar zijn. Houd de score en de onderbouwing zichtbaar, zodat nieuw bewijs de beslissing kan veranderen.
Moet een klein team meerdere AI-features tegelijk bouwen?
Meestal test je minder ideeën tegelijk als het team ze niet parallel kan evalueren. Met een smalle pilot kun je beoordelingsinspanning, kwaliteitsproblemen en gebruikersresultaten makkelijker aan één werkproces toeschrijven. Kies de reikwijdte op basis van het beschikbare bewijs en de capaciteit.
Wat als twee AI-use cases vergelijkbare scores hebben?
Vergelijk welke onzekerheid elke test zou wegnemen, wat de schade is als het werkproces faalt en of de ideeën van dezelfde data of integratie afhangen. Als het bewijs nog steeds gelijk staat, doe dan een discoverystap of een kleine omkeerbare test in plaats van schijnnauwkeurigheid in de scoring te verzinnen.
Voorspelt de score van een AI-use case het productsucces?
Nee. Een score is een gestructureerde samenvatting van het huidige bewijs en de huidige aannames. Hij voorspelt geen adoptie, omzet of product-marktfit. Valideer het gebruikersprobleem en meet wat er gebeurt in een echt werkproces.
Waarom geef je probleembewijs een hoger gewicht dan AI-voordeel?
Omdat de cijfers over mislukkingen wijzen op problemen en werkprocessen, niet op modellen. De koplopers van BCG staken 70% van hun AI-middelen in mensen en processen en slechts 10% in algoritmen. Een sterk model op een onbewezen probleem mislukt alsnog, terwijl een bescheiden model op een goed onderbouwde, controleerbare taak snel waarde kan leveren.
Kies een test en werk de beslissing bij met bewijs
Een nuttig proces om AI-use cases te prioriteren maakt de keuze en de onzekerheid ervan beter zichtbaar. Vergelijk kandidaat-problemen, laat zien waarom één test als eerste komt en noteer wat de beslissing zou veranderen. Het doel is te leren welk werkproces een echt voordeel voor gebruikers oplevert, niet om AI standaard op de roadmap te zetten.
GDPR-aligned. EU workspace data is stored in Frankfurt, Germany. GDPR and EU data Built in Vienna, Austria. A product of influence solutions fm GmbH (FN 675374y). Imprint 14-day trial. Card required, and nothing is charged until day 14. 30-day refund after subscribing. See pricing